
ปลดล็อกศักยภาพบอทอัจฉริยะ: ตอบทุกคำถาม สร้างสรรค์เนื้อหา พร้อมอ้างอิงครบครัน
คู่มือฉบับสมบูรณ์สำหรับการตั้งค่าแชทบอทให้รองรับงานซับซ้อน ตั้งแต่การตอบคำถามทั่วไปจนถึงการสร้างองค์ความรู้แบบมีโครงสร้าง
การสร้างแชทบอทที่มีความสามารถหลากหลายตามที่คุณต้องการ ตั้งแต่การตอบคำถามพื้นฐานไปจนถึงการวิเคราะห์ข้อมูลที่ซับซ้อน การสรุปคำศัพท์ การเปรียบเทียบข้อมูลจากแหล่งภายในและภายนอก การเรียงลำดับข้อมูล และแม้กระทั่งการสร้างเนื้อหาที่มีโครงสร้างคล้าย "หนังสือ" พร้อมการอ้างอิงที่แม่นยำนั้น เป็นกระบวนการที่ต้องอาศัยการวางแผน การเลือกใช้เทคโนโลยีที่เหมาะสม และการตั้งค่าอย่างรอบคอบ คู่มือนี้จะแนะนำขั้นตอนและองค์ประกอบสำคัญต่างๆ เพื่อช่วยให้คุณสร้างบอทอัจฉริยะได้อย่างมีประสิทธิภาพ
ไฮไลท์สำคัญในการสร้างบอทขั้นสูง
- การผสานพลังของ LLMs และ RAG: ใช้ประโยชน์จากโมเดลภาษาขนาดใหญ่ (Large Language Models) ร่วมกับสถาปัตยกรรม Retrieval-Augmented Generation (RAG) เพื่อให้บอทสามารถเข้าถึงและอ้างอิงข้อมูลจากฐานความรู้เฉพาะของคุณได้อย่างแม่นยำ ลดการสร้างข้อมูลที่ไม่ถูกต้อง (hallucination)
- ฐานความรู้ที่ครอบคลุม: สร้างและจัดการฐานความรู้ (Knowledge Base) ที่แข็งแกร่ง ซึ่งรวมทั้งข้อมูลภายในองค์กร (เอกสาร, FAQs, API) และข้อมูลภายนอก (เว็บไซต์, บทความวิชาการ, ฐานข้อมูลสาธารณะ) เพื่อให้บอทมีแหล่งข้อมูลที่ครบถ้วนในการตอบคำถามและสร้างเนื้อหา
- การออกแบบ Workflow ที่ยืดหยุ่น: กำหนดขั้นตอนการทำงาน (flows) และการโต้ตอบแบบหลายขั้นตอน (multi-step Q&A) เพื่อให้บอทสามารถจัดการกับคำถามที่มีความซับซ้อน รวบรวมข้อมูลเพิ่มเติมจากผู้ใช้ และนำเสนอคำตอบหรือเนื้อหาได้อย่างเป็นระบบ
ทำความเข้าใจความต้องการและวางแผนการสร้างบอท
ก่อนเริ่มต้นพัฒนาระบบ สิ่งสำคัญคือการกำหนดขอบเขตและวัตถุประสงค์ของบอทให้ชัดเจน เพื่อให้การออกแบบและการเลือกใช้เทคโนโลยีเป็นไปในทิศทางที่ถูกต้อง
1. กำหนดขอบเขตและวัตถุประสงค์
ระบุให้ชัดเจนว่าบอทของคุณจะถูกนำไปใช้เพื่อวัตถุประสงค์ใดบ้าง เช่น:
- ตอบคำถามที่พบบ่อย (FAQs) เกี่ยวกับผลิตภัณฑ์หรือบริการ
- ให้ข้อมูลเชิงลึกจากการวิเคราะห์ข้อมูลภายในองค์กร
- สรุปประเด็นสำคัญจากเอกสารขนาดยาว
- เปรียบเทียบคุณสมบัติของผลิตภัณฑ์กับคู่แข่งในตลาด
- รวบรวมและจัดลำดับข้อมูลเหตุการณ์สำคัญ
- สร้างรายงานสรุปหรือเอกสารองค์ความรู้จากข้อมูลที่หลากหลาย
การกำหนดขอบเขตที่ชัดเจนจะช่วยให้คุณสามารถเลือกเครื่องมือและเทคนิคที่เหมาะสม รวมถึงการประเมินความซับซ้อนและทรัพยากรที่ต้องใช้ในการพัฒนา
2. ประเภทคำถามที่บอทจะจัดการ
บอทของคุณจำเป็นต้องสามารถจัดการกับคำถามประเภทต่างๆ ได้แก่:
- คำถามทั่วไป (General Questions): คำถามพื้นฐานที่มีคำตอบชัดเจนและตรงไปตรงมา มักพบในส่วน FAQs
- คำถามซับซ้อน (Complex Questions): คำถามที่ต้องการการวิเคราะห์ การตีความ หรือการประมวลผลข้อมูลจากหลายแหล่ง อาจต้องมีการโต้ตอบหลายขั้นตอนเพื่อทำความเข้าใจความต้องการของผู้ใช้อย่างถ่องแท้
- คำขอให้สรุป (Summarization Requests): เช่น สรุปคำศัพท์ทางเทคนิค สรุปเนื้อหาจากบทความยาว
- คำขอให้เปรียบเทียบ (Comparison Requests): เช่น เปรียบเทียบข้อมูลผลิตภัณฑ์ A กับ B โดยใช้ข้อมูลภายในและข้อมูลจากตลาด
- คำขอให้เรียงลำดับ (Ordering Requests): เช่น เรียงลำดับเหตุการณ์ทางประวัติศาสตร์ หรือจัดอันดับข้อมูลตามเกณฑ์ที่กำหนด
- คำขอให้สร้างเนื้อหา (Content Generation Requests): เช่น สร้างรายงานสรุปข้อมูลยอดขายรายไตรมาสพร้อมการวิเคราะห์และอ้างอิงแหล่งข้อมูล
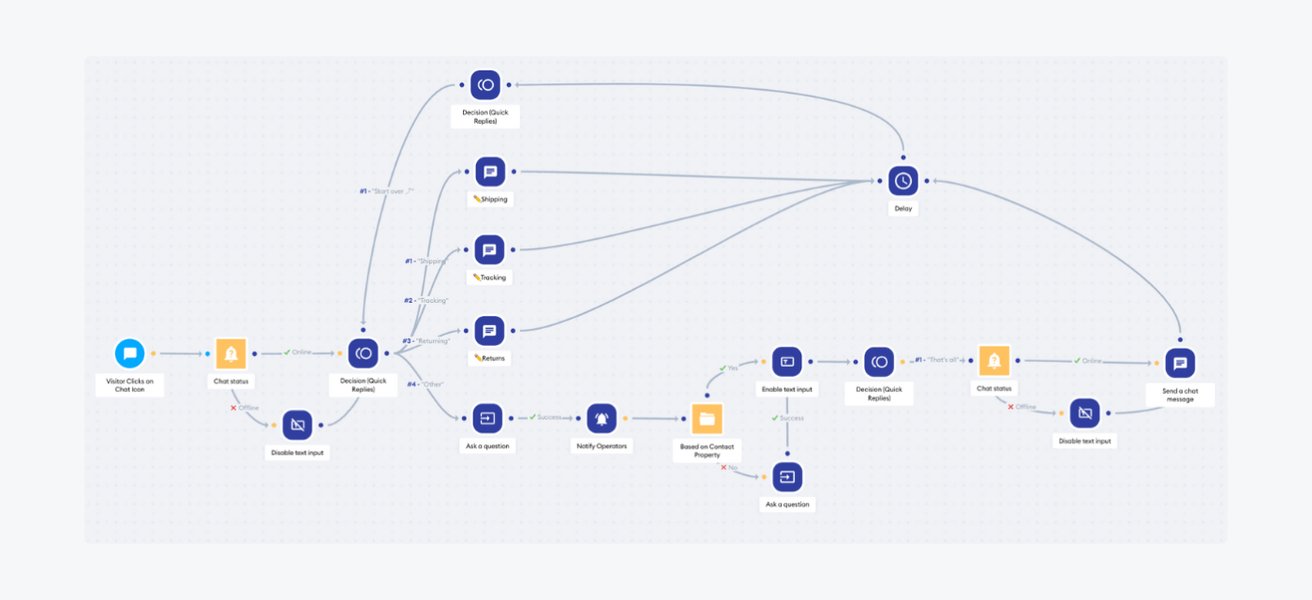
ภาพตัวอย่างผังการสนทนาของแชทบอท (Chatbot Flowchart) ที่แสดงการจัดการคำถามหลายขั้นตอน
สถาปัตยกรรมและเทคโนโลยีหลักสำหรับบอทอัจฉริยะ
การสร้างบอทที่มีความสามารถสูงจำเป็นต้องเลือกใช้เทคโนโลยีที่เหมาะสม เพื่อให้สามารถประมวลผลภาษาธรรมชาติ เข้าใจความซับซ้อนของคำถาม และเข้าถึงข้อมูลได้อย่างมีประสิทธิภาพ
1. โมเดลภาษาขนาดใหญ่ (Large Language Models - LLMs)
LLMs เช่น GPT-4o, GPT-4 Turbo, หรือโมเดลโอเพนซอร์สอย่าง Mixtral เป็นหัวใจสำคัญของบอทอัจฉริยะ โมเดลเหล่านี้มีความสามารถในการทำความเข้าใจและสร้างภาษาธรรมชาติที่ใกล้เคียงมนุษย์ ทำให้บอทสามารถ:
- ตีความคำถามที่มีความหมายซับซ้อน
- สร้างคำตอบที่เป็นธรรมชาติและสอดคล้องกับบริบท
- สรุปเนื้อหาจากข้อความยาว
- แปลภาษา และเขียนเนื้อหาในรูปแบบต่างๆ
การเลือกใช้ LLM ที่เหมาะสมขึ้นอยู่กับความต้องการด้านประสิทธิภาพ ความซับซ้อนของงาน และงบประมาณ
2. Retrieval-Augmented Generation (RAG)
RAG เป็นสถาปัตยกรรมที่ผสานความสามารถของ LLM เข้ากับระบบการดึงข้อมูล (Retrieval System) จากฐานความรู้ภายนอก (เช่น เอกสารภายในองค์กร ฐานข้อมูล หรือเว็บไซต์ที่กำหนด) แทนที่จะให้ LLM ตอบคำถามจากความรู้ที่ถูกฝึกมาเท่านั้น RAG จะค้นหาข้อมูลที่เกี่ยวข้องจากแหล่งข้อมูลที่กำหนด แล้วนำข้อมูลนั้นมาเป็นบริบท (context) ให้ LLM ใช้ในการสร้างคำตอบ วิธีนี้ช่วยให้:
- คำตอบมีความแม่นยำและอ้างอิงจากข้อมูลจริงเฉพาะทางได้
- ลดปัญหาการสร้างข้อมูลที่ไม่เป็นความจริง (Hallucination) ของ LLM
- บอทสามารถให้ข้อมูลที่เป็นปัจจุบัน หากฐานความรู้มีการอัปเดตอย่างสม่ำเสมอ
3. Vector Databases
ฐานข้อมูลเวกเตอร์ (Vector Databases) เช่น ChromaDB, Pinecone, หรือ Weaviate มีบทบาทสำคัญในระบบ RAG โดยทำหน้าที่จัดเก็บข้อมูลในรูปแบบของ Vector Embeddings ซึ่งเป็นตัวแทนเชิงตัวเลขของความหมายของข้อความ ทำให้สามารถค้นหาข้อมูลที่มีความหมายใกล้เคียงหรือเกี่ยวข้องกับคำถามของผู้ใช้ได้อย่างรวดเร็วและมีประสิทธิภาพ แม้ว่าคำที่ใช้ในคำถามจะไม่ตรงกับคำในฐานข้อมูลก็ตาม
4. แพลตฟอร์มและเฟรมเวิร์ก (Platforms and Frameworks)
มีแพลตฟอร์มและเฟรมเวิร์กหลากหลายที่ช่วยอำนวยความสะดวกในการสร้างบอทอัจฉริยะ:
- แพลตฟอร์มสร้างแชทบอทแบบ Low-code/No-code: เช่น Botpress, Tidio, Copilot Studio (Microsoft) เหมาะสำหรับการสร้างบอทที่ไม่ซับซ้อนมากนัก หรือต้องการเริ่มต้นอย่างรวดเร็ว
- บริการ AI บนคลาวด์: เช่น Azure AI Bot Service (Microsoft), Amazon Lex ร่วมกับ Amazon Kendra (AWS) ให้บริการเครื่องมือและโครงสร้างพื้นฐานสำหรับการสร้างบอทที่ปรับขนาดได้และมีความสามารถสูง
- เฟรมเวิร์กสำหรับนักพัฒนา: เช่น LangChain, LlamaIndex เป็นไลบรารี Python ที่ช่วยให้นักพัฒนาสามารถสร้างแอปพลิเคชันที่ขับเคลื่อนด้วย LLM ได้ง่ายขึ้น โดยเฉพาะการสร้างระบบ RAG การจัดการ Agents และการเชื่อมต่อกับเครื่องมือต่างๆ
การสร้างและจัดการฐานความรู้ (Knowledge Base)
ฐานความรู้คือหัวใจของบอทอัจฉริยะ เป็นแหล่งข้อมูลที่บอทจะนำไปใช้ในการตอบคำถามและสร้างเนื้อหา การมีฐานความรู้ที่ครอบคลุมและเป็นระบบจะช่วยให้บอททำงานได้อย่างมีประสิทธิภาพ
1. ข้อมูลภายใน (Internal Data)
รวบรวมข้อมูลที่มีอยู่ภายในองค์กรของคุณ ซึ่งอาจรวมถึง:
- เอกสาร FAQs: คำถามที่พบบ่อยและคำตอบมาตรฐาน
- คู่มือผลิตภัณฑ์และเอกสารทางเทคนิค: ข้อมูลรายละเอียดเกี่ยวกับสินค้าหรือบริการ
- นโยบายและระเบียบขององค์กร: ข้อมูลที่เกี่ยวข้องกับการดำเนินงานภายใน
- ฐานข้อมูลภายใน: เช่น ข้อมูลลูกค้า ข้อมูลสินค้าคงคลัง (ควรพิจารณาเรื่องความปลอดภัยและการเข้าถึงข้อมูล)
- บทสนทนาที่ผ่านมา: ข้อมูลจากการโต้ตอบระหว่างลูกค้ากับเจ้าหน้าที่ (หากมี) เพื่อใช้ในการฝึกบอท
ข้อมูลเหล่านี้ควรถูกจัดเก็บในรูปแบบที่บอทสามารถเข้าถึงและประมวลผลได้ง่าย เช่น ไฟล์ CSV, JSON, PDF หรือผ่าน API
2. ข้อมูลภายนอก (External Data)
บอทอาจจำเป็นต้องเข้าถึงข้อมูลจากแหล่งภายนอกเพื่อให้คำตอบที่ครอบคลุมและเป็นปัจจุบัน เช่น:
- เว็บไซต์สาธารณะ: เช่น เว็บไซต์ข่าว บทความวิชาการ หรือหน้าข้อมูลผลิตภัณฑ์ของคู่แข่ง
- API จากบริการภายนอก: เช่น API สภาพอากาศ API ตลาดหุ้น หรือ API ข้อมูลทางวิทยาศาสตร์
- ฐานข้อมูลสาธารณะ: แหล่งข้อมูลเปิดที่เกี่ยวข้องกับอุตสาหกรรมหรือหัวข้อที่บอทดูแล
การเชื่อมต่อกับข้อมูลภายนอกต้องคำนึงถึงความน่าเชื่อถือของแหล่งข้อมูล ข้อจำกัดในการใช้งาน (API rate limits) และความเป็นปัจจุบันของข้อมูล
แผนภาพแสดงภาพรวมการพัฒนาบอทอัจฉริยะ
เพื่อให้เห็นภาพรวมของกระบวนการพัฒนาบอทที่มีความสามารถซับซ้อน แผนภาพความคิด (Mindmap) ด้านล่างนี้จะสรุปขั้นตอนและองค์ประกอบหลักที่เกี่ยวข้อง ตั้งแต่การวางแผนไปจนถึงการปรับใช้และบำรุงรักษา:
(เอกสาร, FAQs, API ภายใน)"] id2_2["เชื่อมต่อแหล่งข้อมูลภายนอก
(เว็บไซต์, API ภายนอก, ฐานข้อมูลสาธารณะ)"] id2_3["การแปลงข้อมูลให้อยู่ในรูปแบบที่ LLM เข้าใจ
(เช่น Vector Embeddings)"] id3["3. การพัฒนาฟังก์ชันหลักของบอท"] id3_1["ตอบคำถามทั่วไป (FAQ)"] id3_2["ตอบคำถามซับซ้อน"] id3_2_1["Multi-step Q&A flows"] id3_2_2["Prompt Engineering ขั้นสูง"] id3_3["สรุปคำศัพท์และเนื้อหา"] id3_4["เปรียบเทียบข้อมูล"] id3_4_1["ดึงข้อมูลจากหลายแหล่ง (RAG)"] id3_4_2["วิเคราะห์และแสดงผลเปรียบเทียบ"] id3_5["เรียงลำดับข้อมูลตามเกณฑ์"] id3_6["สร้าง 'หนังสือ' (รายงาน/เอกสารสรุป)"] id3_6_1["รวบรวมและสังเคราะห์ข้อมูลเชิงลึก"] id3_6_2["จัดโครงสร้างเนื้อหา (บท, หัวข้อ)"] id3_6_3["การจัดการการอ้างอิง (Citation)"] id4["4. การเลือกและผสานเทคโนโลยี AI"] id4_1["โมเดลภาษาขนาดใหญ่ (LLMs: GPT-4o, Mixtral)"] id4_2["Retrieval-Augmented Generation (RAG)"] id4_3["Vector Databases (ChromaDB, Pinecone)"] id4_4["เฟรมเวิร์ก (เช่น LangChain, LlamaIndex)"] id5["5. การทดสอบ, ปรับใช้, และบำรุงรักษา"] id5_1["การทดสอบฟังก์ชันและความแม่นยำ"] id5_2["การปรับปรุงตาม Feedback จากผู้ใช้"] id5_3["การอัปเดตฐานความรู้สม่ำเสมอ"] id5_4["การติดตามประสิทธิภาพของบอท"]
แผนภาพนี้ช่วยให้เห็นว่าแต่ละส่วนมีความเชื่อมโยงกันอย่างไร และต้องพิจารณาองค์ประกอบใดบ้างในแต่ละขั้นตอนของการพัฒนาบอท
การตั้งค่าบอทสำหรับฟังก์ชันเฉพาะ
เพื่อให้บอทสามารถทำงานตามที่คุณต้องการได้อย่างครบถ้วน การตั้งค่าสำหรับแต่ละฟังก์ชันมีความสำคัญอย่างยิ่ง
1. การตอบคำถามทั่วไป (FAQ Handling)
เทคนิคและเครื่องมือ:
- แพลตฟอร์มสร้างแชทบอท: เช่น Botpress, Tidio, หรือ Microsoft Copilot Studio ซึ่งมักมีเครื่องมือสำหรับการสร้างฐานข้อมูล FAQ และจัดการ Intent พื้นฐานได้ง่าย
- QnA Maker (Azure): บริการที่ช่วยสร้างฐานความรู้จากเอกสาร FAQ หรือ URL ที่มีอยู่ และเชื่อมต่อกับ Azure Bot Service
- LLM พื้นฐาน: สามารถใช้ LLM ในการจับคู่คำถามของผู้ใช้กับคำถามในฐานข้อมูล FAQ แม้ว่ารูปประโยคจะไม่ตรงกันทั้งหมด
การตั้งค่า:
- อัปโหลดหรือสร้างคู่คำถาม-คำตอบ (Q&A pairs) เข้าสู่ระบบ
- กำหนด Intent หรือหัวข้อสำหรับกลุ่มคำถามที่เกี่ยวข้อง
- ฝึกบอทด้วยรูปแบบคำถามที่หลากหลายสำหรับแต่ละคำตอบ เพื่อเพิ่มความแม่นยำในการจับคู่
- ตั้งค่า "temperature" ของ LLM ให้ต่ำ (เช่น 0 ถึง 0.2) หากใช้ LLM เพื่อตอบ FAQ เพื่อให้คำตอบมีความสอดคล้องและเป็นข้อเท็จจริง
2. การตอบคำถามซับซ้อน (Complex Questions)
เทคนิคและเครื่องมือ:
- LLMs ขั้นสูง: เช่น GPT-4o, GPT-4 Turbo ที่มีความสามารถในการให้เหตุผล (reasoning) และทำความเข้าใจบริบทที่ซับซ้อน
- LangChain Agents: สร้าง Agent ที่สามารถใช้เครื่องมือหลายอย่าง (tools) และวางแผนการทำงาน (plan) เพื่อตอบคำถามที่ต้องการการประมวลผลหลายขั้นตอน
- RAG: ดึงข้อมูลที่เกี่ยวข้องจากฐานความรู้มาเป็นบริบทให้ LLM เพื่อตอบคำถามเชิงลึก
- Multi-step Q&A flows: ออกแบบการสนทนาที่บอทสามารถถามคำถามเพิ่มเติมเพื่อเก็บข้อมูลที่จำเป็นจากผู้ใช้ ก่อนที่จะให้คำตอบสุดท้าย (แพลตฟอร์มอย่าง Juji หรือการเขียนโค้ดเอง)
- Prompt Engineering: ออกแบบ Prompt ที่มีโครงสร้างและรายละเอียดชัดเจน เพื่อชี้นำ LLM ให้สร้างคำตอบที่ตรงประเด็นและมีคุณภาพ
การตั้งค่า:
- ออกแบบ Flow การสนทนาสำหรับคำถามซับซ้อน โดยกำหนดเงื่อนไขและทางเลือกต่างๆ
- สร้าง Prompt ที่มีประสิทธิภาพ เช่น "โปรดตอบคำถามโดยอ้างอิงจากข้อมูลในบริบทต่อไปนี้ หากข้อมูลไม่เพียงพอ โปรดระบุว่า 'ฉันไม่ทราบข้อมูลนี้'"
- จัดการประวัติการสนทนา (Chat History) เพื่อให้บอทเข้าใจคำถามติดตามผล (follow-up questions) ได้อย่างถูกต้อง
3. การสรุปคำศัพท์และเนื้อหา (Summarization)
เทคนิคและเครื่องมือ:
- LLMs: โมเดลส่วนใหญ่มีความสามารถในการสรุปเนื้อหาโดยธรรมชาติ สามารถกำหนดความยาวและรูปแบบการสรุปได้ (เช่น สรุปเป็นย่อหน้า หรือ bullet points)
- เครื่องมือสรุป AI เฉพาะทาง: เช่น QuillBot, SummarizeBot, Notta ซึ่งอาจมีฟีเจอร์เพิ่มเติมสำหรับการสรุปเอกสารหรือบทความ
- LangChain (Summarization Chains): มี Chain สำเร็จรูปสำหรับการสรุปเนื้อหาแบบต่างๆ เช่น "map-reduce" สำหรับเอกสารยาว
การตั้งค่า:
- กำหนด Prompt ให้ชัดเจน เช่น "โปรดสรุปคำศัพท์ [ชื่อคำศัพท์] โดยอธิบายความหมายและการใช้งานใน 2-3 ประโยค" หรือ "สรุปประเด็นสำคัญจากข้อความต่อไปนี้เป็น 5 bullet points"
- สำหรับเอกสารยาว เช่น PDF สามารถใช้ LangChain ร่วมกับ Vector Database เพื่อดึงส่วนที่เกี่ยวข้องมาสรุป
4. การเปรียบเทียบข้อมูลภายในและภายนอก (Data Comparison)
เทคนิคและเครื่องมือ:
- RAG: หัวใจสำคัญในการดึงข้อมูลจากทั้งแหล่งภายใน (เช่น ฐานข้อมูลผลิตภัณฑ์) และภายนอก (เช่น เว็บไซต์รีวิว หรือข้อมูลตลาด)
- Vector Databases: ช่วยในการค้นหาข้อมูลที่เกี่ยวข้องจากทั้งสองแหล่ง
- LLMs: ใช้ในการวิเคราะห์ข้อมูลที่ดึงมาและสร้างข้อความเปรียบเทียบ
- LangChain: สามารถสร้าง Chain ที่ดึงข้อมูลจากหลายแหล่ง ประมวลผล และเปรียบเทียบ
- API Integration: เชื่อมต่อ API เพื่อดึงข้อมูลล่าสุดจากระบบภายในและบริการภายนอก
การตั้งค่า:
- ระบุแหล่งข้อมูลภายในและภายนอกที่ต้องการเปรียบเทียบให้ชัดเจน
- พัฒนาโมดูลสำหรับดึงและประมวลผลข้อมูลจากแต่ละแหล่ง
- ออกแบบ Prompt ให้ LLM ทำการเปรียบเทียบตามเกณฑ์ที่กำหนด เช่น "เปรียบเทียบคุณสมบัติ A, B, C ของผลิตภัณฑ์ X (ข้อมูลภายใน) กับผลิตภัณฑ์ Y (ข้อมูลภายนอกจากเว็บไซต์ Z)"
- พิจารณารูปแบบการแสดงผลการเปรียบเทียบที่เข้าใจง่าย เช่น ตาราง หรือข้อความสรุป
5. การเรียงลำดับข้อมูล (Information Sorting)
เทคนิคและเครื่องมือ:
- LLMs: สามารถเข้าใจและประมวลผลคำสั่งให้เรียงลำดับข้อมูลตามเกณฑ์ต่างๆ (เช่น ตามเวลา ความสำคัญ ตัวอักษร) หากข้อมูลไม่ซับซ้อนมาก
- Programming Logic (Python): หากข้อมูลมีโครงสร้างชัดเจนและต้องการการเรียงลำดับที่ซับซ้อน การเขียนโค้ด (เช่น ใช้ Pandas ใน Python) จะให้ความแม่นยำสูง
- ฐานข้อมูล: คำสั่ง SQL (เช่น ORDER BY) สามารถใช้เรียงลำดับข้อมูลที่จัดเก็บในฐานข้อมูลได้โดยตรง
การตั้งค่า:
- กำหนดเกณฑ์การเรียงลำดับให้ชัดเจนใน Prompt หรือในโค้ด
- ตรวจสอบให้แน่ใจว่าข้อมูลที่นำมาเรียงลำดับอยู่ในรูปแบบที่เหมาะสม (เช่น วันที่ควรอยู่ใน format เดียวกัน)
- หากใช้ LLM ให้ทดสอบความสามารถในการเรียงลำดับกับชุดข้อมูลตัวอย่าง
6. การสร้าง "หนังสือ" พร้อมการอ้างอิง (Content Generation with Citations)
ในที่นี้ "หนังสือ" หมายถึงการสร้างเอกสารหรือรายงานที่มีโครงสร้างชัดเจน รวบรวมข้อมูลจากหลายส่วน และมีการอ้างอิงแหล่งที่มาอย่างถูกต้อง
เทคนิคและเครื่องมือ:
- LLMs: สำหรับการสังเคราะห์เนื้อหา สร้างโครงร่าง และเขียนข้อความในแต่ละส่วน
- LangChain: สร้าง Chain ที่ซับซ้อนสำหรับการรวบรวมข้อมูลจากหลายแหล่ง สังเคราะห์ และจัดรูปแบบเป็นเอกสาร
- RAG: ดึงข้อมูลที่เกี่ยวข้องจากฐานความรู้เพื่อใช้เป็นเนื้อหาหลักและสำหรับการอ้างอิง
- Citation Management Tools/Logic: พัฒนาระบบหรือใช้เครื่องมือที่ช่วยในการบันทึกและแสดงแหล่งที่มาของข้อมูลแต่ละส่วนอย่างถูกต้อง
- Document Generation Libraries (Python): เช่น `reportlab` สำหรับสร้าง PDF, หรือ `python-docx` สำหรับไฟล์ Word เพื่อสร้างผลลัพธ์ในรูปแบบเอกสาร
การตั้งค่า:
- กำหนดโครงสร้างเอกสาร: ออกแบบโครงสร้างของ "หนังสือ" หรือรายงาน (เช่น บทนำ เนื้อหาหลักแต่ละบท สรุป และภาคผนวกอ้างอิง)
- พัฒนากระบวนการรวบรวมข้อมูล: บอทจะต้องสามารถดึงข้อมูลที่เกี่ยวข้องกับแต่ละหัวข้อจากฐานความรู้ภายในและภายนอก
- การสังเคราะห์เนื้อหา: ใช้ LLM ในการเขียนเนื้อหาสำหรับแต่ละส่วน โดยอ้างอิงจากข้อมูลที่รวบรวมมา
- ระบบการอ้างอิง: ทุกครั้งที่นำข้อมูลจากแหล่งใดมาใช้ บอทจะต้องบันทึกแหล่งที่มานั้น และสามารถแสดงรายการอ้างอิงในตอนท้ายของเอกสาร หรือตามจุดที่เหมาะสม (เช่น footnote หรือ inline citation)
- การจัดรูปแบบและการส่งออก: กำหนดรูปแบบของเอกสารสุดท้าย และวิธีการส่งออก (เช่น ดาวน์โหลดเป็น PDF)
การสร้าง "หนังสือ" เป็นฟังก์ชันที่ซับซ้อนที่สุดและอาจต้องใช้การพัฒนาแบบกำหนดเอง (custom development) สูง รวมถึงการออกแบบ Prompt และ Workflow ที่ละเอียดรอบคอบ
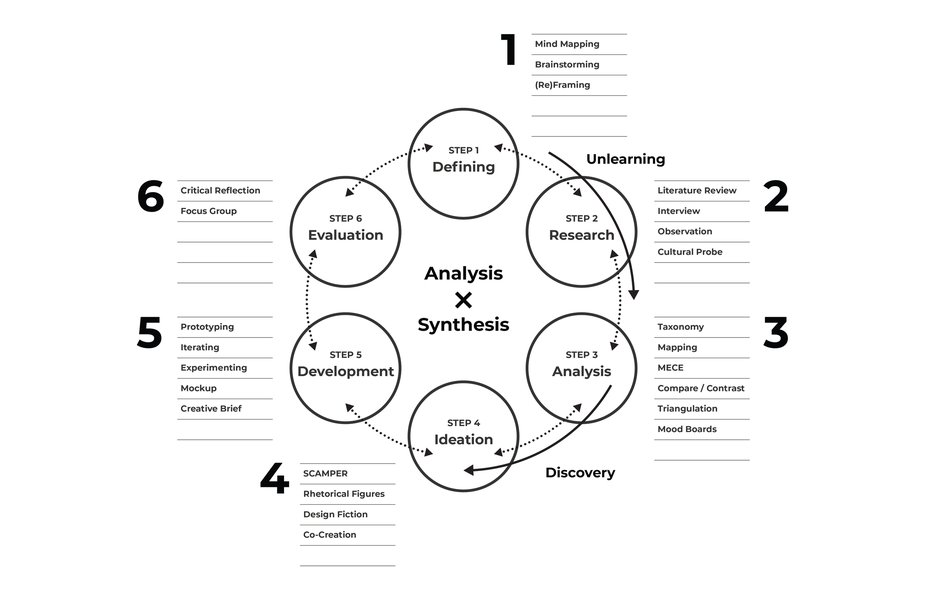
ภาพแสดงแนวคิดกระบวนการสร้างสรรค์และรวบรวมเนื้อหา ซึ่งคล้ายกับการสร้าง "หนังสือ" หรือรายงานที่มีโครงสร้าง
ตารางสรุปเทคโนโลยีและข้อควรพิจารณาสำหรับแต่ละฟังก์ชัน
ตารางด้านล่างนี้สรุปเทคโนโลยีหลักและข้อควรพิจารณาที่สำคัญสำหรับการพัฒนาแต่ละฟังก์ชันของบอท:
| ฟังก์ชันการทำงาน | เทคโนโลยี/เครื่องมือหลัก | ข้อควรพิจารณาสำคัญ |
|---|---|---|
| ตอบคำถามทั่วไป (FAQ) | แพลตฟอร์มสร้างแชทบอท (Botpress, Tidio), QnA Maker (Azure), LLM พื้นฐาน | ความแม่นยำของคำตอบ, การอัปเดตข้อมูล FAQ สม่ำเสมอ, การจัดการ Intent ที่หลากหลาย |
| ตอบคำถามซับซ้อน | LLMs ขั้นสูง (GPT-4o), LangChain Agents, RAG, Multi-step Q&A flows (Juji), Prompt Engineering | ความสามารถในการเข้าใจบริบท, การออกแบบ Prompt ที่ดี, การจัดการการสนทนาต่อเนื่อง, การให้เหตุผลของบอท |
| สรุปคำศัพท์/เนื้อหา | LLMs (GPT-4o), เครื่องมือสรุป AI (QuillBot, SummarizeBot), LangChain (Summarization Chains) | ความกระชับและความถูกต้องของบทสรุป, การคงความหมายเดิม, การรองรับความยาวเอกสารที่หลากหลาย |
| เปรียบเทียบข้อมูล (ภายใน/ภายนอก) | RAG, Vector Databases (ChromaDB), LLMs, LangChain, API Integration | การเข้าถึงและการรวมข้อมูลจากหลายแหล่ง, ความน่าเชื่อถือของข้อมูล, การแสดงผลการเปรียบเทียบที่ชัดเจนและเป็นกลาง |
| เรียงลำดับข้อมูล | LLMs (ความสามารถในการประมวลผลตรรกะ), Python (Pandas), ฟังก์ชันการจัดเรียงในฐานข้อมูล (SQL) | เกณฑ์การเรียงลำดับที่ชัดเจน, การจัดการข้อมูลปริมาณมาก, ความถูกต้องของผลลัพธ์การเรียง |
| สร้าง "หนังสือ" (รายงาน/เอกสารสรุป) | LLMs, LangChain (Document Generation chains), RAG, Citation Management Tools/Logic, Python (สำหรับสร้างเอกสาร เช่น PDF) | การรวบรวมและสังเคราะห์ข้อมูลจำนวนมาก, การจัดโครงสร้างเนื้อหาที่สอดคล้องกัน, ความถูกต้องและความสม่ำเสมอของการอ้างอิง, การจัดการรูปแบบเอกสาร |
การเปรียบเทียบแนวทางการพัฒนาบอทด้วย Radar Chart
เพื่อให้เห็นภาพความแตกต่างของแนวทางการพัฒนาบอทสำหรับฟังก์ชันที่ซับซ้อน Radar Chart ด้านล่างนี้แสดงการประเมิน (ตามความคิดเห็น) ของแพลตฟอร์ม/แนวทางต่างๆ ในมิติต่างๆ เช่น ความง่ายในการใช้งาน การจัดการความซับซ้อน และการเชื่อมต่อข้อมูล ซึ่งจะช่วยให้คุณตัดสินใจเลือกแนวทางที่เหมาะสมกับทรัพยากรและความต้องการของคุณ:
หมายเหตุ: การประเมินใน Radar Chart นี้เป็นเพียงความคิดเห็นเพื่อประกอบการพิจารณา อาจแตกต่างกันไปขึ้นอยู่กับกรณีการใช้งานและประสบการณ์เฉพาะ
การทดสอบ การปรับปรุง และการดูแลรักษา
หลังจากตั้งค่าบอทแล้ว กระบวนการยังไม่สิ้นสุด การทดสอบ ปรับปรุง และดูแลรักษาอย่างต่อเนื่องเป็นสิ่งจำเป็นเพื่อให้บอททำงานได้อย่างมีประสิทธิภาพในระยะยาว
- การทดสอบอย่างสม่ำเสมอ (Regular Testing): ทดสอบบอทด้วยคำถามและสถานการณ์ที่หลากหลาย ทั้งคำถามที่คาดหวังและคำถามที่คาดไม่ถึง เพื่อตรวจสอบความถูกต้องและความครอบคลุมของคำตอบ
- การจัดการข้อผิดพลาดและการส่งต่อ (Error Handling and Escalation): กำหนดกลไกเมื่อบอทไม่สามารถตอบคำถามได้ เช่น การแจ้งให้ผู้ใช้ทราบว่าไม่เข้าใจคำถาม หรือการส่งต่อคำถามไปยังเจ้าหน้าที่ที่เป็นมนุษย์ (Human Handoff)
- การเก็บ Feedback และปรับปรุง (Feedback Loop and Iteration): รวบรวมความคิดเห็นจากผู้ใช้เกี่ยวกับประสบการณ์การใช้งานบอท และนำมาปรับปรุงการทำงาน ฐานความรู้ หรือ Flow การสนทนาอย่างต่อเนื่อง
- การอัปเดตฐานความรู้: ตรวจสอบและอัปเดตข้อมูลในฐานความรู้ให้ทันสมัยอยู่เสมอ โดยเฉพาะข้อมูลที่เปลี่ยนแปลงบ่อย
- การติดตามประสิทธิภาพ (Performance Monitoring): ติดตามตัวชี้วัดต่างๆ เช่น อัตราความสำเร็จในการตอบคำถาม ความพึงพอใจของผู้ใช้ หรือระยะเวลาที่ใช้ในการตอบ เพื่อหาจุดที่ต้องพัฒนา
วิดีโอแนะนำ: การสร้าง Chatbot เพื่อโต้ตอบกับข้อมูลของคุณ
วิดีโอนี้จะให้แนวคิดและภาพรวมเกี่ยวกับการสร้างแชทบอทที่สามารถโต้ตอบกับชุดข้อมูลของคุณได้อย่างมีประสิทธิภาพ ซึ่งเป็นพื้นฐานสำคัญสำหรับการพัฒนาบอทที่สามารถเปรียบเทียบข้อมูลภายในและภายนอก หรือสร้างรายงานสรุปจากข้อมูลเหล่านั้นได้ การทำความเข้าใจหลักการในวิดีโอนี้จะช่วยให้คุณเห็นภาพการนำเทคโนโลยี LLM และการจัดการข้อมูลมาประยุกต์ใช้จริง:
วิดีโอนี้อธิบายเกี่ยวกับการสร้างแชทบอทที่สามารถโต้ตอบกับข้อมูลของคุณได้ (Ultimate Guide to Building Chatbots to Chat with Your Data)
คำถามที่พบบ่อย (FAQ)
ต้องใช้เวลานานแค่ไหนในการสร้างบอทที่มีความสามารถครบถ้วนตามที่อธิบาย?
จำเป็นต้องมีทักษะการเขียนโปรแกรมหรือไม่ในการสร้างบอทเหล่านี้?
ข้อมูลภายในองค์กรจะปลอดภัยหรือไม่เมื่อนำมาใช้กับบอท?
จะจัดการอย่างไรหากบอทให้ข้อมูลที่ไม่ถูกต้อง (Hallucination)?
การสร้าง "หนังสือ" ด้วยบอท หมายถึงการตีพิมพ์หนังสือจริงๆ หรือไม่?
สรุป
การตั้งค่าบอทให้สามารถตอบคำถามทั่วไป คำถามซับซ้อน สรุปคำศัพท์ เปรียบเทียบข้อมูล จัดลำดับเหตุการณ์ และสร้าง "หนังสือ" พร้อมการอ้างอิงข้อมูลทั้งภายในและภายนอก เป็นภารกิจที่ท้าทายแต่สามารถทำได้จริงด้วยการวางแผนที่ดี การเลือกใช้เทคโนโลยีที่เหมาะสม เช่น LLMs, RAG, Vector Databases และเฟรมเวิร์กอย่าง LangChain รวมถึงการพัฒนาฐานความรู้ที่แข็งแกร่ง กระบวนการนี้ต้องอาศัยการทำซ้ำ ทดสอบ และปรับปรุงอย่างต่อเนื่อง เพื่อให้ได้บอทที่มีประสิทธิภาพ ตอบโจทย์ความต้องการของผู้ใช้ และสร้างคุณค่าให้กับองค์กรของคุณได้อย่างแท้จริง
คำแนะนำเพิ่มเติม (Recommended Queries)
- วิธีสร้างฐานความรู้สำหรับแชทบอท RAG อย่างมีประสิทธิภาพควรทำอย่างไร?
- เทคนิค Prompt Engineering ขั้นสูงสำหรับการตอบคำถามซับซ้อนด้วย LLM มีอะไรบ้าง?
- การเปรียบเทียบแพลตฟอร์ม LangChain กับ LlamaIndex ในการสร้างแอปพลิเคชัน AI แตกต่างกันอย่างไร?
- แนวทางการจัดการความปลอดภัยและความเป็นส่วนตัวของข้อมูลในการพัฒนาระบบ AI Chatbot มีอะไรบ้าง?
แหล่งข้อมูลอ้างอิง (Search Results)
 docs.aws.amazon.com
 aws.amazon.com