
بناء صانع مواقع أكاديمية ذكي: دليلك المتكامل لتصحيح ملفات التخرج بالذكاء الاصطناعي
استكشف كيف يمكنك تسخير قوة HTML، CSS، JavaScript، Python، Flask، وهندسة المحفزات لإنشاء أداة مبتكرة تساعد الأساتذة.
أبرز النقاط الرئيسية
- التكامل الشامل للتقنيات: تعلم كيف تجتمع تقنيات الواجهة الأمامية (HTML, CSS, JavaScript) مع قوة الواجهة الخلفية (Python, Flask) لإنشاء تطبيق ويب متكامل.
- دور الذكاء الاصطناعي وهندسة المحفزات: اكتشف كيف يمكن لنماذج الذكاء الاصطناعي تحليل محتوى الملفات، وطرح أسئلة ذكية، وتقديم تقييمات، وكيف أن "هندسة المحفزات" (Prompt Engineering) هي مفتاحك لتوجيه هذه النماذج بفعالية.
- منصة قابلة للتطوير: ابدأ بأساس متين يمكنك تطويره تدريجيًا ليشمل ميزات متقدمة مثل دعم أنواع ملفات متعددة، وتكامل واجهات برمجة تطبيقات (APIs) لنماذج لغوية أكثر تطوراً، وتخصيص تجربة المستخدم.
فهم المكونات الأساسية لنظام التصحيح الذكي
يتطلب بناء نظام متطور لتصحيح ملفات التخرج بالذكاء الاصطناعي فهماً واضحاً للمكونات المختلفة التي تعمل معاً. دعنا نستعرض هذه المكونات:
1. الواجهة الأمامية (Frontend): بوابة التفاعل للمستخدم
الواجهة الأمامية هي ما يراه المستخدم ويتفاعل معه مباشرة في المتصفح. هي مسؤولة عن عرض المعلومات وتمكين المستخدم (الأستاذ في حالتنا) من التفاعل مع النظام.
- HTML (HyperText Markup Language): تُستخدم لبناء هيكل صفحات الويب، مثل تحديد أماكن مربعات إدخال النصوص، الأزرار، ومناطق عرض النتائج.
- CSS (Cascading Style Sheets): تُعنى بتصميم ومظهر الموقع، من الألوان والخطوط إلى تخطيط العناصر وتجاوبها مع مختلف أحجام الشاشات.
- JavaScript: تضيف التفاعلية إلى الموقع. تُستخدم لمعالجة إدخالات المستخدم، إرسال واستقبال البيانات من الخادم دون الحاجة لإعادة تحميل الصفحة (باستخدام AJAX)، وتحديث المحتوى ديناميكياً.
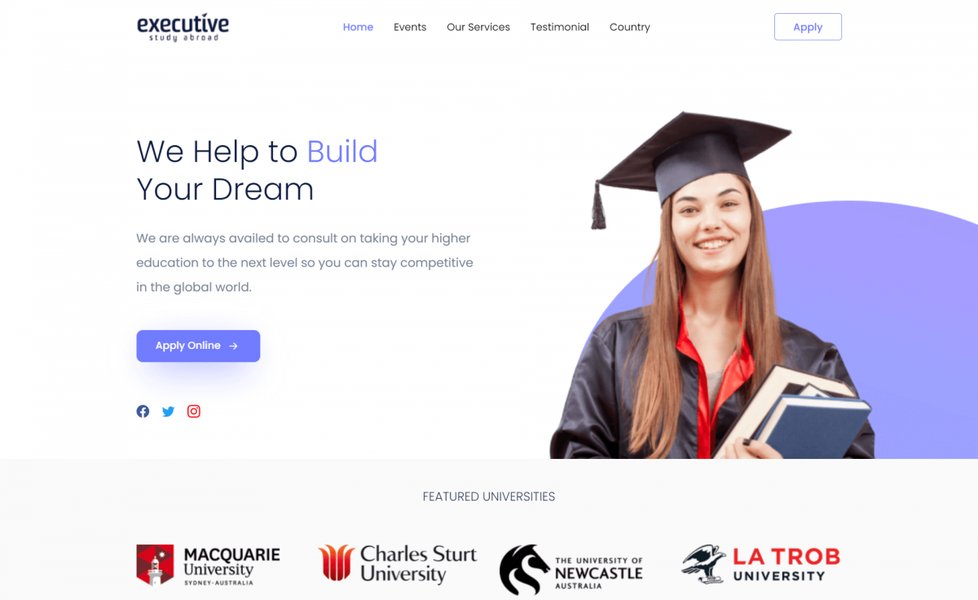
مثال لواجهة موقع أكاديمي يمكن تكييفها لتضمين أدوات التصحيح الذكية.
2. الواجهة الخلفية (Backend): المحرك الخفي للنظام
الواجهة الخلفية تعمل على الخادم وتتعامل مع المنطق الأساسي للتطبيق، معالجة البيانات، والتفاعل مع قواعد البيانات أو نماذج الذكاء الاصطناعي.
- Python: لغة برمجة قوية ومتعددة الاستخدامات، تتميز ببساطتها وقوة مكتباتها، مما يجعلها خياراً ممتازاً لتطوير الواجهة الخلفية ولمهام الذكاء الاصطناعي.
- Flask: إطار عمل ويب خفيف الوزن ومبني بلغة Python. يوفر الأدوات الأساسية لبناء تطبيقات الويب بسرعة وكفاءة، ويتيح لك تحديد كيفية معالجة الطلبات من المستخدمين، إدارة الملفات، والتواصل مع خدمات أخرى.
3. تكامل الذكاء الاصطناعي وهندسة المحفزات (Prompt Engineering)
هذا هو قلب النظام الذكي. يهدف إلى تحليل محتوى ملفات التخرج، طرح أسئلة ذات صلة، وتقييم الإجابات المحتملة داخل الملف.
- نماذج اللغة الكبيرة (LLMs): هي نماذج ذكاء اصطناعي متقدمة (مثل نماذج GPT) يمكنها فهم وتوليد النصوص. يمكنك استخدامها لتحليل محتوى الملف، استخلاص المعلومات الرئيسية، صياغة أسئلة بناءً على هذا المحتوى، وحتى تقييم مدى دقة أجزاء معينة من النص.
- استخلاص النصوص: قبل أن يتمكن الذكاء الاصطناعي من تحليل الملف، يجب استخلاص النص منه. ستحتاج إلى مكتبات يمكنها التعامل مع صيغ ملفات شائعة مثل PDF (باستخدام
PyPDF2أوpdfplumber) و DOCX (باستخدامpython-docx). - هندسة المحفزات (Prompt Engineering): هي فن وعلم صياغة المدخلات (المحفزات أو Prompts) التي توجه نموذج الذكاء الاصطناعي لإنتاج المخرجات المطلوبة. في سياقنا، هذا يعني تصميم محفزات دقيقة تطلب من النموذج، على سبيل المثال، "حلل هذا القسم من ملف التخرج واقترح ثلاثة أسئلة يمكن طرحها على الطالب حول منهجية البحث المستخدمة" أو "قيّم مدى اتساق هذه الفقرة مع الأهداف المعلنة للمشروع". جودة المحفزات تؤثر بشكل مباشر على جودة ودقة استجابات الذكاء الاصطناعي.
تصور لمفهوم دمج الذكاء الاصطناعي في تصميم واجهات المستخدم، وهو أمر أساسي لأداتك.
خطوات تطوير الأداة: من الفكرة إلى التنفيذ الأولي
سنقدم هنا مثالاً مبسطاً لكيفية بناء الهيكل الأساسي لتطبيقك. هذا المثال يركز على توضيح تدفق العمل بين الواجهة الأمامية والخلفية، مع ترك مساحة لتكامل نماذج ذكاء اصطناعي أكثر تعقيدًا.
1. إعداد هيكل المشروع
قم بإنشاء مجلد لمشروعك بالهيكل التالي:
/academic_corrector_project/
  ├── app.py                 # ملف بايثون الرئيسي لتطبيق Flask
  ├── templates/
  │    └── index.html        # ملف HTML للواجهة الأمامية
  ├── static/
  │    ├── style.css         # ملف CSS للتصميم
  │    └── script.js         # ملف JavaScript للتفاعلية
  └── uploads/               # مجلد لتخزين الملفات المرفوعة مؤقتًا
2. تطوير الواجهة الأمامية
أ. ملف templates/index.html
هذا الملف يمثل الهيكل الأساسي لصفحة الويب التي سيراها الأستاذ.
<!DOCTYPE html>
<html lang="ar" dir="rtl">
<head>
    <meta charset="UTF-8">
    <meta name="viewport" content="width=device-width, initial-scale=1.0">
    <title>أداة تصحيح ملفات التخرج الذكية</title>
    <link rel="stylesheet" href="{{ url_for('static', filename='style.css') }}">
</head>
<body>
    <div class="container">
        <h1>تصحيح ملفات التخرج بالذكاء الاصطناعي</h1>
        <p>قم برفع ملف التخرج (يفضل بصيغة نصية TXT أو PDF مبسط حاليًا) ليقوم النظام بتحليله وطرح أسئلة مقترحة.</p>

        <form id="upload-form" enctype="multipart/form-data">
            <div class="form-group">
                <label for="file">اختر ملف التخرج:</label>
                <input type="file" id="file" name="file" accept=".txt,.pdf" required>
            </div>
            <button type="submit">تحليل الملف</button>
        </form>

        <div id="results-area" style="display:none;">
            <h3>نتائج التحليل والأسئلة المقترحة:</h3>
            <div id="analysis-output"></div>
        </div>
        <div id="loading-spinner" style="display:none; text-align:center; margin-top:20px;">
             <p>جاري التحليل، يرجى الانتظار...</p>
        </div>
    </div>
    <script src="{{ url_for('static', filename='script.js') }}"></script>
</body>
</html>
ب. ملف static/style.css
يستخدم هذا الملف لتطبيق بعض الأنماط الأساسية لجعل الواجهة أكثر ترتيبًا.
body {
    font-family: 'Segoe UI', Tahoma, Geneva, Verdana, sans-serif;
    background-color: #f4f7f6;
    color: #333;
    margin: 0;
    padding: 20px;
    direction: rtl;
}

.container {
    max-width: 800px;
    margin: 20px auto;
    background-color: #fff;
    padding: 30px;
    border-radius: 8px;
    box-shadow: 0 4px 15px rgba(0, 0, 0, 0.1);
}

h1 {
    color: #2c3e50; /* استخدم لون H1 المخصص إذا كنت لا تستخدم style attribute */
    text-align: center;
    margin-bottom: 20px;
}

.form-group {
    margin-bottom: 20px;
}

label {
    display: block;
    margin-bottom: 8px;
    font-weight: bold;
    color: #555;
}

input[type="file"] {
    display: block;
    width: calc(100% - 22px);
    padding: 10px;
    border: 1px solid #ddd;
    border-radius: 4px;
    box-sizing: border-box;
}

button[type="submit"] {
    background-color: #388278; /* لون H3 */
    color: white;
    padding: 12px 25px;
    border: none;
    border-radius: 4px;
    cursor: pointer;
    font-size: 1em;
    transition: background-color 0.3s ease;
}

button[type="submit"]:hover {
    background-color: #2c6b61;
}

#results-area {
    margin-top: 30px;
    padding: 20px;
    background-color: #eef2f3;
    border-radius: 6px;
    border: 1px solid #d1d9db;
}

#analysis-output p, #analysis-output ul {
    margin-bottom: 10px;
    line-height: 1.6;
}
ج. ملف static/script.js
هذا الملف يحتوي على الكود الذي يتعامل مع رفع الملف وعرض النتائج ديناميكيًا.
document.getElementById('upload-form').addEventListener('submit', async function(event) {
    event.preventDefault(); // منع الإرسال التقليدي للنموذج

    const fileInput = document.getElementById('file');
    const resultsArea = document.getElementById('results-area');
    const analysisOutput = document.getElementById('analysis-output');
    const loadingSpinner = document.getElementById('loading-spinner');

    if (fileInput.files.length === 0) {
        analysisOutput.innerHTML = '<p style="color: red;">يرجى اختيار ملف أولاً.</p>';
        resultsArea.style.display = 'block';
        return;
    }

    const formData = new FormData();
    formData.append('file', fileInput.files[0]);

    resultsArea.style.display = 'none';
    loadingSpinner.style.display = 'block';
    analysisOutput.innerHTML = ''; // مسح النتائج السابقة

    try {
        const response = await fetch('/analyze', { // تأكد أن المسار يطابق ما في Flask
            method: 'POST',
            body: formData
        });

        loadingSpinner.style.display = 'none';
        resultsArea.style.display = 'block';

        if (response.ok) {
            const data = await response.json();
            if (data.error) {
                analysisOutput.innerHTML = `<p style="color: red;">خطأ: ${data.error}</p>`;
            } else {
                let htmlContent = `<h4>ملخص المحتوى المستخرج (عينة):</h4>`;
                htmlContent += `<p>${data.extracted_text_sample}...</p>`;
                htmlContent += `<h4>الأسئلة المقترحة من الذكاء الاصطناعي:</h4>`;
                if (data.questions && data.questions.length > 0) {
                    htmlContent += '<ul>';
                    data.questions.forEach(q => {
                        htmlContent += `<li>${q}</li>`;
                    });
                    htmlContent += '</ul>';
                } else {
                    htmlContent += '<p>لم يتمكن الذكاء الاصطناعي من توليد أسئلة لهذا الملف حاليًا.</p>';
                }
                analysisOutput.innerHTML = htmlContent;
            }
        } else {
            const errorData = await response.json();
            analysisOutput.innerHTML = `<p style="color: red;">حدث خطأ في الخادم: ${errorData.error || response.statusText}</p>`;
        }
    } catch (error) {
        loadingSpinner.style.display = 'none';
        resultsArea.style.display = 'block';
        analysisOutput.innerHTML = `<p style="color: red;">فشل الاتصال بالخادم: ${error.message}</p>`;
        console.error('Error during fetch:', error);
    }
});
3. تطوير الواجهة الخلفية (Python/Flask)
ملف app.py
هذا هو قلب تطبيقك على الخادم. سيقوم باستقبال الملفات، ومعالجتها (مبدئيًا)، والتفاعل مع "محرك الذكاء الاصطناعي" (الذي سنقوم بمحاكاته هنا).
from flask import Flask, request, jsonify, render_template
import os
# لمزيد من التقدم، ستحتاج إلى مكتبات مثل:
# import PyPDF2  # لقراءة ملفات PDF
# from docx import Document # لقراءة ملفات DOCX
# import openai # للتفاعل مع نماذج GPT (يتطلب مفتاح API)

app = Flask(__name__)
app.config['UPLOAD_FOLDER'] = 'uploads'
app.config['MAX_CONTENT_LENGTH'] = 16 * 1024 * 1024 # حد أقصى 16 ميجابايت للملف

# التأكد من وجود مجلد الرفع
if not os.path.exists(app.config['UPLOAD_FOLDER']):
    os.makedirs(app.config['UPLOAD_FOLDER'])

def extract_text_from_file(filepath):
    """
    دالة لاستخلاص النص من الملفات.
    هذه نسخة مبسطة جدًا. في الواقع، ستحتاج إلى معالجة أنواع ملفات مختلفة.
    """
    try:
        # مثال بسيط لملفات TXT. يجب توسيعه لدعم PDF, DOCX, إلخ.
        if filepath.lower().endswith('.txt'):
            with open(filepath, 'r', encoding='utf-8') as f:
                return f.read()
        # elif filepath.lower().endswith('.pdf'):
            # استخدم PyPDF2 أو مكتبة أخرى هنا
            # return "نص مستخرج من PDF (مثال)"
        else:
            return "صيغة الملف غير مدعومة حاليًا للاستخلاص المباشر."
    except Exception as e:
        print(f"Error extracting text: {e}")
        return "حدث خطأ أثناء استخلاص النص."

def call_ai_model_for_analysis(text_content):
    """
    محاكاة لدالة تتفاعل مع نموذج ذكاء اصطناعي.
    هنا يجب تطبيق "هندسة المحفزات" (Prompt Engineering).
    """
    # مثال على محفز (Prompt) بسيط جداً
    # prompt = f"بناءً على النص التالي: '{text_content[:1000]}...', قم بصياغة 3 أسئلة تحليلية حول المنهجية المستخدمة."

    # في تطبيق حقيقي، سترسل هذا المحفز والنص إلى API لنموذج لغوي (مثل OpenAI GPT)
    # وتستقبل الرد الذي يحتوي على الأسئلة المقترحة.

    # لأغراض العرض، سنعيد أسئلة ثابتة:
    questions = [
        "ما هي المشكلة الرئيسية التي يعالجها هذا البحث؟ (سؤال محاكاة)",
        "هل تم توضيح المنهجية المستخدمة بشكل كافٍ؟ (سؤال محاكاة)",
        "ما هي أبرز النتائج التي توصل إليها الباحث؟ (سؤال محاكاة)"
    ]

    # يمكن للنموذج أيضاً تقييم أجزاء من النص أو البحث عن إجابات محددة
    # بناءً على أسئلة يطرحها الأستاذ.

    return questions

@app.route('/')
def index():
    return render_template('index.html')

@app.route('/analyze', methods=['POST'])
def analyze_file_route():
    if 'file' not in request.files:
        return jsonify({'error': 'لم يتم إرسال أي ملف'}), 400

    file = request.files['file']
    if file.filename == '':
        return jsonify({'error': 'لم يتم اختيار أي ملف'}), 400

    if file:
        filename = file.filename # استخدم اسم الملف الأصلي أو قم بتأمينه
        filepath = os.path.join(app.config['UPLOAD_FOLDER'], filename)

        try:
            file.save(filepath)

            # الخطوة 1: استخلاص النص من الملف
            extracted_text = extract_text_from_file(filepath)

            if "صيغة الملف غير مدعومة" in extracted_text or "حدث خطأ" in extracted_text:
                 return jsonify({'error': extracted_text, 'extracted_text_sample': '', 'questions': []}), 400

            # الخطوة 2: إرسال النص إلى نموذج الذكاء الاصطناعي للتحليل وتوليد الأسئلة
            # (هذه هي الدالة التي تحتاج إلى تطبيق Prompt Engineering فيها)
            suggested_questions = call_ai_model_for_analysis(extracted_text)

            # تنظيف: إزالة الملف بعد المعالجة (اختياري، يعتمد على متطلباتك)
            # os.remove(filepath)

            return jsonify({
                'message': 'تم تحليل الملف بنجاح!',
                'extracted_text_sample': extracted_text[:500], # إرسال عينة من النص
                'questions': suggested_questions
            })

        except Exception as e:
            # os.remove(filepath) # تأكد من الحذف حتى في حالة الخطأ إذا كان الملف قد حُفظ
            return jsonify({'error': f'حدث خطأ أثناء معالجة الملف: {str(e)}'}), 500

    return jsonify({'error': 'خطأ غير معروف'}), 500

if __name__ == '__main__':
    app.run(debug=True) # debug=True للتطوير فقط
ملاحظة هامة: الكود أعلاه يقدم أساسًا بسيطًا. في تطبيق حقيقي، ستحتاج إلى:
- مكتبات متخصصة لاستخلاص النصوص من PDF وملفات DOCX (مثل `PyPDF2`, `python-docx`).
- التكامل مع واجهة برمجة تطبيقات (API) لنموذج لغوي كبير (مثل OpenAI GPT, Claude, أو نماذج مفتوحة المصدر عبر Hugging Face).
- تطبيق تقنيات "هندسة المحفزات" بشكل متقدم في دالة `call_ai_model_for_analysis` لتوجيه النموذج لإنشاء أسئلة دقيقة وذات صلة بمحتوى الملف.
- إدارة الأخطاء بشكل أكثر شمولاً وأمانًا.
تصور النظام: الهيكل العام وعوامل النجاح الأساسية
لفهم أفضل لكيفية عمل النظام المقترح والعناصر المؤثرة في فعاليته، دعنا نلقي نظرة على هيكله العام والعوامل الرئيسية لنجاحه.
الهيكل العام للنظام (Mindmap)
يُظهر المخطط الذهني التالي المكونات الرئيسية لنظام تصحيح الملفات الأكاديمية بالذكاء الاصطناعي والعلاقات بينها. يوضح كيف تتفاعل الواجهة الأمامية مع الواجهة الخلفية، وكيف يتم دمج محرك الذكاء الاصطناعي لإجراء التحليلات المطلوبة.
بالذكاء الاصطناعي"] id1["الواجهة الأمامية (User Interface)"] id1_1["HTML: هيكل الصفحة"] id1_2["CSS: تصميم وجاذبية بصرية"] id1_3["JavaScript: تفاعلية المستخدم
(رفع الملفات، عرض النتائج)"] id2["الواجهة الخلفية (Server Logic)"] id2_1["Python + Flask: إطار العمل"] id2_2["API Endpoints:
(/analyze لمعالجة الملفات)"] id2_3["معالجة الملفات:
(استقبال، تخزين مؤقت، حذف)"] id2_4["استخلاص النصوص:
(من PDF, DOCX, TXT)"] id3["محرك الذكاء الاصطناعي الأساسي"] id3_1["نماذج اللغة الكبيرة (LLMs)"] id3_2["هندسة المحفزات (Prompt Engineering):
صياغة طلبات دقيقة للنماذج"] id3_3["تحليل المحتوى:
(فهم، تلخيص، تحديد نقاط رئيسية)"] id3_4["توليد الأسئلة الذكية"] id3_5["تقييم الإجابات (متقدم)"] id4["إدارة البيانات (اختياري/متقدم)"] id4_1["تخزين الملفات (دائم)"] id4_2["قاعدة بيانات:
(لتخزين معلومات المستخدمين،
تاريخ التحليلات)"]
يوضح هذا المخطط كيف تتكامل العناصر المختلفة، بدءًا من تفاعل المستخدم مع الواجهة الأمامية، مرورًا بمعالجة الطلبات والملفات في الواجهة الخلفية، وصولاً إلى قلب النظام وهو محرك الذكاء الاصطناعي الذي يقوم بالتحليل الفعلي وتوليد الأسئلة بناءً على هندسة محفزات متقنة.
عوامل النجاح الرئيسية (Radar Chart)
يقارن المخطط الشعاعي التالي بين الأداء المتوقع لنظام مثالي ونظام أساسي مبدئي عبر عدة عوامل حاسمة لنجاح أداة تصحيح الملفات الأكاديمية بالذكاء الاصطناعي. كلما اقتربت النقطة من الحافة الخارجية، كان الأداء أفضل في ذلك العامل.
يُظهر هذا المخطط أن "النظام المثالي" يتطلب أداءً عاليًا في جميع الجوانب، خاصة في دقة استخلاص النص، وقدرات النموذج اللغوي، وجودة هندسة المحفزات. بينما "التنفيذ الأساسي" قد يبدأ بمستويات أقل، مع التركيز على سهولة الاستخدام الأولية، ثم يتطور تدريجيًا. الهدف هو السعي نحو تحسين كل هذه العوامل لتوفير أداة قوية وموثوقة.
مقارنة بين نُهج معالجة النصوص بالذكاء الاصطناعي
عند دمج الذكاء الاصطناعي لتحليل النصوص وتوليد الأسئلة، هناك عدة نُهج يمكن اتباعها. الجدول التالي يقارن بين بعض هذه النُهج لمساعدتك في اختيار الأنسب لمشروعك:
| النهج (Approach) | المزايا | العيوب | أدوات/مكتبات أمثلة |
|---|---|---|---|
| الأنظمة القائمة على القواعد (Rule-based Systems) | تحكم كامل ودقيق، شفافية في القرارات. | صعبة الصيانة والتطوير لتغطية كل الحالات، غير مرنة مع النصوص المتنوعة. | تطوير مخصص باستخدام تعابير نمطية (Regex)، SpaCy (ميزات مطابقة القواعد). |
| التعلم الآلي الأساسي (Basic Machine Learning) | أسهل في التعامل مع التنوع اللغوي من القواعد الصرفة، يمكن تدريبها على بيانات محددة. | قد لا تفهم السياقات المعقدة أو الفروق الدقيقة، تتطلب بيانات تدريب جيدة. | TextBlob (للتصحيح الإملائي البسيط، تحليل المشاعر)، Scikit-learn (لتصنيف النصوص). |
| نماذج لغوية كبيرة متقدمة (Advanced LLMs via API) | فهم عميق للسياق، قدرة عالية على توليد نصوص وأسئلة معقدة، مرونة كبيرة. | قد تكون مكلفة (تكلفة استخدام API)، تتطلب هندسة محفزات جيدة، قد تنتج "هلوسات" (معلومات غير دقيقة). | OpenAI GPT series (GPT-3.5, GPT-4), Anthropic Claude, Google Gemini. |
| نماذج لغوية كبيرة مفتوحة المصدر (Open Source LLMs) | لا توجد تكلفة API مباشرة، إمكانية التخصيص والضبط الدقيق (Fine-tuning) على بياناتك. | تتطلب موارد حوسبة كبيرة للتشغيل والتدريب، قد تكون أقل قوة من النماذج التجارية الكبرى دون ضبط دقيق. | نماذج من Hugging Face (مثل Llama, Mistral) يمكن تشغيلها محليًا أو على خوادم خاصة. |
| النهج الهجينة (Hybrid Approaches) | تجمع بين قوة النماذج المختلفة (مثلاً استخدام قواعد لتصفية أولية ثم LLM للتحليل العميق). | قد تكون أكثر تعقيدًا في التصميم والتنفيذ. | مزيج من الأدوات المذكورة أعلاه. |
يعتمد اختيار النهج على متطلبات مشروعك، الميزانية المتاحة، ومستوى الدقة والتعقيد المطلوب. غالبًا ما يكون البدء بنموذج أبسط ثم الترقية تدريجيًا استراتيجية جيدة.
إلهام إضافي: بناء منصة أكاديمية متكاملة
بينما يركز طلبك على أداة تصحيح محددة، فإن فهم كيفية بناء مواقع أكاديمية بشكل عام يمكن أن يوفر لك سياقًا أوسع لتطوير منصتك. الفيديو التالي يقدم نظرة عامة حول بناء موقع أكاديمي، والذي يمكن أن يكون هو "المنزل" الذي تستضيف فيه أداتك المبتكرة للتصحيح الذكي. فكر في كيف يمكن دمج أداة التصحيح كجزء من نظام أكبر يدعم الأنشطة الأكاديمية المختلفة.
هذا الفيديو بعنوان "Stand Out Skills: Build Your Own Academic Website" يستعرض أهمية وفوائد إنشاء موقع ويب أكاديمي شخصي أو بحثي. على الرغم من أنه لا يغوص في تفاصيل برمجة أدوات الذكاء الاصطناعي، إلا أنه يمنحك أفكارًا حول كيفية تقديم عملك وأدواتك (مثل أداة التصحيح التي تبنيها) بشكل احترافي عبر الإنترنت. يمكنك اعتبار منصة الموقع الأكاديمي هي الواجهة التي من خلالها يصل الأساتذة إلى أداة التصحيح الخاصة بك، وربما ميزات أخرى تضيفها مستقبلاً.
اعتبارات متقدمة وتحسينات مستقبلية
بمجرد بناء النسخة الأولية من أداتك، هناك العديد من الطرق لتحسينها وتوسيع قدراتها:
- دعم أنواع ملفات متعددة: تحسين استخلاص النصوص من ملفات PDF المعقدة (التي تحتوي على صور وجداول) وملفات DOCX.
- واجهة مستخدم تفاعلية غنية: استخدام مكتبات JavaScript متقدمة (مثل React, Vue, أو Angular) لبناء واجهة أكثر تفاعلية وسلاسة.
- تكامل مع أنظمة إدارة التعلم (LMS): ربط أداتك مع منصات مثل Moodle أو Blackboard.
- قاعدة بيانات: حفظ سجلات التحليل، تفضيلات المستخدمين، أو حتى إنشاء قاعدة بيانات معرفية من الملفات المصححة (مع مراعاة الخصوصية).
- نظام حسابات للمستخدمين: لتخصيص التجربة وحفظ الإعدادات لكل أستاذ.
- تحسينات أمنية: ضمان أمان تحميل الملفات وحماية خصوصية البيانات.
- التدريب الدقيق (Fine-tuning) لنماذج الذكاء الاصطناعي: إذا كنت تستخدم نماذج مفتوحة المصدر، يمكنك تدريبها بشكل دقيق على مجموعة من ملفات التخرج والأسئلة الجيدة لتحسين أدائها في سياقك المحدد.
- إمكانية تحديد معايير التصحيح: السماح للأساتذة بتحديد معايير أو نقاط تركيز معينة ليقوم الذكاء الاصطناعي بالتركيز عليها.
أسئلة شائعة (FAQ)
ما هي "هندسة المحفزات" (Prompt Engineering) وكيف تساعد في هذا النظام؟ +
هندسة المحفزات هي عملية تصميم وتكرير المدخلات (المحفزات) التي تُعطى لنماذج الذكاء الاصطناعي (مثل نماذج اللغة الكبيرة) لتوجيهها نحو إنتاج المخرجات المطلوبة. في سياق أداة تصحيح ملفات التخرج، هذا يعني صياغة أسئلة أو تعليمات واضحة للنموذج، مثل: "حلل هذا القسم من النص وحدد أي تناقضات منطقية" أو "اقترح ثلاثة أسئلة يمكن طرحها على الطالب بخصوص هذه النتائج". جودة المحفزات تؤثر بشكل كبير على دقة وفائدة استجابات الذكاء الاصطناعي.
ما مدى دقة الذكاء الاصطناعي في تصحيح الملفات الأكاديمية وفهم محتواها؟ +
تعتمد دقة الذكاء الاصطناعي على عدة عوامل، بما في ذلك جودة النموذج اللغوي المستخدم، دقة استخلاص النص من الملف، وفعالية هندسة المحفزات. النماذج المتقدمة يمكنها فهم السياق بشكل جيد واقتراح تحسينات أو طرح أسئلة ذات صلة. ومع ذلك، لا يزال الإشراف البشري (من قبل الأستاذ) ضروريًا للتحقق من صحة اقتراحات الذكاء الاصطناعي، خاصة في المجالات الأكاديمية المتخصصة. يجب اعتبار الذكاء الاصطناعي أداة مساعدة قوية وليس بديلاً كاملاً عن الخبرة البشرية.
هل يمكنني استخدام نماذج ذكاء اصطناعي مفتوحة المصدر بدلاً من الخدمات المدفوعة؟ +
نعم، هناك العديد من نماذج الذكاء الاصطناعي مفتوحة المصدر المتاحة (مثلاً عبر Hugging Face) التي يمكنك استخدامها. الميزة الرئيسية هي عدم وجود تكاليف API مباشرة والقدرة على تشغيلها على بنيتك التحتية الخاصة، مما يمنحك تحكمًا أكبر في البيانات. ومع ذلك، قد تتطلب هذه النماذج موارد حاسوبية كبيرة (وحدات معالجة رسومات GPU قوية) للتشغيل بكفاءة، وقد تحتاج إلى "ضبط دقيق" (fine-tuning) على بياناتك الخاصة لتحقيق أداء مماثل للنماذج التجارية الكبيرة في مهام محددة. الخيار يعتمد على ميزانيتك، خبرتك التقنية، ومتطلبات الخصوصية.
ما هي أبرز التحديات في بناء أداة كهذه؟ +
تشمل التحديات الرئيسية:
- دقة استخلاص النص: خاصة من ملفات PDF المعقدة التي تحتوي على جداول وصور ومعادلات.
- فهم السياق الأكاديمي المتخصص: قد تحتاج النماذج العامة إلى توجيه دقيق (عبر هندسة المحفزات) أو تدريب إضافي لفهم المصطلحات والمفاهيم الخاصة بمجال معين.
- التعامل مع الإجابات الغامضة أو المفتوحة: تقييم الإجابات التي ليست مجرد "صحيح" أو "خطأ" يتطلب نماذج متطورة.
- خصوصية وأمان البيانات: ملفات التخرج تحتوي على معلومات حساسة ويجب التعامل معها بأمان.
- تكلفة الموارد: استخدام واجهات برمجة التطبيقات لنماذج لغوية قوية يمكن أن يكون مكلفًا، وتشغيل النماذج المفتوحة المصدر يتطلب بنية تحتية قوية.
- توقعات المستخدم: تحقيق توازن بين قدرات الذكاء الاصطناعي الحالية وتوقعات الأساتذة.
استكشافات موصى بها لتعميق فهمك
- كيفية تحسين دقة استخلاص النصوص من ملفات PDF باستخدام Python.
- أفضل ممارسات هندسة المحفزات لنماذج GPT في السياقات الأكاديمية.
- مقارنة بين أطر عمل Python Flask و Django لتطبيقات الويب المعتمدة على الذكاء الاصطناعي.
- استراتيجيات تأمين تطبيقات الويب التي تتعامل مع بيانات أكاديمية حساسة.
المراجع والمصادر
Last updated May 10, 2025