
Создание AI-интегратора в России: Как выбрать бесплатный и доступный технологический стек?
Ваш гид по выбору Open Source инструментов для AI-агентов, доступных на территории РФ и не требующих затрат на лицензии.
Ключевые моменты
- Приоритет Open Source: Используйте решения с открытым исходным кодом для максимальной доступности, гибкости и экономии в условиях российского рынка.
- Фокус на проверенные фреймворки: Сосредоточьтесь на таких инструментах, как LangChain, Auto-GPT и SuperAGI для разработки и управления AI-агентами.
- Использование российских разработок: Обратите внимание на отечественные LLM (Yandex, Sber GigaChat) и библиотеки (CatBoost, ClickHouse) для лучшей адаптации и снижения зависимости от зарубежных платформ.
Почему Open Source — ваш лучший выбор в России?
При создании компании по интеграции AI-агентов в российские предприятия выбор технологического стека играет решающую роль. Ориентация на бесплатные и доступные в РФ технологии — это стратегическое преимущество. Решения с открытым исходным кодом (Open Source) идеально отвечают этим требованиям по нескольким причинам:
- Экономия: Отсутствие лицензионных платежей существенно снижает стартовые и операционные расходы.
- Доступность: Open Source проекты обычно доступны для скачивания и использования без географических ограничений, что особенно важно в текущих условиях. Их можно развертывать на локальных серверах или в российских облаках.
- Гибкость и контроль: Открытый код позволяет адаптировать инструменты под конкретные нужды клиентов, вносить изменения и не зависеть от политики одного вендора.
- Сообщество и поддержка: Многие популярные Open Source проекты имеют активные сообщества разработчиков, предоставляющие поддержку, документацию и готовые решения.
- Российская экосистема: В России активно развивается собственная экосистема Open Source AI. Компании, такие как Яндекс, Сбер, VK, вносят вклад в разработку инструментов и моделей, а также предоставляют инфраструктуру и даже грантовую поддержку для разработчиков.
Таким образом, ставка на Open Source не только решает проблему доступности и бесплатности, но и открывает возможности для создания гибких, кастомизируемых и устойчивых AI-решений для российского бизнеса.
Рекомендуемый технологический стек для AI-интегратора
Основываясь на анализе доступных Open Source решений и их применимости в России по состоянию на май 2025 года, предлагается следующий стек технологий:
Основные фреймворки для разработки AI-агентов
Гибкие инструменты для создания интеллектуальных систем
Это ядро вашей системы, позволяющее создавать, управлять и оркестрировать работу AI-агентов.
- LangChain: Самый популярный и универсальный Open Source фреймворк. Позволяет создавать сложные цепочки (chains) и агентов, интегрируя LLM, инструменты и источники данных. Обладает обширной документацией и большим сообществом. Активно используется в России благодаря своей гибкости.
- Auto-GPT / AgentGPT: Фреймворки для создания автономных агентов, способных самостоятельно ставить и выполнять задачи для достижения поставленной цели. Хорошо подходят для автоматизации сложных процессов без постоянного вмешательства человека.
- SuperAGI: Ориентированный на разработчиков фреймворк для создания, развертывания и управления автономными агентами. Предоставляет инструменты для мониторинга и отладки.
- CrewAI: Фреймворк для организации совместной работы нескольких AI-агентов над одной задачей. Позволяет создавать "команды" агентов с разными ролями.
Большие языковые модели (LLM)
"Мозг" ваших AI-агентов
LLM отвечают за понимание языка, генерацию текста и принятие решений агентом.
- Глобальные Open Source LLM: Модели, такие как Llama (Meta), Mistral, Qwen (Alibaba), Phi (Microsoft), Gemma (Google) являются мощными и бесплатными альтернативами проприетарным моделям вроде GPT-4. Их можно разворачивать локально или на российских серверах.
- Российские LLM:
- YandexGPT API / YaLM: Модели от Яндекса, адаптированные для русского языка и контекста. Яндекс также выпускает Open Source инструменты для обучения моделей.
- GigaChat API (Sber): Модель и платформа от Сбера, также с фокусом на русский язык. Предоставляет API для интеграции.
Библиотеки машинного обучения (ML)
Инструменты для обучения и тонкой настройки моделей
- PyTorch / TensorFlow: Стандартные Open Source библиотеки для глубокого обучения. PyTorch часто предпочитают за его гибкость и простоту интеграции в Python-проекты, включая фреймворки для AI-агентов. Обе библиотеки широко используются в России.
- CatBoost (Yandex): Высокопроизводительная Open Source библиотека градиентного бустинга от Яндекса. Отлично подходит для работы с табличными данными, особенно категориальными признаками, и часто показывает лучшие результаты на российских датасетах.
- Ludwig: Open Source фреймворк, позволяющий обучать модели с минимальным написанием кода (low-code).
Обработка и хранение данных
Основа для работы с информацией
AI-агентам часто требуется доступ к большим объемам данных и их эффективная обработка.
- Векторные базы данных: Необходимы для семантического поиска и работы с эмбеддингами (представлениями данных для AI).
- PGVector: Расширение для PostgreSQL, добавляющее возможности векторного поиска.
- Milvus / Weaviate: Специализированные Open Source векторные базы данных, рассчитанные на высокие нагрузки.
- FAISS (Facebook AI): Библиотека для эффективного поиска по сходству и кластеризации векторов.
- Аналитические СУБД:
- ClickHouse (Yandex): Российская Open Source колоночная СУБД, оптимизированная для OLAP-запросов и аналитики больших данных в реальном времени.
- Реляционные СУБД:
- PostgreSQL: Надежная и популярная Open Source СУБД общего назначения.
Frontend / Пользовательский интерфейс (при необходимости)
Визуализация и взаимодействие
Если вашим клиентам потребуется интерфейс для взаимодействия с AI-агентами.
- Streamlit / Gradio: Простые в использовании Python-фреймворки для быстрого создания интерактивных веб-приложений для демонстрации AI/ML моделей.
- Next.js / React: Более мощные JavaScript-фреймворки для построения сложных пользовательских интерфейсов.
Инфраструктура и развертывание
Обеспечение работы и доступности
- Хостинг: Рекомендуется использовать серверы на территории РФ (локальные или облачные) для соответствия законодательству о персональных данных и обеспечения низкой задержки. Рассмотрите российских провайдеров, таких как Yandex Cloud, VK Cloud, Selectel, которые часто предлагают поддержку Open Source решений.
- Репозитории кода: GitHub остается стандартом, но учитывайте наличие российских альтернатив, таких как Gitee или отечественные платформы, для снижения рисков блокировок.
- Контейнеризация: Docker и Kubernetes (Open Source) для стандартизации развертывания и масштабирования приложений.
Визуализация компонентов стека
Для наглядного сравнения ключевых компонентов рекомендуемого стека по важным для вас параметрам (доступность в РФ, бесплатность, гибкость, поддержка и т.д.), рассмотрим следующую радар-диаграмму. Оценки являются экспертными и отражают общую картину на основе доступной информации.
Карта процесса интеграции AI-агентов
Эта ментальная карта иллюстрирует основные этапы создания и внедрения AI-агентов на предприятии, показывая, на каких этапах задействуются компоненты рекомендованного технологического стека.
AI-агентов в РФ"] id1["1. Анализ потребностей клиента"] id1_1["Определение задач для
автоматизации"] id1_2["Анализ бизнес-процессов"] id1_3["Требования к данным"] id2["2. Выбор технологий (Стек)"] id2_1["Фреймворки
(LangChain, Auto-GPT, SuperAGI)"] id2_2["LLM
(Open Source Global,
Open Source Russian)"] id2_3["ML Библиотеки
(PyTorch, TensorFlow, CatBoost)"] id2_4["Базы данных
(Vector DB: PGVector, Milvus;
Analytical DB: ClickHouse)"] id2_5["Инфраструктура
(Российские облака, Docker,
Git-альтернативы)"] id2_6["Frontend (если нужен)
(Streamlit, Next.js)"] id3["3. Разработка AI-агента"] id3_1["Настройка LLM (Fine-tuning)"] id3_2["Программирование логики агента
(используя фреймворк)"] id3_3["Подключение к источникам данных
(БД, API)"] id3_4["Тестирование и отладка"] id4["4. Интеграция в бизнес-процессы"] id4_1["Подключение к корпоративным системам (CRM, ERP)"] id4_2["Настройка API и шлюзов"] id4_3["Обучение персонала"] id5["5. Развертывание и хостинг"] id5_1["Выбор хостинга (Локальный/Облачный РФ)"] id5_2["Настройка окружения (Docker/Kubernetes)"] id5_3["Запуск в продуктив"] id6["6. Поддержка и обслуживание"] id6_1["Мониторинг производительности"] id6_2["Обновление моделей и ПО"] id6_3["Техническая поддержка"]
Использование российских AI-инноваций
Российский рынок AI активно развивается, и местные компании вносят значительный вклад в Open Source. Интеграция этих разработок в ваш стек может дать дополнительные преимущества:
- CatBoost (Yandex): Как упоминалось, эта библиотека градиентного бустинга часто превосходит аналоги на задачах с категориальными данными и хорошо работает с русскоязычными датасетами.
- ClickHouse (Yandex): Эта СУБД стала мировым стандартом для быстрой аналитики больших данных и идеально подходит для обработки логов и событий, генерируемых AI-агентами.
- Kandinsky (Sber AI): Бесплатная российская модель для генерации изображений по текстовому описанию. Может быть полезна для создания визуального контента в рамках задач, выполняемых агентами.
- GigaChat (Sber) / YandexGPT: Использование API этих моделей обеспечивает качественную работу с русским языком и учитывает местные реалии, что может быть критично для некоторых бизнес-задач.
- Государственная поддержка: Наличие грантов для разработчиков Open Source AI библиотек в России может стать дополнительным стимулом для использования и развития отечественных решений.
Включение этих инструментов не только усиливает ваш технологический стек, но и демонстрирует ориентацию на локальный рынок.
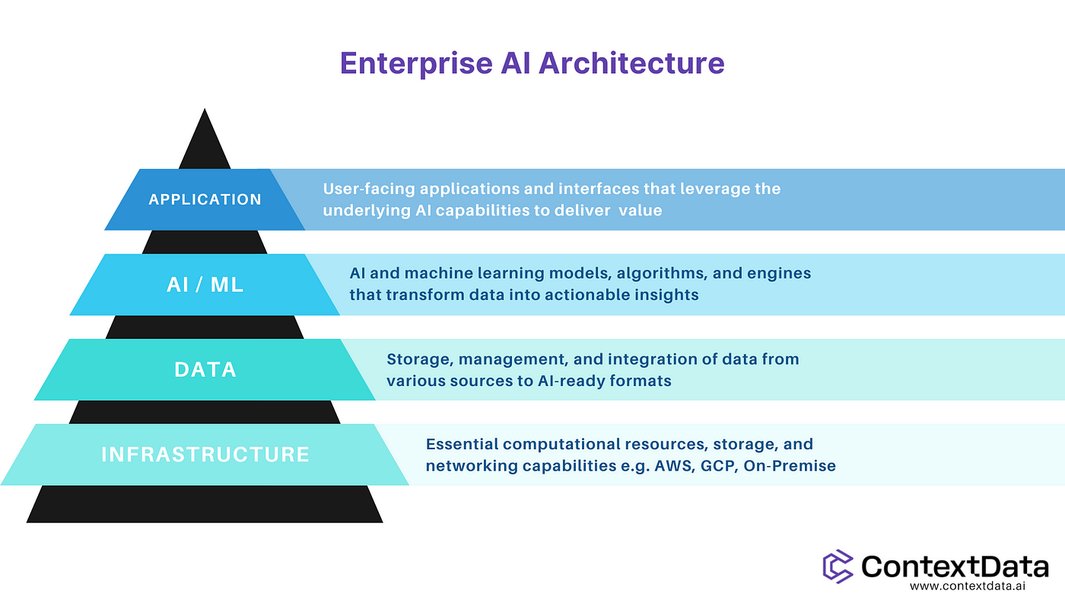
Концептуальная схема построения корпоративной AI-платформы, включающей различные компоненты стека.
Дополнительные бесплатные инструменты
Помимо основного стека, существует ряд бесплатных онлайн-инструментов и сервисов, которые могут быть полезны на этапе прототипирования, для выполнения специфических задач или для малого бизнеса:
- TinyWow AI / MiniToolAI: Онлайн-платформы, предлагающие набор бесплатных AI-инструментов для работы с текстом, PDF, изображениями и видео. Могут быть полезны для быстрых задач или демонстраций.
- Wordify: Российский сервис для генерации маркетинговых текстов.
- Notion AI: Интегрирован в Notion, предлагает AI-помощника для генерации текста, суммирования и т.д. (бесплатный тариф ограничен, может требовать VPN).
- AI2SQL: Веб-сервис для генерации SQL-запросов из текстового описания.
- Forms.app: Инструмент для создания AI-форм для сбора данных.
Эти инструменты могут дополнить ваш основной стек, но важно помнить об их ограничениях (функциональность, доступность в РФ, зависимость от сторонних сервисов).
Посмотрите видео об Open Source AI стеке
Чтобы глубже понять компоненты современного Open Source AI стека и как они взаимодействуют, рекомендуем посмотреть это видео. Оно дает хороший обзор инструментов, многие из которых упоминались выше, и подчеркивает преимущества открытого исходного кода для разработки AI-приложений.
В видео рассматриваются различные уровни стека, от фронтенда до моделей и баз данных, что поможет вам сформировать целостное представление о построении AI-решений с использованием бесплатных и доступных технологий.
Сравнительный обзор ключевых компонентов стека
В таблице ниже представлено краткое сравнение рекомендованных компонентов стека по их основным характеристикам, лицензии и доступности в России.
| Компонент | Рекомендуемый Инструмент(ы) | Ключевые Особенности | Лицензия | Доступность/Примечания по РФ |
|---|---|---|---|---|
| AI Agent Фреймворки | LangChain, Auto-GPT, SuperAGI, CrewAI | Создание, управление, оркестрация AI-агентов, интеграция с LLM и инструментами. | Open Source (MIT, Apache 2.0 и др.) | Полностью доступны, популярны в РФ. Репозитории можно клонировать локально. |
| LLM (Глобальные) | Llama, Mistral, Qwen, Phi, Gemma | Мощные языковые модели общего назначения. Требуют ресурсов для локального запуска. | Open Source (различные) | Доступны для скачивания. Производительность зависит от ресурсов. |
| LLM (Российские) | YandexGPT (API), GigaChat (Sber, API) | Оптимизированы для русского языка и контекста. Обычно доступны через API. | Проприетарные (API), могут быть бесплатные/льготные тарифы. | Высокая доступность в РФ. Уточняйте условия использования API. |
| ML Библиотеки | PyTorch, TensorFlow, CatBoost (Yandex), Ludwig | Обучение, тонкая настройка моделей (глубокое обучение, градиентный бустинг, low-code). | Open Source (Apache 2.0, BSD и др.) | Полностью доступны. CatBoost - российская разработка. |
| Векторные Базы Данных | PGVector (PostgreSQL Ext.), Milvus, Weaviate, FAISS | Хранение и поиск векторных представлений данных (эмбеддингов). | Open Source (PostgreSQL, Apache 2.0, MIT) | Полностью доступны. Возможен локальный/облачный хостинг в РФ. |
| Аналитические Базы Данных | ClickHouse (Yandex) | Быстрая обработка аналитических запросов на больших объемах данных. | Open Source (Apache 2.0) | Полностью доступна, российская разработка, широко используется. |
| Инфраструктура | Docker, Kubernetes, Yandex Cloud, VK Cloud, Gitee | Контейнеризация, оркестрация, облачный хостинг, альтернативные Git-платформы. | Open Source / Коммерческие (IaaS) | Российские облака обеспечивают локальный хостинг. Git-альтернативы снижают риски. |
Часто задаваемые вопросы (FAQ)
Почему стоит выбирать именно Open Source для AI-интегратора в России?
Open Source предоставляет ключевые преимущества: бесплатность (отсутствие лицензионных сборов), доступность (нет географических ограничений на использование ПО, возможность локального развертывания), гибкость (возможность модификации кода под нужды клиента) и независимость от политики конкретного вендора. В условиях российского рынка это снижает риски и затраты.
Какие российские LLM можно использовать и в чем их плюс?
Основные российские разработки — это модели от Яндекса (YandexGPT) и Сбера (GigaChat). Их главное преимущество — глубокая адаптация к русскому языку, культурному контексту и специфике российских данных. Они часто доступны через API. Хотя не все являются полностью Open Source, их использование гарантирует высокую доступность в РФ и релевантность для местных задач.
Нужен ли VPN для доступа к этим инструментам?
Для большинства рекомендованных Open Source инструментов (LangChain, PyTorch, ClickHouse, PGVector, CatBoost и др.) VPN не требуется, так как их можно скачать напрямую или клонировать из репозиториев (включая российские зеркала или альтернативы GitHub вроде Gitee). Однако для доступа к некоторым глобальным онлайн-сервисам или API (например, определенные функции Notion AI или специфические зарубежные платформы) VPN может понадобиться. Рекомендуется использовать локально развертываемые Open Source решения или российские облачные сервисы.
Как обстоят дела с поддержкой русского языка в этих инструментах?
Поддержка русского языка зависит от компонента:
- Фреймворки (LangChain и др.): Сами фреймворки языконезависимы, поддержка языка определяется используемой LLM.
- LLM: Российские модели (YandexGPT, GigaChat) изначально оптимизированы под русский. Глобальные Open Source LLM (Llama, Mistral) могут требовать дообучения (fine-tuning) на русских данных для лучшего качества.
- Библиотеки (PyTorch, CatBoost): Не зависят от языка данных напрямую, но CatBoost хорошо работает с особенностями русскоязычных текстов (например, при обработке категориальных признаков).
- Базы данных: Обычно поддерживают Unicode (включая кириллицу) для хранения данных.
В целом, стек позволяет эффективно работать с русским языком, особенно при использовании российских LLM или дообучении глобальных.
Есть ли юридические или регуляторные риски?
Да, при работе с AI в России важно учитывать регуляторные аспекты, особенно законодательство о персональных данных (ФЗ-152). Это требует хранения и обработки персональных данных граждан РФ на серверах внутри страны. Использование российских облачных провайдеров или локальных серверов помогает соответствовать этому требованию. Также следует следить за развитием регулирования в сфере ИИ в России (обновленный фреймворк с 2025 года), которое может затрагивать вопросы ответственности, прозрачности и этики использования AI. Рекомендуется консультация с юристами по специфике вашего бизнеса и используемых данных.
Рекомендуем также изучить
- Сравнение производительности Open Source LLM на русском языке
- Практический опыт интеграции LangChain с российскими CRM системами
- Юридические аспекты использования AI в России для обработки персональных данных
- Обзор российских облачных платформ для хостинга AI-приложений
Источники
Last updated May 5, 2025