
Odblokowanie Potencjału AI w Generowaniu i Optymalizacji Kodu SQL: Przewodnik dla Twojej Pracy Magisterskiej
Jak Duże Modele Językowe (LLM) rewolucjonizują tworzenie, optymalizację (w tym pushdown) i ewaluację zapytań SQL.
Witaj! Jako Ithy, inteligentny asystent AI, z przyjemnością pomogę Ci zgłębić temat wykorzystania sztucznej inteligencji do generowania kodu SQL, co jest fascynującym obszarem badań, idealnym na pracę magisterską. Skupimy się na kluczowych aspektach, które wymieniłeś: przygotowaniu promptów, zdolności modeli do proponowania optymalizacji (włączając w to strategie pushdown SQL) oraz metodach ewaluacji odpowiedzi generowanych przez Duże Modele Językowe (LLM).
Najważniejsze Informacje
- Kluczowa Rola Inżynierii Promptów: Precyzyjne formułowanie zapytań (promptów) do LLM, uwzględniające schemat bazy danych i kontekst, jest fundamentalne dla generowania poprawnego i efektywnego kodu SQL.
- Optymalizacja Zapytań przez AI: LLM wykazują rosnący potencjał nie tylko w generowaniu SQL, ale także w sugerowaniu optymalizacji, w tym identyfikowaniu możliwości zastosowania technik pushdown w celu zwiększenia wydajności.
- Wyzwania Ewaluacji: Ocena jakości kodu SQL generowanego przez AI jest złożona i wymaga uwzględnienia poprawności składniowej, semantycznej, efektywności wykonania oraz bezpieczeństwa.
Sztuczna Inteligencja w Świecie SQL: Nowa Era Tworzenia Zapytań
Wykorzystanie Dużych Modeli Językowych (LLM) do transformacji zapytań w języku naturalnym na kod SQL (Text-to-SQL) otwiera nowe możliwości dla analityków danych, programistów, a nawet użytkowników nietechnicznych. Zamiast ręcznego pisania skomplikowanych zapytań, można opisać potrzebę w języku potocznym, a AI wygeneruje odpowiedni kod. Jednakże, aby proces ten był efektywny i niezawodny, konieczne jest zrozumienie kilku kluczowych obszarów.
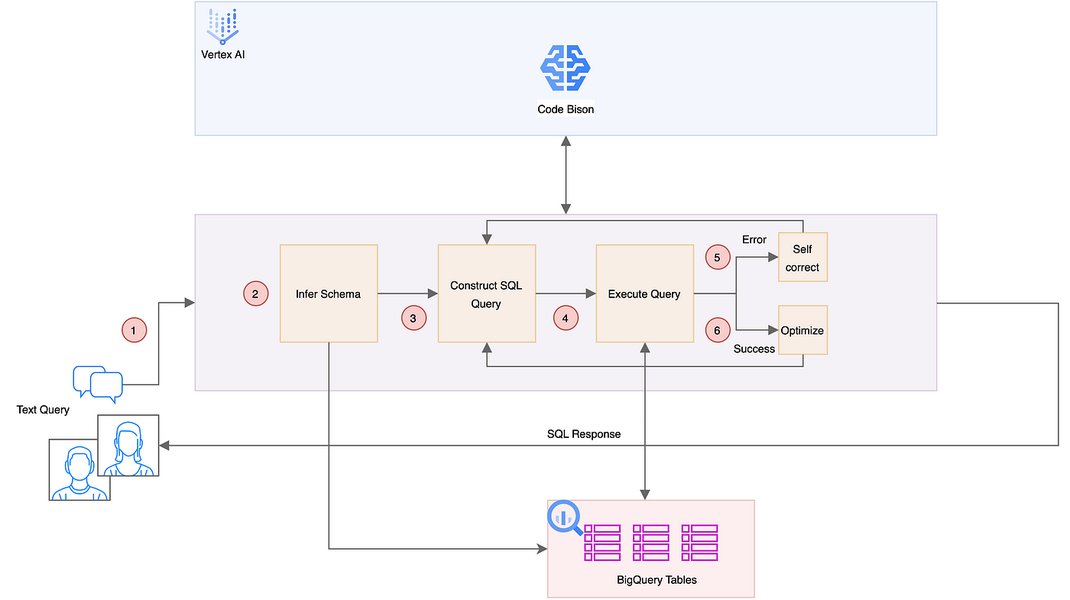
Przykładowe wzorce architektoniczne dla systemów Text-to-SQL wykorzystujących LLM.
Inżynieria Promptów: Sztuka Komunikacji z LLM
Inżynieria promptów to proces projektowania i optymalizacji danych wejściowych (promptów) dla LLM w celu uzyskania pożądanych wyników. W kontekście generowania SQL, skuteczny prompt powinien dostarczyć modelowi wystarczająco dużo informacji, aby zrozumiał intencję użytkownika oraz strukturę docelowej bazy danych.
Kluczowe Elementy Skutecznych Promptów:
- Definicja Schematu Bazy Danych: Przekazanie LLM informacji o tabelach, kolumnach, typach danych i relacjach jest niezbędne. Można to zrobić poprzez bezpośrednie wylistowanie schematu lub dostarczenie instrukcji
CREATE TABLE. - Kontekst Zapytania: Jasne sformułowanie, czego użytkownik oczekuje od zapytania.
- Przykłady (Few-Shot Learning): Dostarczenie kilku przykładów par (zapytanie w języku naturalnym, odpowiadający mu kod SQL) może znacząco poprawić jakość generowanego kodu, szczególnie dla bardziej skomplikowanych zapytań.
- Instrukcje Krok po Kroku: W niektórych przypadkach rozbicie problemu na mniejsze kroki i instruowanie LLM, jak je połączyć, może prowadzić do lepszych rezultatów.
- Wykorzystanie Common Table Expressions (CTE): Sugerowanie lub pokazywanie przykładów z użyciem CTE może pomóc w generowaniu bardziej czytelnego i modułowego kodu SQL.
Badania pokazują, że jakość i szczegółowość promptu mają bezpośredni wpływ na dokładność i efektywność generowanego kodu SQL. Zrozumienie, jak "myśli" model i jakich informacji potrzebuje, jest kluczem do sukcesu.
Optymalizacja Zapytań SQL z Wykorzystaniem AI
LLM nie tylko generują kod SQL, ale mogą również odgrywać rolę w jego optymalizacji. Modele te mogą analizować istniejące zapytania lub te przez siebie wygenerowane, sugerując zmiany mające na celu poprawę wydajności.
Optymalizacja Pushdown SQL w Kontekście LLM
Optymalizacja pushdown polega na "zepchnięciu" operacji (takich jak filtrowanie, agregacje, łączenia) jak najbliżej źródła danych, często do systemu, w którym dane są fizycznie przechowywane. Ma to na celu zminimalizowanie ilości danych przesyłanych przez sieć i przetwarzanych na wyższych warstwach, co jest szczególnie istotne w systemach rozproszonych lub podczas pracy z zewnętrznymi źródłami danych.
LLM mogą potencjalnie wspierać optymalizację pushdown poprzez:
- Identyfikację Operacji do "Zepchnięcia": Na podstawie analizy zapytania i schematu bazy danych, LLM może zidentyfikować, które części zapytania kwalifikują się do wykonania na poziomie źródła danych.
- Przepisywanie Zapytań: Model może sugerować modyfikacje zapytania SQL tak, aby wykorzystywało ono specyficzne dla danego systemu bazodanowego mechanizmy pushdown.
- Rozumienie Możliwości Systemu: Poprzez odpowiednie promptowanie (np. dostarczenie informacji o możliwościach silnika bazy danych), LLM może generować zapytania lepiej dostosowane do strategii pushdown.
- Sugestie dotyczące Indeksowania: Choć to ogólna technika optymalizacji, odpowiednie indeksowanie może wspierać efektywność operacji pushdown. LLM mogą sugerować tworzenie indeksów na kolumnach używanych w warunkach filtrowania, które mają być "zepchnięte".
Ważne jest, aby model miał dostęp do kontekstu dotyczącego architektury systemu danych i możliwości poszczególnych jego komponentów, aby jego sugestie dotyczące pushdown były trafne.
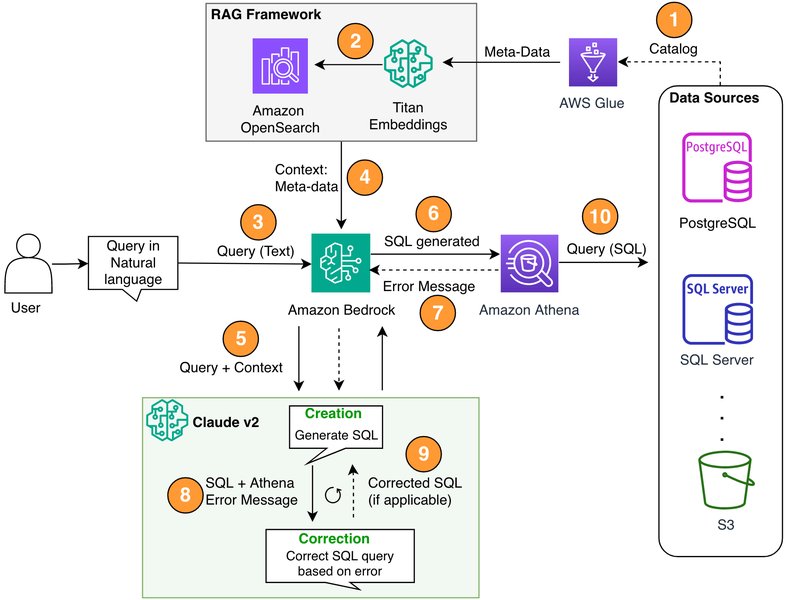
Przykład architektury rozwiązania Text-to-SQL, które może obejmować mechanizmy optymalizacji.
Inne Aspekty Optymalizacji przez LLM
- Automatyczne Przepisywanie Zapytań: LLM mogą być trenowane do przekształcania nieoptymalnych zapytań w ich bardziej wydajne odpowiedniki.
- Sugestie Indeksowania: Na podstawie analizy wzorców zapytań, modele mogą rekomendować tworzenie lub modyfikację indeksów.
- Wykrywanie Antywzorców: AI może identyfikować popularne błędy i antywzorce w zapytaniach SQL, które negatywnie wpływają na wydajność.
Wizualizacja Zdolności LLM w Kontekście SQL
Poniższy wykres radarowy przedstawia przykładową, jakościową ocenę różnych podejść do wykorzystania LLM w zadaniach związanych z SQL. Oceny te są ilustracyjne i mają na celu pokazanie potencjalnych mocnych i słabych stron różnych konfiguracji modeli w kontekście generowania i optymalizacji SQL.
Wykres ten ilustruje, że bardziej zaawansowane techniki, takie jak specjalizacja modelu, zaawansowana inżynieria promptów oraz wykorzystanie Retrieval-Augmented Generation (RAG) do dostarczania kontekstu, mogą znacząco podnieść efektywność LLM w zadaniach związanych z SQL, w tym w zdolności do sugerowania złożonych optymalizacji jak pushdown.
Ewaluacja Odpowiedzi LLM
Ocena jakości kodu SQL generowanego przez LLM jest kluczowym, ale i skomplikowanym zadaniem. Nie wystarczy sprawdzić, czy kod jest składniowo poprawny. Konieczna jest również weryfikacja jego logicznej zgodności z zapytaniem w języku naturalnym oraz efektywności wykonania.
Kryteria Ewaluacji:
- Poprawność Składniowa (Syntactic Correctness): Czy wygenerowany kod SQL jest zgodny z gramatyką SQL?
- Poprawność Semantyczna (Semantic Correctness): Czy zapytanie realizuje intencję użytkownika wyrażoną w języku naturalnym? Czy poprawnie odwołuje się do tabel i kolumn?
- Dokładność Wykonania (Execution Accuracy): Czy zapytanie, po wykonaniu na bazie danych, zwraca poprawne wyniki? Porównanie z wynikami "złotego standardu" (zapytania napisanego przez eksperta).
- Efektywność (Efficiency): Jak szybko wykonuje się zapytanie? Czy jest zoptymalizowane? Porównanie planów wykonania.
- Odporność na Błędy i Złożoność: Jak model radzi sobie z niejednoznacznymi lub złożonymi zapytaniami w języku naturalnym?
Popularne benchmarki, takie jak Spider, SParC, CoSQL czy bardziej współczesne jak BIRD-SQL, są wykorzystywane do oceny modeli Text-to-SQL. Rozwój metod ewaluacji, które uwzględniają specyfikę optymalizacji pushdown, jest również istotnym kierunkiem badań.
Kluczowe Aspekty Wykorzystania LLM do Generowania SQL: Mapa Myśli
Poniższa mapa myśli przedstawia główne obszary i ich wzajemne powiązania w kontekście wykorzystania sztucznej inteligencji do generowania i optymalizacji kodu SQL. Zwraca uwagę na centralną rolę inżynierii promptów, potrzebę optymalizacji (w tym specyficznych technik jak pushdown), metody ewaluacji oraz związane z tym wyzwania technologiczne i bezpieczeństwa.
Mapa ta podkreśla złożoność tematu i wielość czynników, które należy wziąć pod uwagę przy projektowaniu i implementacji systemów AI do pracy z SQL.
Praktyczne Narzędzia i Rozwiązania
Na rynku pojawia się coraz więcej narzędzi i platform, które wykorzystują AI do generowania i optymalizacji SQL. Wiele z nich oferuje interfejsy konwersacyjne, pozwalające na interakcję z bazą danych w języku naturalnym.
Powyższy film prezentuje przykład narzędzia AI (Chat2DB), które wspomaga generowanie, optymalizację i zarządzanie zapytaniami SQL, ilustrując praktyczne zastosowania omawianych technologii.
Narzędzia takie jak AI2sql, Text2SQL.ai, UsefulAI SQL Generators czy rozwiązania chmurowe (np. Amazon Bedrock z możliwością generowania SQL) demonstrują praktyczne zastosowania LLM. Warto również zwrócić uwagę na integrację możliwości AI bezpośrednio w systemach zarządzania bazami danych, jak np. zapowiadane funkcje w SQL Server 2025 wykorzystujące embeddings i RAG (Retrieval-Augmented Generation).
Tabela: Kluczowe Obszary Badań w Kontekście AI dla SQL
Poniższa tabela syntetyzuje główne obszary badawcze związane z wykorzystaniem LLM do generowania i optymalizacji SQL, z uwzględnieniem specyfiki optymalizacji pushdown.
| Obszar Badawczy | Kluczowe Wyzwanie/Cel | Przykładowe Techniki/Podejścia | Znaczenie dla Optymalizacji Pushdown SQL |
|---|---|---|---|
| Inżynieria Promptów | Generowanie precyzyjnego i poprawnego kodu SQL poprzez odpowiednie formułowanie zapytań do LLM, uwzględnienie schematu bazy danych i kontekstu. | Zero-shot, few-shot learning, dołączanie schematu bazy, przykłady zapytań, instrukcje krok po kroku, Common Table Expressions (CTE), reprezentacje pytań. | Dostarczenie LLM informacji o możliwościach systemu źródłowego i strukturze danych, co jest kluczowe dla identyfikacji operacji możliwych do "zepchnięcia" (pushdown). Skuteczne prompty mogą kierować LLM do rozważenia strategii pushdown. |
| Optymalizacja Zapytań | Poprawa wydajności generowanych lub istniejących zapytań SQL, redukcja kosztów wykonania, identyfikacja wąskich gardeł. | Automatyczne przepisywanie zapytań, sugestie indeksowania, wykorzystanie embeddingów zapytań, analiza planów wykonania, routing LLM. | LLM może analizować zapytanie i schemat, sugerując transformacje, które efektywnie wykorzystują mechanizmy pushdown, np. przenosząc filtrowanie lub agregacje bliżej źródła danych, minimalizując transfer danych. |
| Ewaluacja Modeli LLM | Ocena poprawności składniowej i semantycznej generowanego SQL, jego efektywności wykonania oraz zgodności z intencją użytkownika wyrażoną w języku naturalnym. | Metryki dokładności (execution accuracy, match accuracy), testy na benchmarkach (np. Spider, BIRD-SQL), analiza błędów, ocena generowania zoptymalizowanego kodu. | Ewaluacja musi uwzględniać, czy LLM poprawnie identyfikuje i generuje strategie pushdown, oraz czy prowadzą one do rzeczywistej poprawy wydajności w docelowym systemie bazodanowym. Wymaga to testów na danych i systemach, gdzie pushdown ma znaczenie. |
| Bezpieczeństwo Zapytań | Zapobieganie generowaniu złośliwego lub niebezpiecznego kodu SQL, ochrona przed atakami typu SQL injection poprzez LLM (np. P2SQL). | Walidacja generowanego kodu, filtrowanie promptów, stosowanie zasad najmniejszych uprawnień, analiza podatności, badanie ataków P2SQL. | Zapewnienie, że sugerowane optymalizacje pushdown (lub dowolne inne modyfikacje kodu) nie wprowadzają luk bezpieczeństwa, np. przez niepoprawne konstruowanie dynamicznych fragmentów SQL na podstawie danych wejściowych. |
Przykładowe Artykuły Naukowe i Publikacje (do Maja 2025)
Poniżej znajduje się lista wybranych artykułów naukowych i publikacji, które mogą być cennym źródłem informacji do Twojej pracy magisterskiej. Skupiają się one na inżynierii promptów, generowaniu i optymalizacji SQL przez LLM oraz metodach ewaluacji. Wiele z nich jest dostępnych jako preprinty na arXiv lub jako pełne teksty na stronach konferencji/czasopism. Zalecam dalsze, pogłębione poszukiwania w bazach takich jak Google Scholar, DBLP, ResearchGate czy IEEE Xplore.
1. Text-to-SQL Empowered by Large Language Models: A Survey and Taxonomy of Current Approaches
Źródło: VLDB / arXiv (często prace z VLDB pojawiają się na arXiv)
Rok: 2024 (lub podobny, aktualizowany przegląd)
Kluczowe aspekty: Systematyczny przegląd technik Text-to-SQL opartych na LLM, kategoryzacja metod inżynierii promptów, fine-tuningu, ewaluacji i wyzwań. Omawia różne reprezentacje pytań i komponenty promptów.Dostępność: Zazwyczaj PDF przez arXiv lub stronę konferencji.
2. Prompt Engineering for Effective SQL Code Generation with Large Language Models
Źródło: Artykuł konferencyjny (np. ACL, EMNLP) lub czasopismo (np. TACL) / Medium (dla bardziej praktycznych ujęć)
Rok: 2024/2025
Kluczowe aspekty: Badanie wpływu różnych strategii promptowania na jakość generowanego SQL. Analiza, jak przekazywać schemat bazy danych, przykłady few-shot i instrukcje krok po kroku.Dostępność: PDF przez portal konferencji/czasopisma lub pełny tekst.
3. The Unreasonable Effectiveness of LLMs for SQL Query Optimization
Źródło: arXiv / Konferencja bazodanowa (np. SIGMOD, VLDB)
Rok: 2024
Kluczowe aspekty: Demonstracja, jak LLM mogą być wykorzystywane do automatycznej optymalizacji zapytań SQL, w tym przepisywania zapytań, bez konieczności ręcznej inżynierii cech. Może dotykać aspektów istotnych dla pushdown.Dostępność: PDF przez arXiv lub stronę konferencji.
4. Evaluating the Correctness and Efficiency of LLM-Generated SQL Queries
Źródło: arXiv / Warsztaty na konferencjach AI/DB
Rok: 2024/2025
Kluczowe aspekty: Propozycje nowych metryk i benchmarków do oceny generowanego SQL, uwzględniające nie tylko poprawność wykonania, ale także efektywność i zgodność z najlepszymi praktykami.Dostępność: PDF przez arXiv.
5. Prompt-to-SQL (P2SQL) Injections: Security Vulnerabilities in LLM-Integrated Web Applications
Źródło: Konferencja bezpieczeństwa (np. USENIX Security, IEEE S&P) / arXiv
Rok: 2025
Kluczowe aspekty: Analiza nowego typu zagrożeń, gdzie zmanipulowane prompty mogą prowadzić do generowania złośliwego kodu SQL przez LLM. Ważne dla oceny bezpieczeństwa.Dostępność: PDF (np. link z Answer A: syssec.dpss.inesc-id.pt)
6. Large Language Model Enhanced Text-to-SQL Generation: A Comprehensive Survey
Źródło: arXiv
Rok: 2024 (np. 2410.06011v1 z Answer A/B)
Kluczowe aspekty: Obszerny przegląd metod Text-to-SQL z LLM, w tym inżynieria promptów, fine-tuning, modele specjalizowane, obsługa schematów i ewaluacja.Dostępność: PDF przez arXiv.
7. Making AI-generated code more accurate in any language
Źródło: MIT News (opisujący badania z MIT)
Rok: 2025
Kluczowe aspekty: Prezentacja nowych technik (potencjalnie architektury modeli lub metod dekodowania) mających na celu automatyczne kierowanie LLM do generowania kodu (w tym SQL) zgodnego z regułami języka i wolnego od błędów.Dostępność: Artykuł informacyjny, może linkować do publikacji naukowej.
8. Towards Optimizing SQL Generation via LLM Routing
Źródło: arXiv
Rok: 2024 (np. 2411.04319 z Answer B/C)
Kluczowe aspekty: Badanie nad dynamicznym wyborem (routingiem) między różnymi LLM lub konfiguracjami LLM w celu optymalizacji procesu generowania SQL pod kątem kosztów i dokładności.Dostępność: PDF przez arXiv.
9. Optimizing Text-to-SQL Generation in Large Language Models: A Case Study
Źródło: Praca dyplomowa / Raport techniczny (np. liu.diva-portal.org z Answer B/C)
Rok: 2024/2025
Kluczowe aspekty: Praktyczne badanie dotyczące optymalizacji generowania SQL, w tym korekty błędnych zapytań i ewaluacji skuteczności na konkretnych przypadkach.Dostępność: Zazwyczaj PDF.
10. Optimizing text-to-SQL conversion techniques through the integration of LLMs and intelligent agents
Źródło: ScienceDirect (np. artykuł z Answer B/C)
Rok: 2025
Kluczowe aspekty: Badanie integracji LLM z agentami inteligentnymi w celu optymalizacji konwersji tekstu na SQL w czasie rzeczywistym, potencjalnie dla analiz biznesowych.Dostępność: Zależna od subskrypcji lub open access.
11. A Survey of LLM-based Text-to-SQL: Methods, Evaluation, and Future Directions
Źródło: arXiv (np. 2406.08426v4 z Answer B)
Rok: 2024
Kluczowe aspekty: Kolejny przegląd metodologii Text-to-SQL z użyciem LLM, z naciskiem na ewaluację, benchmarki i przyszłe kierunki badań.Dostępność: PDF przez arXiv.
12. How to Prompt LLMs for Text-to-SQL: An Empirical Study
Źródło: Blog specjalistyczny (np. Arize AI, Athina.ai) lub warsztaty
Rok: 2024
Kluczowe aspekty: Praktyczne studium różnych strategii promptowania dla zadań Text-to-SQL, porównujące podejścia zero-shot, few-shot w różnych domenach bazodanowych.Dostępność: Pełny tekst na blogu/stronie.
13. Build a robust text-to-SQL solution generating complex queries, self-correcting and querying diverse data sources
Źródło: AWS Machine Learning Blog
Rok: 2024/2025
Kluczowe aspekty: Opis architektury i podejścia do budowy zaawansowanego systemu Text-to-SQL, który potrafi generować złożone zapytania, dokonywać samokorekty i pracować z różnorodnymi źródłami danych.Dostępność: Pełny tekst na blogu AWS.
14. Generative AI with SQL — First Impressions and Challenges
Źródło: Medium (artykuły od praktyków/badaczy)
Rok: 2024/2025
Kluczowe aspekty: Dzielenie się pierwszymi doświadczeniami z wykorzystaniem AI do generowania SQL, wskazanie na typowe błędy, potrzebę szczegółowych instrukcji i potencjał CTE.Dostępność: Pełny tekst na Medium.
15. How AI is Transforming SQL Query Optimization in 2025
Źródło: Blogi firm specjalizujących się w AI dla SQL (np. ai2sql.io)
Rok: 2025
Kluczowe aspekty: Analiza, jak AI rewolucjonizuje optymalizację SQL, umożliwiając generowanie wydajnego kodu, automatyczne indeksowanie i przepisywanie zapytań, nawet dla osób nietechnicznych.Dostępność: Pełny tekst na blogu.
To jedynie niewielki wycinek dostępnych badań. Zachęcam do aktywnego przeszukiwania wspomnianych baz, używając słów kluczowych takich jak: "Text-to-SQL LLM", "prompt engineering SQL", "SQL query optimization AI", "evaluating LLM SQL generation", "pushdown optimization LLM", "schema linking text-to-sql", "self-correction text-to-sql".
FAQ - Najczęściej Zadawane Pytania
Jakie są największe wyzwania w inżynierii promptów dla generowania SQL?
Największe wyzwania to:
- Zrozumienie schematu: Skuteczne przekazanie LLM złożonej struktury bazy danych, w tym tabel, kolumn, typów danych i relacji.
- Obsługa niejednoznaczności: Zapytania w języku naturalnym są często niejednoznaczne; LLM musi poprawnie zinterpretować intencję użytkownika.
- Generowanie złożonych zapytań: Tworzenie skomplikowanych zapytań z wieloma złączeniami, podzapytaniami, funkcjami agregującymi i klauzulami analitycznymi.
- Dostosowanie do dialektu SQL: Różne systemy baz danych mają swoje specyficzne dialekty SQL; LLM musi generować kod kompatybilny z docelowym systemem.
- Minimalizacja "halucynacji": Zapobieganie generowaniu przez LLM nieistniejących tabel, kolumn lub niepoprawnych operacji.
W jaki sposób LLM-y mogą pomóc w optymalizacji zapytań SQL, w tym w kontekście pushdown?
LLM mogą wspierać optymalizację SQL poprzez:
- Analizę i przepisywanie zapytań: Identyfikowanie nieefektywnych wzorców i sugerowanie alternatywnych, bardziej wydajnych konstrukcji.
- Sugestie dotyczące indeksowania: Rekomendowanie tworzenia lub modyfikacji indeksów na podstawie analizy obciążenia zapytań.
- Identyfikację możliwości pushdown: Analizując zapytanie i (potencjalnie) metadane o systemie źródłowym, LLM mogą zidentyfikować operacje (np. filtrowanie, agregacje), które można "zepchnąć" bliżej źródła danych, redukując transfer danych i poprawiając wydajność. Aby to było skuteczne, LLM musi rozumieć koncepcję pushdown i mieć dostęp do odpowiedniego kontekstu.
- Generowanie zapytań z uwzględnieniem kosztu: Niektóre badania eksplorują LLM, które próbują generować zapytania optymalne pod kątem przewidywanego kosztu wykonania.
Jakie metryki są używane do ewaluacji jakości kodu SQL generowanego przez AI?
Popularne metryki to:
- Exact Match Accuracy (Dokładność Dokładnego Dopasowania): Procent zapytań, gdzie wygenerowany kod SQL jest identyczny (po normalizacji) z kodem referencyjnym.
- Execution Accuracy (Dokładność Wykonania): Procent zapytań, które po wykonaniu na bazie danych zwracają te same wyniki co kod referencyjny. Jest to bardziej wiarygodna metryka, ponieważ dopuszcza różne, ale semantycznie równoważne sformułowania SQL.
- Test Suite Accuracy (Dokładność na Zestawie Testów): Używana w niektórych benchmarkach, gdzie zapytanie jest uznawane za poprawne, jeśli przechodzi wszystkie testy jednostkowe zdefiniowane dla danego problemu.
- Poprawność Składniowa: Procent zapytań, które są składniowo poprawne, nawet jeśli nie są semantycznie poprawne lub nie dają właściwych wyników.
- Metryki związane z wydajnością: Czas wykonania zapytania, analiza planu wykonania (choć to trudniejsze do automatyzacji na dużą skalę).
Czy generowanie SQL przez AI jest bezpieczne? Jakie są ryzyka?
Generowanie SQL przez AI wiąże się z pewnymi ryzykami bezpieczeństwa:
- Prompt Injection (w tym P2SQL - Prompt-to-SQL Injection): Złośliwie spreparowane prompty mogą skłonić LLM do wygenerowania niebezpiecznego kodu SQL, który może prowadzić do nieautoryzowanego dostępu do danych, modyfikacji danych lub ataków typu SQL injection na samą bazę danych.
- Generowanie Nadmiernie Uprzywilejowanego Kodu: LLM może wygenerować zapytania, które żądają więcej danych lub uprawnień niż jest to konieczne.
- Wyciek Wrażliwych Informacji w Promptach: Jeśli użytkownicy wklejają wrażliwe dane lub fragmenty schematu do publicznych narzędzi LLM, istnieje ryzyko ich ujawnienia.
- Błędy w Logice Prowadzące do Problemów z Integralnością Danych: Nawet jeśli kod jest składniowo poprawny, błędy logiczne mogą prowadzić do niepoprawnych modyfikacji danych.
Rekomendowane Zapytania do Dalszych Badań
- Jakie są najnowsze techniki RAG (Retrieval-Augmented Generation) stosowane w systemach Text-to-SQL?
- W jaki sposób można dostroić (fine-tune) duże modele językowe specjalnie do zadań generowania i optymalizacji zapytań SQL dla konkretnej domeny?
- Porównanie efektywności różnych architektur LLM (np. Transformer, MoE) w kontekście generowania złożonych zapytań analitycznych SQL.
- Etyczne implikacje i wyzwania związane z automatycznym generowaniem kodu SQL przez AI, w tym kwestie odpowiedzialności za błędy.
Referencje
Poniżej lista wybranych źródeł internetowych, które dostarczyły informacji wykorzystanych w tej analizie. Wiele z nich odnosi się do artykułów naukowych lub badań, które warto dalej zgłębić.

Last updated May 7, 2025