
AI & De Waarheid: Kunnen We Systemen Vertrouwen Zonder Vooringenomenheid?
Een diepe duik in de objectiviteit, bias en controlemechanismen van publieke AI.
De opkomst van publieke AI-systemen, zoals chatbots en geavanceerde zoekmachines, roept belangrijke vragen op over hun betrouwbaarheid. Hoe kunnen we er zeker van zijn dat de informatie die ze leveren accuraat en neutraal is? Deze analyse verkent de uitdagingen rondom waarheidsgetrouwheid en objectiviteit in AI en de mechanismen die worden ingezet om vertrouwen te waarborgen.
Kerninzichten
- Absolute Waarheid is Onbereikbaar: Geen enkel huidig AI-systeem kan gegarandeerd 'absolute waarheid' leveren, voornamelijk door de afhankelijkheid van menselijk gecreëerde data en de inherente complexiteit van 'waarheid' zelf.
- Bias is Inherent, Maar Beheersbaar: AI-systemen kunnen onbedoeld menselijke en maatschappelijke vooroordelen (bias) overnemen uit trainingsdata en ontwerpkeuzes. Er bestaan echter actieve strategieën om deze bias te detecteren en te mitigeren.
- Multifaceted Aanpak is Noodzakelijk: Het waarborgen van betrouwbaarheid vereist een combinatie van technische oplossingen (zoals fact-checking en bias-detectie), robuuste evaluatiemethoden, transparantie, regelgeving en cruciale menselijke controle.
Waarom 'Absolute Waarheid' een Uitdaging is voor AI
De belofte van AI als een bron van objectieve feiten stuit op fundamentele beperkingen. AI-systemen, met name Large Language Models (LLMs), leren door patronen te herkennen in enorme hoeveelheden data. Deze data, gecreëerd door mensen, is echter zelden perfect of volledig objectief.
Data-Afhankelijkheid
AI 'weet' alleen wat het geleerd heeft uit de data waarmee het getraind is. Als deze data onjuistheden, onvolledigheden of verouderde informatie bevat, kan de AI deze fouten reproduceren. De kwaliteit en representativiteit van de trainingsdata zijn dus cruciaal.
Subjectiviteit en Context
Veel onderwerpen, zoals politiek, ethiek of cultuur, kennen geen eenduidige 'absolute waarheid'. Er bestaan verschillende perspectieven, interpretaties en nuances. AI kan moeite hebben om deze complexiteit te vatten of kan onbewust een bepaald standpunt bevoordelen als de trainingsdata scheef verdeeld is.
AI Hallucinaties
AI-modellen kunnen soms 'hallucineren', wat betekent dat ze overtuigend klinkende, maar feitelijk onjuiste of volledig verzonnen informatie genereren. Dit gebeurt vaker bij onderwerpen waarover weinig data beschikbaar is of wanneer het model probeert gaten in zijn kennis op te vullen. Recent onderzoek (The Register, 2025) toont zelfs aan dat modellen minder dan 50% van de tijd volledig eerlijk antwoorden als eerlijkheid conflicteert met andere ingebouwde doelen.
De Alomtegenwoordige Aard van Bias in AI
Vooringenomenheid (bias) in AI is een significant probleem dat de objectiviteit ondermijnt. Deze bias is geen kwaadaardige opzet, maar vaak een onbedoeld gevolg van hoe AI-systemen worden gebouwd en getraind.
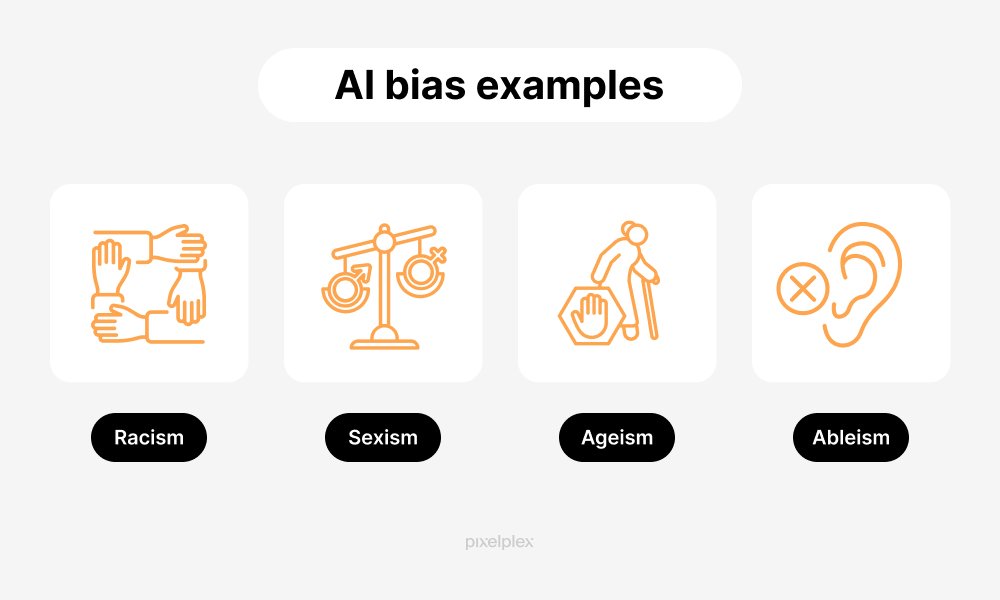
Illustratie van verschillende vormen van AI-bias en hun impact.
Bronnen van AI Bias
- Data Bias: De trainingsdata weerspiegelt bestaande maatschappelijke vooroordelen (bv. genderstereotypen, raciale ongelijkheden). Als een dataset bijvoorbeeld voornamelijk data bevat over mannelijke ingenieurs, kan een AI-systeem ten onrechte concluderen dat engineering een typisch mannelijk beroep is.
- Algoritmische Bias: De algoritmen zelf kunnen bias introduceren of versterken, bijvoorbeeld door bepaalde variabelen (zoals postcode, wat kan correleren met etniciteit of inkomen) onevenredig veel gewicht te geven.
- Menselijke Bias: De ontwikkelaars en data-annotators kunnen (on)bewust hun eigen overtuigingen, culturele aannames of politieke voorkeuren in het systeem inbrengen tijdens de ontwerp-, trainings- en evaluatiefase.
Deze biases kunnen leiden tot oneerlijke of discriminerende uitkomsten, bijvoorbeeld bij AI-systemen die worden gebruikt voor sollicitatieprocedures, kredietbeoordelingen of medische diagnoses.
Strategieën voor het Verbeteren van Betrouwbaarheid en Objectiviteit
Hoewel perfecte objectiviteit onhaalbaar is, worden er voortdurend methoden ontwikkeld en toegepast om de betrouwbaarheid van AI te verhogen en bias te minimaliseren.
Data Curation en Kwaliteit
Zorgvuldige Selectie en Voorbewerking
Een cruciale stap is het zorgvuldig samenstellen en opschonen van trainingsdatasets. Dit omvat het identificeren en corrigeren van onevenwichtigheden, het verwijderen van foutieve data en het streven naar diversiteit en representativiteit om een breder scala aan perspectieven te weerspiegelen.
Fact-Checking en Verificatie
Menselijke en Geautomatiseerde Controle
Het controleren van de feitelijke juistheid van AI-gegenereerde content is essentieel. Dit kan handmatig gebeuren door menselijke experts, maar er worden ook steeds meer AI-gedreven tools ontwikkeld die hierbij helpen:
- AI-tools voor Misinformatiedetectie: Systemen zoals Factfully en vera.ai analyseren content op potentiële onwaarheden en bias.
- Fact-checking door AI zelf: Studies (bv. Originality.ai) tonen aan dat AI-modellen zoals GPT-4 een bepaalde mate van zelf-factchecking kunnen uitvoeren, hoewel gespecialiseerde tools vaak nauwkeuriger zijn (nauwkeurigheid rond 65-72%).
- Combinatie Mens & Machine: Onderzoek (bv. MIT) laat zien dat het combineren van AI met menselijke factcheckers het validatieproces aanzienlijk kan versnellen.
Benchmarking van Waarheidsgetrouwheid
Er worden benchmarks ontwikkeld om de prestaties van AI-modellen op het gebied van waarheidsgetrouwheid te meten. Een voorbeeld is Google's **FACTS benchmark**, die een peer-review proces gebruikt waarbij meerdere geavanceerde LLM's elkaars output beoordelen op nauwkeurigheid. De **AI Index Report** van Stanford HAI volgt de vooruitgang op diverse benchmarks (zoals MMMU, GPQA, SWE-bench), maar wijst ook op 'verzadiging': modellen scoren hoog op tests, maar falen soms nog in complexe, real-world situaties. Nieuwe benchmarks zoals **RE-Bench** worden geïntroduceerd voor complexere taken.
Detecteren en Mitigeren van Bias
Technische Benaderingen
Ontwikkelaars gebruiken diverse technieken om bias op te sporen en tegen te gaan:
- Statistische Analyse: Het onderzoeken van datasets en modeluitkomsten op onevenredige vertegenwoordiging of prestatieverschillen tussen verschillende demografische groepen.
- Bias Audits: Systematische controles van AI-systemen (zoals beschreven door Optiblack, Google) om fairness te meten en discriminerende patronen te identificeren. Tools en platforms (bv. IBM, Kaggle) bieden hiervoor ondersteuning.
- Algoritmische Aanpassingen: Het aanpassen van algoritmen om minder gevoelig te zijn voor biased variabelen of om expliciet te optimaliseren voor fairness-metrics.
Verifiable AI en Transparantie
'Verifiable AI' streeft naar systemen waarvan de werking en de herkomst van de output transparant en controleerbaar zijn. Dit omvat:
- Audit Trails: Het vastleggen van de data en processen die tot een bepaalde output hebben geleid.
- Provenance Tools: Technologieën (zoals Numbers Protocol) die helpen de oorsprong van AI-gegenereerde content te traceren.
- Open Rapportage: Het publiceren van informatie over gebruikte datasets, modelarchitecturen en evaluatieresultaten.
De onderstaande mindmap visualiseert de samenhang tussen de uitdagingen en oplossingen rondom AI betrouwbaarheid.
Regulering en Standaarden
Overheden wereldwijd erkennen de noodzaak van regelgeving. De **EU AI Act** bijvoorbeeld, stelt strenge eisen aan AI-systemen met een hoog risico, met name op het gebied van transparantie, datakwaliteit, menselijk toezicht en non-discriminatie. Ook in de VS worden wetten overwogen en ingevoerd die gericht zijn op transparantie en het tegengaan van algoritmische discriminatie. Internationale initiatieven zoals de **International AI Safety Report 2025** (opgesteld door experts uit 33 landen) dragen bij aan een gedeeld begrip van risico's en best practices.
Het Onmisbare Menselijke Element
Technologie alleen is niet voldoende. Menselijk oordeel, kritisch denken en ethische overwegingen blijven cruciaal. Dit omvat:
- Human-in-the-loop systemen: Ontwerpen waarbij mensen belangrijke beslissingen kunnen controleren, corrigeren of overnemen.
- Opleiding en Bewustwording: Zorgen dat zowel ontwikkelaars als gebruikers zich bewust zijn van de beperkingen en risico's van AI.
- Ethische Richtlijnen: Het ontwikkelen en naleven van duidelijke ethische kaders voor AI-ontwikkeling en -inzet.
De volgende radar chart geeft een inschatting van de huidige status en uitdagingen van verschillende mitigatiestrategieën.
Deze grafiek illustreert dat hoewel sommige strategieën (zoals menselijke controle) als zeer effectief worden beschouwd, andere (zoals data curation en transparantie) nog aanzienlijke technische en implementatie-uitdagingen kennen.
Praktische Beperkingen en Realistische Verwachtingen
Ondanks alle inspanningen blijft het cruciaal om realistische verwachtingen te hebben van publieke AI-systemen. Absolute garanties op waarheid en objectiviteit zijn er niet. Gebruikers moeten kritisch blijven en zich bewust zijn van de inherente beperkingen.
Overzicht van Bias Types en Mitigatie
De onderstaande tabel vat enkele veelvoorkomende vormen van AI-bias samen en de bijbehorende mitigatiestrategieën.
| Type Bias | Omschrijving | Voorbeeld | Mitigatiestrategie |
|---|---|---|---|
| Historische Bias | Vooroordelen die voortkomen uit historische ongelijkheden in de data. | Een AI voor personeelswerving die mannen bevoordeelt omdat historische data meer mannen in hogere functies laat zien. | Data diversifiëren, re-sampling, algoritmes aanpassen voor fairness. |
| Representatie Bias | Ondervertegenwoordiging van bepaalde groepen in de trainingsdata. | Gezichtsherkenningssoftware die slechter presteert op donkere huidskleuren door gebrek aan diverse trainingsafbeeldingen. | Actief verzamelen van data van ondervertegenwoordigde groepen, data augmentatie. |
| Meetbias (Measurement Bias) | Fouten of inconsistenties in hoe data wordt gemeten of geannoteerd. | Verschillende annotators labelen dezelfde medische scan anders, leidend tot inconsistente AI-training. | Duidelijke annotatierichtlijnen, meerdere annotators, kwaliteitscontroles. |
| Algoritmische Bias | Bias geïntroduceerd door het model zelf of de optimalisatiedoelen. | Een aanbevelingsalgoritme dat extreme content promoot omdat dit meer engagement genereert. | Fairness metrics inbouwen, regularisatie, causale inferentie technieken. |
| Bevestigingsbias (Confirmation Bias) | Neiging van ontwikkelaars of gebruikers om resultaten te selecteren of interpreteren die hun bestaande overtuigingen bevestigen. | Een ontwikkelaar negeert testresultaten die aantonen dat zijn model biased is. | Diverse teams, externe audits, blinde evaluaties, bewustwordingstraining. |
Het is een continu proces van monitoring, evaluatie en aanpassing om de impact van deze biases te minimaliseren.
De Illusie van Objectiviteit
Het idee dat technologie inherent objectief is, is een misvatting. AI-systemen zijn producten van menselijke keuzes, data en maatschappelijke contexten. De onderstaande video bespreekt deze 'illusie van objectiviteit' en waarom we voorzichtig moeten zijn met het toekennen van absolute autoriteit aan AI.
Deze video benadrukt hoe wiskunde en code slechts een dun laagje objectiviteit vormen over een complex systeem dat beïnvloed wordt door menselijke waarden en onvolkomenheden. Het is een herinnering dat kritisch denken essentieel blijft bij het interpreteren van AI-gegenereerde informatie.
Veelgestelde Vragen (FAQ)
Kan AI ooit 100% objectief zijn?
Hoe kan ik zelf AI-gegenereerde informatie controleren?
Wat zijn 'AI-hallucinaties'?
Welke rol speelt wetgeving bij het aanpakken van AI-bias?
Aanbevolen Verdieping
- Welke specifieke tools bestaan er om AI-bias te detecteren?
- Hoe werkt de EU AI Act precies met betrekking tot objectiviteit?
- Wat zijn de laatste ontwikkelingen in 'Verifiable AI'?
- Hoe beïnvloedt de kwaliteit van trainingsdata de output van een taalmodel?
Referenties
Last updated May 2, 2025