
精通核心算法:为您量身打造的算法面试通关课程
系统掌握六大关键算法领域,从理论到实战,全面提升面试竞争力。
准备技术面试,特别是算法密集型的面试,需要对核心数据结构和算法有深入的理解和熟练的应用。本课程大纲专为希望系统性复习和掌握常见算法面试题目的学习者设计,涵盖链表、字符串、树、栈与队列、图以及查找与排序这六个关键领域。
课程亮点
- 系统性覆盖: 深入讲解六大核心算法主题,构建完整的知识体系。
- 实战导向: 结合经典面试题目(如 LeetCode 高频题)进行实例解析与代码实现。
- 能力提升: 培养分析问题、设计高效算法及编写高质量代码的综合能力。
模块一:链表 (Linked Lists) - 灵巧的指针艺术
主题:反转指定区间链表 (Reverse Linked List within an Interval)
链表操作是面试中考察指针运用和细节处理能力的常见方式。掌握区间反转是理解更复杂链表操作的基础。
核心概念与原理
此问题要求在单链表中仅反转从位置 m 到 n 的节点。关键在于:
- 定位: 准确找到第 m-1 个节点(区间前驱)、第 m 个节点(区间起点)以及第 n 个节点(区间终点)。
- 反转: 在 [m, n] 区间内进行标准的链表反转操作(通常使用头插法或迭代三指针)。
- 连接: 将反转后的子链表正确地接回原链表,确保区间前驱指向反转后的新头节点(原 n 节点),以及反转前的旧头节点(原 m 节点)指向 n 节点之后的部分。
- 边界处理: 特别注意 m=1(从头节点开始反转)以及 m=n(无需反转)等情况。使用虚拟头节点(Dummy Node)可以简化边界处理。
实现方法
常用的实现方法包括迭代法和递归法。迭代法通常使用几个指针(如 prev, curr, next 或 pre, start, tmp, end)来辅助完成反转和连接。
代码示例 (Python - 迭代法)
# 定义链表节点
class ListNode:
    def __init__(self, val=0, next=None):
        self.val = val
        self.next = next

def reverseBetween(head: ListNode, m: int, n: int) -> ListNode:
    if not head or m == n:
        return head

    dummy = ListNode(0, head)
    pre = dummy # pre 指向第 m-1 个节点

    # 移动 pre 到第 m-1 个节点的位置
    for _ in range(m - 1):
        pre = pre.next

    # cur 指向第 m 个节点,即反转区间的起始节点
    cur = pre.next

    # 使用头插法进行区间反转
    # 在 n-m 次循环中,依次将 cur 后面的节点移动到 pre 的后面
    for _ in range(n - m):
        tmp = cur.next          # tmp 指向要移动的节点
        cur.next = tmp.next     # cur 跳过 tmp,指向 tmp 的下一个节点
        tmp.next = pre.next     # 将 tmp 插入到 pre 后面
        pre.next = tmp          # 更新 pre 的 next 指向

    return dummy.next
复杂度分析
- 时间复杂度: O(N),其中 N 是链表的长度。需要遍历链表找到 m 和 n 的位置,并进行一次区间反转。
- 空间复杂度: O(1),迭代法仅使用常数个额外指针。
面试要点与扩展
- 理解指针操作的细节,防止指针丢失或错误连接。
- 考虑各种边界情况(如 m=1, n=链表长度, m=n)。
- 相关题目:反转整个链表 (LeetCode 206),K 个一组反转链表 (LeetCode 25)。
视频讲解:迭代与递归方式反转链表 (LeetCode 206 基础)
模块二:字符串 (Strings) - 模式的艺术
主题:匹配子字符串 (Substring Matching / String Searching)
在文本中高效地查找模式串是计算机科学中的一个基本问题,有着广泛的应用,如文本编辑器的查找功能、搜索引擎、生物信息学中的基因序列匹配等。
核心概念与算法
目标是在一个长文本字符串 (Text) 中查找一个或多个模式字符串 (Pattern) 的所有出现位置。
- 朴素算法 (Naive Algorithm):
- 原理:将模式串与文本串中所有可能的子串逐一比较。
- 实现:外层循环遍历文本串的起始位置,内层循环比较模式串。
- 复杂度:最坏情况下 O(m*n),其中 n 是文本长度,m 是模式长度。
- Rabin-Karp 算法:
- 原理:利用哈希函数快速比较子串。计算模式串的哈希值,然后计算文本中所有长度为 m 的子串的哈希值(使用滚动哈希优化计算)。如果哈希值匹配,再进行精确比较以排除哈希冲突。
- 复杂度:平均情况下 O(n+m),最坏情况(哈希冲突频繁)下 O(m*n)。
- KMP 算法 (Knuth-Morris-Pratt):
- 原理:利用模式串本身的性质,在匹配失败时,根据已匹配的前缀信息智能地移动模式串,避免不必要的回溯。核心是构建一个 "next" 数组(或称为失配函数、前缀函数)。
- 复杂度:O(n+m),预处理 next 数组 O(m),匹配过程 O(n)。
- Boyer-Moore 算法:
- 原理:从模式串的末尾开始比较。利用“坏字符规则”和“好后缀规则”尽可能大地向右移动模式串。
- 复杂度:通常比 KMP 更快,平均 O(n/m),最坏 O(n*m),但实际应用中表现优异。
- Aho-Corasick 算法:
- 原理:用于同时匹配多个模式串。构建一个有限自动机(Trie 树 + 失败指针)。
- 复杂度:构建自动机 O(L),匹配 O(n+k),L 是所有模式串总长,k 是匹配次数。
KMP 算法核心 - Next 数组构建 (Java)
// 构建 KMP 算法中的 next 数组 (前缀函数)
int[] buildNext(String p) {
    int m = p.length();
    int[] next = new int[m]; // next[i] 表示 p[0...i] 的最长相等前后缀长度
    int j = 0; // j 指向当前最长相等前后缀的末尾+1 (即长度)
    // next[0] 总是 0
    for (int i = 1; i < m; i++) {
        // 如果当前字符不匹配,回溯 j
        while (j > 0 && p.charAt(i) != p.charAt(j)) {
            j = next[j - 1];
        }
        // 如果当前字符匹配,增加 j
        if (p.charAt(i) == p.charAt(j)) {
            j++;
        }
        // 更新 next[i]
        next[i] = j;
    }
    return next;
}

// 使用 next 数组进行匹配 (伪代码)
void kmpSearch(String text, String pattern) {
    int n = text.length();
    int m = pattern.length();
    int[] next = buildNext(pattern);
    int j = 0; // pattern 的指针
    for (int i = 0; i < n; i++) { // text 的指针
        while (j > 0 && text.charAt(i) != pattern.charAt(j)) {
            j = next[j - 1]; // 失配,根据 next 数组移动 pattern 指针
        }
        if (text.charAt(i) == pattern.charAt(j)) {
            j++;
        }
        if (j == m) {
            System.out.println("Pattern found at index " + (i - m + 1));
            j = next[j - 1]; // 找到匹配后,继续查找下一个可能的匹配
        }
    }
}
面试要点
- 理解不同算法的原理、优缺点和适用场景。
- 能够手写 KMP 算法的核心代码,特别是 next 数组的构建。
- 了解 Rabin-Karp 的哈希冲突问题及其处理。
- 时间复杂度和空间复杂度的分析。
模块三:树 (Trees) - 递归与结构的和谐
主题:反转二叉树 (Invert/Mirror Binary Tree)
反转二叉树是一道经典的树操作题目,常用于考察对树的遍历(特别是递归思想)的理解。
核心概念与原理
反转(或镜像)一棵二叉树,意味着对于树中的每一个节点,都要交换其左子节点和右子节点。
例如,将:
      4
     / \
    2   7
   / \ / \
  1  3 6  9
反转为:
      4
     / \
    7   2
   / \ / \
  9  6 3  1
实现方法
- 递归法 (DFS):
- 如果当前节点为空,返回 null。
- 递归地反转左子树。
- 递归地反转右子树。
- 交换当前节点的左右子节点指针。
- 返回当前节点。
- 迭代法 (BFS 或 DFS):
- BFS (使用队列): 层序遍历树。对于访问到的每个节点,交换其左右子节点。然后将非空的子节点加入队列。
- DFS (使用栈): 先序遍历(或其他顺序)。对于访问到的每个节点,交换其左右子节点。然后将非空的子节点压入栈。
代码示例 (C++ - 递归法)
// 定义二叉树节点
struct TreeNode {
    int val;
    TreeNode *left;
    TreeNode *right;
    TreeNode() : val(0), left(nullptr), right(nullptr) {}
    TreeNode(int x) : val(x), left(nullptr), right(nullptr) {}
    TreeNode(int x, TreeNode *left, TreeNode *right) : val(x), left(left), right(right) {}
};

class Solution {
public:
    TreeNode* invertTree(TreeNode* root) {
        // 基线条件:如果节点为空,直接返回
        if (!root) {
            return nullptr;
        }

        // 交换当前节点的左右子节点指针
        // 注意:直接交换指针即可,不需要先递归再交换
        // TreeNode* temp = root->left;
        // root->left = root->right;
        // root->right = temp;
        // C++ 中可以用 swap 简化
        std::swap(root->left, root->right);

        // 递归地反转左子树和右子树
        invertTree(root->left);
        invertTree(root->right);

        // 返回反转后的根节点
        return root;
    }
};
复杂度分析
- 时间复杂度: O(N),其中 N 是树中的节点数,因为每个节点都需要访问一次。
- 空间复杂度:
- 递归法:O(H),H 是树的高度。在最坏情况下(链状树),H=N;在平衡二叉树中,H=logN。这是递归调用栈的深度。
- 迭代法 (BFS):O(W),W 是树的最大宽度。在最坏情况下(完美二叉树),W 约等于 N/2,即 O(N)。
- 迭代法 (DFS 使用栈):O(H),与递归法类似。
面试要点
- 熟练掌握递归和迭代两种实现方式。
- 理解树的遍历(前序、中序、后序、层序)及其在问题中的应用。
- 处理空树或只有一个节点的边界情况。
- 相关题目:判断两棵树是否镜像对称 (Symmetric Tree)。
模块四:栈与队列 (Stacks and Queues) - 结构的力量
主题:单调栈 / 单调队列 (Monotonic Stack / Monotonic Queue)
单调栈和单调队列是栈和队列的特殊应用,通过维持数据结构内元素的单调性(递增或递减),可以高效解决一系列涉及区间最值、下一个更大/更小元素等问题。
单调栈 (Monotonic Stack)
- 定义: 一种栈内元素始终保持单调递增或单调递减顺序的栈结构。
- 原理: 当一个新元素准备入栈时,为了维持栈的单调性,需要将栈顶所有“破坏”单调性的元素弹出。
- 应用:
- 寻找下一个更大元素 (Next Greater Element, NGE): 维护一个单调递减栈。当新元素 `nums[i]` 入栈时,栈顶元素若小于 `nums[i]`,则 `nums[i]` 就是该栈顶元素的 NGE,将其弹出,继续比较新的栈顶。最后将 `i` 入栈。
- 寻找下一个更小元素 (Next Smaller Element, NSE): 维护一个单调递增栈,逻辑类似。
- 计算矩形最大面积、接雨水等问题。
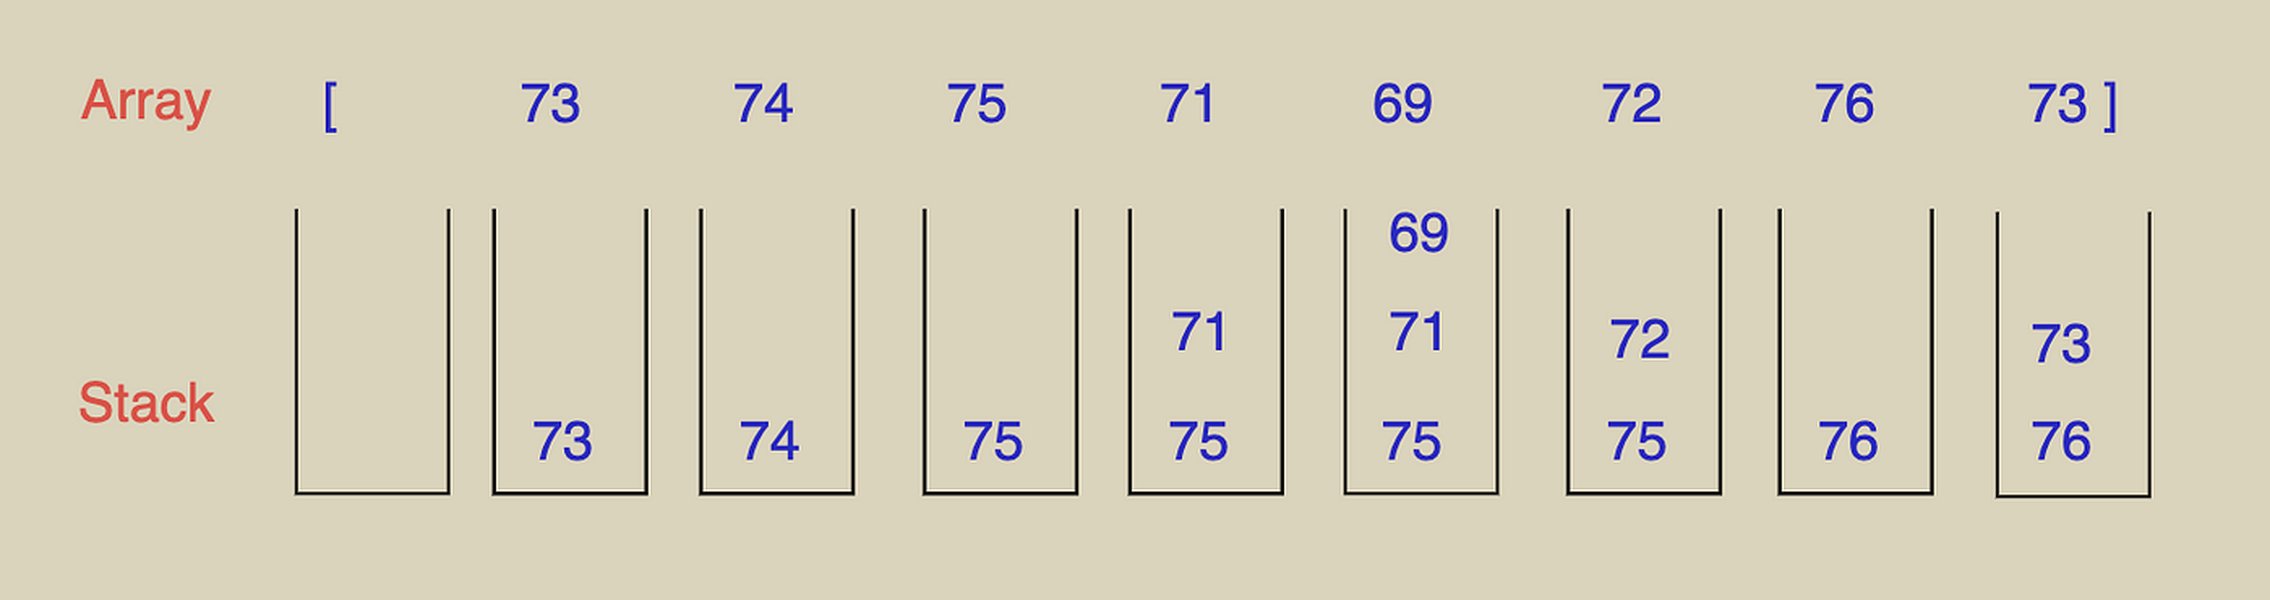
图解:使用单调栈寻找下一个更大元素的过程
代码示例 (Python - 寻找下一个更大元素)
def nextGreaterElement(nums):
    n = len(nums)
    res = [-1] * n # 结果数组,初始化为 -1
    stack = [] # 存储索引的单调递减栈

    for i in range(n):
        # 当栈不为空,且当前元素大于栈顶索引对应的元素时
        while stack and nums[i] > nums[stack[-1]]:
            # 栈顶元素的下一个更大元素就是当前元素 nums[i]
            idx = stack.pop()
            res[idx] = nums[i]
        # 将当前元素的索引入栈
        stack.append(i)

    return res

# 示例: nums = [2, 1, 2, 4, 3]
# 输出: res = [4, 2, 4, -1, -1]
单调队列 (Monotonic Queue)
- 定义: 一种队列内元素始终保持单调递增或递减顺序的队列结构(通常使用双端队列 Deque 实现)。
- 原理:
- 入队: 当新元素准备从队尾入队时,为了维持队列的单调性,将队尾所有“破坏”单调性的元素弹出,然后新元素入队。
- 出队: 当队首元素已经滑出窗口范围时,将其从队首弹出。
- 应用:
- 滑动窗口最大值/最小值: 维护一个单调递减/递增队列。队首元素始终是当前窗口的最大/最小值。
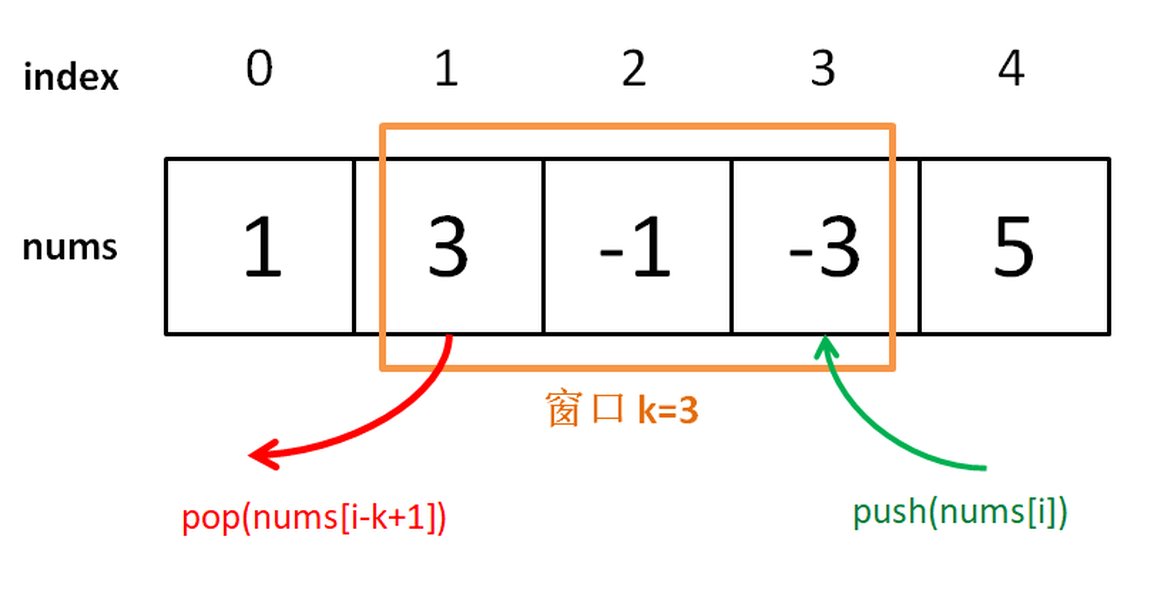
图解:使用单调队列解决滑动窗口最大值问题
复杂度分析
- 时间复杂度: 通常为 O(N),虽然有嵌套循环(`while` 在 `for` 内部),但每个元素最多入栈/出栈(或入队/出队)一次。
- 空间复杂度: O(N) 或 O(K),K 是窗口大小,取决于具体问题,最坏情况下所有元素可能都在栈或队列中。
面试要点
- 理解单调栈/队列的维护过程和核心思想。
- 能够识别适合使用单调栈/队列的问题模式。
- 熟练实现相关经典问题的代码。
模块五:图 (Graphs) - 探索连接的世界
主题:深度优先搜索 (DFS) 与 广度优先搜索 (BFS)
DFS 和 BFS 是图遍历的两种基本且核心的算法,是解决许多图相关问题的基础,如路径查找、连通性判断、拓扑排序、最短路径等。
图的基础
- 表示方法: 邻接矩阵 (Adjacency Matrix) 和 邻接表 (Adjacency List)。邻接表在稀疏图中更节省空间,常用。
- 分类: 有向图 vs 无向图,加权图 vs 无权图。
深度优先搜索 (DFS)
- 原理: “不撞南墙不回头”。从起始节点出发,尽可能深地探索图的分支。当访问到某个节点,且该节点的所有邻居都已被访问或没有邻居时,回溯到上一个节点,继续探索其他未访问的分支。
- 实现: 通常使用递归或显式栈 (Stack) 实现。需要记录已访问节点,防止无限循环。
- 特点: 找到的路径不一定是最短的。
- 应用: 查找路径、检测环、拓扑排序(有向无环图)、寻找连通分量、解决迷宫问题等。
广度优先搜索 (BFS)
- 原理: “逐层扩散”。从起始节点出发,首先访问其所有直接相邻的邻居,然后访问这些邻居的邻居,以此类推,一层一层地向外扩展。
- 实现: 通常使用队列 (Queue) 实现。需要记录已访问节点。
- 特点: 在无权图中,第一次找到目标节点时,所经过的路径就是从起点到该节点的最短路径。
- 应用: 查找无权图的最短路径、层序遍历、判断二分图、解决社交网络最短距离问题等。
DFS 与 BFS 对比
下表总结了 DFS 和 BFS 的主要区别和适用场景:
| 维度 | 深度优先搜索 (DFS) | 广度优先搜索 (BFS) |
|---|---|---|
| 数据结构 | 栈 (递归或显式栈) | 队列 |
| 搜索路径 | 深入探索一条分支到底 | 逐层向外扩展 |
| 最短路径 (无权图) | 不保证找到最短路径 | 保证找到最短路径 |
| 空间复杂度 | O(H),H 为最大深度/递归深度 | O(W),W 为图的最大宽度 |
| 适用场景 | 查找路径存在性、拓扑排序、寻找连通分量、查找环 | 无权图最短路径、层序遍历、判断二分图 |
代码模板 (Java - BFS)
import java.util.LinkedList;
import java.util.Queue;
import java.util.Set;
import java.util.HashSet;
// 假设 Node 类包含一个 neighbors 列表/集合

void bfs(Node startNode) {
    Queue<Node> queue = new LinkedList<>();
    Set<Node> visited = new HashSet<>(); // 记录已访问节点

    queue.offer(startNode);
    visited.add(startNode);

    while (!queue.isEmpty()) {
        Node currentNode = queue.poll();

        // 在这里处理 currentNode (例如打印,检查是否为目标节点等)
        System.out.println("Visiting node: " + currentNode.val); // 假设 Node 有 val 属性

        // 遍历当前节点的所有邻居
        for (Node neighbor : currentNode.neighbors) { // 假设 neighbors 是邻居列表
            // 如果邻居未被访问过
            if (!visited.contains(neighbor)) {
                visited.add(neighbor); // 标记为已访问
                queue.offer(neighbor); // 将邻居加入队列
            }
        }
    }
}
面试要点
- 理解两种遍历算法的原理和过程。
- 能够根据问题选择合适的遍历算法。
- 熟练编写 DFS 和 BFS 的代码(递归和迭代)。
- 注意处理图的表示(邻接表/矩阵)和 visited 集合的使用以避免死循环。
模块六:查找与排序 (Searching and Sorting) - 效率的基石
主题:快速排序 (QuickSort) 与 二分查找 (Binary Search)
快速排序是最高效的内部排序算法之一,而二分查找是在有序数据上进行高效查找的典范。两者都是面试中频繁考察的基础算法。
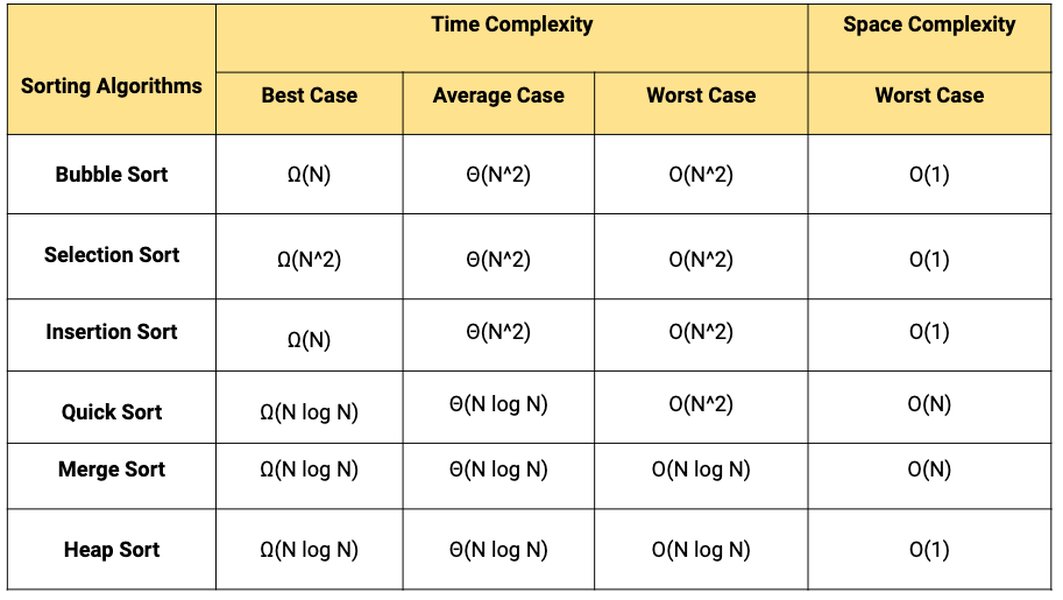
常见排序算法的时间和空间复杂度对比
快速排序 (QuickSort)
- 原理: 基于分治 (Divide and Conquer) 思想。
- 选择基准 (Pivot): 从数组中选择一个元素作为基准。
- 分区 (Partition): 重新排列数组,使得所有小于基准的元素移到基准前面,所有大于基准的元素移到基准后面。分区结束后,基准元素处于其最终排序位置。
- 递归: 递归地对基准左右两边的子数组进行快速排序。
- 复杂度:
- 平均时间复杂度:O(N log N)。
- 最坏时间复杂度:O(N^2)(发生在数组已经有序或接近有序,且每次都选到最小/最大元素作为基准时)。
- 空间复杂度:O(log N)(递归调用栈的平均深度),最坏 O(N)。
- 优化:
- 随机化基准: 随机选择基准元素,降低遇到最坏情况的概率。
- 三数取中: 取数组首、中、尾三个元素的中位数作为基准。
- 三路快排: 特别适用于处理含有大量重复元素的数组,将数组分为 < pivot, = pivot, > pivot 三部分。
- 小数组优化: 当子数组规模小于某个阈值时,改用插入排序等更优的算法。
- 尾递归优化: 减少递归深度。
- 稳定性: 快速排序是不稳定的排序算法。
二分查找 (Binary Search)
- 原理: 适用于已排序的数组或列表。通过比较目标值与数组中间元素的大小,每次将查找范围缩小一半,直至找到目标值或查找范围为空。
- 前提条件: 数据必须是有序的。
- 实现: 可以用迭代或递归实现。
- 复杂度:
- 时间复杂度:O(log N)。
- 空间复杂度:O(1)(迭代),O(log N)(递归)。
- 变种:
- 查找第一个等于目标值的元素。
- 查找最后一个等于目标值的元素。
- 查找第一个大于等于目标值的元素 (Lower Bound)。
- 查找第一个大于目标值的元素 (Upper Bound)。
- 在旋转排序数组中查找元素。
代码示例 (C++ - 标准二分查找)
#include <vector>

int binarySearch(const std::vector<int>& nums, int target) {
    int left = 0;
    int right = nums.size() - 1; // 注意这里的边界是 size() - 1

    while (left <= right) { // 循环条件是 left <= right
        // 防止整数溢出
        int mid = left + (right - left) / 2;

        if (nums[mid] == target) {
            return mid; // 找到目标值,返回索引
        } else if (nums[mid] < target) {
            left = mid + 1; // 目标值在右半部分
        } else { // nums[mid] > target
            right = mid - 1; // 目标值在左半部分
        }
    }

    return -1; // 未找到目标值
}
面试要点
- 熟练掌握快速排序的分区操作和递归实现。
- 理解快速排序的复杂度分析和优化方法。
- 熟练掌握二分查找的迭代和递归实现。
- 重点关注二分查找的边界条件处理(`left <= right` vs `left < right`, `right = mid` vs `right = mid - 1` 等)。
- 能够实现二分查找的各种变种。
算法能力雷达图评估
为了更好地理解这六大主题在算法面试中的重要性和考察维度,以下雷达图提供了一个直观的评估。评分基于一般面试情况下的相对重要性(主观评估,非精确数据):
- 实现复杂度 (Implementation Complexity): 编写无错代码的难度。
- 面试频率 (Interview Frequency): 在面试中出现的普遍程度。
- 时间效率重要性 (Time Efficiency Focus): 面试中对最优时间复杂度的强调程度。
- 空间效率关注度 (Space Efficiency Focus): 面试中对空间复杂度优化的关注程度。
- 概念深度 (Conceptual Depth): 理解相关理论和变种所需的深度。
- 优化技巧多样性 (Optimization Techniques): 可应用的优化策略的丰富程度。
课程结构思维导图
以下思维导图清晰地展示了本算法面试课程的整体结构和核心内容模块:
常见问题解答 (FAQ)
哪种字符串匹配算法最好?
没有绝对“最好”的算法,选择取决于具体场景:
- 朴素算法: 实现简单,适用于模式串很短或文本很短的情况。
- KMP: 理论复杂度优秀 O(n+m),在文本串较长、模式串重复性高时表现良好,且最坏情况有保障。
- Rabin-Karp: 平均情况快 O(n+m),实现相对简单,但需处理哈希冲突,最坏情况 O(nm)。适用于需要快速排除不匹配的情况。
- Boyer-Moore: 在实践中通常最快,尤其当字符集较大且模式串较长时,平均 O(n/m),但最坏情况 O(nm),实现相对复杂。
- Aho-Corasick: 专门用于同时匹配大量模式串,效率最高。
面试中,KMP 是最常被要求理解和实现的算法之一。
何时使用 DFS,何时使用 BFS?
选择 DFS 还是 BFS 取决于问题的目标:
- 需要找到达路径(不要求最短)或探索所有可能性: 通常使用 DFS。例如,查找图中是否存在从 A 到 B 的路径、找出所有连通分量、解决迷宫问题(找到一条出路即可)、拓扑排序等。DFS 更容易用递归实现,代码可能更简洁。
- 需要找到最短路径(在无权图中)或按层级处理: 通常使用 BFS。例如,查找 A 到 B 的最短距离、层序遍历树或图、社交网络中查找最短关系链等。BFS 能保证找到最短路径(按边数计)。
- 空间复杂度考虑: 如果图很深但宽度不大,DFS(递归栈)可能空间效率更高。如果图很宽但深度不大,BFS(队列)可能更优。
如何处理快速排序的最坏情况 O(N^2)?
快速排序的最坏情况通常发生在输入数组已经有序或接近有序,并且每次选取的基准 (pivot) 都是当前子数组的最小值或最大值时。这导致分区极其不平衡,递归深度达到 O(N)。处理方法主要有:
- 随机化基准 (Randomized Pivot): 不再固定选择第一个或最后一个元素,而是从当前子数组中随机选取一个元素作为基准。这使得出现最坏情况的概率大大降低,期望时间复杂度保持在 O(N log N)。
- 三数取中 (Median-of-Three): 取子数组的第一个、中间和最后一个元素,选择这三个元素的中位数作为基准。这也能有效避免在有序或反序数组上选到极端值。
- 内省排序 (Introsort): 结合了快速排序、堆排序和插入排序。开始时使用快速排序,当递归深度超过一定阈值(如 2*logN)时,切换到堆排序(保证最坏 O(N log N)),当子数组规模很小时,切换到插入排序(小数组效率高)。许多语言的标准库排序函数(如 C++ STL 的 `std::sort`)采用了类似策略。
二分查找的边界条件为什么容易出错?
二分查找的边界条件容易出错,主要是因为循环条件(`while(left <= right)` vs `while(left < right)`)和区间更新(`right = mid` vs `right = mid - 1`, `left = mid` vs `left = mid + 1`)需要精确匹配,以确保:
- 循环能够正确终止: 避免死循环。例如,当 `left == right` 时,如果更新是 `right = mid` 或 `left = mid`,且 `mid` 可能等于 `left` 或 `right`,就可能导致区间不再缩小。
- 查找区间覆盖所有可能: 确保目标值所在的区间不会被错误地排除。
- 避免越界: 确保 `mid` 的计算和访问 `nums[mid]` 不会越界。
常见的两种写法是:
- 闭区间 `[left, right]` 写法: 循环条件 `while (left <= right)`,更新 `left = mid + 1` 和 `right = mid - 1`。这种写法比较直观,`left` 和 `right` 都可能是解。
- 左闭右开区间 `[left, right)` 写法: 循环条件 `while (left < right)`,更新 `left = mid + 1` 和 `right = mid`。这种写法下,循环结束时 `left == right`,需要额外判断 `nums[left]` 是否为目标值。在查找边界问题时更常用。
关键在于保持对当前查找区间定义的一致性,并仔细推敲每次更新后区间是否正确缩小且包含潜在解。
推荐探索
参考资料
Last updated May 5, 2025