
เจาะลึก Apache Kafka: หัวใจของการประมวลผลข้อมูลแบบเรียลไทม์
ทำความเข้าใจแพลตฟอร์มสตรีมมิ่งข้อมูลแบบกระจายที่ขับเคลื่อนระบบขนาดใหญ่
ไฮไลต์สำคัญของ Apache Kafka
- Kafka เป็นแพลตฟอร์มสตรีมมิ่งข้อมูลแบบกระจาย (Distributed Event-Streaming Platform) ที่ออกแบบมาเพื่อจัดการข้อมูลจำนวนมหาศาลที่ถูกสร้างขึ้นอย่างต่อเนื่อง (Streaming Data) ในรูปแบบเรียลไทม์
- หลักการทำงานคล้าย Message Queue แต่เหนือกว่า โดยทำหน้าที่เป็นตัวกลางในการรับ-ส่งข้อมูล (Messages หรือ Events) ระหว่างผู้ผลิต (Producers) และผู้บริโภค (Consumers) ด้วยความเร็วสูง ความน่าเชื่อถือ และความสามารถในการขยายตัว (Scalability)
- สถาปัตยกรรมประกอบด้วย Producers, Consumers, Brokers (Kafka Servers), Topics, Partitions และ Zookeeper ซึ่งทำงานร่วมกันเพื่อจัดเก็บ ประมวลผล และกระจายข้อมูลได้อย่างมีประสิทธิภาพและทนทานต่อความผิดพลาด (Fault-Tolerant)
ในยุคที่ข้อมูลมีบทบาทสำคัญอย่างยิ่งต่อการดำเนินธุรกิจและการตัดสินใจ การจัดการข้อมูลที่หลั่งไหลเข้ามาอย่างต่อเนื่องและรวดเร็วเป็นความท้าทายที่สำคัญ Apache Kafka จึงถือกำเนิดขึ้นมาเพื่อตอบโจทย์นี้ ด้วยการเป็นแพลตฟอร์มโอเพนซอร์สแบบกระจายที่ช่วยให้องค์กรต่างๆ สามารถนำเข้า จัดเก็บ ประมวลผล และวิเคราะห์ข้อมูลแบบสตรีมมิ่งได้แบบเรียลไทม์อย่างมีประสิทธิภาพ
Apache Kafka คืออะไร?
Apache Kafka คือ open-source distributed event-streaming platform ที่ถูกสร้างขึ้นโดย LinkedIn ในปี 2011 และต่อมาได้กลายเป็นส่วนหนึ่งของ Apache Incubator ในปี 2012 ปัจจุบัน Kafka ถูกนำไปใช้อย่างแพร่หลายในการสร้าง real-time data pipeline และ streaming applications
ลองนึกภาพว่า Kafka เป็นเหมือน "คนกลาง" ที่เชื่อมต่อระหว่างผู้ส่งข้อมูล (Producers) และผู้รับข้อมูล (Consumers) ที่สนใจในข้อมูลชุดเดียวกัน (Topics) มันไม่ได้เป็นเพียงแค่ระบบจัดคิวข้อความ (Message Queue) ทั่วไป แต่ยังรวมความสามารถในการจัดเก็บข้อมูล (Storage) และการประมวลผลสตรีม (Stream Processing) เข้าไว้ด้วยกัน ทำให้สามารถเก็บและวิเคราะห์ข้อมูลได้ทั้งในอดีตและแบบเรียลไทม์
จุดเด่นของ Kafka อยู่ที่ความสามารถในการจัดการข้อมูลปริมาณมหาศาลที่เกิดขึ้นอย่างต่อเนื่องจากแหล่งข้อมูลหลายพันแห่งพร้อมกัน ตัวอย่างเช่น ข้อมูลการคลิกบนเว็บไซต์, ข้อมูลการขาย ณ จุดขาย, หรือข้อมูลจากอุปกรณ์ IoT ต่างๆ Kafka สามารถรับข้อมูลเหล่านี้เข้ามา จัดเก็บอย่างปลอดภัย และส่งต่อไปยังแอปพลิเคชันที่ต้องการใช้ข้อมูลนั้นได้อย่างรวดเร็วและน่าเชื่อถือ
ต้นกำเนิดและวิวัฒนาการของ Kafka
Kafka ถูกพัฒนาขึ้นมาเพื่อแก้ปัญหาที่ LinkedIn เผชิญในการจัดการกับข้อมูลเรียลไทม์จำนวนมากในระบบต่างๆ เดิมทีเป็นเพียง Message Queue แต่ก็พัฒนาอย่างรวดเร็วจนกลายเป็นแพลตฟอร์ม Event Streaming เต็มรูปแบบ ซึ่งสามารถรองรับข้อความได้มากกว่าหนึ่งล้านข้อความต่อวินาที หรือหลายล้านล้านข้อความต่อวัน การออกแบบของ Kafka ที่ใช้โมเดล log-based แบบกระจาย ทำให้สามารถขยายตัวได้อย่างยืดหยุ่นและมีความทนทานต่อความผิดพลาดสูง
หลักการทำงานของ Apache Kafka
Kafka ทำงานบนหลักการของ Event Streaming ซึ่งเป็นแนวคิดที่ว่าข้อมูลจะถูกมองว่าเป็นชุดของเหตุการณ์ (Events) ที่เกิดขึ้นอย่างต่อเนื่อง โดยแต่ละเหตุการณ์คือหน่วยของข้อมูล (Message) ที่ถูกส่งเข้าสู่ระบบ และ Kafka จะทำหน้าที่จัดเก็บและส่งต่อเหตุการณ์เหล่านั้น
ส่วนประกอบหลักในสถาปัตยกรรมของ Kafka
เพื่อให้เข้าใจการทำงานของ Kafka อย่างลึกซึ้ง เราจำเป็นต้องทำความเข้าใจส่วนประกอบหลักต่างๆ ที่ทำงานร่วมกัน:
Producers (ผู้ผลิต)
คือแอปพลิเคชันที่ทำหน้าที่ส่งข้อมูล (Messages หรือ Events) เข้าสู่ Kafka พวกเขา "ผลิต" ข้อมูล ตัวอย่างเช่น เว็บเซิร์ฟเวอร์ที่ส่งข้อมูลการคลิกของผู้ใช้ หรือแอปพลิเคชัน IoT ที่ส่งข้อมูลจากเซ็นเซอร์ Producers จะส่งข้อมูลไปยัง Topic ที่กำหนดไว้ และมักจะเลือก Partition ภายใน Topic เพื่อกระจายข้อมูลให้สมดุล หรือตามตรรกะที่กำหนด
Consumers (ผู้บริโภค)
คือแอปพลิเคชันที่ทำหน้าที่อ่านและประมวลผลข้อมูลจาก Kafka พวกเขา "บริโภค" ข้อมูลที่ Producers ส่งมา Consumers จะสมัครรับข้อมูล (Subscribe) จาก Topic ที่สนใจ แต่ละ Consumer จะมี Offset เป็นของตัวเองเพื่อบันทึกความคืบหน้าในการประมวลผลข้อมูล ทำให้สามารถกลับมาทำงานต่อจากจุดที่ค้างไว้ได้หากเกิดความล้มเหลว และหลาย Consumer สามารถอ่านข้อมูลจาก Stream เดียวกันได้โดยอิสระ
Brokers (Kafka Servers)
คือเซิร์ฟเวอร์ที่ประกอบกันเป็น Kafka Cluster แต่ละ Broker มี ID เฉพาะตัว ทำหน้าที่เก็บข้อมูล (Events) ที่ Producers ส่งมา และส่งข้อมูลนั้นให้กับ Consumers ที่ร้องขอ Broker จะจัดเก็บข้อมูลในระดับ Partition ของแต่ละ Topic โดย Kafka จะรู้เองว่าข้อมูลจาก Topic และ Partition ใดถูกเก็บไว้ที่ Broker ตัวใด
Topics
คือหมวดหมู่ของข้อความหรือ Events ที่ Producers ส่งเข้ามา และ Consumers สมัครรับเพื่ออ่าน Topics สามารถแบ่งออกเป็นหลาย Partitions เพื่อเพิ่มขีดความสามารถในการขนาน (Parallelism) และความทนทานต่อความผิดพลาด
Partitions
แต่ละ Topic จะถูกแบ่งออกเป็น 1 หรือมากกว่า Partitions ซึ่งเป็นหน่วยย่อยของการจัดเก็บข้อมูล แต่ละ Partition เป็น Append-Only Log ที่เรียงลำดับข้อมูลตามเวลาที่เข้ามา ข้อมูลในแต่ละ Partition จะถูกเขียนต่อท้ายเท่านั้น และไม่สามารถแก้ไขได้ Partitions ช่วยให้ Kafka สามารถประมวลผลข้อมูลแบบขนานได้ และยังเป็นหัวใจสำคัญของ Fault Tolerance เนื่องจากแต่ละ Partition สามารถมี Replica (สำเนา) บน Broker อื่นๆ ได้
Zookeeper
Zookeeper ทำหน้าที่เป็นผู้ดูแลและจัดการ Kafka Cluster (เหล่า Broker) มันจะบันทึกสถานะต่างๆ ของ Kafka Cluster เช่น Broker ตัวไหนยังทำงานอยู่ หรือตายไปแล้ว, Topic ไหนมีกี่ Partition, และจัดการการเลือก Leader/Replica ของ Partition อย่างไรก็ตาม ในเวอร์ชันใหม่ๆ ของ Kafka กำลังมีการพัฒนาให้สามารถทำงานได้โดยไม่ต้องพึ่งพา Zookeeper ในอนาคต
กลไกการทำงานร่วมกัน
เมื่อ Producers ส่ง Message เข้าสู่ Kafka พวกเขาจะเลือก Topic และ Partition ที่จะส่งข้อมูลไป ข้อมูลจะถูกเขียนลงใน Partition นั้นๆ บน Broker ที่รับผิดชอบ เมื่อ Consumers ต้องการอ่านข้อมูล พวกเขาจะดึงข้อมูลจาก Partition ที่ต้องการ การทำงานจะคล้ายกับ Write-Ahead Logging (WAL) กล่าวคือ Kafka จะบันทึกข้อมูลลงไฟล์หรือ Log ก่อนที่ Consumer จะเห็นและนำไปประมวลผลต่อได้
ความสามารถในการทำ Replication ของ Partition ข้าม Broker ทำให้ Kafka มีความทนทานต่อความผิดพลาดสูง หาก Broker ตัวใดล้มเหลว ข้อมูลใน Partition ที่อยู่บน Broker นั้นก็ยังคงมีสำเนา (Replica) อยู่บน Broker อื่นๆ ทำให้ระบบยังคงทำงานต่อไปได้โดยไม่หยุดชะงัก
จากแผนภูมิเรดาร์ข้างต้นแสดงให้เห็นถึงจุดแข็งที่โดดเด่นของ Apache Kafka เมื่อเทียบกับ Message Queue ทั่วไป Kafka มีคะแนนสูงในด้านความเร็วสูง ความทนทานข้อมูล การขยายตัว (Scalability) ความน่าเชื่อถือ และการประมวลผลเรียลไทม์ ซึ่งเป็นคุณสมบัติที่ทำให้ Kafka เป็นทางเลือกที่เหนือกว่าสำหรับแอปพลิเคชันที่ต้องการจัดการข้อมูลสตรีมมิ่งปริมาณมากและมีความสำคัญ
ประโยชน์และจุดเด่นของ Apache Kafka
Kafka ไม่ได้เป็นแค่ Message Queue ธรรมดา แต่เป็นแพลตฟอร์มที่มีคุณสมบัติโดดเด่นหลายประการที่ทำให้เหมาะสำหรับการประมวลผลข้อมูลขนาดใหญ่และเรียลไทม์
ความเร็วสูง (High Throughput)
Kafka ถูกออกแบบมาให้สามารถรองรับการรับส่งข้อมูลจำนวนมหาศาลได้อย่างรวดเร็ว ด้วยสถาปัตยกรรมแบบ Distributed และการเขียนข้อมูลแบบ Append-Only Log ทำให้มี Latency ต่ำ เหมาะสำหรับแอปพลิเคชันที่ต้องการข้อมูลแบบ Real-time เช่น การวิเคราะห์ข้อมูลตลาดหุ้น หรือการติดตามข้อมูลในระบบต่างๆ
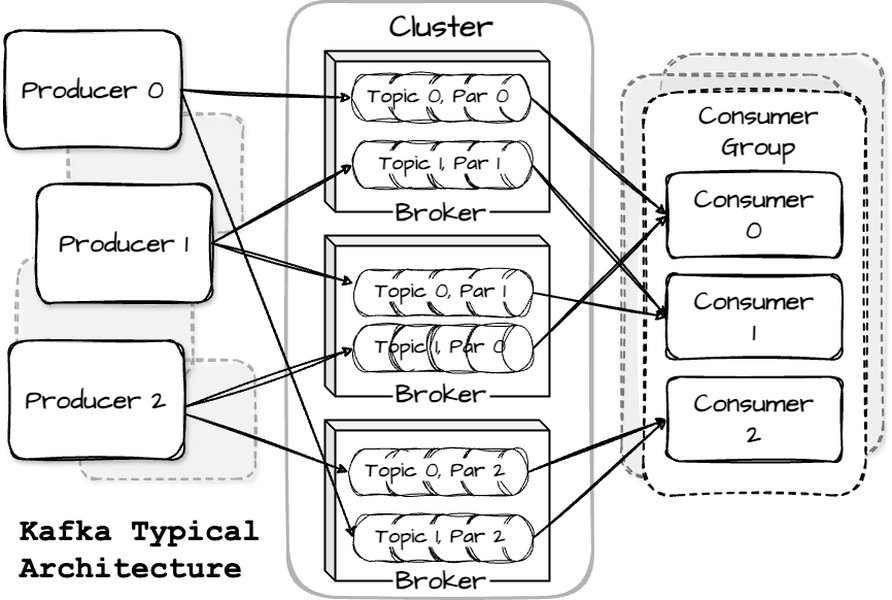 สถาปัตยกรรมของ Apache Kafka แสดงถึงการไหลของข้อมูลจาก Producers ไปยัง Consumers ผ่าน Kafka Brokers
ความสามารถในการขยายตัว (Scalability)
Kafka Cluster สามารถขยายขนาดได้ง่าย ทั้งในแนวตั้ง (เพิ่มทรัพยากรให้กับ Broker) และแนวนอน (เพิ่มจำนวน Broker) โดยสามารถรองรับได้ถึงหนึ่งพัน Broker และจัดการข้อความได้หลายล้านล้านข้อความต่อวัน ทำให้เหมาะกับระบบที่มีการเติบโตของข้อมูลอย่างรวดเร็ว
ความทนทานต่อความผิดพลาด (Fault-Tolerance) และความน่าเชื่อถือ (Reliability)
ด้วยการทำ Replication ของ Partition ทำให้ Kafka สามารถจัดเก็บข้อมูลได้อย่างปลอดภัยและทนทาน หาก Broker ตัวใดล้มเหลว ข้อมูลยังคงสามารถเข้าถึงได้จาก Replica บน Broker อื่นๆ นอกจากนี้ Kafka ยังใช้ Offset เพื่อบันทึกความคืบหน้าของ Consumer ทำให้สามารถกลับมาประมวลผลต่อจากจุดที่หยุดไปได้โดยไม่เกิดข้อมูลซ้ำซ้อน
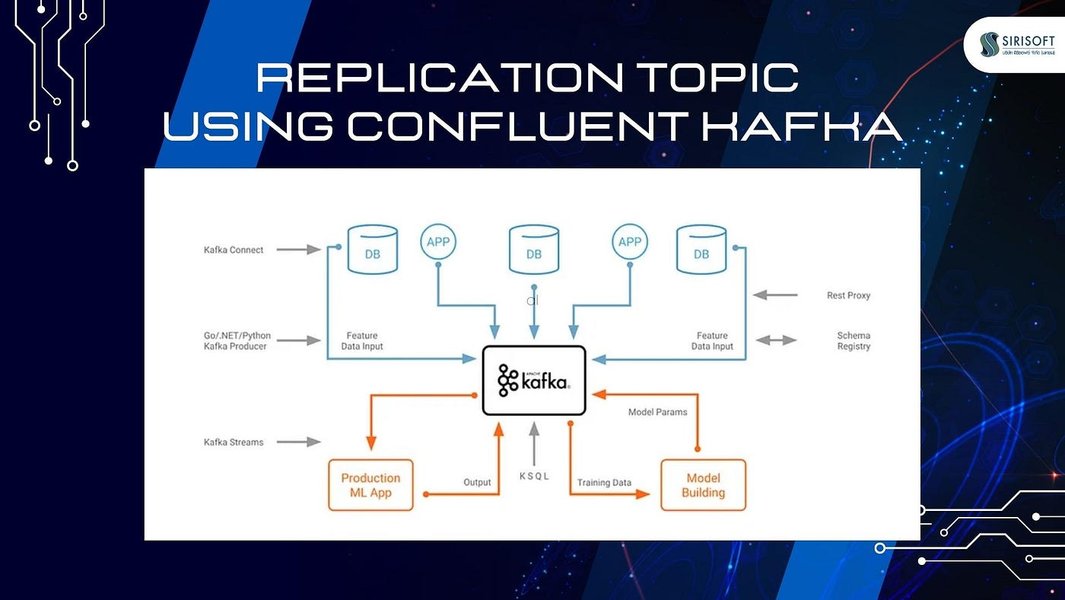 การทำ Replication ของ Topic ใน Confluent Kafka เพื่อเพิ่มความทนทานต่อความผิดพลาด
การประมวลผลสตรีม (Stream Processing)
Kafka ไม่เพียงแค่จัดเก็บและส่งต่อข้อมูลเท่านั้น แต่ยังมี Kafka Streams API ซึ่งเป็นไลบรารีที่มีประสิทธิภาพสำหรับประมวลผลและวิเคราะห์ข้อมูลแบบ On-the-fly ทำให้สามารถรวมข้อมูล กำหนดช่วงเวลา หรือทำการ Join ข้อมูลภายใน Stream ได้
ความสามารถในการเก็บบันทึกข้อมูล (Durable Storage)
Kafka เก็บข้อความไว้ใน Log ที่ทนทาน ทำให้ Consumers หลายตัวสามารถอ่านข้อมูลจาก Stream เดียวกันได้ในเวลาที่ต่างกัน และสามารถย้อนกลับไปอ่านข้อมูลเก่าได้หากต้องการ ซึ่งแตกต่างจาก Message Queue แบบดั้งเดิมที่มักจะลบข้อความทันทีที่ Consumer ดึงไป
กรณีการใช้งาน (Use Cases) ของ Apache Kafka
ด้วยคุณสมบัติที่กล่าวมาข้างต้น Kafka จึงถูกนำไปใช้ในสถานการณ์ต่างๆ มากมายในอุตสาหกรรมต่างๆ:
Real-time Data Pipelines
ใช้ในการเคลื่อนย้ายข้อมูลจากระบบหนึ่งไปยังอีกระบบหนึ่งได้อย่างน่าเชื่อถือและรวดเร็ว เช่น การนำข้อมูลกิจกรรมผู้ใช้จากเว็บไซต์เข้าสู่ระบบวิเคราะห์เพื่อติดตามพฤติกรรมแบบเรียลไทม์
Activity Tracking และ Log Aggregation
เป็นเครื่องมือที่ยอดเยี่ยมในการติดตามกิจกรรมของผู้ใช้บนเว็บไซต์ เช่น การดูหน้าเว็บ การค้นหา หรือการอัปโหลด นอกจากนี้ยังใช้ในการรวบรวม Log จากแอปพลิเคชันและเซิร์ฟเวอร์ต่างๆ เข้ามาไว้ที่ส่วนกลาง
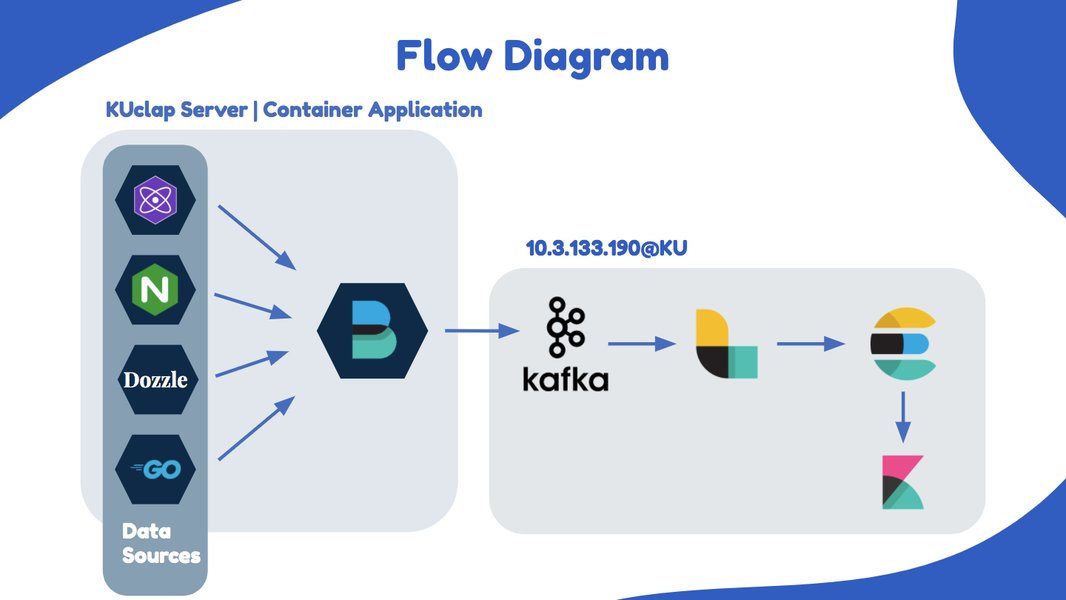 ตัวอย่างการรวม Log เข้าสู่ส่วนกลางด้วย Kafka และ Elastic Stack
Event-Driven Architecture
เป็นแกนหลักของการสร้างระบบที่ขับเคลื่อนด้วยเหตุการณ์ (Event-Driven Systems) ซึ่งแอปพลิเคชันจะสื่อสารกันผ่าน Events ทำให้ระบบมีความยืดหยุ่นและขยายตัวได้ดี
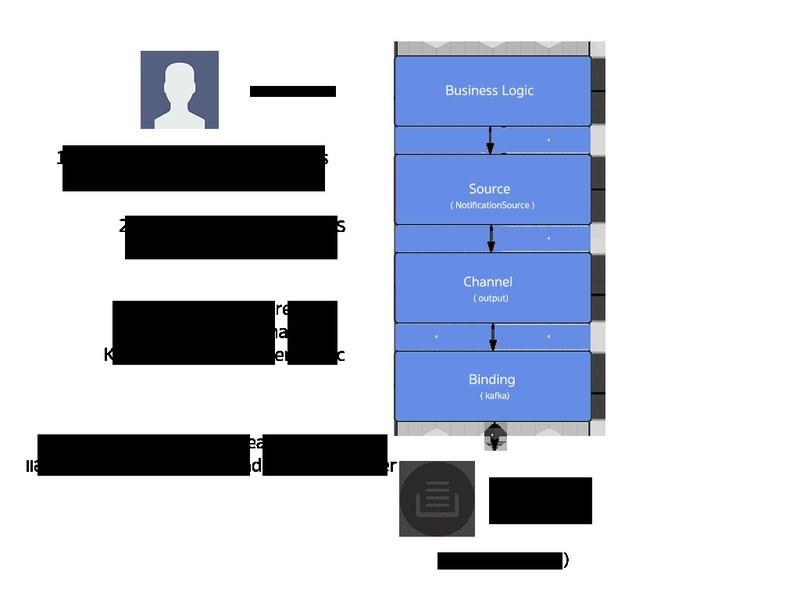 การสร้างระบบ Event-Driven ด้วย Spring Cloud Stream และ Apache Kafka
Stream Processing
ใช้ในการประมวลผลข้อมูลแบบเรียลไทม์เพื่อสร้าง Dashboard วิเคราะห์ข้อมูล หรือทำการแจ้งเตือนแบบทันที
Message Broker ขนาดใหญ่
ทำหน้าที่เป็นตัวกลางในการส่งข้อความระหว่าง Microservices หรือระบบขนาดใหญ่ที่ต้องการการส่งข้อมูลที่รวดเร็วและน่าเชื่อถือ
ความแตกต่างระหว่าง Kafka กับ Message Queue อื่นๆ (เช่น RabbitMQ)
แม้ว่า Kafka จะถูกเรียกว่า Message Queue ในบางบริบท แต่ก็มีความแตกต่างพื้นฐานกับ Message Queue แบบดั้งเดิมอย่าง RabbitMQ ที่สำคัญคือ:
| คุณสมบัติ | Apache Kafka | Traditional Message Queue (เช่น RabbitMQ) |
|---|---|---|
| วัตถุประสงค์หลัก | แพลตฟอร์ม Event Streaming สำหรับ Data Pipelines และ Streaming Applications | ระบบจัดคิวข้อความสำหรับการส่งข้อความแบบจุดต่อจุด (Point-to-Point) หรือเผยแพร่-สมัครรับข้อมูล (Publish-Subscribe) |
| การจัดเก็บข้อมูล | เก็บข้อมูลใน Append-Only Log ที่ทนทาน สามารถย้อนอ่านได้หลายครั้งโดยหลาย Consumer | ข้อความมักถูกลบออกเมื่อ Consumer ดึงไปใช้งานแล้ว |
| รูปแบบการอ่านข้อมูล | Consumer แต่ละตัวมี Offset ของตัวเอง สามารถอ่านข้อมูลจาก Partition เดียวกันได้อย่างอิสระ | มักใช้โมเดลคิวที่ข้อความจะถูกส่งไปยัง Consumer เพียงตัวเดียว หรือโมเดล Topic ที่ข้อความจะถูกส่งไปยัง Subscriber ทุกตัว |
| Scalability | ออกแบบมาสำหรับการขยายตัวแนวนอน (Horizontal Scaling) และ Throughput สูงมาก | สามารถขยายตัวได้ แต่โดยทั่วไปไม่เท่า Kafka ในแง่ของ Throughput สำหรับข้อมูลสตรีมมิ่งขนาดใหญ่ |
| Fault-Tolerance | มีการทำ Replication ของ Partition เพื่อความทนทานต่อความผิดพลาดสูง | มีกลไกรับประกันข้อความและการยืนยัน แต่โครงสร้างต่างกัน |
| การประมวลผลข้อมูล | มี Kafka Streams API สำหรับการประมวลผลข้อมูลแบบเรียลไทม์บน Stream โดยตรง | โดยทั่วไปเน้นการส่งข้อความ ไม่ได้มีฟังก์ชันการประมวลผลในตัว |
| Use Cases | Log aggregation, Activity tracking, IoT data, Real-time analytics, Event Sourcing | Task queues, Background jobs, Inter-service communication ใน Microservices |
วิดีโอด้านล่างนี้จะช่วยให้เห็นภาพรวมของ Apache Kafka และการทำงานของมันได้ชัดเจนยิ่งขึ้น
วิดีโอจาก Simplilearn ที่อธิบาย Apache Kafka สำหรับผู้เริ่มต้น โดยครอบคลุมถึงสิ่งที่ Kafka คือ และกรณีการใช้งานจริงข้อกำหนดเบื้องต้นในการเรียนรู้ Kafka
สำหรับการเริ่มต้นเรียนรู้และใช้งาน Apache Kafka อย่างมีประสิทธิภาพ มีความรู้พื้นฐานบางอย่างที่ควรมี:
ความเข้าใจระบบปฏิบัติการ Linux
เนื่องจาก Kafka มักจะถูกติดตั้งและรันบนสภาพแวดล้อม Linux การมีความรู้พื้นฐานเกี่ยวกับคำสั่งและการจัดการระบบ Linux จะเป็นประโยชน์อย่างมาก
ความเชี่ยวชาญด้าน Java หรือภาษาโปรแกรมอื่นที่รองรับ
Kafka ถูกพัฒนาด้วย Java และ Scala แต่ก็มี Client Library สำหรับภาษาอื่นๆ อีกมากมาย (เช่น Python, Go, Node.js) การมีความรู้ในภาษาโปรแกรมใดภาษาหนึ่งที่ใช้ในการพัฒนา Producer และ Consumer จะช่วยให้เริ่มต้นใช้งานได้ง่ายขึ้น
ความรู้ด้านเครือข่ายคอมพิวเตอร์
เนื่องจาก Kafka เป็นระบบแบบกระจายที่ทำงานผ่านเครือข่าย การมีความรู้พื้นฐานเกี่ยวกับ Network, IP, Port, และการสื่อสารระหว่าง Server จะช่วยให้เข้าใจการทำงานและการแก้ไขปัญหาได้ดีขึ้น
แนวคิดเกี่ยวกับ Distributed Systems
การทำความเข้าใจแนวคิดพื้นฐานของระบบกระจาย (Distributed Systems) เช่น Consistency, Availability, Partition Tolerance (CAP Theorem) จะช่วยให้มองเห็นภาพรวมของ Kafka และการออกแบบระบบได้ดีขึ้น
สรุป
Apache Kafka เป็นมากกว่าแค่ Message Queue แต่เป็นแพลตฟอร์ม Event Streaming ที่ทรงพลังและยืดหยุ่น ซึ่งช่วยให้องค์กรต่างๆ สามารถจัดการกับข้อมูลจำนวนมหาศาลที่เกิดขึ้นอย่างต่อเนื่องในแบบเรียลไทม์ได้อย่างมีประสิทธิภาพและน่าเชื่อถือ ด้วยสถาปัตยกรรมที่ออกแบบมาเพื่อความเร็วสูง การขยายตัว และความทนทานต่อความผิดพลาด ทำให้ Kafka เป็นเครื่องมือสำคัญในการขับเคลื่อนระบบที่ต้องการการประมวลผลข้อมูลแบบทันทีและต่อเนื่องในโลกดิจิทัลปัจจุบัน
คำถามที่พบบ่อย (FAQ)
Kafka ต่างจาก RabbitMQ อย่างไร?
Zookeeper มีบทบาทอย่างไรใน Kafka?
Producer และ Consumer ใน Kafka คืออะไร?
Topic และ Partition ใน Kafka คืออะไร?
หัวข้อที่แนะนำสำหรับการค้นคว้าเพิ่มเติม
- Kafka Streams API คืออะไรและใช้ทำอะไรได้บ้าง?
- เปรียบเทียบ Apache Kafka กับ Apache Spark Streaming แตกต่างกันอย่างไร?
- วิธีการทำ Monitoring สำหรับ Kafka Cluster ที่มีประสิทธิภาพ
- แนวทางการตั้งค่า Apache Kafka เพื่อให้ได้ High Availability และ Disaster Recovery
ผลการค้นหาอ้างอิง
 aws.amazon.com