
เจาะลึก Apache Kafka: หัวใจของการประมวลผลข้อมูลแบบเรียลไทม์
ทำความเข้าใจถึงหลักการทำงาน โครงสร้าง และประโยชน์ของแพลตฟอร์มสตรีมมิ่งข้อมูลอันทรงพลัง
Apache Kafka คือแพลตฟอร์มการสตรีมเหตุการณ์แบบกระจาย (distributed event-streaming platform) แบบโอเพนซอร์สที่ถูกออกแบบมาเพื่อจัดการกับข้อมูลจำนวนมหาศาลได้อย่างรวดเร็วและน่าเชื่อถือในแบบเรียลไทม์ เดิมที Kafka ถูกพัฒนาขึ้นโดย LinkedIn ในปี 2010 เพื่อจัดการกับข้อมูลกิจกรรมของผู้ใช้และบันทึกระบบภายในองค์กร ก่อนจะถูกเปิดเป็นโอเพนซอร์สในปี 2011 และกลายเป็นโครงการภายใต้ Apache Incubator ในปี 2012 ปัจจุบัน Kafka ได้รับการนำไปใช้อย่างแพร่หลายในการสร้างไปป์ไลน์ข้อมูลแบบเรียลไทม์ (real-time data pipelines) และแอปพลิเคชันที่ประมวลผลสตรีมข้อมูล (streaming applications) ในองค์กรขนาดใหญ่ทั่วโลก
สรุปประเด็นสำคัญของ Apache Kafka
- Kafka เป็นศูนย์กลางข้อมูลแบบเรียลไทม์: ทำหน้าที่เป็นตัวกลางที่เชื่อถือได้ในการรับส่ง จัดเก็บ และประมวลผลข้อมูลสตรีมมิ่งจากผู้ผลิต (Producers) ไปยังผู้บริโภค (Consumers) โดยมีประสิทธิภาพสูงและมีความทนทานต่อความเสียหาย
- สถาปัตยกรรมแบบกระจายตัว: Kafka ทำงานบนหลักการของระบบกระจายตัว (distributed system) ประกอบด้วย Broker หลายตัวที่ทำงานร่วมกันเป็นคลัสเตอร์ ทำให้มีความสามารถในการขยายขนาด (scalability) และความพร้อมใช้งานสูง (high availability)
- Topic และ Partition คือหัวใจ: ข้อมูลใน Kafka จะถูกจัดเก็บใน Topic ซึ่งแบ่งย่อยเป็น Partition เพื่อเพิ่มประสิทธิภาพในการเขียนและอ่านข้อมูลแบบขนาน ทำให้สามารถรองรับปริมาณข้อมูลที่สูงมากได้อย่างมีประสิทธิภาพ
Apache Kafka คืออะไร?
ในแก่นแท้ของมัน Apache Kafka ทำหน้าที่เป็น "คนกลาง" ที่คอยจัดการการไหลของข้อมูลระหว่างระบบต่างๆ โดยเฉพาะอย่างยิ่งข้อมูลที่เกิดขึ้นอย่างต่อเนื่องและรวดเร็ว หรือที่เรียกว่า "Streaming Data" แนวคิดนี้คล้ายกับการเป็น "Message Queue" ที่มีประสิทธิภาพสูง แต่มีความสามารถในการจัดเก็บข้อมูล (storage) และประมวลผลสตรีม (stream processing) เพิ่มเติมเข้ามา ทำให้เป็นมากกว่าแค่ระบบรับส่งข้อความทั่วไป
ลองจินตนาการถึงสถานการณ์ที่ระบบต่างๆ ในองค์กรต้องการแลกเปลี่ยนข้อมูลกันแบบเรียลไทม์ ไม่ว่าจะเป็นข้อมูลการคลิกบนเว็บไซต์, บันทึกการทำรายการ, ข้อมูลเซ็นเซอร์, หรือกิจกรรมของผู้ใช้ต่างๆ แทนที่แต่ละระบบจะต้องเชื่อมต่อและสื่อสารกันโดยตรง ซึ่งจะทำให้เกิดความซับซ้อนและปัญหาในการขยายขนาด Kafka เข้ามาทำหน้าที่เป็นศูนย์กลางที่ทุกระบบสามารถส่งข้อมูลเข้ามา (ในฐานะ Producer) และรับข้อมูลออกไป (ในฐานะ Consumer) ได้อย่างอิสระและเชื่อถือได้
วิวัฒนาการจาก Message Queue สู่ Event Streaming Platform
แรกเริ่มเดิมที Kafka ถูกออกแบบมาเพื่อแก้ปัญหาการจัดการข้อมูลจำนวนมากที่หลั่งไหลเข้ามาอย่างต่อเนื่องที่ LinkedIn ซึ่งระบบเดิมที่ใช้การเก็บข้อมูลเป็นไฟล์ XML และประมวลผลแบบ Batch นั้นไม่สามารถรองรับความต้องการได้อีกต่อไป ด้วยความต้องการที่จะรองรับ "Stream Data" ที่มีความรวดเร็วสูงและมีความคงทนต่อความเสียหาย จึงนำไปสู่การพัฒนา Kafka ซึ่งเป็นระบบที่ทำงานแบบกระจายตัว (Distributed System) และมีความสามารถในการทำงานแบบ Publish-Subscribe
Kafka ได้พัฒนาจากเพียงแค่ Message Queue ไปสู่การเป็น Event Streaming Platform อย่างเต็มรูปแบบ ซึ่งหมายถึงความสามารถในการจัดการกับ "เหตุการณ์" (events) หรือข้อมูลขนาดเล็กๆ ที่เกิดขึ้นอย่างต่อเนื่อง และนำมาประมวลผลได้ทันทีเพื่อการใช้งานแบบเรียลไทม์หรือเกือบเรียลไทม์
Kafka ทำงานอย่างไร: สถาปัตยกรรมและองค์ประกอบหลัก
Kafka ทำงานโดยผสมผสานแนวคิดของ การจัดคิว (queuing) และการเผยแพร่-สมัครรับข้อมูล (publish-subscribe) เข้าด้วยกัน เพื่อมอบประโยชน์หลักๆ ในการจัดการข้อมูลสตรีมมิ่งอย่างมีประสิทธิภาพ โดยมีองค์ประกอบหลักดังนี้:
Producer: ผู้ส่งข้อมูล
Producer คือแอปพลิเคชันหรือระบบต้นทางที่ทำหน้าที่ ส่งข้อมูลหรือเหตุการณ์ (event) เข้ามาใน Kafka โดยข้อมูลจะถูกส่งไปยัง "Topic" ที่ระบุไว้ Producer มีหน้าที่เลือก Partition ภายใน Topic เพื่อกระจายข้อมูล ซึ่งโดยปกติจะทำงานเป็นแบบ Round-robin เพื่อความสมดุล หรืออาจใช้ฟังก์ชันอื่นในการกระจายได้
ภาพ: แสดงกระบวนการที่ Producer ส่งข้อมูลเข้าสู่ Kafka
Topic: หมวดหมู่ข้อมูล
Topic คือชื่อหมวดหมู่ (category) หรือชื่อกลุ่มของข้อมูลที่เราต้องการบันทึกและเผยแพร่ แต่ละ Topic จะมีชื่อที่ไม่ซ้ำกันและเป็นที่เก็บข้อมูลหลักใน Kafka ข้อมูลภายใน Topic จะถูกจัดเก็บในรูปแบบ Log ซึ่งเป็นลำดับของ Record ที่ไม่สามารถเปลี่ยนแปลงได้
Partition: การแบ่งส่วนข้อมูล
แต่ละ Topic สามารถแบ่งออกเป็นหลาย Partition ได้ ซึ่งแต่ละ Partition เป็นลำดับของ Record ที่ถูกจัดเก็บแบบเรียงตามลำดับ (ordered, immutable sequence of records) แต่ละ Record ใน Partition จะมี "Offset" ที่เป็นตัวระบุตำแหน่งเฉพาะ ซึ่งช่วยให้ Consumer สามารถติดตามความคืบหน้าในการประมวลผลข้อมูลได้ การแบ่งเป็น Partition ช่วยให้ Kafka สามารถประมวลผลข้อมูลแบบขนาน (parallel processing) และกระจายโหลดไปยัง Broker ต่างๆ ได้
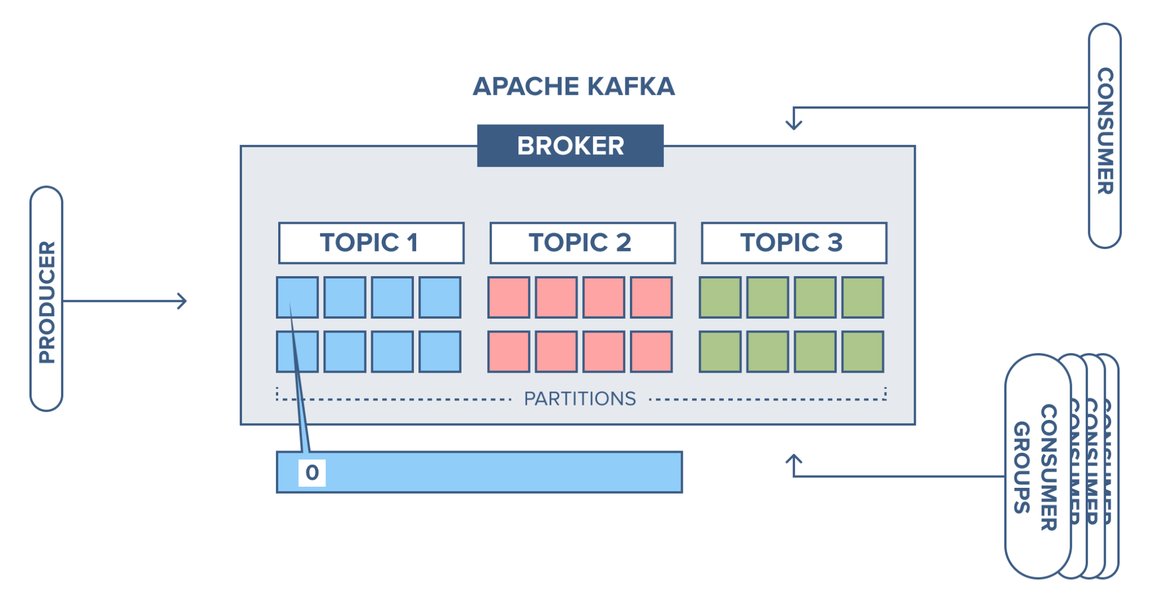
ภาพ: โครงสร้างของ Topic ที่แบ่งออกเป็น Partition
Replica: การสำเนาข้อมูลเพื่อความคงทน
Partition สามารถมีการสำเนา (replicate) ไปยัง Broker อื่นๆ ได้ เพื่อเพิ่มความคงทนต่อความเสียหาย (fault tolerance) หาก Broker ตัวใดตัวหนึ่งล้มเหลว ข้อมูลยังคงสามารถเข้าถึงได้จาก Replica ที่อยู่บน Broker อื่นๆ
Broker: เซิร์ฟเวอร์ Kafka
Broker คือเซิร์ฟเวอร์ (node) ที่เป็นส่วนหนึ่งของ Kafka Cluster ทำหน้าที่จัดเก็บข้อมูลจาก Producer และส่งข้อมูลไปยัง Consumer แต่ละ Broker จะมี ID ที่ไม่ซ้ำกัน และจะบรรจุข้อมูลในระดับ Partition ของแต่ละ Topic ภายในตัวมันเอง Kafka Cluster มักประกอบด้วย Broker หลายตัวที่ทำงานร่วมกัน เพื่อให้สามารถขยายขนาดและรองรับปริมาณงานที่เพิ่มขึ้นได้
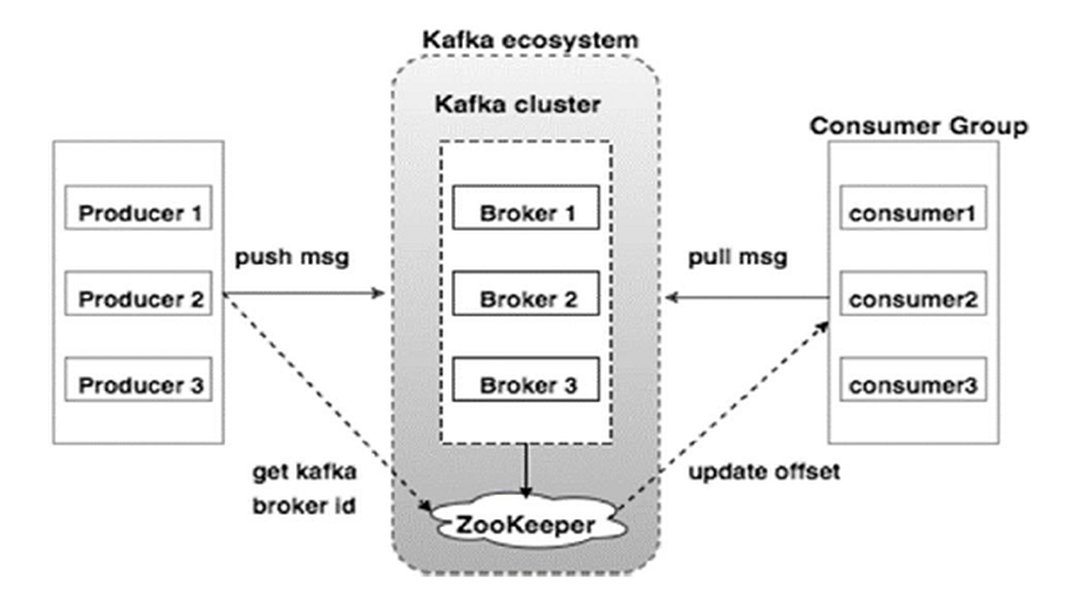
ภาพ: สถาปัตยกรรมของ Kafka Cluster
Consumer: ผู้รับข้อมูล
Consumer คือแอปพลิเคชันหรือระบบปลายทางที่ มาอ่านข้อมูลจาก Topic ที่ต้องการ Consumer แต่ละตัวจะติดตามความคืบหน้าในการอ่านข้อมูลด้วย "Offset" ของตัวเอง ทำให้ Consumer หลายตัวสามารถอ่านข้อมูลจาก Topic เดียวกันได้อย่างอิสระโดยไม่กระทบกัน
Consumer Group: การประมวลผลข้อมูลแบบขนาน
Consumer สามารถจัดกลุ่มกันเป็น "Consumer Group" ได้ โดยในแต่ละ Consumer Group จะมี Consumer หลายตัวที่ทำงานร่วมกันเพื่อประมวลผล Partition ต่างๆ ของ Topic เดียวกัน ซึ่งช่วยให้สามารถประมวลผลข้อมูลแบบขนานและเพิ่ม Throughput ได้ โปรโตคอล Consumer Group ได้รับการปรับปรุงอย่างต่อเนื่องเพื่อลด Downtime และ Latency ในการรับส่งข้อมูล
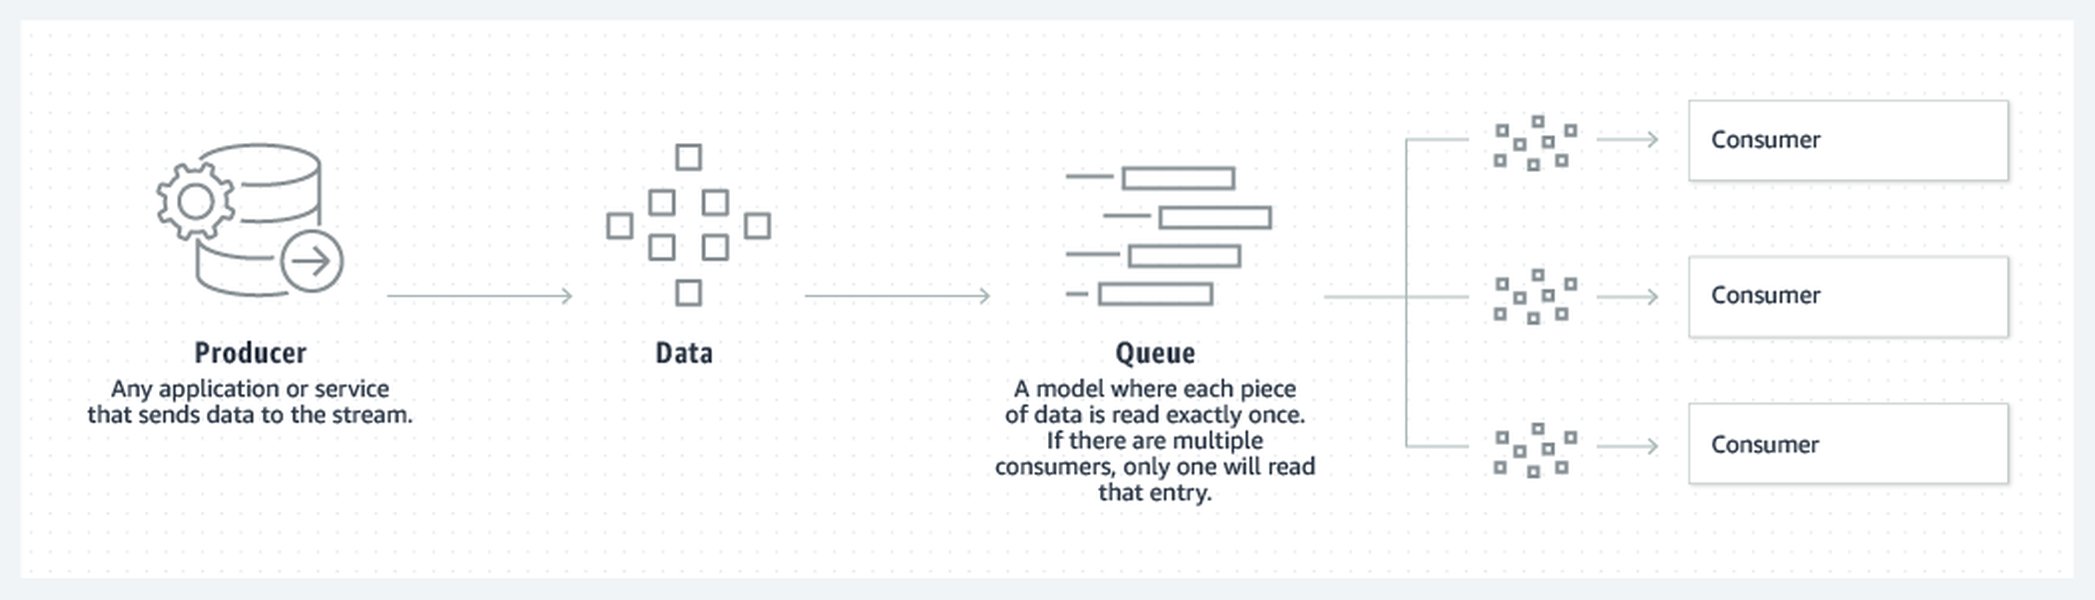
ภาพ: โมเดล Publish-Subscribe ของ Kafka
Zookeeper (สำหรับ Kafka เวอร์ชันเก่า) และ KRaft (สำหรับ Kafka เวอร์ชันใหม่)
สำหรับ Kafka เวอร์ชันเก่า Zookeeper มีบทบาทสำคัญในการจัดการคลัสเตอร์ เช่น การดูแลสถานะของ Broker, การเลือก Leader สำหรับ Partition และการจัดการ Configuration ต่างๆ
แต่ใน Apache Kafka 4.0 เป็นต้นไป ได้มีการเปลี่ยนมาใช้ KRaft (Kafka Raft metadata mode) ซึ่งมีเป้าหมายเพื่อลด Operational Cost/Time และปรับปรุงประสิทธิภาพ โดย KRaft จะทำหน้าที่จัดการ Metadata ของคลัสเตอร์แทน Zookeeper ทำให้ Kafka สามารถทำงานได้อย่างอิสระและมีประสิทธิภาพมากยิ่งขึ้น
กระบวนการทำงานแบบองค์รวม
โดยสรุป กระบวนการทำงานของ Kafka เป็นไปดังนี้:
- Producer ส่งข้อมูล: ระบบต้นทาง (Producer) สร้างข้อมูลหรือเหตุการณ์ (events) และส่งไปยัง Topic ที่ต้องการใน Kafka Cluster
- Kafka จัดเก็บข้อมูล: ข้อมูลที่ได้รับจะถูกจัดเก็บใน Partition ที่เกี่ยวข้องบน Broker ต่างๆ โดยมีการเรียงลำดับและมีการสำเนาเพื่อความคงทน
- Consumer อ่านข้อมูล: ระบบปลายทาง (Consumer) สมัครรับข้อมูลจาก Topic ที่สนใจ และอ่านข้อมูลตามลำดับ Offset ของตัวเอง
- การประมวลผล: Consumer Group ช่วยให้สามารถประมวลผลข้อมูลแบบขนานได้ ทำให้ Kafka สามารถรองรับปริมาณข้อมูลที่สูงมากและประมวลผลได้อย่างรวดเร็ว
การทำงานร่วมกันขององค์ประกอบเหล่านี้ทำให้ Kafka เป็นแพลตฟอร์มที่ทรงพลังสำหรับการจัดการข้อมูลสตรีมมิ่งในปริมาณมากด้วยความน่าเชื่อถือและความยืดหยุ่นสูง
วิดีโอ: "What is Kafka and How does it work?" โดย Confluent Developer อธิบายถึง Broker, Connection, Topics, Producer, Consumer และ Partitions
ประโยชน์และกรณีการใช้งานของ Apache Kafka
Apache Kafka ถูกนำไปใช้งานอย่างแพร่หลายในหลากหลายอุตสาหกรรมและกรณีการใช้งาน ด้วยคุณสมบัติเด่นที่ตอบโจทย์ความต้องการของระบบที่ต้องจัดการข้อมูลแบบเรียลไทม์
ประโยชน์หลักของ Kafka
- ประสิทธิภาพสูง (High Throughput): Kafka สามารถรองรับการรับส่งข้อความได้มากกว่าหนึ่งล้านข้อความต่อวินาที หรือหลายล้านล้านข้อความต่อวัน ซึ่งเหมาะสำหรับระบบที่มีปริมาณข้อมูลมหาศาล
- ความสามารถในการขยายขนาด (Scalability): คลัสเตอร์ Kafka สามารถขยายขนาดได้ถึงหลายร้อย Broker และสามารถจัดการกับข้อมูลได้ระดับ Petabytes ทำให้สามารถรองรับการเติบโตของข้อมูลได้อย่างยืดหยุ่น
- ความคงทนและทนทานต่อความเสียหาย (Durability & Fault-Tolerance): Kafka จัดเก็บสตรีมข้อมูลไว้อย่างปลอดภัยในคลัสเตอร์แบบกระจายตัว ซึ่งมีการสำเนาข้อมูล ทำให้ข้อมูลยังคงเข้าถึงได้แม้ในกรณีที่เซิร์ฟเวอร์ล้มเหลว
- ความพร้อมใช้งานสูง (High Availability): ด้วยสถาปัตยกรรมแบบกระจายตัวและกลไกการสำเนา ทำให้ Kafka มีความพร้อมใช้งานสูง ไม่ล่มง่าย และสามารถทำ Disaster Recovery ได้
- การแยกการสื่อสาร (Decoupling): Kafka ทำหน้าที่เป็นตัวกลางในการเชื่อมต่อ ช่วยแยกการสื่อสารระหว่างระบบต้นทาง (Producer) และระบบปลายทาง (Consumer) ทำให้ระบบต่างๆ สามารถพัฒนาและทำงานได้อย่างอิสระ
- การประมวลผลแบบเรียลไทม์ (Real-time Processing): สามารถนำข้อมูลมาประมวลผลได้ทันทีที่ข้อมูลถูกสร้างขึ้น เหมาะสำหรับแอปพลิเคชันที่ต้องการการตอบสนองที่รวดเร็ว
กรณีการใช้งานทั่วไป
ด้วยคุณสมบัติที่กล่าวมา Kafka จึงถูกนำไปใช้ในกรณีต่างๆ ดังนี้:
- Real-time Data Pipelines: สร้างไปป์ไลน์ข้อมูลที่เชื่อถือได้และเคลื่อนย้ายข้อมูลจากระบบหนึ่งไปยังอีกระบบหนึ่งแบบเรียลไทม์ เช่น การติดตามกิจกรรมผู้ใช้บนเว็บไซต์ (Clickstream Data), การเก็บข้อมูลบันทึก (Logging), หรือข้อมูลจากอุปกรณ์ IoT
- Streaming Applications: พัฒนาแอปพลิเคชันที่บริโภคและประมวลผลสตรีมข้อมูลเพื่อการวิเคราะห์แบบเรียลไทม์ การแจ้งเตือน หรือการปรับปรุงระบบต่างๆ
- Data Integration: ใช้เป็นศูนย์กลางในการรวมข้อมูลจากแหล่งต่างๆ เข้าด้วยกัน เพื่อให้ระบบปลายทางสามารถนำไปใช้ได้อย่างสะดวก
- Message Brokering: ทำหน้าที่เป็น Message Queue สำหรับระบบที่ต้องการการรับส่งข้อความในปริมาณมากและต้องการความน่าเชื่อถือ
- Microservices Communication: เป็นโครงสร้างพื้นฐานสำหรับการสื่อสารระหว่าง Microservices ในสถาปัตยกรรมแบบ Event-Driven Architecture
การเปรียบเทียบความสามารถของ Apache Kafka
เพื่อทำความเข้าใจถึงความสามารถของ Apache Kafka ในบริบทที่กว้างขึ้น ลองมาดูการเปรียบเทียบกับเทคโนโลยีอื่น ๆ ที่เกี่ยวข้อง
Kafka vs. RabbitMQ: เมื่อใดควรเลือกใช้?
ทั้ง Kafka และ RabbitMQ ต่างก็เป็นระบบ Message Queue ที่ได้รับความไว้วางใจในเรื่องความน่าเชื่อถือและ scalability แต่มีความแตกต่างกันในด้านแนวคิดและการทำงาน:
| คุณสมบัติ | Apache Kafka | RabbitMQ |
|---|---|---|
| ประเภทหลัก | Distributed Event Streaming Platform | General-purpose Message Broker |
| การจัดเก็บข้อมูล | เน้นการจัดเก็บข้อมูลแบบคงทนในรูปแบบ Log สามารถเก็บข้อมูลได้นานและให้ Consumer อ่านซ้ำได้ | เน้นการจัดเก็บข้อความชั่วคราว เมื่อ Consumer อ่านแล้ว ข้อความมักจะถูกลบออก (หรือกำหนด TTL) |
| รูปแบบการอ่าน | Consumer ดึงข้อมูลจาก Topic และจัดการ Offset เอง ทำให้สามารถอ่านซ้ำได้และหลาย Consumer Group อ่านได้พร้อมกัน | Broker เป็นผู้ผลักข้อความไปยัง Consumer (Push-based) มักจะเน้นการประมวลผลแบบ Once-Only |
| ประสิทธิภาพ | ออกแบบมาเพื่อ Throughput สูงมาก เหมาะสำหรับข้อมูลสตรีมมิ่งขนาดใหญ่ | ประสิทธิภาพดีสำหรับการรับส่งข้อความทั่วไป แต่ Throughput อาจไม่สูงเท่า Kafka สำหรับข้อมูลสตรีมมิ่งมหาศาล |
| ความซับซ้อน | มีความซับซ้อนในการตั้งค่าและจัดการมากกว่า โดยเฉพาะสำหรับผู้เริ่มต้น | ใช้งานง่ายกว่าและเหมาะสำหรับ Use Case ที่ไม่ซับซ้อนมาก |
| Use Case | Real-time Data Pipelines, Event Sourcing, Log Aggregation, Stream Processing, Big Data Analytics | Task Queues, Microservices Communication (แบบ Request/Reply), Distributed Systems Integration |
โดยทั่วไปแล้ว หากต้องการจัดการกับข้อมูลสตรีมมิ่งขนาดใหญ่, มีความต้องการ Throughput สูง, ต้องการเก็บข้อมูลไว้อ่านซ้ำได้, และเน้นการประมวลผลแบบ Event-Driven ที่ซับซ้อน Apache Kafka จะเป็นตัวเลือกที่ดีกว่า ในขณะที่ RabbitMQ เหมาะสำหรับ Use Case ที่ต้องการ Message Queue ทั่วไป, เน้นการส่งข้อความแบบรับประกันการส่ง, และมีการสื่อสารแบบ Point-to-Point หรือ Request/Reply
Kafka vs. Spark: การประมวลผลข้อมูล
Kafka และ Apache Spark เป็นเครื่องมือที่แตกต่างกันแต่สามารถทำงานร่วมกันได้อย่างมีประสิทธิภาพ:
- Apache Kafka: คือ Stream Processing Engine ที่เน้นการนำเข้าและจัดเก็บข้อมูลสตรีมมิ่งแบบเรียลไทม์ เป็นแหล่งข้อมูลที่สตรีมเข้ามาอย่างต่อเนื่อง
- Apache Spark: คือ Distributed Data Processing Engine ที่สามารถประมวลผลข้อมูลได้ทั้งแบบ Batch และ Stream (ผ่าน Spark Streaming)
โดยพื้นฐานแล้ว Kafka เป็นระบบที่รับและจัดเก็บข้อมูลสตรีมมิ่ง ส่วน Spark เป็นระบบที่ประมวลผลข้อมูลนั้นๆ ทั้งสองเทคโนโลยีมักถูกใช้ร่วมกันในสถาปัตยกรรม Big Data โดย Kafka ทำหน้าที่เป็นตัวกลางในการรับและส่งข้อมูลดิบ ส่วน Spark ทำหน้าที่วิเคราะห์และประมวลผลข้อมูลที่ไหลผ่าน Kafka
การเรียนรู้ Apache Kafka สำหรับผู้เริ่มต้น
สำหรับผู้ที่สนใจเริ่มต้นเรียนรู้ Apache Kafka มีแนวทางและข้อควรรู้เบื้องต้นดังนี้:
ขั้นตอนการเรียนรู้
- ทำความเข้าใจพื้นฐาน (Understand the Basics): เริ่มต้นจากแนวคิดหลักของ Kafka เช่น Producer, Consumer, Topic, Partition, Broker และ Consumer Group ทำความเข้าใจว่าแต่ละส่วนทำงานอย่างไร และเชื่อมโยงกันอย่างไร
- ตั้งค่า Kafka (Set-up Kafka): ทดลองติดตั้ง Kafka บนเครื่องของคุณเอง อาจใช้ Docker เพื่อความสะดวกในการตั้งค่าและทดลองใช้งานในสภาพแวดล้อมที่ไม่ซับซ้อน
- ทำงานกับ Producer และ Consumer: เขียนโค้ดง่ายๆ เพื่อให้ Producer ส่งข้อความไปยัง Topic และ Consumer อ่านข้อความจาก Topic นั้นๆ ลองใช้ภาษาที่คุณถนัด เช่น Java, Python, Go หรือ Node.js
- เจาะลึกแนวคิดขั้นสูง: เมื่อเข้าใจพื้นฐานแล้ว ให้ศึกษาแนวคิดที่ลึกซึ้งขึ้น เช่น Offset Management, Consumer Group Rebalancing, Replication Factor, Acks, Idempotence และ Transactions
- สำรวจ Ecosystem: ทำความรู้จักกับส่วนอื่นๆ ในระบบนิเวศของ Kafka เช่น Kafka Connect สำหรับการเชื่อมต่อข้อมูล, Kafka Streams สำหรับการประมวลผลสตรีม และ Schema Registry สำหรับการจัดการ Schema ของข้อมูล
- ลงมือปฏิบัติ (Hands-on Practice): สิ่งสำคัญที่สุดคือการฝึกฝนด้วยการสร้าง Project จริง การแก้ปัญหาต่างๆ จะช่วยให้คุณเข้าใจ Kafka ได้อย่างลึกซึ้งยิ่งขึ้น
ทักษะพื้นฐานที่ควรมี
แม้ว่า Kafka จะเป็นเทคโนโลยีที่ซับซ้อน แต่การมีพื้นฐานบางอย่างจะช่วยให้การเรียนรู้เป็นไปอย่างราบรื่น:
- ความรู้พื้นฐานด้านการเขียนโปรแกรม: เข้าใจแนวคิดการเขียนโปรแกรมและสามารถเขียนโค้ดได้ในภาษาใดภาษาหนึ่ง
- แนวคิดด้านเครือข่าย: ความเข้าใจเกี่ยวกับ IP Address, Port และ Protocol เป็นสิ่งสำคัญสำหรับการตั้งค่าและแก้ไขปัญหาคลัสเตอร์ Kafka
- ความเข้าใจใน Distributed Systems: การตระหนักว่า Kafka ทำงานแบบกระจายตัวและมีประเด็นที่เกี่ยวข้องกับ Concurrency, Consistency และ Fault Tolerance จะช่วยให้เข้าใจสถาปัตยกรรมได้ดีขึ้น
- Command Line Interface (CLI): การใช้คำสั่ง Linux/Unix เบื้องต้นจะช่วยในการจัดการ Kafka Broker และเครื่องมือ CLI ต่างๆ
การเรียนรู้ Kafka เป็นกระบวนการที่ต้องใช้เวลาและการฝึกฝน แต่ด้วยทรัพยากรที่มีอยู่มากมายในปัจจุบัน รวมถึงคอร์สออนไลน์และเอกสารประกอบต่างๆ คุณจะสามารถก้าวสู่การเป็นผู้เชี่ยวชาญ Kafka ได้อย่างแน่นอน
ภาพรวมประสิทธิภาพของ Apache Kafka
เมื่อพิจารณาประสิทธิภาพของ Apache Kafka จะเห็นได้ว่ามันถูกออกแบบมาเพื่อรองรับงานหนักและมีความต้องการที่สูง ลองดูภาพรวมความสามารถด้านต่างๆ ผ่าน Radar Chart นี้
แผนภาพ Radar Chart นี้แสดงให้เห็นถึงจุดเด่นของ Apache Kafka เมื่อเทียบกับ Message Queue ทั่วไป
- Throughput (ปริมาณข้อมูล): Kafka มีความโดดเด่นอย่างมากในการจัดการกับปริมาณข้อมูลที่สูงลิ่ว เหมาะสำหรับระบบที่สร้างข้อมูลจำนวนมหาศาลอย่างต่อเนื่อง
- Scalability (การขยายขนาด): ด้วยสถาปัตยกรรมแบบกระจายตัว Kafka สามารถขยายขนาดได้ง่ายเพื่อรองรับการเติบโตของข้อมูลและผู้ใช้
- Fault Tolerance (ทนทานต่อความเสียหาย): การสำเนาข้อมูลและการออกแบบคลัสเตอร์ช่วยให้ Kafka มีความทนทานสูง แม้บางส่วนจะล้มเหลวก็ยังคงทำงานได้
- Latency (ความหน่วง): แม้ว่า Kafka จะให้ความสำคัญกับ Throughput แต่ก็ยังคงมีความหน่วงต่ำในระดับที่ยอมรับได้สำหรับการประมวลผลแบบเรียลไทม์
- Data Durability (ความคงทนของข้อมูล): Kafka จัดเก็บข้อมูลไว้อย่างปลอดภัยและสามารถเข้าถึงได้นานตามที่กำหนด ทำให้เหมาะสำหรับ Event Sourcing และการวิเคราะห์ย้อนหลัง
- Ease of Use (ความง่ายในการใช้งาน): ในด้านนี้ Kafka อาจมีความซับซ้อนมากกว่า Message Queue ทั่วไป โดยเฉพาะในขั้นตอนการตั้งค่าและบริหารจัดการคลัสเตอร์ แต่ก็แลกมาด้วยประสิทธิภาพและความสามารถที่สูงกว่า
แผนภาพนี้สะท้อนให้เห็นว่า Kafka เป็นตัวเลือกที่ยอดเยี่ยมสำหรับระบบที่ต้องการความสามารถในการประมวลผลข้อมูลสตรีมมิ่งขนาดใหญ่และมีความยืดหยุ่นสูง แม้จะต้องแลกมาด้วยความซับซ้อนในการจัดการที่เพิ่มขึ้นเล็กน้อย
คำถามที่พบบ่อย (FAQ)
Kafka แตกต่างจากฐานข้อมูลทั่วไปอย่างไร?
Zookeeper ยังจำเป็นสำหรับ Kafka ในปัจจุบันหรือไม่?
Kafka เหมาะกับทุก Use Case หรือไม่?
สามารถใช้ Kafka ในภาษาโปรแกรมใดได้บ้าง?
บทสรุป
Apache Kafka เป็นแพลตฟอร์มการสตรีมเหตุการณ์แบบกระจายตัวที่ทรงพลังและยืดหยุ่น ซึ่งได้ปฏิวัติวิธีการจัดการข้อมูลแบบเรียลไทม์ในองค์กรยุคใหม่ ด้วยความสามารถในการรับส่ง จัดเก็บ และประมวลผลข้อมูลสตรีมมิ่งด้วยประสิทธิภาพสูง, ความสามารถในการขยายขนาด, และความทนทานต่อความเสียหาย ทำให้ Kafka เป็นหัวใจสำคัญของสถาปัตยกรรมข้อมูลที่ขับเคลื่อนด้วยเหตุการณ์ (Event-Driven Architecture) และเป็นเครื่องมือที่ขาดไม่ได้สำหรับการสร้างแอปพลิเคชันที่ต้องการการตอบสนองที่รวดเร็วในโลกที่ขับเคลื่อนด้วยข้อมูลในปัจจุบัน การทำความเข้าใจองค์ประกอบและหลักการทำงานของ Kafka จะช่วยให้คุณสามารถใช้ประโยชน์จากเทคโนโลยีนี้ได้อย่างเต็มศักยภาพ และสร้างระบบที่สามารถรองรับความต้องการที่เพิ่มขึ้นของข้อมูลในอนาคตได้อย่างมีประสิทธิภาพ
คำแนะนำเพิ่มเติม
- Kafka Connect คืออะไร และมีประโยชน์อย่างไร?
- Kafka Streams API ใช้ทำอะไร และแตกต่างจาก Spark Streaming อย่างไร?
- แนวคิด Event-Driven Architecture และบทบาทของ Kafka ในสถาปัตยกรรมนี้คืออะไร?
- วิธีการติดตั้งและทดลองใช้งาน Apache Kafka เบื้องต้นด้วย Docker?
อ้างอิงจากผลการค้นหา
 aws.amazon.com