
Décoder Apache Kafka : Le Moteur Temps Réel de Vos Applications Multi-Devices
Maîtrisez Kafka, de l'installation à la pratique, pour propulser vos projets web et mobiles.
Salut ! En tant qu'étudiant en première année d'ingénierie informatique, tu es au bon endroit pour plonger dans le monde fascinant d'Apache Kafka. Oublie le jargon complexe, je vais te guider pas à pas pour que tu comprennes ce qu'est Kafka, pourquoi c'est un outil incontournable (surtout pour les infrastructures multi-devices), comment l'installer, et comment l'utiliser concrètement avec un exemple de code. L'objectif ? Que tu sois prêt à l'expérimenter dès la fin de cette lecture !
Les Points Clés à Retenir sur Kafka
- Plateforme de Streaming d'Événements Distribuée : Kafka n'est pas juste une file d'attente ; c'est un système robuste conçu pour collecter, stocker et traiter des flux massifs de données (événements) en temps réel, de manière fiable et scalable.
- Indispensable pour le Temps Réel et le Multi-Device : Il excelle dans les scénarios nécessitant une communication instantanée entre différentes applications ou appareils (web, mobile, serveurs), comme le suivi d'activité, la collecte de logs ou la synchronisation de données.
- Architecture Puissante mais Compréhensible : Ses composants clés (Producteurs, Consommateurs, Brokers, Topics, Partitions, ZooKeeper) forment un écosystème cohérent pour gérer les flux de données de manière performante et résiliente.
Qu'est-ce qu'Apache Kafka Exactement ?
Imaginez un Système Nerveux Central pour vos Données
Pense à Apache Kafka (oui, c'est "Apache Kafka", pas "Pache" 😉) comme à un système de messagerie ultra-performant et distribué. C'est une plateforme open-source de streaming d'événements. Qu'est-ce que ça veut dire ?
- Streaming d'Événements : Il gère des flux continus de données, appelés "événements". Un événement peut être n'importe quoi : un clic sur un site web, une transaction financière, une lecture de capteur IoT, un log système, etc. Kafka permet de capter ces événements dès qu'ils se produisent.
- Distribuée : Kafka est conçu pour fonctionner sur un ensemble de machines (un "cluster"). Cela le rend très résistant aux pannes (si une machine tombe, les autres prennent le relais) et lui permet de gérer d'énormes volumes de données en répartissant la charge.
- Open-Source : Développé initialement par LinkedIn et maintenant géré par la Fondation Apache, son code est accessible et modifiable par tous, et son utilisation est gratuite.
En gros, Kafka agit comme un intermédiaire centralisé et fiable où différentes applications (les "Producteurs") peuvent envoyer des flux de données, et d'autres applications (les "Consommateurs") peuvent venir lire ces flux, le tout en temps réel ou différé, et à grande échelle.
Les Composants Fondamentaux de Kafka
Pour bien comprendre comment Kafka fonctionne, visualisons-le comme un immense bureau de poste numérique ultra-efficace :
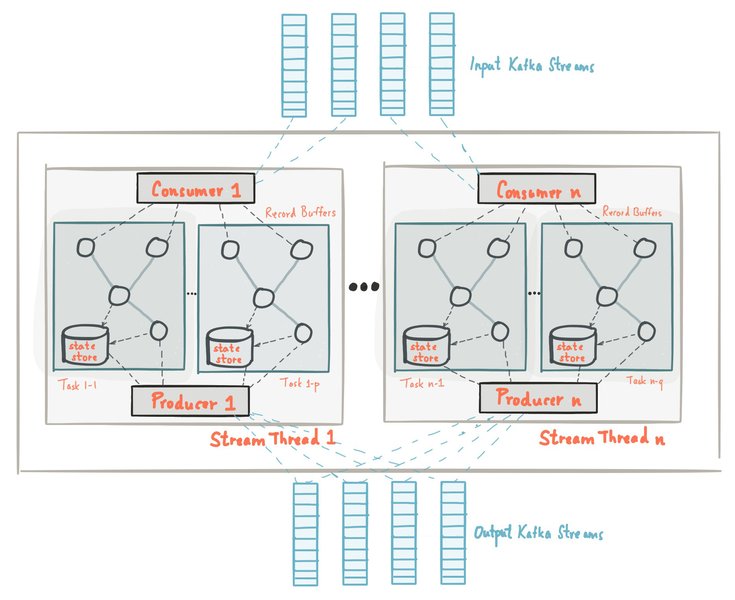
Architecture générale illustrant les flux de données dans Kafka.
- Brokers : Ce sont les serveurs Kafka eux-mêmes. Un cluster Kafka est composé d'un ou plusieurs brokers. Ils reçoivent les messages des producteurs, les stockent et les servent aux consommateurs. Ils gèrent la réplication des données pour assurer la tolérance aux pannes.
- Topics : Ce sont les catégories ou "flux" auxquels les messages sont publiés. Imagine une boîte aux lettres spécifique pour chaque type d'information (ex: "clics_utilisateurs", "commandes_site_web", "logs_serveur").
- Partitions : Chaque topic est divisé en une ou plusieurs partitions. C'est comme diviser une grosse boîte aux lettres en plusieurs compartiments. Les messages d'un topic sont répartis entre ses partitions. Cela permet de paralléliser le traitement (plusieurs consommateurs peuvent lire différentes partitions en même temps) et d'augmenter le débit. L'ordre des messages n'est garanti qu'au sein d'une même partition.
- Producteurs (Producers) : Ce sont les applications qui envoient (publient) des messages (événements) vers les topics Kafka. Par exemple, un serveur web qui envoie un événement à chaque nouvelle commande.
- Consommateurs (Consumers) : Ce sont les applications qui lisent (s'abonnent) les messages depuis les topics Kafka. Par exemple, un système d'analyse qui lit les commandes pour mettre à jour un tableau de bord en temps réel. Les consommateurs s'organisent en "groupes de consommateurs" pour se répartir les partitions d'un topic et éviter que le même message soit traité plusieurs fois par le même groupe.
- ZooKeeper : C'est un service externe essentiel (bien que les versions récentes de Kafka visent à s'en passer via KRaft) qui aide à gérer et coordonner le cluster Kafka. Il stocke les métadonnées sur les brokers, les topics, les partitions, et gère l'élection des "leaders" de partitions. Pense à lui comme au chef d'orchestre qui s'assure que tous les musiciens (brokers) jouent en harmonie.
Pourquoi Utiliser Kafka ? Son Utilité Concrète
Le Carburant de vos Applications Temps Réel et Multi-Devices
Maintenant que tu sais ce qu'est Kafka, voyons pourquoi c'est si utile, surtout dans le contexte du développement web et des architectures multi-devices qui sont au cœur de tes études.
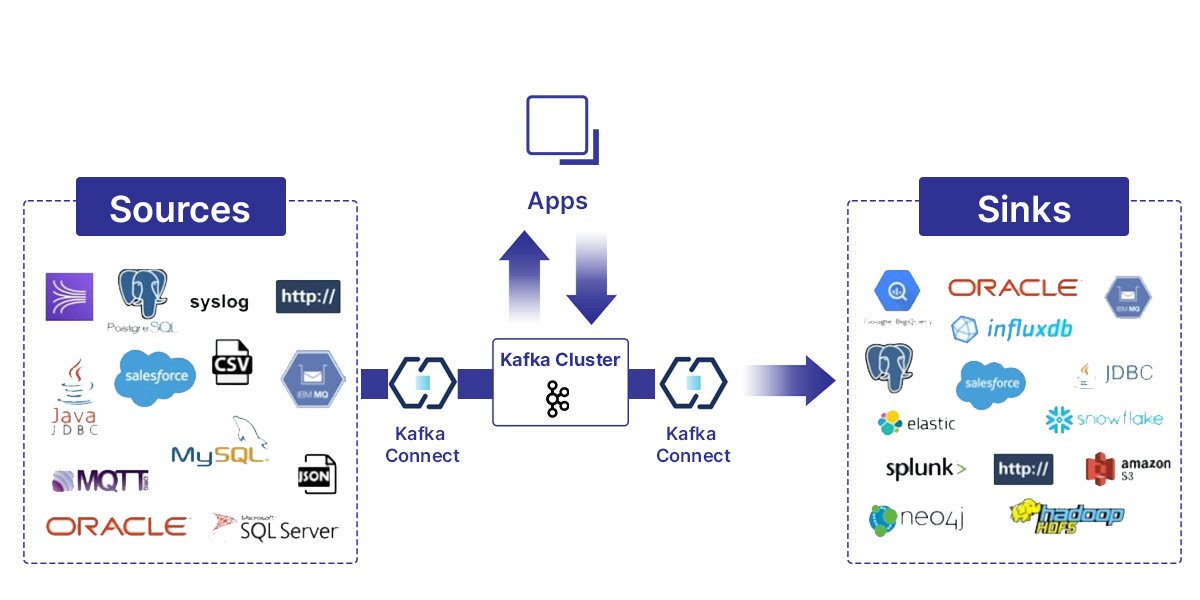
Kafka permet le traitement et l'analyse de données en temps réel pour des décisions rapides.
- Gestion de Données en Temps Réel : C'est LE point fort de Kafka. Si tu construis une application qui doit réagir instantanément à des événements (notifications push, mise à jour de dashboards, détection de fraude, suivi de géolocalisation), Kafka est idéal. Il assure une faible latence (quelques millisecondes) pour la transmission des messages.
- Haute Scalabilité : Ton application devient populaire ? Pas de problème. Kafka est conçu pour monter en charge horizontalement. Tu peux ajouter plus de brokers au cluster pour gérer des millions de messages par seconde sans sacrifier les performances.
- Fiabilité et Tolérance aux Pannes (Haute Disponibilité) : Kafka stocke les messages de manière persistante sur disque et réplique les données sur plusieurs brokers. Si un serveur tombe en panne, les données ne sont pas perdues et le système continue de fonctionner. C'est crucial pour les applications critiques.
- découplage des Systèmes : Les producteurs et les consommateurs sont indépendants. Un producteur envoie des données sans savoir qui va les consommer, et vice-versa. Cela simplifie l'architecture : tu peux ajouter, modifier ou supprimer des producteurs ou des consommateurs sans impacter le reste du système.
- Intégration Facilitée (Multi-Device) : Dans un écosystème multi-devices (app mobile, site web, objets connectés, backend), Kafka sert de "hub" central pour faire communiquer tous ces éléments de manière asynchrone et fiable. Une action sur mobile peut déclencher un traitement sur le backend et une notification sur le web, le tout orchestré via Kafka.
- Cas d'Usage Courants :
- Agrégation de logs et de métriques de multiples serveurs/applications.
- Suivi d'activité utilisateur en temps réel (clics, vues, parcours).
- Pipelines de traitement de données (ETL en temps réel).
- Systèmes de messagerie (notifications, chat...).
- Synchronisation de bases de données ou de caches.
- Source d'événements pour des architectures microservices (Event Sourcing).
Visualisation des Forces de Kafka
Ce graphique radar illustre les points forts typiques d'Apache Kafka par rapport à d'autres systèmes de messagerie ou objectifs de conception. Les scores sont indicatifs et visent à montrer où Kafka excelle particulièrement.
Comme tu peux le voir, Kafka brille par sa capacité à gérer de gros volumes (Débit, Scalabilité), sa robustesse (Durabilité, Tolérance aux Pannes) et sa rapidité (Latence), tout en offrant une bonne flexibilité.
Installation d'Apache Kafka : Le Guide Pratique
Prérequis et Étapes pour Démarrer
Prêt à mettre les mains dans le cambouis ? Installer Kafka pour tester localement est assez simple. Voici ce dont tu as besoin et les étapes à suivre.
Prérequis Indispensables
- Java Development Kit (JDK) : Kafka est écrit en Java et Scala. Tu auras besoin d'une version récente du JDK installée (version 11 ou supérieure est recommandée). Pour vérifier si Java est installé et quelle version, ouvre un terminal (ou Invite de commandes sur Windows) et tape : `java -version`. Si ce n'est pas installé, télécharge-le depuis Adoptium (OpenJDK) ou Oracle.
- ZooKeeper : Kafka l'utilise pour sa coordination. Les distributions Kafka récentes incluent un script pour lancer ZooKeeper facilement, ou peuvent utiliser le mode KRaft (sans ZooKeeper externe), mais pour un premier test, démarrer ZooKeeper fourni est le plus simple.
- Système d'Exploitation : Kafka fonctionne bien sur Linux, macOS et Windows (via WSL2 - Windows Subsystem for Linux - est souvent recommandé pour une meilleure expérience sous Windows).
- Ressources Système : Prévois quelques Go de RAM (4 Go minimum) et de l'espace disque pour les logs et les données Kafka.
Étapes d'Installation (Exemple sur Linux/Ubuntu)
Les commandes peuvent légèrement varier sur d'autres systèmes, mais le principe reste le même.
-
Télécharger Kafka :
Rends-toi sur la page de téléchargement officielle d'Apache Kafka : https://kafka.apache.org/downloads. Choisis une version binaire récente (par exemple, la 3.x.x). Télécharge l'archive `.tgz`.
# Exemple de commande pour télécharger (adapte la version) wget https://downloads.apache.org/kafka/3.7.0/kafka_2.13-3.7.0.tgz -
Extraire l'Archive :
Place-toi dans le répertoire où tu veux installer Kafka et décompresse l'archive.
tar -xzf kafka_2.13-3.7.0.tgz cd kafka_2.13-3.7.0 -
Démarrer ZooKeeper :
Kafka inclut un serveur ZooKeeper prêt à l'emploi. Ouvre un premier terminal et lance-le avec le script fourni et le fichier de configuration par défaut.
Laisse ce terminal ouvert, ZooKeeper doit rester actif.# Depuis le répertoire racine de Kafka (ex: kafka_2.13-3.7.0) bin/zookeeper-server-start.sh config/zookeeper.properties -
Démarrer le Broker Kafka :
Ouvre un deuxième terminal et lance le serveur (broker) Kafka avec son script et son fichier de configuration par défaut.
Laisse également ce terminal ouvert. Ton broker Kafka est maintenant en cours d'exécution !# Depuis le répertoire racine de Kafka bin/kafka-server-start.sh config/server.properties -
(Optionnel) Créer un Topic pour Tester :
Ouvre un troisième terminal pour interagir avec Kafka. Créons un topic nommé `test-topic` avec une seule partition et un seul facteur de réplication (suffisant pour un test local).
Si la commande réussit, ton environnement Kafka local est prêt !# Depuis le répertoire racine de Kafka bin/kafka-topics.sh --create --topic test-topic --bootstrap-server localhost:9092 --partitions 1 --replication-factor 1
Note pour Windows : L'installation directe peut être délicate. Il est fortement conseillé d'utiliser WSL2 (Windows Subsystem for Linux). Installe une distribution Linux (comme Ubuntu) depuis le Microsoft Store, puis suis les étapes Linux ci-dessus dans le terminal WSL2.
L'Écosystème Kafka en un Coup d'Œil
Une Cartographie des Composants Clés
Pour mieux visualiser comment les différents éléments de Kafka et de son écosystème s'articulent, voici une carte mentale simplifiée :
(Coordination)"] id2["Kafka Connect"] id2_1["Source Connectors
(Import Data)"] id2_1_1["Database"] id2_1_2["Files"] id2_1_3["MQTT"] id2_2["Sink Connectors
(Export Data)"] id2_2_1["HDFS"] id2_2_2["Elasticsearch"] id2_2_3["S3"] id3["Kafka Streams"] id3_1["Stream Processing Library"] id3_2["Real-time Analytics"] id3_3["Stateful / Stateless Ops"] id4["Client Libraries"] id4_1["Java"] id4_2["Python"] id4_3["Go"] id4_4["Node.js"] id4_5["...and more"] id5["Schema Registry
(Confluent Platform)"] id5_1["Schema Management"] id5_2["Data Evolution"] id6["ksqlDB
(Confluent Platform)"] id6_1["SQL for Kafka"] id6_2["Event Streaming Database"]
Cette carte montre le cœur de Kafka (Brokers, Topics, APIs), ainsi que des composants importants de l'écosystème comme Kafka Connect (pour intégrer Kafka avec d'autres systèmes sans coder), Kafka Streams (pour le traitement de flux directement dans Kafka), les bibliothèques clientes pour différents langages, et des outils additionnels souvent utilisés comme le Schema Registry ou ksqlDB (populaires dans la distribution Confluent).
Cas d'Usage : Suivi des Clics sur un Site Web en Temps Réel
Mise en Pratique Immédiate avec du Code Python
Passons à la pratique ! Imaginons que tu veuilles suivre chaque clic effectué par les utilisateurs sur ton site web et envoyer cette information à Kafka pour une analyse ultérieure (par exemple, calculer les pages les plus populaires en temps réel).
Nous allons utiliser Python, qui est souvent apprécié pour sa simplicité, avec la librairie `confluent-kafka`, un client Kafka populaire.
Étape 1 : Installer la Librairie Kafka pour Python
Ouvre ton terminal et installe la librairie :
pip install confluent-kafkaÉtape 2 : Le Producteur (Producer) - Envoyer les Événements de Clic
Ce script simule l'envoi d'un événement de clic vers le topic `clics-utilisateurs` que nous allons créer (ou utilise `test-topic` si tu l'as déjà créé).
# producer.py
import time
from confluent_kafka import Producer
import json # Pour envoyer des données structurées

# Configuration du Producteur
# Assure-toi que ton serveur Kafka tourne sur localhost:9092
conf = {'bootstrap.servers': 'localhost:9092'}

# Crée une instance du Producteur
producer = Producer(conf)

# Nom du topic Kafka
topic_name = 'clics-utilisateurs' # Ou 'test-topic'

# Fonction pour envoyer un message (callback optionnel pour gérer les erreurs/confirmations)
def delivery_report(err, msg):
    """ Callback appelé une fois le message livré ou en cas d'échec. """
    if err is not None:
        print(f"Erreur de livraison du message : {err}")
    else:
        print(f"Message livré à {msg.topic()} [{msg.partition()}] @ offset {msg.offset()}")

# Simuler quelques événements de clic
for i in range(5):
    user_id = f"user_{i % 2 + 1}" # Simule 2 utilisateurs différents
    page_clicked = f"/page/{i + 1}"
    timestamp = time.time()

    # Créer un dictionnaire pour les données de l'événement
    event_data = {
        'user_id': user_id,
        'page': page_clicked,
        'timestamp': timestamp
    }

    # Convertir le dictionnaire en chaîne JSON
    event_value = json.dumps(event_data)

    print(f"Envoi de l'événement : {event_value}")

    # Produire le message de manière asynchrone
    # .encode('utf-8') est important car Kafka attend des bytes
    producer.produce(topic_name, value=event_value.encode('utf-8'), callback=delivery_report)

    # Petite pause entre les envois
    time.sleep(1)

# Attendre que tous les messages soient envoyés
# poll(0) déclenche les callbacks en attente
# flush() bloque jusqu'à ce que les messages soient envoyés ou expirent
producer.flush()

print("Tous les messages ont été envoyés.")
Important : Avant d'exécuter ce script, assure-toi que le topic `clics-utilisateurs` existe. Si ce n'est pas le cas, crée-le avec la commande :
bin/kafka-topics.sh --create --topic clics-utilisateurs --bootstrap-server localhost:9092 --partitions 1 --replication-factor 1Étape 3 : Le Consommateur (Consumer) - Lire et Afficher les Événements de Clic
Ce script va s'abonner au topic `clics-utilisateurs` et afficher chaque événement de clic qu'il reçoit.
# consumer.py
from confluent_kafka import Consumer, KafkaException, KafkaError
import json # Pour décoder les données JSON

# Configuration du Consommateur
conf = {
    'bootstrap.servers': 'localhost:9092',
    'group.id': 'click-analysis-group', # Identifiant unique pour le groupe de consommateurs
    'auto.offset.reset': 'earliest' # Commence à lire depuis le début du topic si pas d'offset sauvegardé
}

# Crée une instance du Consommateur
consumer = Consumer(conf)

# Nom du topic auquel s'abonner
topic_name = 'clics-utilisateurs' # Ou 'test-topic'

try:
    # S'abonner au(x) topic(s)
    consumer.subscribe([topic_name])

    print(f"Consommateur démarré. En attente de messages sur le topic '{topic_name}'...")
    print("Appuyez sur Ctrl+C pour arrêter.")

    while True:
        # Interroger Kafka pour de nouveaux messages (timeout de 1.0 seconde)
        msg = consumer.poll(timeout=1.0)

        if msg is None:
            # Pas de nouveau message, on continue d'attendre
            continue
        if msg.error():
            # Gérer les erreurs
            if msg.error().code() == KafkaError._PARTITION_EOF:
                # Fin de la partition atteinte (non considéré comme une erreur)
                print(f"Fin de la partition atteinte {msg.topic()} [{msg.partition()}]")
            elif msg.error():
                raise KafkaException(msg.error())
        else:
            # Message reçu avec succès !
            try:
                # Décoder la valeur du message (qui est en bytes) en UTF-8, puis en JSON
                event_value_str = msg.value().decode('utf-8')
                event_data = json.loads(event_value_str)
                print(f"Message reçu : Partition={msg.partition()}, Offset={msg.offset()}")
                print(f"  Utilisateur: {event_data.get('user_id')}")
                print(f"  Page Cliquée: {event_data.get('page')}")
                print(f"  Timestamp: {event_data.get('timestamp')}")
                print("-" * 20)
            except json.JSONDecodeError:
                print(f"Erreur : Impossible de décoder le message en JSON: {msg.value().decode('utf-8')}")
            except Exception as e:
                 print(f"Erreur lors du traitement du message : {e}")


except KeyboardInterrupt:
    print("Arrêt du consommateur demandé.")
finally:
    # Fermer le consommateur proprement
    consumer.close()
    print("Consommateur fermé.")
Comment Exécuter ?
- Assure-toi que ZooKeeper et le broker Kafka sont démarrés (voir section Installation).
- Assure-toi que le topic (`clics-utilisateurs` ou `test-topic`) est créé.
- Ouvre un terminal et lance le script consommateur : `python consumer.py`. Il va commencer à écouter.
- Ouvre un autre terminal et lance le script producteur : `python producer.py`.
- Observe le terminal du consommateur : tu devrais voir les messages de clics apparaître au fur et à mesure qu'ils sont envoyés par le producteur.
Cet exemple simple te montre le flux de base : produire des données structurées (JSON) dans un topic et les consommer de l'autre côté. Dans une vraie application, le producteur serait intégré à ton serveur web, et le consommateur pourrait être un service d'analyse, une base de données, etc.
Kafka face à d'Autres Systèmes de Messagerie
Un Tableau Comparatif Simplifié
Pour mieux situer Kafka, voici une comparaison très simplifiée avec d'autres technologies de messagerie courantes comme RabbitMQ (un broker de messages traditionnel) et Redis Pub/Sub (souvent utilisé pour la messagerie simple et rapide).
| Caractéristique | Apache Kafka | RabbitMQ | Redis Pub/Sub |
|---|---|---|---|
| Type Principal | Plateforme de Streaming d'Événements / Log distribué | Broker de Messages (AMQP, MQTT, STOMP) | Serveur en mémoire / Cache / Messagerie Pub/Sub simple |
| Architecture | Cluster de brokers, log distribué basé sur partitions | Broker centralisé ou clusterisé, files d'attente intelligentes | Serveur unique ou cluster, pas de persistance Pub/Sub par défaut |
| Persistance des Messages | Très configurable (temps, taille), durable sur disque par défaut | Configurable (mémoire ou disque), messages supprimés après consommation ack | Non persistant pour Pub/Sub (messages perdus si aucun abonné actif) |
| Débit (Throughput) | Très élevé (Millions msg/sec) | Élevé (Dizaines/Centaines milliers msg/sec) | Très élevé (limité par réseau/CPU) |
| Latence | Faible (ms) | Très faible (µs-ms) | Extrêmement faible (µs) |
| Rejeu des Messages (Replay) | Facile (les consommateurs gèrent leur offset) | Difficile/Impossible par défaut | Impossible |
| Cas d'Usage Idéal | Streaming de données, pipelines ETL temps réel, agrégation de logs, event sourcing, microservices | Routage complexe de messages, communication inter-services, tâches en arrière-plan | Notifications temps réel simples, signalisation, cache |
| Complexité de Gestion | Moyenne à Élevée (gestion du cluster, ZooKeeper/KRaft) | Moyenne | Faible |
En résumé : Choisis Kafka pour le traitement de flux massifs et persistants, la relecture d'événements et la scalabilité horizontale extrême. Préfère RabbitMQ pour des scénarios de messagerie plus traditionnels avec des règles de routage complexes. Utilise Redis Pub/Sub pour des notifications ultra-rapides et éphémères.
Introduction Visuelle à Kafka
Comprendre Kafka en Quelques Minutes
Parfois, une vidéo vaut mille mots. Cette vidéo (en anglais, mais les concepts sont universels et les sous-titres souvent disponibles) offre une excellente introduction visuelle à ce qu'est Apache Kafka et pourquoi il est devenu si populaire dans le monde de la data.
Elle explique de manière concise les principes fondamentaux de Kafka, son architecture basée sur les logs distribués, et ses principaux cas d'utilisation, renforçant ainsi les concepts que nous avons abordés.
Questions Fréquemment Posées (FAQ)
Quelle est la différence entre un Topic et une Partition ? ▶
Un Topic est une catégorie logique pour les messages, comme un flux nommé (ex: "commandes"). Une Partition est une subdivision physique d'un topic. Un topic est composé d'une ou plusieurs partitions. C'est au niveau de la partition que les messages sont stockés dans un ordre séquentiel et immuable (comme un log). La division en partitions permet la parallélisation : plusieurs consommateurs d'un même groupe peuvent lire différentes partitions d'un topic simultanément, augmentant ainsi le débit global de lecture.
ZooKeeper est-il toujours nécessaire pour Kafka ? ▶
Historiquement, oui, ZooKeeper était indispensable pour gérer les métadonnées du cluster Kafka (brokers, topics, leaders, etc.). Cependant, depuis la KIP-500 (Kafka Improvement Proposal), un nouveau mode de consensus appelé KRaft (basé sur le protocole Raft) est en cours de développement et est considéré comme prêt pour la production dans les versions récentes de Kafka (depuis la 3.3 environ). KRaft permet de faire fonctionner Kafka sans dépendance externe à ZooKeeper, simplifiant ainsi le déploiement et la gestion. Pour les nouveaux déploiements, KRaft est la voie recommandée.
Qu'est-ce que Kafka Connect et Kafka Streams ? ▶
Ce sont deux composants importants de l'écosystème Kafka :
- Kafka Connect : C'est un framework pour connecter facilement Kafka à d'autres systèmes (bases de données, systèmes de fichiers, applications SaaS, etc.) sans écrire de code complexe. Il utilise des "Connecteurs" (Source Connectors pour importer des données dans Kafka, Sink Connectors pour exporter des données depuis Kafka) qui sont souvent pré-construits et configurables.
- Kafka Streams : C'est une bibliothèque Java (et Scala) qui permet de construire des applications de traitement de flux (stream processing) directement avec Kafka. Elle permet de lire des données depuis des topics, d'appliquer des transformations (filtrage, agrégation, jointures entre flux), et d'écrire les résultats dans d'autres topics, le tout de manière scalable et tolérante aux pannes, en s'intégrant nativement avec les concepts de Kafka (partitions, groupes de consommateurs).
Puis-je perdre des messages avec Kafka ? ▶
Kafka est conçu pour être très fiable, mais la perte de messages est possible dans certaines configurations ou scénarios extrêmes. Pour minimiser ce risque :
- Côté Producteur : Utilisez les acquittements (`acks=all`) pour vous assurer que le message a été répliqué sur plusieurs brokers avant d'être considéré comme envoyé avec succès. Activez les mécanismes de relance (`retries`).
- Côté Broker : Configurez une réplication suffisante pour vos topics (`replication.factor >= 3` est courant) et assurez-vous que le nombre minimum de répliques synchronisées (`min.insync.replicas >= 2`) est défini pour garantir qu'une écriture n'est confirmée que si elle est présente sur plusieurs machines.
- Côté Consommateur : Validez (commit) les offsets seulement *après* avoir traité le message avec succès. Si le consommateur plante avant de traiter mais après avoir commité, le message sera perdu pour ce consommateur.
Avec une configuration appropriée, Kafka offre de fortes garanties de durabilité.
Références Utiles
Pour approfondir tes connaissances ou revoir certaines étapes :
- Apache Kafka Quickstart - Apache Kafka
- Introduction to Apache Kafka | Confluent Documentation - Confluent
- How To Install Apache Kafka on Ubuntu 20.04 - DigitalOcean
- Apache Kafka for Beginners: A Comprehensive Guide - DataCamp
- Apache Kafka Documentation - Apache Kafka
- How to Install Kafka on Windows 11: A Step by Step Guide - Medium
Pistes d'Exploration Supplémentaires
Envie d'aller plus loin ? Voici quelques sujets connexes à explorer :
 aws.amazon.com
Last updated April 13, 2025