
ไขความลับการลดต้นทุน AWS CloudWatch: แผนปฏิบัติการฉบับสมบูรณ์สำหรับองค์กรของคุณ!
คู่มือเชิงลึกพร้อมขั้นตอน cụ thể เพื่อควบคุมค่าใช้จ่าย Metrics, Logs, และ Alerts อย่างมีประสิทธิภาพสูงสุด
การจัดการต้นทุน AWS CloudWatch เป็นสิ่งสำคัญสำหรับองค์กรที่ใช้งานระบบคลาวด์อย่างเต็มรูปแบบ เนื่องจากค่าใช้จ่ายสามารถเพิ่มขึ้นได้อย่างรวดเร็วหากไม่มีการวางแผนและควบคุมที่ดี แผนปฏิบัติการนี้จะนำเสนอแนวทางโดยละเอียด ครอบคลุมทุกองค์ประกอบหลักของ CloudWatch เพื่อช่วยให้คุณลดค่าใช้จ่ายได้อย่างเป็นรูปธรรมและยั่งยืน โดยข้อมูลอ้างอิงล่าสุดถึงวันที่ 13 พฤษภาคม 2025
✨ ไฮไลท์สำคัญเพื่อการลดต้นทุน CloudWatch ที่คุณไม่ควรพลาด
- มุ่งเน้นจุดสำคัญ: ให้ความสำคัญกับการปรับปรุง Logs (นโยบายการจัดเก็บข้อมูล, ระดับการบันทึก) และ Metrics (การลบส่วนที่ไม่จำเป็น, การเลือกใช้ Custom Metrics อย่างชาญฉลาด) ซึ่งมักเป็นส่วนที่มีค่าใช้จ่ายสูง
- วิเคราะห์และทบทวนอย่างสม่ำเสมอ: การทำความเข้าใจโครงสร้างค่าใช้จ่ายปัจจุบันและการตรวจสอบการตั้งค่าอย่างต่อเนื่องเป็นหัวใจสำคัญของการควบคุมต้นทุนในระยะยาว
- รวมศูนย์เพื่อประสิทธิภาพ: ใช้ประโยชน์จากเครื่องมือเช่น Metric Math และ Composite Alarms เพื่อรวมทรัพยากร ลดความซับซ้อน และลดจำนวนรายการที่ต้องเสียค่าใช้จ่าย
🔍 ขั้นตอนที่ 1: วิเคราะห์และทำความเข้าใจโครงสร้างต้นทุนปัจจุบัน
ก่อนที่จะเริ่มลดต้นทุน การทำความเข้าใจว่าค่าใช้จ่าย CloudWatch ของคุณมาจากส่วนใดบ้างเป็นสิ่งสำคัญที่สุด การวิเคราะห์อย่างละเอียดจะช่วยให้คุณสามารถกำหนดเป้าหมายและจัดลำดับความสำคัญของกิจกรรมการปรับลดต้นทุนได้อย่างมีประสิทธิภาพ
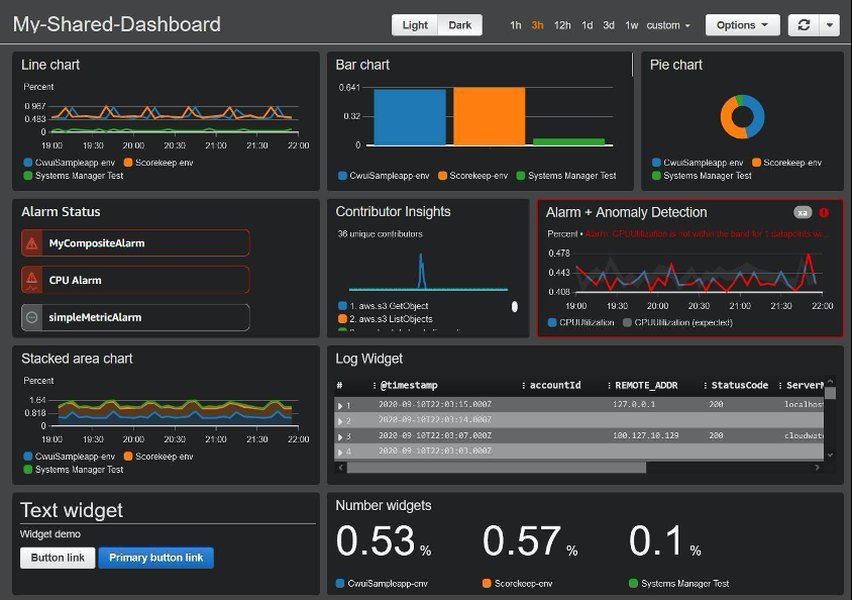
ตัวอย่าง Dashboard ใน CloudWatch ที่ช่วยให้เห็นภาพรวมการใช้งานและค่าใช้จ่าย
-
สิ่งที่ต้องทำและเหตุผล (Why):
ใช้เครื่องมือ AWS Cost Explorer เพื่อตรวจสอบและแบ่งแยกค่าใช้จ่าย CloudWatch ตามบริการ (เช่น Metrics, Logs, Alarms, Dashboards) และตาม Resource ID (หากมีการ Tagging ที่ดี) สำหรับการวิเคราะห์เชิงลึกยิ่งขึ้น ให้ใช้ Cost and Usage Reports (CUR) ร่วมกับ Amazon Athena เพื่อเจาะลึกรายละเอียดต้นทุนระดับ Operation (เช่น PutLogEvents, HourlyStorageMetering) การทราบแหล่งที่มาของค่าใช้จ่ายจะช่วยให้คุณมุ่งเน้นความพยายามไปยังส่วนที่มีผลกระทบมากที่สุด
-
ลำดับความสำคัญ (Priority):
สูง
-
วิธีวัดผลเป็นตัวเลข (Measurement):
ระบุสัดส่วนเปอร์เซ็นต์ของต้นทุน CloudWatch ทั้งหมดที่มาจาก Metrics, Logs, Alarms, และส่วนอื่นๆ เช่น "ค่าใช้จ่ายจาก Logs คิดเป็น 60% ของค่าใช้จ่าย CloudWatch ทั้งหมด"
📊 ขั้นตอนที่ 2: การเพิ่มประสิทธิภาพ Metrics
Metrics เป็นองค์ประกอบพื้นฐานในการติดตามประสิทธิภาพ แต่การจัดเก็บ Metrics จำนวนมากเกินความจำเป็น โดยเฉพาะ Custom Metrics หรือ High-Resolution Metrics สามารถทำให้ค่าใช้จ่ายสูงขึ้นได้อย่างมาก
2.1 ตรวจสอบและลบ Metrics ที่ไม่จำเป็น
-
สิ่งที่ต้องทำและเหตุผล (Why):
ตรวจสอบ Metrics ที่มีอยู่ทั้งหมด ระบุและลบ Metrics ที่ไม่ได้ใช้งาน ซ้ำซ้อน หรือมาจากทรัพยากรที่ถูกยกเลิกไปแล้ว CloudWatch คิดค่าบริการตามจำนวน Metrics ที่จัดเก็บและส่งข้อมูล การลดจำนวน Metrics ที่ไม่จำเป็นจึงช่วยลดค่าใช้จ่ายได้โดยตรง
-
ลำดับความสำคัญ (Priority):
สูง
-
วิธีวัดผลเป็นตัวเลข (Measurement):
ลดจำนวน Metrics ที่จัดเก็บได้ 20-50% ส่งผลให้ค่าใช้จ่ายในส่วนของ Metrics ลดลงตามสัดส่วน (เช่น ลดจาก 1,000 Metrics เหลือ 500 Metrics)
2.2 ปรับความละเอียดของ Metrics (Detailed vs. Basic Monitoring)
-
สิ่งที่ต้องทำและเหตุผล (Why):
สำหรับบริการอย่าง EC2 instances ให้พิจารณาเปลี่ยนจาก Detailed Monitoring (เก็บข้อมูลทุก 1 นาที) เป็น Basic Monitoring (เก็บข้อมูลทุก 5 นาที) หากความละเอียดสูงไม่ได้มีความจำเป็นทางธุรกิจ Detailed Monitoring มีค่าใช้จ่ายสูงกว่า
-
ลำดับความสำคัญ (Priority):
สูง
-
วิธีวัดผลเป็นตัวเลข (Measurement):
จำนวน Instances ที่เปลี่ยนเป็น Basic Monitoring, เปอร์เซ็นต์การลดลงของค่าใช้จ่าย Metrics สำหรับ Instances เหล่านั้น
2.3 ใช้ Custom Metrics อย่างมีกลยุทธ์ และพิจารณา Metrics มาตรฐานของ AWS
-
สิ่งที่ต้องทำและเหตุผล (Why):
สร้าง Custom Metrics เฉพาะเมื่อมีความจำเป็นจริงๆ และไม่สามารถหาได้จาก Metrics มาตรฐานที่ AWS เตรียมไว้ให้ เนื่องจาก Custom Metrics มักมีค่าใช้จ่ายสูงกว่า ตรวจสอบว่า Metrics ที่ต้องการสามารถสร้างจากการคำนวณ Metrics ที่มีอยู่แล้วได้หรือไม่
-
ลำดับความสำคัญ (Priority):
กลาง
-
วิธีวัดผลเป็นตัวเลข (Measurement):
ลดจำนวน Custom Metrics ลง, เปรียบเทียบค่าใช้จ่ายระหว่างการใช้ Custom Metrics กับ Metrics มาตรฐาน หรือ Metric Math
2.4 ใช้ Metric Math เพื่อรวมและลดจำนวน Metrics
-
สิ่งที่ต้องทำและเหตุผล (Why):
ใช้ฟีเจอร์ Metric Math ของ CloudWatch เพื่อคำนวณ Metrics ใหม่จาก Metrics ที่มีอยู่ เช่น การหาค่าเฉลี่ย, ผลรวม หรืออัตราส่วน วิธีนี้ช่วยลดจำนวน Metrics ที่ต้องจัดเก็บและเสียค่าใช้จ่ายโดยตรง
-
ลำดับความสำคัญ (Priority):
กลาง
-
วิธีวัดผลเป็นตัวเลข (Measurement):
ลดจำนวน Metrics โดยรวมที่ต้องจัดเก็บได้ 10-30%, ลดค่าใช้จ่ายที่เกี่ยวข้องกับ Metrics เหล่านั้น
📝 ขั้นตอนที่ 3: การเพิ่มประสิทธิภาพ Logs
Logs มักเป็นส่วนที่มีสัดส่วนค่าใช้จ่ายสูงที่สุดใน CloudWatch โดยเฉพาะสำหรับองค์กรที่มีปริมาณ Log Data จำนวนมาก การจัดการ Log Ingestion, Storage และ Analysis อย่างมีประสิทธิภาพจึงเป็นสิ่งจำเป็น
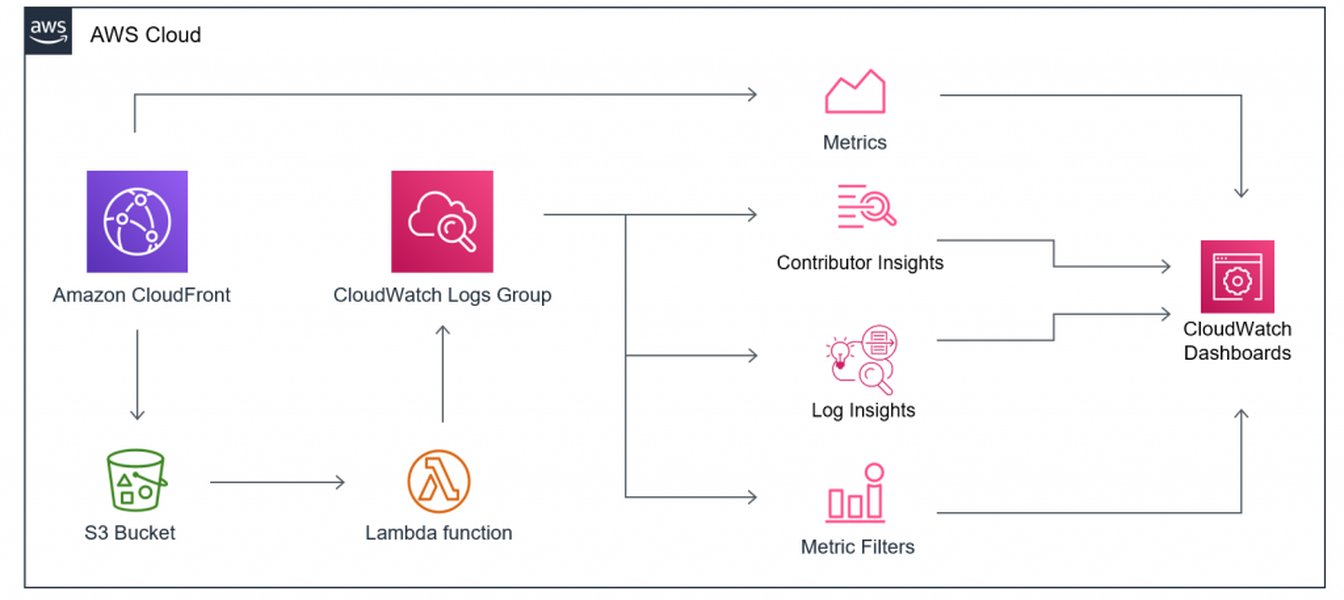
สถาปัตยกรรมการส่ง Log จาก CloudWatch Logs ไปยัง Amazon S3 เพื่อการจัดเก็บระยะยาวในต้นทุนที่ต่ำกว่า
3.1 กำหนดนโยบายการจัดเก็บ Logs (Log Retention Policies)
-
สิ่งที่ต้องทำและเหตุผล (Why):
โดยค่าเริ่มต้น CloudWatch Logs จะเก็บ Log Data ไว้ตลอดไป ซึ่งทำให้ต้นทุนการจัดเก็บ (Storage) เพิ่มขึ้นอย่างต่อเนื่อง กำหนดนโยบาย Log Retention ที่เหมาะสมสำหรับแต่ละ Log Group ตามความต้องการทางธุรกิจและข้อกำหนดด้าน Compliance (เช่น 30 วัน, 90 วัน หรือ 1 ปี) เพื่อลบ Logs ที่เก่าเกินความจำเป็นโดยอัตโนมัติ
-
ลำดับความสำคัญ (Priority):
สูง
-
วิธีวัดผลเป็นตัวเลข (Measurement):
ลดปริมาณ Log Storage ลงได้ 30-90% (ขึ้นอยู่กับระยะเวลา Retention เดิมและใหม่), ลดค่าใช้จ่าย Log Storage ตามสัดส่วน (เช่น ลด Storage จาก 1TB เหลือ 300GB)
3.2 ปรับระดับการบันทึก Logs (Log Levels)
-
สิ่งที่ต้องทำและเหตุผล (Why):
ตั้งค่า Log Level ในแอปพลิเคชันหรือบริการให้เหมาะสมกับแต่ละสภาพแวดล้อม (Environment) เช่น ใช้ INFO หรือ WARN ใน Production และ DEBUG หรือ TRACE เฉพาะใน Development หรือ Staging การบันทึก Logs ที่ละเอียดเกินไปใน Production จะทำให้เกิด Log Data ปริมาณมหาศาล เพิ่มทั้งต้นทุนการนำเข้า (Ingestion) และการจัดเก็บ
-
ลำดับความสำคัญ (Priority):
สูง
-
วิธีวัดผลเป็นตัวเลข (Measurement):
ลดปริมาณ Log Ingestion (GB/เดือน) ลงได้ 30-80%, ลดค่าใช้จ่าย Log Ingestion ตามสัดส่วน
3.3 พิจารณาการส่งออก Logs ไปยังที่จัดเก็บข้อมูลทางเลือก (S3/Glacier)
-
สิ่งที่ต้องทำและเหตุผล (Why):
สำหรับ Logs ที่จำเป็นต้องเก็บไว้นานเพื่อการตรวจสอบ (Audit) หรือ Compliance แต่ไม่จำเป็นต้องเข้าถึงบ่อยครั้ง ให้พิจารณาส่งออก (Export) Logs จาก CloudWatch Logs ไปยัง Amazon S3 (และอาจต่อไปยัง S3 Glacier หรือ S3 Glacier Deep Archive) ซึ่งมีค่าใช้จ่ายในการจัดเก็บระยะยาวที่ถูกกว่า CloudWatch Logs มาก
-
ลำดับความสำคัญ (Priority):
กลาง
-
วิธีวัดผลเป็นตัวเลข (Measurement):
ปริมาณ Log Data (GB) ที่ย้ายไปยัง S3/Glacier, เปอร์เซ็นต์การลดลงของค่าใช้จ่าย Log Storage ใน CloudWatch Logs สำหรับข้อมูลส่วนนั้น
3.4 ใช้ CloudWatch Logs Insights อย่างมีประสิทธิภาพและพิจารณา Filter Index
-
สิ่งที่ต้องทำและเหตุผล (Why):
CloudWatch Logs Insights คิดค่าบริการตามปริมาณข้อมูลที่สแกน (Data Scanned) ต่อ Query การสร้าง Query ที่เฉพาะเจาะจงและจำกัดช่วงเวลาให้แคบที่สุดจะช่วยลดค่าใช้จ่าย นอกจากนี้ การเปิดใช้งาน Filter Index สำหรับ Fields ที่ใช้บ่อยในการ Query สามารถลดปริมาณข้อมูลที่ต้องสแกนและลดต้นทุนการวิเคราะห์ได้
-
ลำดับความสำคัญ (Priority):
กลาง
-
วิธีวัดผลเป็นตัวเลข (Measurement):
ลดปริมาณ Data Scanned ต่อ Query โดยเฉลี่ย (GB), ลดค่าใช้จ่าย CloudWatch Logs Insights ลงได้ (เช่น ลดลง 10-20%)
Mindmap สรุปกลยุทธ์หลักในการลดต้นทุน AWS CloudWatch
🚨 ขั้นตอนที่ 4: การเพิ่มประสิทธิภาพ Alerts (Alarms)
Alarms มีค่าใช้จ่ายตามจำนวนที่สร้างขึ้นและจำนวนการแจ้งเตือน (Notifications) ที่ส่งออกไป การจัดการ Alarms ที่ไม่จำเป็นหรือซ้ำซ้อนจะช่วยลดต้นทุนส่วนนี้และลด "Alarm Fatigue" ให้กับทีมงาน
4.1 ตรวจสอบและลบ Alarms ที่ไม่จำเป็นหรือซ้ำซ้อน
-
สิ่งที่ต้องทำและเหตุผล (Why):
ตรวจสอบ Alarms ทั้งหมดที่มีอยู่ ลบ Alarms ที่ล้าสมัย, ไม่ได้ใช้งาน, ไม่เคย Trigger หรือซ้ำซ้อนกับ Alarms อื่นๆ การลดจำนวน Alarms จะช่วยลดค่าใช้จ่ายโดยตรงและลดภาระการจัดการ
-
ลำดับความสำคัญ (Priority):
สูง
-
วิธีวัดผลเป็นตัวเลข (Measurement):
ลดจำนวน Alarms ลงได้ 30-70%, ลดค่าใช้จ่ายที่เกี่ยวข้องกับ Alarms และ Notifications ตามสัดส่วน
4.2 รวม Alarms ด้วย Composite Alarms
-
สิ่งที่ต้องทำและเหตุผล (Why):
ใช้ Composite Alarms เพื่อรวมสถานะของ Alarms หลายตัวเป็นเงื่อนไขสำหรับ Alarm เดียว วิธีนี้ช่วยลดจำนวน Notifications ที่ส่งไปยังปลายทาง (เช่น SNS Topic) และช่วยให้การแจ้งเตือนมีความหมายมากขึ้น ลดปัญหา Alarm Noise
-
ลำดับความสำคัญ (Priority):
กลาง
-
วิธีวัดผลเป็นตัวเลข (Measurement):
จำนวน Composite Alarms ที่สร้างขึ้น, เปอร์เซ็นต์การลดลงของจำนวน Notifications ที่ส่งออก
4.3 ทบทวนเงื่อนไขและ Thresholds ของ Alarms
-
สิ่งที่ต้องทำและเหตุผล (Why):
ปรับ Thresholds, Evaluation Periods, และ Datapoints to Alarm ให้เหมาะสมกับพฤติกรรมของระบบ เพื่อลด False Positive Alarms การตั้งค่าที่ไม่เหมาะสมอาจทำให้เกิด Notifications จำนวนมากโดยไม่จำเป็น พิจารณาใช้ Anomaly Detection สำหรับ Metrics ที่มีรูปแบบซับซ้อน
-
ลำดับความสำคัญ (Priority):
กลาง
-
วิธีวัดผลเป็นตัวเลข (Measurement):
ลดจำนวน Alarms ที่ Trigger โดยไม่จำเป็น (False Positives) ลง, ลดจำนวน Notifications ที่ส่งออกไป
4.4 ใช้คำแนะนำ Best Practice Alarm จาก AWS
-
สิ่งที่ต้องทำและเหตุผล (Why):
AWS มีการแนะนำ Best Practice สำหรับการตั้งค่า Alarms สำหรับบริการต่างๆ การปฏิบัติตามคำแนะนำเหล่านี้ช่วยให้มั่นใจได้ว่าคุณกำลังติดตาม Metrics ที่สำคัญจริงๆ และตั้งค่า Alarms ได้อย่างมีประสิทธิภาพ ลดความเสี่ยงที่จะพลาดปัญหาสำคัญหรือมีการแจ้งเตือนที่ไม่จำเป็น
-
ลำดับความสำคัญ (Priority):
กลาง
-
วิธีวัดผลเป็นตัวเลข (Measurement):
จำนวนบริการที่นำ Best Practice Alarm Recommendations มาปรับใช้, การปรับปรุงความครอบคลุมของการ Monitoring
🎨 ขั้นตอนที่ 5: การเพิ่มประสิทธิภาพ Dashboards
แม้ว่า Dashboards จะมีค่าใช้จ่ายไม่สูงเท่า Metrics หรือ Logs แต่การจัดการที่ดีก็ช่วยลดต้นทุนส่วนเกินเล็กน้อยได้
-
สิ่งที่ต้องทำและเหตุผล (Why):
ตรวจสอบและลบ Dashboards ที่ไม่ได้ใช้งานแล้ว หากเป็นไปได้ ให้รวมข้อมูลที่จำเป็นไว้ใน Dashboard น้อยลง เพื่อลดจำนวน Dashboard ทั้งหมดที่ต้องดูแลรักษาและเสียค่าบริการ (แม้จะน้อยก็ตาม)
-
ลำดับความสำคัญ (Priority):
ต่ำ
-
วิธีวัดผลเป็นตัวเลข (Measurement):
จำนวน CloudWatch Dashboards ที่ลดลง (เช่น ลดลง 10-20%)
🎯 ภาพรวมการประเมินผลกระทบและความพยายาม
เพื่อให้เห็นภาพรวมของแต่ละกลยุทธ์ในการลดต้นทุน CloudWatch ทั้งในแง่ของศักยภาพการลดค่าใช้จ่ายและความพยายามที่ต้องใช้ในการดำเนินการ Radar chart ด้านล่างนี้จะช่วยสรุปข้อมูลสำคัญเหล่านี้:
จาก Radar chart จะเห็นได้ว่าการปรับปรุง Log Storage และ Log Ingestion มีศักยภาพในการลดต้นทุนสูง ในขณะที่ความพยายามในการดำเนินการอาจแตกต่างกันไป การทำความเข้าใจความสมดุลนี้จะช่วยให้คุณจัดลำดับความสำคัญของงานได้อย่างเหมาะสม
🎬 ชมวิดีโอ: การปรับลดค่าใช้จ่าย CloudWatch ภายใน 5 นาที
เพื่อเสริมความเข้าใจและเห็นภาพรวมของการปรับลดค่าใช้จ่าย CloudWatch อย่างรวดเร็ว วิดีโอนี้จาก AWS จะสรุปประเด็นสำคัญและแสดงวิธีการตรวจสอบค่าใช้จ่ายเบื้องต้น ซึ่งจะเป็นประโยชน์ในการเริ่มต้น:
วิดีโอนี้จะแสดงให้เห็นถึงวิธีการระบุส่วนที่ก่อให้เกิดค่าใช้จ่ายหลักใน CloudWatch, Log group ใดที่มีการ ingest ข้อมูลมากที่สุด และภาพรวมการวิเคราะห์รูปแบบของ Log ซึ่งสอดคล้องกับขั้นตอนการวิเคราะห์ต้นทุนปัจจุบันและการปรับปรุง Logs ที่ได้กล่าวถึง
🔄 ขั้นตอนที่ 6: การตรวจสอบและทบทวนอย่างสม่ำเสมอ
การปรับลดต้นทุนไม่ใช่กิจกรรมที่ทำครั้งเดียวแล้วจบ แต่เป็นกระบวนการที่ต้องทำอย่างต่อเนื่อง
-
สิ่งที่ต้องทำและเหตุผล (Why):
จัดตารางเวลาเพื่อทบทวนการใช้งาน CloudWatch และต้นทุนที่เกี่ยวข้องเป็นประจำ (เช่น รายเดือน หรือรายไตรมาส) ใช้ AWS Cost Explorer, CUR และ CloudWatch Dashboards เพื่อติดตามแนวโน้มค่าใช้จ่าย ตรวจสอบว่านโยบายที่ตั้งไว้ยังคงเหมาะสมหรือไม่ และมองหาโอกาสใหม่ๆ ในการลดต้นทุนเพิ่มเติม เนื่องจากระบบและแอปพลิเคชันมีการเปลี่ยนแปลงอยู่เสมอ
-
ลำดับความสำคัญ (Priority):
สูง (สำหรับการควบคุมต้นทุนในระยะยาว)
-
วิธีวัดผลเป็นตัวเลข (Measurement):
การติดตามแนวโน้มต้นทุน CloudWatch รายเดือน, การเปรียบเทียบต้นทุนกับช่วงก่อนหน้า, บันทึกการปรับปรุงที่ทำในแต่ละรอบการทบทวน
ข้อควรพิจารณาเพิ่มเติม:
- CloudWatch Free Tier: ทำความเข้าใจและใช้ประโยชน์จาก CloudWatch Free Tier ให้ได้มากที่สุด ซึ่งมีการให้บริการ Metrics, Logs, และ Alarms จำนวนหนึ่งโดยไม่เสียค่าใช้จ่าย
- การ Tagging ทรัพยากร: ใช้ Resource Tagging ที่สอดคล้องกันกับทรัพยากร AWS ของคุณ เพื่อช่วยในการวิเคราะห์และจัดสรรต้นทุน CloudWatch ตามโปรเจกต์, ทีม, หรือสภาพแวดล้อม
สรุปกลยุทธ์และแนวทางการวัดผลในตารางเดียว
เพื่อความสะดวกในการอ้างอิง ตารางด้านล่างนี้สรุปกลยุทธ์หลักในการลดต้นทุน AWS CloudWatch พร้อมลำดับความสำคัญ, ศักยภาพในการลดต้นทุนโดยประมาณ, และตัวชี้วัดสำคัญ:
| ส่วนที่ปรับปรุง (Optimization Area) | การดำเนินการหลัก (Key Actions) | ลำดับความสำคัญ (Priority) | ประมาณการลดต้นทุน (%) (Potential Cost Reduction) | ตัวชี้วัดหลัก (Key Measurement Metrics) |
|---|---|---|---|---|
| การวิเคราะห์ต้นทุนปัจจุบัน | ใช้ Cost Explorer, CUR+Athena วิเคราะห์ | สูง | N/A (เป็นขั้นตอนพื้นฐาน) | ระบุสัดส่วน % ต้นทุนจาก Metrics, Logs, Alarms |
| Metrics | ลบ Metrics ที่ไม่จำเป็น, ลดความละเอียด, ใช้ Metric Math, ใช้ Custom Metrics อย่างเหมาะสม | สูง | 20-50% (ของค่าใช้จ่าย Metrics) | จำนวน Metrics ที่ลดลง, ค่าใช้จ่าย Metrics ที่ลดลง |
| Logs | กำหนด Retention Policy, ปรับ Log Level, ส่งออก Logs ไป S3/Glacier, ใช้ Logs Insights อย่างมีประสิทธิภาพ | สูง | 30-90% (ของค่าใช้จ่าย Logs) | ปริมาณ Log Ingestion/Storage (GB) ที่ลดลง, ค่าใช้จ่าย Logs ที่ลดลง |
| Alerts (Alarms) | ลบ Alarms ที่ไม่จำเป็น, ใช้ Composite Alarms, ปรับ Thresholds และเงื่อนไข | สูง | 10-50% (ของค่าใช้จ่าย Alarms) | จำนวน Alarms ที่ลดลง, จำนวน Notifications ที่ลดลง |
| Dashboards | ลบ Dashboards ที่ไม่ได้ใช้งาน, รวมข้อมูลใน Dashboards ให้น้อยลง | ต่ำ | <5% (ของค่าใช้จ่าย Dashboards) | จำนวน Dashboards ที่ลดลง |
| การทบทวนและติดตามผลอย่างสม่ำเสมอ | ตรวจสอบต้นทุนและตั้งค่าเป็นประจำ (รายเดือน/ไตรมาส) | สูง (ระยะยาว) | เป็นการรักษาผลลัพธ์ | ความสม่ำเสมอของการตรวจสอบ, การปรับปรุงอย่างต่อเนื่อง, แนวโน้มต้นทุนคงที่หรือลดลง |
หมายเหตุ: เปอร์เซ็นต์การลดต้นทุนเป็นค่าประมาณการและอาจแตกต่างกันไปขึ้นอยู่กับสภาพแวดล้อมและการใช้งานจริงของแต่ละองค์กร
คำถามที่พบบ่อย (FAQ)
Q1: เหตุใด CloudWatch Logs จึงมักเป็นส่วนที่มีค่าใช้จ่ายสูงที่สุด?
CloudWatch Logs มีค่าใช้จ่ายจากหลายส่วน ทั้งการนำเข้าข้อมูล (Ingestion), การจัดเก็บ (Storage), และการวิเคราะห์ (Analysis เช่น Logs Insights) หากไม่มีการควบคุม Log Level ที่เหมาะสม, ไม่ได้ตั้งค่า Log Retention, หรือมีการ Query ข้อมูลจำนวนมากบ่อยครั้ง ค่าใช้จ่ายสามารถเพิ่มขึ้นได้อย่างรวดเร็ว โดยเฉพาะในระบบที่มีการสร้าง Log ปริมาณมหาศาล
Q2: ควรทบทวนค่าใช้จ่ายและการตั้งค่า CloudWatch บ่อยเพียงใด?
แนะนำให้ทบทวนค่าใช้จ่ายและการตั้งค่า CloudWatch อย่างน้อยเป็นรายเดือน เพื่อติดตามแนวโน้มและตรวจจับความผิดปกติได้อย่างรวดเร็ว สำหรับการปรับปรุงนโยบายหรือการตั้งค่าเชิงลึก อาจทำเป็นรายไตรมาสหรือเมื่อมีการเปลี่ยนแปลงสำคัญในสถาปัตยกรรมของระบบ
Q3: สามารถใช้ระบบอัตโนมัติช่วยในการปรับลดต้นทุน CloudWatch ได้หรือไม่?
ใช่ สามารถใช้ AWS Lambda functions ร่วมกับ CloudWatch Events (หรือ Amazon EventBridge) เพื่อทำงานบางอย่างโดยอัตโนมัติ เช่น การตั้งค่า Log Retention ให้กับ Log Groups ใหม่ๆ ที่ถูกสร้างขึ้น, การลบ Alarms ที่ไม่ใช้งาน หรือการส่งออก Logs ไปยัง S3 ตามกำหนดเวลา
Q4: Basic Monitoring กับ Detailed Monitoring สำหรับ EC2 แตกต่างกันอย่างไรในแง่ค่าใช้จ่าย?
Basic Monitoring สำหรับ EC2 instances จะเก็บข้อมูล Metrics ทุก 5 นาที และมักจะรวมอยู่ใน Free Tier หรือมีค่าใช้จ่ายต่ำมาก ในขณะที่ Detailed Monitoring จะเก็บข้อมูลทุก 1 นาที ซึ่งมีค่าใช้จ่ายเพิ่มเติมต่อ Metric การเลือกใช้ Detailed Monitoring เฉพาะเมื่อจำเป็นจริงๆ จะช่วยลดค่าใช้จ่ายได้มาก
Q5: การส่งออก Logs ไปยัง S3 คุ้มค่ากว่าเสมอไปหรือไม่?
โดยทั่วไปแล้ว สำหรับการจัดเก็บ Logs ระยะยาว (Long-term archival) ที่ไม่ต้องการการเข้าถึงหรือวิเคราะห์บ่อยครั้ง การส่งออกไปยัง S3 (โดยเฉพาะ S3 Standard-Infrequent Access, S3 Glacier Flexible Retrieval, หรือ S3 Glacier Deep Archive) จะมีค่าใช้จ่ายถูกกว่าการเก็บไว้ใน CloudWatch Logs อย่างไรก็ตาม ต้องพิจารณาถึงความถี่ในการเข้าถึงข้อมูลและความซับซ้อนในการตั้งค่าระบบส่งออกและ Query ข้อมูลจาก S3 ด้วย หากต้องการ Query บ่อยครั้งด้วย Logs Insights การเก็บไว้ใน CloudWatch Logs อาจสะดวกกว่า แม้จะมีค่าใช้จ่ายสูงกว่าเล็กน้อย
คำแนะนำเพิ่มเติมสำหรับการค้นคว้า (Recommended Queries)
- วิธีตั้งค่า Log Retention Policy ใน AWS CloudWatch Logs ผ่าน CLI ทำอย่างไร?
- เปรียบเทียบค่าใช้จ่ายระหว่าง CloudWatch Logs Standard กับ Infrequent Access Log Class มีข้อดีข้อเสียอย่างไร?
- ตัวอย่างการใช้ Composite Alarms เพื่อลด Alarm Noise ใน CloudWatch มีอะไรบ้าง?
- เทคนิคการใช้ AWS Cost Explorer เพื่อวิเคราะห์ค่าใช้จ่าย CloudWatch เชิงลึกมีอะไรบ้าง?
แหล่งอ้างอิง (References)
 docs.aws.amazon.com
 aws.amazon.com
docs.aws.amazon.com
aws.amazon.com
 aws.amazon.com
docs.aws.amazon.com
docs.aws.amazon.com
Last updated May 13, 2025