
解锁百度UNIT潜能:全面解析文档规范与集成要点
深入了解百度UNIT对文档格式、内容、API交互及数据结构的具体要求,助您高效构建智能对话系统。
核心洞察:快速掌握UNIT文档要求精髓
- 文件格式与内容标准: UNIT对上传文档的格式(如TXT, DOC, DOCX, 以及表格数据的XLS)及内容(需UTF-8编码,结构清晰,避免冗余信息)有明确规定,这是确保系统正确解析数据的基础。
- API交互规范的遵循: 与UNIT平台进行API交互时,技能对话API需遵循特定的请求参数结构(例如
query_info对象),而表格问答功能则依赖于严格定义的数据表(table,schema,data)和字段命名规则。 - 文档管理与技能构建流程: 文档是构建知识问答等技能的核心要素,需要经过上传和平台的“学习”过程。平台支持通过API进行文档的增删改查及内容更新,以保证知识库的时效性和准确性。
理解百度UNIT文档要求:构建高效对话系统基石
百度UNIT(Understanding and Interaction Technology)作为百度推出的一款强大的智能对话定制与服务平台,为开发者和企业提供了快速构建和部署高级对话系统的能力。要充分利用UNIT的功能,理解并遵循其文档相关的各项要求至关重要。这些要求涵盖了从文档上传的格式、内容标准到API交互的数据结构等多个层面,直接影响着对话机器人的训练效果、知识库的准确性以及系统整体的稳定运行。
百度持续投入AI技术研发,UNIT平台是其重要成果之一。
核心文档规格:格式、命名与内容标准
在百度UNIT平台上处理和上传文档时,遵循特定的规范是确保数据被正确解析和利用的前提。
支持的文件格式
百度UNIT平台明确支持以下几种主流文档格式,以便于集成到对话技能或知识问答系统中:
- 文本文件:
.txt - Word文档:
.doc,.docx
这些格式因其易于处理和分析,非常适合平台的自然语言处理(NLP)引擎进行内容提取和理解。对于表格型数据,尤其是在表格问答场景下,建议使用Excel的.xls格式(特别是Excel 97-2003版本),因为.xlsx格式有时可能在上传时遇到兼容性问题。
文档命名约定
为了便于管理和后续调用,上传的文档应基于其业务场景进行合理命名。推荐使用能够简明扼要地概括文档内容的名称,例如《XX产品售后服务条款》或《XX地区分店地址列表》,避免使用如“文档1”、“测试数据”等模糊不清的命名。这有助于提高文档检索效率和系统维护的便捷性。
内容与编码标准
文档内容的质量和格式同样重要:
- 编码要求: 所有上传的文本文档必须使用
UTF-8编码。这是因为UTF-8能够广泛支持包括中文在内的多语种字符,确保文本在对话系统中得到正确解析,避免乱码或识别错误。 - 内容清晰度与结构化: 文档内容应尽可能清晰、条理分明且结构化,这有助于UNIT的NLP技术更高效地进行知识抽取和语义理解。避免上传包含大量无关信息或格式混乱的内容。
- 长度与大小限制: 针对特定技能(如问答技能中的问题),文本长度可能存在限制(例如,不超过125个字符,具体视技能类型而定)。对于大模型知识问答技能,文档内容应力求简洁、有针对性,避免冗长内容影响模型训练效果和响应效率。
- 特征词与模板: 在构建多轮对话技能或特定问答技能时,文档内容可能需要包含预先定义的特征词或与意图、词槽配置相关的模板。如果关键术语未能预先配置到意图和词槽中,技能训练可能会失败或效果不佳。
与百度UNIT交互:API及数据结构指令
通过API与百度UNIT平台进行交互是实现定制化和自动化管理的关键。UNIT对API请求参数和特定场景(如表格问答)的数据结构有严格规定。
技能对话API:请求参数规范
当通过技能对话API与UNIT进行交互时,发送的请求必须包含一个query_info对象,其内部结构需满足以下要求:
type(字符串枚举类型): 必需。表示请求信息的类型,取值范围为"TEXT"(文本请求)或"EVENT"(事件请求)。source(字符串枚举类型): 必需。表示请求信息的来源,取值为"ASR"(Automatic Speech Recognition,语音输入)或"KEYBOARD"(键盘文本输入)。asr_candidates(列表,可选): 当source为"ASR"时,此字段可包含语音输入的多个候选文本及其置信度。这有助于系统进行更综合的判断和处理,提升语音交互的准确性。
所有API请求通常需要以JSON格式进行数据封装,并通过POST请求发送。URL和参数需严格匹配官方文档的规范。
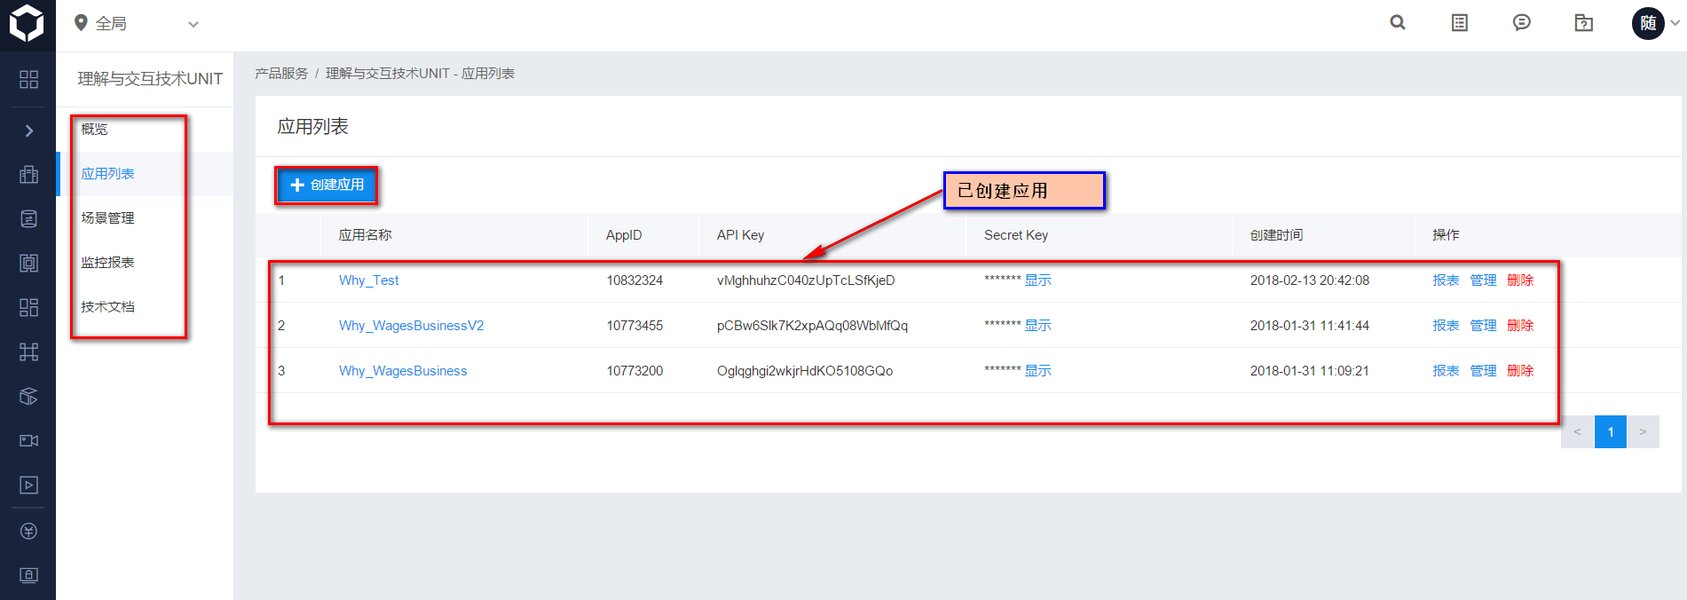
百度UNIT平台界面,展示了技能创建和管理的相关操作。
表格问答:数据结构的严格要求
百度UNIT的表格问答功能对上传的Excel文档内的数据结构有非常具体的要求,以确保数据能被正确解析并用于回答用户基于表格内容的提问。
- 必需的表结构: 上传的Excel文件中必须包含三个特定的工作表(Sheet),分别命名为
table、schema和data。这三者是构成表格问答知识的基础,缺一不可。 - 字段命名规范:
- 表中的所有字段(列头)必须同时提供中文名和英文名。
- 英文名是必需的,且不能使用包含下划线或空格的复合词(例如,
day_and_night是不允许的,但可以使用连写的形式如dayandnight)。
Schema表的特殊规定:“name”字段
在schema工作表中,存在一个特殊且强制性的字段要求:
- 必须包含一个名为
name的字段(列)。无论该列实际存储的内容代表什么业务含义,其英文名必须是name。这个字段通常用于标识表格中的主要实体或条目。
数据完整性:避免多余空格和格式
为保证数据解析的准确性:
- 无多余空格: 数据单元格内不应包含多余的前导、尾随或中间空格,尤其是在关键的标识性字段中(如值班表中的人名)。
- 纯数值数据: 数据应为纯文本或纯数值,不应带有特殊的单元格格式(如货币符号、日期格式等),除非UNIT文档中有明确说明支持。所有格式化应在数据导入前处理完毕。
可视化解析:UNIT文档要求的关键维度
为了更直观地理解百度UNIT对各项文档和数据规范的侧重程度及其对系统功能实现的重要性,下面的雷达图展示了不同要求维度的评估。这些评估基于各项规范对系统基础功能实现和高级特性优化的影响程度。数值越高,代表该方面的要求越严格或对系统性能影响越大。
此图表强调了API参数的精确性、文档格式的合规性以及表格数据结构化的极端重要性,这些是确保UNIT系统正常运作和发挥其功能的基础。同时,高质量的内容和良好的命名规范对于提升NLP效果和系统可维护性也具有显著价值。
文档管理与技能构建:UNIT生态系统中的核心流程
在百度UNIT生态系统中,文档不仅仅是静态的数据,更是构建和训练智能对话技能,尤其是知识问答类技能的关键资源。有效的文档管理贯穿于技能创建、训练、部署和优化的整个生命周期。
文档在知识问答技能中的角色
创建“知识问答技能”时,上传相关的业务文档是必不可少的第一步。平台要求至少上传一篇文档,并完成文档的“学习”过程。在这个过程中,UNIT系统会自动阅读、解析这些文档,抽取关键信息,构建初步的问答知识库。文档内容的质量和覆盖范围直接决定了问答机器人回答问题的准确性和全面性。
通过API进行文档的动态管理
百度UNIT提供了丰富的API接口,允许开发者通过编程方式对文档进行管理,包括:
- 上传文档: 将新的业务文档或知识片段添加到系统中。
- 查询文档: 检索已上传文档的状态或内容。
- 更新文档: 修改现有文档的内容,以反映业务变化。
- 删除文档: 移除过时或不再需要的文档。
在进行API调用时,必须确保请求格式和参数符合百度UNIT技能管理API文档的要求,并使用正确的API授权凭证(如API Key/Secret Key生成的Access Token)进行身份验证。同时,需要注意API的请求频率限制和单次上传数据的大小限制,以避免调用失败。
保持知识鲜活:文档更新与模型再训练
业务知识和用户信息是动态变化的。因此,当相关的业务文档内容发生更改后(例如政策更新、产品信息调整),应及时通过UNIT平台或API接口更新相应的文档。文档更新后,通常需要重新触发学习或训练流程,以确保对话系统内部的知识库与最新的业务状态保持同步,从而保证问答技能能够提供最新、最准确的响应。
百度UNIT文档要求概览:概念结构图
下图通过一个思维导图的形式,清晰地展示了百度UNIT在文档、API及数据结构方面的主要要求和它们之间的层级关系。这有助于开发者从宏观上把握构建UNIT应用时需要关注的关键节点。
该思维导图梳理了从基础的文档格式、内容要求,到复杂的API交互参数、表格数据结构,再到平台集成层面的考量,为开发者提供了一个清晰的遵循指南。
私有化部署的硬件考量
对于选择私有化部署百度UNIT平台的企业用户,除了遵循上述文档和API规范外,还需要关注部署环境的硬件配置。官方文档通常会提供推荐的硬件规格,以保证平台的稳定运行和高效的文档处理能力。一般而言,推荐配置可能包括:
- CPU架构: AMD 64/x86_64 架构。
- 内存 (RAM): 通常要求64GB或以上,以支持大规模数据处理和模型训练。
- 硬盘空间: 至少500GB或以上,需要确保应用安装目录和数据存储目录有充足的磁盘空间。
充足的硬件资源是文档存储、学习、模型训练及服务响应速度的重要保障,尤其是在处理大量文档或高并发请求的场景下。
实践指南:关键文档与数据结构要求一览
为了方便开发者快速查阅和遵循百度UNIT的核心文档及数据规范,下表汇总了各项关键要求及其重要性说明:
| 类别 | 具体要求 | 重要性/备注 |
|---|---|---|
| 文档上传 (通用) | 支持TXT, DOC, DOCX格式;UTF-8编码;命名清晰且能代表业务内容。 | 基础要求,确保系统正确解析、管理文档,并提升维护效率。 |
| 内容质量 (文档问答) | 内容清晰、结构化,紧密围绕业务场景,覆盖用户常见咨询,避免无关信息和格式混乱。 | 直接影响问答机器人的准确性和模型训练效果。 |
| 技能对话API | 请求必须包含query_info对象(内含type, source字段),语音输入时可选用asr_candidates。数据通常以JSON格式封装。 |
API调用的核心,确保用户请求被UNIT平台正确理解和处理。 |
| 表格问答 (数据结构) | Excel中必须包含table, schema, data三个工作表;字段需有中英文名,英文名为必需且不能是复合词;schema表中必须有name字段(英文固定为name)。 |
要求极为严格,直接关系到表格数据的正确导入和后续的查询问答能力。 |
| 表格问答 (数据内容与格式) | 数据单元格内应为纯数值或纯文本,不能有多余空格;推荐使用XLS格式 (Excel 97-2003版本)。 | 保证数据解析的准确性,避免因格式问题导致上传失败或数据错误。 |
| API调用 (通用安全) | 所有API调用前必须获取有效的访问凭证(如API Key/Secret Key生成的Access Token);推荐使用HTTPS协议进行安全传输。 | 保障数据安全和接口访问权限控制的基础。 |
| 私有化部署 (硬件) | 建议CPU为AMD 64/x86_64架构,内存不低于64G,硬盘空间不低于500G(确保应用安装目录空间充足)。 | 硬件资源配置直接影响私有化部署环境下UNIT平台的性能、文档处理效率及服务响应速度。 |
遵循这些指导原则,将有助于开发者更顺利地集成和使用百度UNIT平台,构建出功能强大且表现稳定的智能对话应用。
常见问题解答 (FAQ)
百度UNIT主要支持哪些文档格式进行上传?
百度UNIT平台主要支持以下文档格式:
- 文本文件:
.txt - Microsoft Word 文档:
.doc,.docx - 对于表格问答功能,推荐使用Excel的
.xls(97-2003) 格式。虽然.xlsx也可能被支持,但.xls格式的兼容性更佳。
所有上传的文本文档内容均要求使用UTF-8编码。
调用百度UNIT技能对话API时,关键的请求参数有哪些?
在调用技能对话API时,请求体中必须包含一个名为query_info的JSON对象,其内部关键参数包括:
type: 必需,字符串类型,用于指明请求类型,可选值为"TEXT"(文本) 或"EVENT"(事件)。source: 必需,字符串类型,用于指明请求来源,可选值为"ASR"(语音识别输入) 或"KEYBOARD"(键盘文本输入)。asr_candidates: 可选,当source为"ASR"时,可以提供一个包含多个语音识别候选文本及对应置信度的列表,以供系统综合判断。
百度UNIT对表格问答的数据结构有何特殊要求?
是的,百度UNIT对用于表格问答的Excel数据结构有严格要求:
- 三表结构: Excel文件中必须包含名为
table,schema, 和data的三个工作表 (Sheet)。 - 字段命名: 所有字段(列名)必须同时提供中文名和英文名。英文名是必需的,且不能是复合词(如
user_id),应使用连接词(如userid)。 schema表中的name字段: 在schema表中,必须存在一个字段,其英文名固定为name。此字段至关重要。- 数据纯净: 数据单元格内不应有多余的空格,且数据应为纯数值或文本,不带特殊格式。
为什么上传至百度UNIT的文档需要使用UTF-8编码?
要求文档使用UTF-8编码主要是为了确保最大程度的字符兼容性。UTF-8是一种通用的字符编码标准,能够正确表示世界上几乎所有的字符和符号,包括中文、英文、以及各种特殊符号。在自然语言处理(NLP)和智能对话系统中,正确的字符编码是文本被准确解析、理解和处理的前提。如果使用非UTF-8编码(如GBK),在跨平台或多语言环境下,很容易出现乱码问题,导致UNIT平台无法正确识别文档内容,进而影响模型训练、知识抽取和最终的对话效果。
如果百度UNIT文档命名不规范会产生什么影响?
虽然文档命名不规范可能不会直接导致系统核心功能失败,但它会对项目的管理、维护和协作效率产生负面影响:
- 管理困难: 当项目中包含大量文档时,模糊或无意义的命名(如“文档1”、“测试数据.txt”)会使得查找特定业务文档变得非常困难和耗时。
- 调用混淆: 如果系统或脚本需要通过名称来引用或调用特定文档,不规范的命名容易引发错误或混淆。
- 协作障碍: 在团队协作中,清晰的命名有助于其他成员快速理解文档内容和用途,而不规范的命名则会增加沟通成本和误解风险。
- 可维护性降低: 长期来看,随着业务发展和文档数量的增加,良好的命名习惯是保持系统可维护性的重要因素。
因此,百度UNIT建议为文档赋予能够简明代表其内容的名称,如《手机三包政策》而非《文档1》,以提升整体工作效率和项目管理水平。
推荐进一步探索
- 如何在百度UNIT中创建和训练一个知识问答机器人?
- 百度UNIT的表格问答功能如何配置和使用?
- 探索百度UNIT技能对话API的高级用法和最佳实践。
- 百度UNIT私有化部署的详细步骤和注意事项有哪些?
参考文献
 unitweb.cdn.bcebos.com
Last updated May 14, 2025