
构建智能知识伙伴:从个人知识库到高价值回应的工作流
解锁您的 PDF、EPUB 和 TXT 宝藏,创建能提供深刻见解、励志金句和情感支持的 AI 工作流。
您好!构建一个能够理解问题、深入挖掘您个人知识库(包括 PDF、EPUB 书籍和 TXT 金句),并生成富有洞察力、引用金句且充满情感关怀的回应的工作流,是一个融合了信息检索与人工智能生成能力的有趣挑战。这本质上是创建一个基于检索增强生成(RAG)技术的智能问答系统。下面将详细阐述如何实现这一目标。
核心亮点
- 知识整合: 自动化处理 PDF、EPUB、TXT 文件,构建统一、可检索的向量化知识库。
- 智能匹配: 运用先进的语义搜索技术,精准定位与用户问题最相关的知识片段和金句。
- 价值生成: 结合大型语言模型(LLM)与精心设计的提示词,创造性地输出高认知观点、励志名言,并赋予回应温暖的情感价值。
构建蓝图:工作流核心步骤
整个工作流的核心是检索增强生成(RAG)模型。简单来说,它首先从您的知识库中“检索”与问题相关的信息,然后利用大型语言模型结合这些信息来“生成”一个全面、深入且符合您要求的回答。以下是详细步骤:
1. 知识库准备与构建 (Knowledge Base Preparation)
这是基础环节,目标是将您多样化的文件转换成机器可理解和检索的格式。
数据提取与预处理
- 文本提取:
- 对于 PDF 文件,可以使用
PyMuPDF (fitz)或pdfplumber等库提取文本。 - 对于 EPUB 文件,可以使用
ebooklib等库解析并提取内容。 - 对于 TXT 文件(金句),直接读取文本内容即可。
- 对于 PDF 文件,可以使用
- 文本清洗: 去除提取文本中的无关字符、格式错误、重复内容等噪音,确保数据质量。
- 文本切分 (Chunking): 将较长的文本(如书籍章节)切分成更小的、语义连贯的文本块(Chunks)。合适的切分粒度(例如,按段落或固定长度,如 500-1000 字符)对于后续的向量化和检索效果至关重要。
- 元数据关联: 为每个文本块附加来源信息,如文件名、书籍名称、章节、页码等。这有助于在生成答案时溯源,并可能用于更精细的检索。
- 金句特殊处理: 对 TXT 文件中的名人金句进行特殊标记或单独存储,以便在生成回应时更容易识别和优先选用。
2. 向量化与索引 (Vectorization & Indexing)
此步骤是将文本信息转化为机器能够进行语义理解和比较的数学表示。
文本嵌入 (Text Embedding)
使用强大的文本嵌入模型(如 Sentence Transformers 提供的开源模型 M3E, BGE,或 OpenAI 的 text-embedding-ada-002 等),将每一个文本块(Chunk)转换成高维度的数字向量(Vector)。这些向量能够捕捉文本的深层语义信息,使得意思相近的文本在向量空间中的距离也相近。
构建向量索引
将所有文本块生成的向量存储到一个专门的向量数据库中(如 FAISS, Milvus, Pinecone, Weaviate, ChromaDB 等)。向量数据库能够高效地存储、管理和查询大量的向量数据,实现快速的相似性搜索。
3. 智能检索匹配 (Intelligent Retrieval)
当用户输入问题后,系统需要从庞大的知识库中找到最相关的内容。
查询处理
使用与构建知识库时相同的嵌入模型,将用户的输入问题也转换成一个查询向量。
相似性搜索
利用用户问题的查询向量,在向量数据库中进行搜索,找出与该向量在语义上最相似的 Top-K(例如,Top 3 或 Top 5)个文本块。这些文本块就是从您的知识库中检索到的、与问题最相关的信息片段。
混合检索 (Optional but Recommended)
为了提高检索的准确性和覆盖面,可以考虑结合传统的关键词搜索(如 BM25 算法)和向量语义搜索。关键词搜索能快速定位包含特定术语的文本,而语义搜索则能找到意思相关但用词不同的内容。
4. 内容生成与价值增强 (Generation & Value Enhancement)
这是实现您“高认知、高价值、带情绪价值”输出目标的关键环节。
构建提示词 (Prompt Engineering)
将用户的原始问题、以及上一步检索到的 Top-K 相关文本块(作为上下文信息)整合起来,构建一个结构化的提示词(Prompt)输入给大型语言模型(LLM)。精心设计的 Prompt 是引导 LLM 按需生成的关键,需要明确指示模型:
- 基于提供的上下文信息,提炼和总结深刻的观点。
- 识别并恰当地引用上下文中的名人金句(特别是来自您 TXT 知识库的部分)。
- 使用积极、鼓励、共情或支持性的语言风格,赋予回答情感温度。
- 确保回答逻辑清晰、内容连贯。
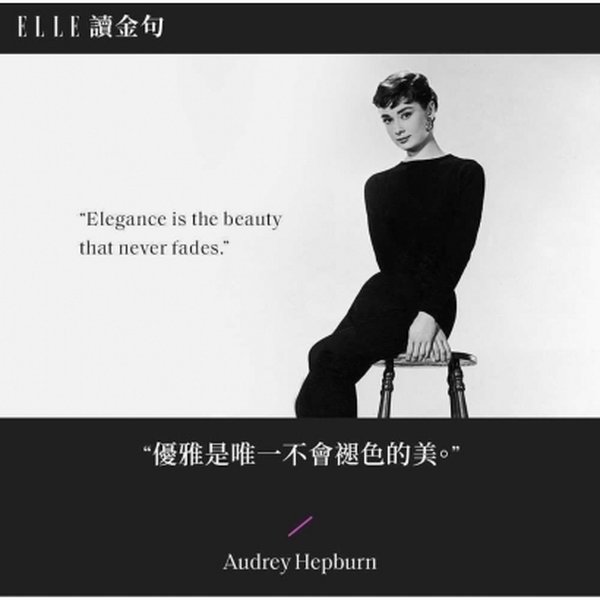
您的金句库可以像这样成为生成励志回应的宝贵素材。
调用大型语言模型 (LLM Invocation)
将构建好的 Prompt 发送给一个性能优越的大型语言模型(如 GPT-4, Claude, Llama 系列,或国内的 ChatGLM, Kimi 等)。LLM 会理解 Prompt 中的指令和上下文,生成最终的回答。
输出优化 (Optional)
在某些情况下,可能需要对 LLM 的原始输出进行简单的后处理,例如格式调整、敏感信息过滤,或根据特定规则进一步强化情感表达。
5. 工作流实现与部署 (Workflow Implementation & Deployment)
选择合适的工具或平台将上述步骤串联起来。
技术选型
- 框架/库:
- LangChain / LlamaIndex: 流行的开源 Python 库,提供了构建 RAG 应用的模块化组件和流程编排能力,灵活性高,适合有一定开发能力的个人或团队。
- 低代码/无代码平台:
- 扣子 (Coze): 正如您提到的,Coze 平台旨在简化 AI 应用和工作流的创建。它通常内置了知识库管理、LLM 调用、插件集成等功能,可以通过图形化界面拖拽节点来构建 RAG 工作流。Answer D 提供了在 Coze 上操作的基本思路。
- Dify / Autoflow: 其他类似的平台,也提供可视化界面来构建和部署基于知识库的问答应用。
部署方式
- 本地部署: 对于数据隐私要求高或希望完全掌控的场景,可以使用 Ollama 等工具在本地运行开源 LLM 和 RAG 框架。
- 云平台部署: 利用云服务商提供的 AI 平台或 PaaS 服务部署工作流。
- 集成到应用: 将构建好的工作流通过 API 接口集成到您需要的应用中(如网站、聊天机器人等)。
工作流可视化:思维导图
下面的思维导图清晰地展示了构建此智能知识伙伴工作流的核心环节及其相互关系。
- 融入上下文
- 指令: 观点/金句/情感"] id4.2["调用大语言模型 (LLM)"] id4.3["(可选) 输出后处理"] id5["5. 实现与部署 (Implementation & Deployment)"] id5.1["选择工具 (LangChain, Coze, Dify...)"] id5.2["本地/云端部署"] id5.3["应用集成 (API)"]
工具与技术栈概览
下表总结了实现工作流各步骤可能用到的关键工具和技术库,供您参考选择:
| 步骤 (Step) | 功能 (Function) | 推荐工具/库 (Recommended Tools/Libraries) |
|---|---|---|
| 知识库准备 | 文件文本提取 | PyMuPDF (fitz), pdfplumber (PDF), ebooklib (EPUB), Python standard library (TXT) |
| 知识库准备 | 文本切分 | LangChain Text Splitters, LlamaIndex Node Parser, NLTK, spaCy |
| 向量化与索引 | 文本嵌入 | Sentence Transformers (M3E, BGE, etc.), OpenAI Embeddings API, Hugging Face Transformers |
| 向量化与索引 | 向量存储与索引 | FAISS, Milvus, Pinecone, Weaviate, ChromaDB, Elasticsearch (with vector plugin) |
| 生成与增强 | 大型语言模型 | OpenAI API (GPT-3.5/4), Anthropic API (Claude), Google Gemini API, Ollama (for local models like Llama, Mistral), Hugging Face Hub |
| 工作流实现 | RAG 框架/平台 | LangChain, LlamaIndex, Haystack, Coze, Dify, Autoflow |
实现方法比较:Coze vs. 自定义构建 (LangChain)
选择 Coze 这样的低代码平台还是使用 LangChain/LlamaIndex 等框架进行自定义构建,各有优劣。下面的雷达图从几个关键维度对这两种主要方法进行了比较,帮助您根据自身需求和技术背景做出决策。
解读:
- Coze: 优势在于易用性高、学习曲线平缓、知识库集成通常更直接(内置功能)。对于希望快速搭建、代码经验较少的用户友好。但在深度定制化和性能调优方面可能受限。
- 自定义构建 (LangChain/LlamaIndex): 提供极高的灵活性和定制化能力,能进行深度性能优化,并可集成任意模型和服务。但学习曲线较陡峭,需要一定的编程基础和时间投入。成本可能因使用的 LLM API 或自托管基础设施而异。
实践案例:本地知识库问答
了解如何实际操作搭建本地知识库可能对您有帮助。以下视频展示了一个零代码创建本地知识库并与文档对话的工具示例,虽然可能不是您最终选择的方案,但其演示的过程和理念是相通的。
这个视频展示了如何利用现成工具快速搭建一个连接本地文档的问答系统,这与您需求的核心流程——连接知识库(文档)并进行问答——非常相似。它强调了数据本地化处理的优势,这对于保护您私人知识库的隐私尤其重要。
常见问题解答 (FAQ)
如何保证我的知识库数据的隐私和安全? +
如果您对数据隐私高度关注,最佳实践是采用本地部署方案。这意味着:
- 将知识库文件存储在本地计算机或私有服务器上。
- 使用可在本地运行的开源嵌入模型和大型语言模型(例如,通过 Ollama 或类似框架运行 Llama 3, Mistral 等)。
- 选择支持本地部署的 RAG 框架(如 LangChain, LlamaIndex)。
- 如果使用 Coze 等平台,请仔细查阅其数据隐私政策,了解数据处理和存储的位置,并优先选择提供私有化部署或确保数据不出域的选项。
避免将您的私人书籍和笔记上传到不信任的第三方云服务。
知识库更新(增加新书或金句)后,工作流需要做什么? +
当您的知识库内容发生变化时,通常需要执行以下操作以使工作流能够利用新信息:
- 重新处理新文件: 对新增的 PDF、EPUB 或 TXT 文件执行与初始构建时相同的步骤:提取文本、清洗、切分。
- 向量化新数据: 使用相同的嵌入模型将新的文本块转换为向量。
- 更新向量索引: 将新生成的向量添加到您的向量数据库中。大多数向量数据库支持增量更新。
工作流的核心逻辑(检索和生成步骤)通常不需要改变,只需确保其连接的向量数据库包含了最新的知识即可。一些平台(如 Coze)可能提供了自动化的知识库更新流程。
如何提高输出观点和金句的质量与相关性? +
提升输出质量涉及多个层面:
- 优化知识库质量: 确保源文件内容清晰、准确。对金句进行良好分类和标记。
- 改进文本切分策略: 实验不同的切分大小和重叠度,找到最适合您数据和查询类型的设置。
- 选择更优的嵌入模型: 不同的嵌入模型在捕捉语义相似性方面表现不同,可以尝试评测效果更好的模型。
- 调整检索参数 (Top-K): 增加或减少检索回的文本块数量(K值),观察对生成结果的影响。
- 精细化 Prompt Engineering: 这是最关键的一环。不断迭代您的提示词,更清晰地指示 LLM 如何综合信息、提炼观点、选择金句,并控制语气。可以加入示例(few-shot learning)来引导模型。
- 使用更强大的 LLM: 能力更强的 LLM 通常能更好地理解指令和上下文,生成更高质量的回应。
- 引入重排 (Re-ranking) 模型: 在检索后、生成前,使用一个轻量级模型对检索到的 Top-K 结果进行二次排序,将最相关的放在前面。
这个工作流可以处理图片或音视频格式的知识吗? +
处理图片、音频或视频等多模态数据比纯文本更复杂,但并非不可能。这需要引入支持多模态处理的技术:
- 图片: 需要使用能够理解图像内容的模型(如 CLIP 或 BLIP 类模型)来提取图像描述或将图像本身嵌入到向量空间。然后可以进行图文混合检索。
- 音视频: 通常需要先使用语音转文本(ASR)技术将音频内容转换为文字,然后按处理文本的方式进行。对于视频,可能还需要结合图像理解技术分析关键帧。
实现多模态知识库问答需要更先进的模型和更复杂的处理流程。当前主流的 RAG 框架(如 LangChain, LlamaIndex)正在逐步增强对多模态数据的支持,但相比纯文本处理,成熟度和易用性还有差距。如果您有此需求,需要关注多模态 AI 领域的最新进展。
参考资料
以下资源提供了关于构建知识库问答系统、RAG 技术和相关工具的更多信息:
- 【AIGC】AI如何匹配RAG知识库: Embedding实践,语义搜索 - CSDN博客
- 【人工智能】AI如何精准匹配RAG知识库?详细揭秘混合检索! - 百度智能云
- 从0开始构建:基于本地知识库的问答机器人 - 知乎专栏
- 知识库检索匹配的服务化实践 - 有赞技术团队
- 【本地部署】构建AI问答知识库:一站式指南 - CSDN博客
- 基于知识库的问答系统中-问题和知识库的相关性匹配是如何做的? - LangChain中文网
- 语言与知识- 评论观点抽取 - 百度AI技术文档
推荐探索
如果您希望进一步深入,可以探索以下相关主题:
Last updated April 24, 2025