
Padroneggiare l'Elaborazione Batch COBOL-DB2: Commit Affidabili e Ripartenze Intelligenti
Scopri come costruire programmi COBOL robusti per l'elaborazione di file e l'interazione con DB2, garantendo integrità dei dati e recupero efficiente.
Punti Salienti dell'Elaborazione Robusta
- Commit Strategici: Impara perché e come implementare commit periodici per ottimizzare le prestazioni e la recuperabilità.
- Logica di Ripartenza Essenziale: Comprendi i meccanismi per riprendere l'elaborazione da un punto di errore, evitando duplicazioni e perdite di dati.
- Gestione Proattiva degli Errori: Scopri come intercettare e gestire gli errori DB2 (come il temuto -803) e di I/O del file.
Introduzione all'Elaborazione Batch COBOL con DB2
Nello sviluppo di applicazioni mainframe, i programmi batch COBOL giocano un ruolo cruciale nell'elaborazione di grandi volumi di dati. Quando questi programmi interagiscono con database relazionali come DB2, diventa fondamentale implementare strategie che garantiscano non solo l'efficienza ma anche la robustezza del processo. Questo include la lettura sequenziale di file di input, l'inserimento dei dati in tabelle DB2, la gestione attenta delle transazioni tramite commit periodici e, soprattutto, una solida logica di ripartenza per affrontare eventuali interruzioni o errori.
Una corretta implementazione di questi concetti previene la perdita di dati, evita la rielaborazione di record già processati (che potrebbe portare a errori come chiavi duplicate) e minimizza i tempi di inattività in caso di fallimento del programma.
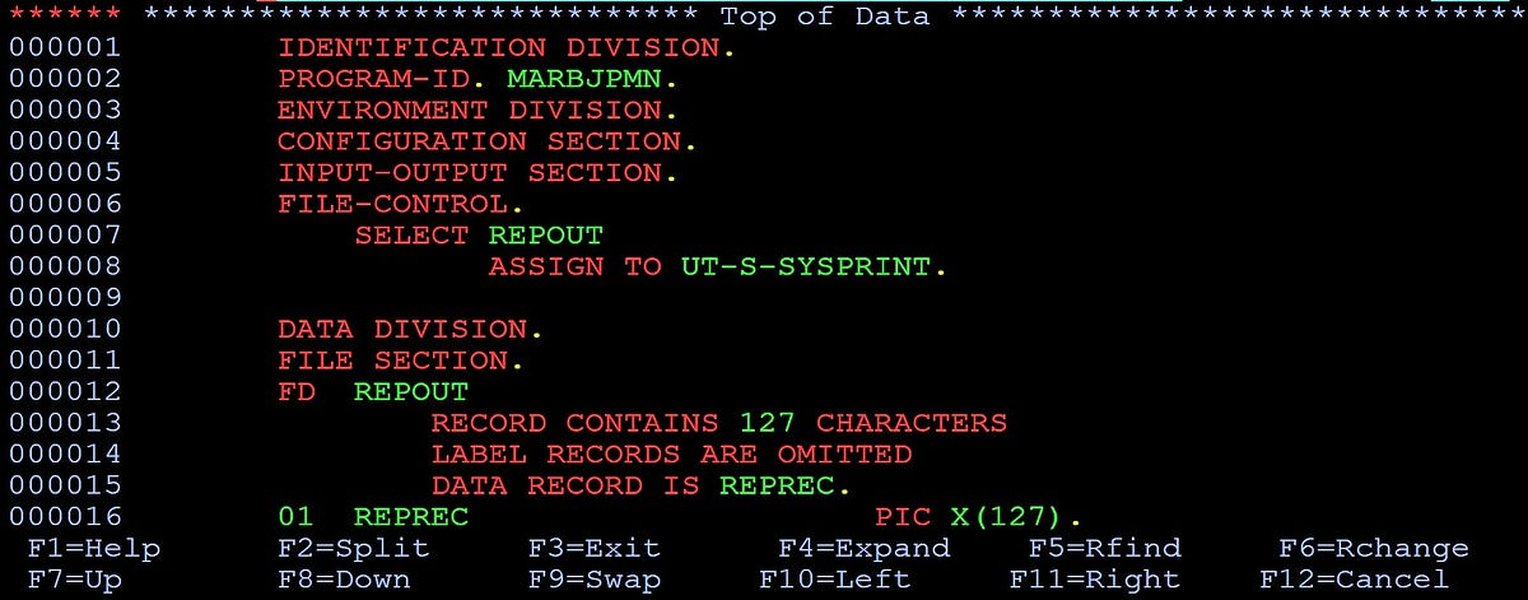
Struttura tipica di un programma COBOL per l'elaborazione dati.
Il Ciclo di Lettura del File in COBOL
Il primo passo nell'elaborazione batch è la lettura dei dati da un file di input. In COBOL, questo processo è ben definito e strutturato.
Definizione e Apertura del File
Prima di poter leggere un file, è necessario definirlo nella ENVIRONMENT DIVISION (all'interno di FILE-CONTROL) e descriverne la struttura dei record nella FILE SECTION della DATA DIVISION. Successivamente, il file viene aperto in modalità INPUT utilizzando l'istruzione OPEN.
IDENTIFICATION DIVISION.
PROGRAM-ID. ELABORA-FILE-DB2.
ENVIRONMENT DIVISION.
INPUT-OUTPUT SECTION.
FILE-CONTROL.
    SELECT FILE-INPUT ASSIGN TO 'NOMEFILE.DAT'
        ORGANIZATION IS SEQUENTIAL
        ACCESS MODE IS SEQUENTIAL
        FILE STATUS IS FS-FILE-INPUT.
DATA DIVISION.
FILE SECTION.
FD FILE-INPUT
   RECORD CONTAINS 80 CHARACTERS.
01 RECORD-INPUT.
   05 CAMPO-CHIAVE       PIC X(10).
   05 ALTRI-DATI         PIC X(70).
WORKING-STORAGE SECTION.
01 FS-FILE-INPUT         PIC XX.
   88 FS-FILE-OK         VALUE '00'.
   88 FS-FILE-EOF        VALUE '10'.
01 WS-EOF-FLAG           PIC X VALUE 'N'.
   88 EOF-RAGGIUNTA      VALUE 'Y'.
Lettura Sequenziale dei Record
La lettura avviene tipicamente all'interno di un loop, utilizzando l'istruzione READ. La clausola AT END viene utilizzata per rilevare la fine del file, mentre NOT AT END gestisce l'elaborazione di ogni record letto. È buona pratica controllare il FILE STATUS dopo ogni operazione di I/O per intercettare eventuali errori.
PROCEDURE DIVISION.
INIZIO-PROGRAMMA.
    OPEN INPUT FILE-INPUT.
    IF NOT FS-FILE-OK
        DISPLAY 'ERRORE APERTURA FILE INPUT: ' FS-FILE-INPUT
        GOBACK
    END-IF.

    PERFORM LEGGI-ELABORA-RECORD UNTIL EOF-RAGGIUNTA.

    CLOSE FILE-INPUT.
    GOBACK.

LEGGI-ELABORA-RECORD.
    READ FILE-INPUT
        AT END
            SET EOF-RAGGIUNTA TO TRUE
        NOT AT END
            IF FS-FILE-OK
                PERFORM PROCESSA-RECORD
            ELSE
                DISPLAY 'ERRORE LETTURA FILE INPUT: ' FS-FILE-INPUT
                *> Potrebbe essere necessario gestire l'errore in modo più robusto,
                *> ad esempio terminando il programma o tentando un recupero.
                *> Per semplicità, qui impostiamo EOF per uscire dal ciclo.
                SET EOF-RAGGIUNTA TO TRUE
            END-IF
    END-READ.

PROCESSA-RECORD.
    *> Logica di elaborazione del RECORD-INPUT e inserimento in DB2
    DISPLAY 'Letto record: ' CAMPO-CHIAVE.
    *> ... segue inserimento DB2
Inserimento in Tabella DB2 e Gestione dei Commit
Una volta letto un record, i dati vengono tipicamente inseriti in una tabella DB2. Questa operazione richiede l'uso di SQL embedded in COBOL e una strategia di commit ben definita.
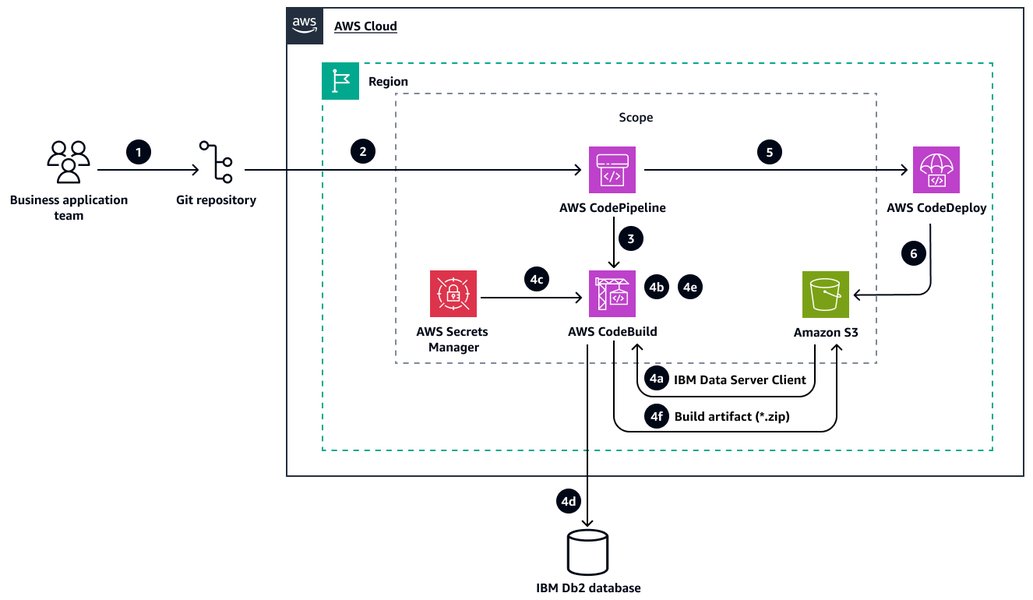
Schema illustrativo dell'interazione tra un programma COBOL e un database DB2.
SQL Embedded per l'Inserimento
Le istruzioni SQL sono incapsulate tra EXEC SQL e END-EXEC. Le variabili COBOL (host variables) vengono utilizzate per passare i dati all'istruzione INSERT.
WORKING-STORAGE SECTION.
*> ... altre variabili ...
01 WS-CONTATORE-COMMIT   PIC S9(05) COMP-3 VALUE 0.
01 WS-FREQUENZA-COMMIT   PIC S9(05) COMP-3 VALUE 1000. *> Commit ogni 1000 record

*> Host variables per DB2
01 HV-RECORD-DB2.
   05 HV-CAMPO-CHIAVE    PIC X(10).
   05 HV-ALTRI-DATI      PIC X(70).

EXEC SQL INCLUDE SQLCA END-EXEC. *> Area di comunicazione SQL

PROCEDURE DIVISION.
*> ...
PROCESSA-RECORD.
    MOVE CAMPO-CHIAVE OF RECORD-INPUT TO HV-CAMPO-CHIAVE.
    MOVE ALTRI-DATI OF RECORD-INPUT TO HV-ALTRI-DATI.

    EXEC SQL
        INSERT INTO NOME_TABELLA (COLONNA_CHIAVE, ALTRA_COLONNA)
        VALUES (:HV-CAMPO-CHIAVE, :HV-ALTRI-DATI)
    END-EXEC.

    IF SQLCODE NOT = ZERO AND SQLCODE NOT = -803 *> -803 è errore di chiave duplicata
        DISPLAY 'ERRORE SQL INSERT: ' SQLCODE
        PERFORM GESTIONE-ERRORE-DB2
    ELSE
        ADD 1 TO WS-CONTATORE-COMMIT
        IF WS-CONTATORE-COMMIT >= WS-FREQUENZA-COMMIT
            PERFORM ESEGUI-COMMIT
        END-IF
    END-IF.

ESEGUI-COMMIT.
    EXEC SQL COMMIT WORK END-EXEC.
    IF SQLCODE NOT = ZERO
        DISPLAY 'ERRORE SQL COMMIT: ' SQLCODE
        PERFORM GESTIONE-ERRORE-DB2
    ELSE
        MOVE ZERO TO WS-CONTATORE-COMMIT
        *> Qui si aggiorna il punto di checkpoint per la ripartenza
        PERFORM AGGIORNA-CHECKPOINT
    END-IF.

GESTIONE-ERRORE-DB2.
    EXEC SQL ROLLBACK WORK END-EXEC.
    DISPLAY 'ROLLBACK ESEGUITO A CAUSA DI ERRORE DB2: ' SQLCODE.
    *> Logica per terminare il programma in modo controllato
    CLOSE FILE-INPUT.
    STOP RUN. *> O GOBACK se chiamato da un altro programma

AGGIORNA-CHECKPOINT.
    *> Logica per salvare l'ultimo CAMPO-CHIAVE processato con successo
    *> o il numero di record processati.
    DISPLAY 'Checkpoint aggiornato dopo commit per record: ' HV-CAMPO-CHIAVE.
La Strategia di Commit
Il COMMIT WORK rende permanenti le modifiche apportate al database (insert, update, delete) e rilascia i lock acquisiti. Eseguire commit periodici (ad esempio, ogni N record) invece che un unico commit alla fine del programma offre diversi vantaggi:
- Riduzione delle Risorse Bloccate: Rilascia i lock più frequentemente, migliorando la concorrenza.
- Log di Database più Piccoli: Evita che i log delle transazioni diventino eccessivamente grandi.
- Punti di Sincronizzazione: Crea "punti di sincronizzazione" (syncpoints) che sono fondamentali per la logica di ripartenza. In caso di errore, il programma può ripartire dall'ultimo commit andato a buon fine.
La frequenza di commit (WS-FREQUENZA-COMMIT) è un parametro cruciale: una frequenza troppo alta può causare overhead, mentre una troppo bassa può portare a lunghe operazioni di rollback e a perdere molto lavoro in caso di fallimento.
Implementazione della Logica di Ripartenza (Restart Logic)
La logica di ripartenza è vitale per i programmi batch che elaborano grandi quantità di dati. Permette al programma, in caso di fallimento (abend), di riprendere l'elaborazione dall'ultimo punto valido, senza riprocessare i dati già committati e senza saltare record.
Principi Fondamentali della Ripartenza
- Checkpointing: Il programma deve salvare periodicamente informazioni sul suo progresso. Questo "checkpoint" di solito corrisponde all'ultimo record processato con successo prima di un
COMMIT. Può essere l'ID univoco dell'ultimo record o il conteggio dei record processati. - Memorizzazione del Checkpoint: Il checkpoint deve essere memorizzato in un luogo persistente, come un piccolo file sequenziale dedicato, una tabella di controllo DB2, o talvolta tramite meccanismi forniti dal gestore di job (es. JCL).
- Logica di Avvio: All'inizio dell'esecuzione, il programma controlla se esiste un checkpoint.
- Se non esiste (prima esecuzione o esecuzione precedente completata con successo), inizia l'elaborazione dal primo record del file di input.
- Se esiste, il programma legge il checkpoint per determinare da dove riprendere.
- Posizionamento nel File di Input: Se si tratta di una ripartenza, il programma deve "saltare" i record del file di input che sono già stati processati e committati. Per file sequenziali, questo significa leggere e scartare record fino a raggiungere quello indicato dal checkpoint. Per file indicizzati o VSAM KSDS, si può usare una chiave per posizionarsi direttamente.
- Ripresa dell'Elaborazione: Una volta posizionato correttamente, il programma riprende il normale ciclo di lettura, elaborazione, inserimento e commit.
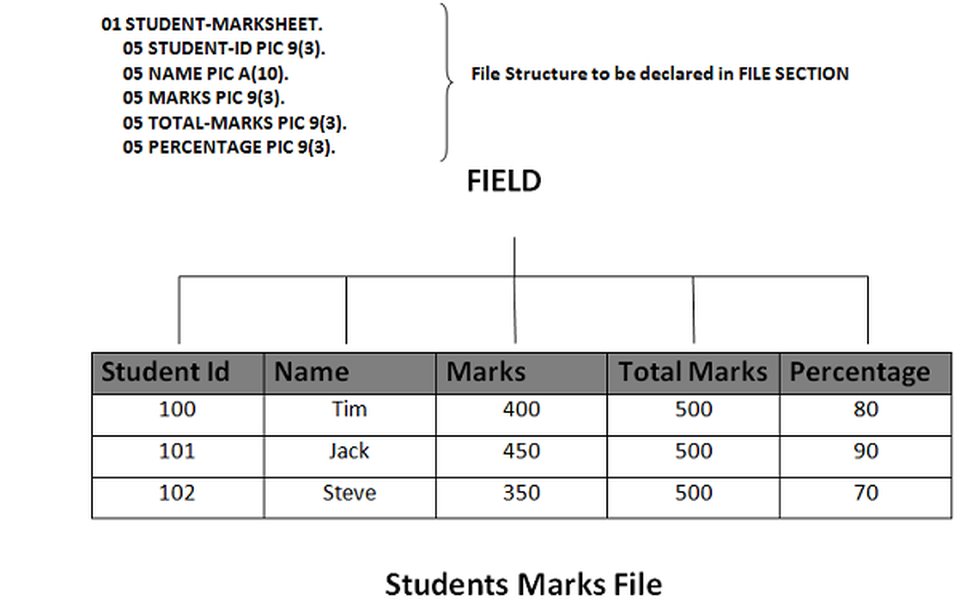
Comprendere la struttura dei record è fondamentale per il checkpointing.
Esempio di Struttura per la Logica di Ripartenza
Si aggiungono sezioni per leggere e scrivere il file di checkpoint. L'esempio seguente usa la chiave del record come punto di ripartenza.
ENVIRONMENT DIVISION.
INPUT-OUTPUT SECTION.
FILE-CONTROL.
    SELECT FILE-INPUT ASSIGN TO 'NOMEFILE.DAT'
        ORGANIZATION IS SEQUENTIAL
        ACCESS MODE IS SEQUENTIAL
        FILE STATUS IS FS-FILE-INPUT.
    SELECT FILE-CHECKPOINT ASSIGN TO 'CHECKPNT.DAT'
        ORGANIZATION IS LINE SEQUENTIAL *> O altra organizzazione idonea
        ACCESS MODE IS SEQUENTIAL
        FILE STATUS IS FS-FILE-CHECKPOINT.
DATA DIVISION.
FILE SECTION.
FD FILE-INPUT
   RECORD CONTAINS 80 CHARACTERS.
01 RECORD-INPUT.
   05 CAMPO-CHIAVE-INPUT  PIC X(10).
   05 ALTRI-DATI-INPUT    PIC X(70).
FD FILE-CHECKPOINT.
01 RECORD-CHECKPOINT.
   05 ULTIMO-CAMPO-CHIAVE-PROCESSATO PIC X(10).
WORKING-STORAGE SECTION.
01 FS-FILE-INPUT         PIC XX.
   88 FS-FILE-OK         VALUE '00'.
   88 FS-FILE-EOF        VALUE '10'.
01 FS-FILE-CHECKPOINT    PIC XX.
   88 FS-CHKPT-OK        VALUE '00'.
   88 FS-CHKPT-NOTFOUND  VALUE '35'. *> Tipico per file non trovato su OPEN I-O
01 WS-EOF-FLAG           PIC X VALUE 'N'.
   88 EOF-RAGGIUNTA      VALUE 'Y'.
01 WS-MODALITA-RIPARTENZA PIC X VALUE 'N'.
   88 IN-RIPARTENZA      VALUE 'Y'.
01 WS-CHIAVE-RIPARTENZA  PIC X(10) VALUE SPACES.
01 WS-CONTATORE-COMMIT   PIC S9(05) COMP-3 VALUE 0.
01 WS-FREQUENZA-COMMIT   PIC S9(05) COMP-3 VALUE 1000.
01 HV-RECORD-DB2.
   05 HV-CAMPO-CHIAVE    PIC X(10).
   05 HV-ALTRI-DATI      PIC X(70).
EXEC SQL INCLUDE SQLCA END-EXEC.

PROCEDURE DIVISION.
INIZIO-PROGRAMMA.
    PERFORM INIZIALIZZA-RIPARTENZA.

    OPEN INPUT FILE-INPUT.
    IF NOT FS-FILE-OK
        DISPLAY 'ERRORE APERTURA FILE INPUT: ' FS-FILE-INPUT
        PERFORM TERMINA-PROGRAMMA-ERRORE
    END-IF.

    IF IN-RIPARTENZA
        PERFORM POSIZIONA-FILE-INPUT
    END-IF.

    PERFORM LEGGI-ELABORA-RECORD UNTIL EOF-RAGGIUNTA.

    PERFORM COMMIT-FINALE-E-RESET-CHECKPOINT.

    CLOSE FILE-INPUT.
    IF FS-CHKPT-OK *> Chiudi solo se aperto con successo
        CLOSE FILE-CHECKPOINT
    END-IF.
    GOBACK.

INIZIALIZZA-RIPARTENZA.
    OPEN I-O FILE-CHECKPOINT.
    IF FS-CHKPT-NOTFOUND
        *> File non esiste, prima esecuzione o checkpoint resettato
        OPEN OUTPUT FILE-CHECKPOINT
        MOVE LOW-VALUES TO ULTIMO-CAMPO-CHIAVE-PROCESSATO *> Valore iniziale basso
        WRITE RECORD-CHECKPOINT
        CLOSE FILE-CHECKPOINT
        OPEN I-O FILE-CHECKPOINT *> Riapri in I-O per letture/scritture successive
    END-IF.

    IF NOT FS-CHKPT-OK
        DISPLAY 'ERRORE CRITICO FILE CHECKPOINT: ' FS-FILE-CHECKPOINT
        STOP RUN *> Fallimento grave, non si può procedere
    END-IF.

    READ FILE-CHECKPOINT INTO RECORD-CHECKPOINT
        AT END *> Improbabile se il file è gestito correttamente
            MOVE LOW-VALUES TO WS-CHIAVE-RIPARTENZA
        NOT AT END
            MOVE ULTIMO-CAMPO-CHIAVE-PROCESSATO TO WS-CHIAVE-RIPARTENZA
            IF WS-CHIAVE-RIPARTENZA NOT = SPACES AND
               WS-CHIAVE-RIPARTENZA NOT = LOW-VALUES
                SET IN-RIPARTENZA TO TRUE
                DISPLAY 'MODALITA RIPARTENZA. ULTIMA CHIAVE: ' WS-CHIAVE-RIPARTENZA
            END-IF
    END-READ.
    *> FILE-CHECKPOINT rimane aperto in I-O per aggiornamenti REWRITE.

POSIZIONA-FILE-INPUT.
    DISPLAY 'POSIZIONAMENTO FILE INPUT DA CHIAVE: ' WS-CHIAVE-RIPARTENZA.
    PERFORM UNTIL EOF-RAGGIUNTA OR CAMPO-CHIAVE-INPUT > WS-CHIAVE-RIPARTENZA
        READ FILE-INPUT INTO RECORD-INPUT
            AT END
                SET EOF-RAGGIUNTA TO TRUE
            NOT AT END
                IF NOT FS-FILE-OK
                    DISPLAY 'ERRORE LETTURA DURANTE POSIZIONAMENTO: ' FS-FILE-INPUT
                    PERFORM TERMINA-PROGRAMMA-ERRORE
                END-IF
        END-READ
    END-PERFORM.
    IF EOF-RAGGIUNTA AND (CAMPO-CHIAVE-INPUT <= WS-CHIAVE-RIPARTENZA OR WS-CHIAVE-RIPARTENZA = HIGH-VALUES)
        DISPLAY 'CHECKPOINT OLTRE EOF O ELABORAZIONE GIA COMPLETATA.'
        *> Potrebbe essere il caso di terminare qui se non ci sono più record da elaborare.
    ELSE IF NOT EOF-RAGGIUNTA
        DISPLAY 'FILE POSIZIONATO A RECORD CON CHIAVE: ' CAMPO-CHIAVE-INPUT
        *> Il record corrente (CAMPO-CHIAVE-INPUT) è il primo da elaborare.
        *> Quindi, rieseguiamo il processa record per questo record.
        PERFORM PROCESSA-RECORD.
    END-IF.


LEGGI-ELABORA-RECORD.
    READ FILE-INPUT INTO RECORD-INPUT
        AT END
            SET EOF-RAGGIUNTA TO TRUE
        NOT AT END
            IF FS-FILE-OK
                PERFORM PROCESSA-RECORD
            ELSE
                DISPLAY 'ERRORE LETTURA FILE INPUT: ' FS-FILE-INPUT
                PERFORM TERMINA-PROGRAMMA-ERRORE
            END-IF
    END-READ.

PROCESSA-RECORD.
    MOVE CAMPO-CHIAVE-INPUT TO HV-CAMPO-CHIAVE.
    MOVE ALTRI-DATI-INPUT TO HV-ALTRI-DATI.

    EXEC SQL
        INSERT INTO NOME_TABELLA (COLONNA_CHIAVE, ALTRA_COLONNA)
        VALUES (:HV-CAMPO-CHIAVE, :HV-ALTRI-DATI)
    END-EXEC.

    IF SQLCODE = ZERO
        ADD 1 TO WS-CONTATORE-COMMIT
    ELSE IF SQLCODE = -803
        *> Chiave duplicata: se in ripartenza e la chiave è <= WS-CHIAVE-RIPARTENZA,
        *> potrebbe essere un record già processato prima di un crash.
        *> La logica qui deve essere robusta. Per semplicità, lo trattiamo come un successo
        *> per il contatore commit, ma NON aggiorniamo il checkpoint con questa chiave.
        DISPLAY 'AVVISO: Chiave duplicata (-803) per ' HV-CAMPO-CHIAVE '. Record possibilmente già inserito.'
        ADD 1 TO WS-CONTATORE-COMMIT *> Considera se contare o meno per il commit
    ELSE
        DISPLAY 'ERRORE SQL INSERT: ' SQLCODE ' PER CHIAVE: ' HV-CAMPO-CHIAVE
        PERFORM GESTIONE-ERRORE-DB2
        EXIT PARAGRAPH *> Esce da PROCESSA-RECORD dopo errore DB2
    END-IF.

    IF WS-CONTATORE-COMMIT >= WS-FREQUENZA-COMMIT
        PERFORM ESEGUI-COMMIT
    END-IF.

ESEGUI-COMMIT.
    EXEC SQL COMMIT WORK END-EXEC.
    IF SQLCODE NOT = ZERO
        DISPLAY 'ERRORE SQL COMMIT: ' SQLCODE
        PERFORM GESTIONE-ERRORE-DB2
    ELSE
        MOVE ZERO TO WS-CONTATORE-COMMIT
        *> Aggiorna checkpoint con l'ULTIMA chiave effettivamente INSERITA E COMMESSA
        MOVE HV-CAMPO-CHIAVE TO ULTIMO-CAMPO-CHIAVE-PROCESSATO IN RECORD-CHECKPOINT.
        PERFORM AGGIORNA-FILE-CHECKPOINT.
    END-IF.

AGGIORNA-FILE-CHECKPOINT.
    REWRITE RECORD-CHECKPOINT.
    IF NOT FS-CHKPT-OK
        DISPLAY 'ERRORE CRITICO AGGIORNAMENTO CHECKPOINT: ' FS-FILE-CHECKPOINT
        PERFORM TERMINA-PROGRAMMA-ERRORE
    END-IF.
    DISPLAY 'CHECKPOINT AGGIORNATO A: ' ULTIMO-CAMPO-CHIAVE-PROCESSATO.

COMMIT-FINALE-E-RESET-CHECKPOINT.
    IF WS-CONTATORE-COMMIT > 0
        EXEC SQL COMMIT WORK END-EXEC
        IF SQLCODE NOT = ZERO
             DISPLAY 'ERRORE COMMIT FINALE: ' SQLCODE
             *> Non resettare il checkpoint se il commit finale fallisce
        ELSE
             MOVE HV-CAMPO-CHIAVE TO ULTIMO-CAMPO-CHIAVE-PROCESSATO IN RECORD-CHECKPOINT.
             PERFORM AGGIORNA-FILE-CHECKPOINT. *> Salva l'ultimo checkpoint
        END-IF
    END-IF.
    *> Resetta il checkpoint per la prossima esecuzione "pulita" solo se tutto è andato bene
    IF SQLCODE = ZERO AND FS-FILE-OK AND FS-CHKPT-OK
        MOVE LOW-VALUES TO ULTIMO-CAMPO-CHIAVE-PROCESSATO.
        REWRITE RECORD-CHECKPOINT.
        IF NOT FS-CHKPT-OK
            DISPLAY 'AVVISO: Errore reset checkpoint finale: ' FS-FILE-CHECKPOINT
        ELSE
            DISPLAY 'CHECKPOINT RESETTATO PER PROSSIMA ESECUZIONE.'
        END-IF.
    END-IF.


GESTIONE-ERRORE-DB2.
    EXEC SQL ROLLBACK WORK END-EXEC.
    DISPLAY 'ROLLBACK ESEGUITO. SQLCODE: ' SQLCODE.
    PERFORM TERMINA-PROGRAMMA-ERRORE.

TERMINA-PROGRAMMA-ERRORE.
    DISPLAY 'ERRORE CRITICO. PROGRAMMA IN TERMINAZIONE.'
    CLOSE FILE-INPUT.
    IF FS-CHKPT-OK OR FS-CHKPT-NOTFOUND = FALSE
        CLOSE FILE-CHECKPOINT.
    END-IF.
    STOP RUN.
Questo esempio è più dettagliato e cerca di gestire alcuni casi limite, ma la logica di ripartenza può diventare molto complessa a seconda dei requisiti specifici, specialmente nella gestione di errori come SQLCODE -803 (chiave duplicata) che possono avere significati diversi in un contesto di ripartenza.
Analisi Comparativa della Frequenza di Commit
La scelta della frequenza di commit influisce su diversi aspetti del programma batch. Un'analisi visiva può aiutare a comprendere questi compromessi. Il seguente grafico radar illustra l'impatto relativo di diverse frequenze di commit (bassa, media, alta) su fattori come le prestazioni, la granularità del riavvio e la complessità.
Interpretazione (scala 1-10, dove 10 è "maggiore impatto/valore"): una bassa frequenza di commit implica minor overhead per singolo commit, ma una granularità di riavvio peggiore (più lavoro perso) e transazioni più lunghe che possono impattare le risorse DB. Una alta frequenza di commit offre un riavvio più preciso e rilascia risorse DB più rapidamente per ogni transazione, ma può introdurre un overhead cumulativo maggiore dovuto ai frequenti cicli di commit/checkpoint.
Mappa Concettuale del Processo
La seguente mappa mentale visualizza il flusso logico complessivo di un programma COBOL-DB2 con gestione dei commit e logica di ripartenza, evidenziando le interdipendenze tra le varie fasi.
Questa mappa illustra come la logica di ripartenza si integra fin dall'inizio del programma e come la gestione dei commit sia strettamente legata all'aggiornamento dei punti di checkpoint.
Componenti Chiave della Logica di Ripartenza
Per una logica di ripartenza efficace, diversi componenti devono lavorare insieme. La tabella seguente riassume gli elementi cruciali e il loro ruolo.
| Componente | Descrizione | Dettaglio Implementativo Tipico |
|---|---|---|
| File/Tabella di Checkpoint | Memorizza l'informazione sull'ultimo punto di elaborazione valido (syncpoint), solitamente l'identificativo dell'ultimo record commesso con successo. | Piccolo file sequenziale (spesso LINE SEQUENTIAL per leggibilità) o tabella DB2 dedicata. Contiene l'ID (o un contatore) dell'ultimo record/gruppo commesso. |
| Frequenza di Commit | Determina ogni quanti record elaborati viene eseguito un COMMIT e, di conseguenza, aggiornato il checkpoint. | Variabile in `WORKING-STORAGE` (es. ogni 100, 1000, o 5000 record), scelta per bilanciare performance e granularità di recupero. |
| Identificatore di Ripartenza | Il valore specifico salvato nel checkpoint (es. chiave primaria del record, numero sequenziale del record, data/ora). | Deve essere univoco e, se possibile, ordinabile per permettere il corretto posizionamento nel file di input. Per file non ordinati, un conteggio di record è più comune. |
| Routine di Inizializzazione | Logica eseguita all'avvio del programma per determinare se si tratta di una ripartenza. | Apre e legge il file/tabella di checkpoint. Se contiene un valore valido (non iniziale/vuoto), imposta una flag di ripartenza e carica l'identificatore. |
| Routine di Posizionamento File | Se in modalità ripartenza, salta i record del file di input già elaborati e commessi. | Per file sequenziali: legge e ignora record fino a trovare quello successivo all'identificatore di ripartenza. Per file indicizzati (es. VSAM KSDS): usa l'istruzione `START` con la chiave. |
| Routine di Aggiornamento Checkpoint | Scrive il nuovo identificatore di ripartenza nel file/tabella di checkpoint dopo ogni `COMMIT WORK` andato a buon fine. | Solitamente un `REWRITE` per file (se aperto in I-O) o `UPDATE`/`INSERT` per tabella DB2. Deve essere atomico o gestito con cura per evitare checkpoint errati. |
| Routine di Gestione Errori | Gestisce errori di I/O del file, errori SQL (controllando `SQLCODE`), o altri fallimenti del programma. Esegue `ROLLBACK WORK` per annullare modifiche non commesse. | Assicura che il programma termini in modo "pulito" senza aggiornare il checkpoint se il commit associato non è avvenuto, preservando così l'integrità per la successiva ripartenza. |
| Reset del Checkpoint | Al termine di un'esecuzione completa e completamente riuscita, il checkpoint viene "resettato" (es. svuotato, impostato a un valore iniziale come LOW-VALUES o zero). | Questo assicura che la prossima esecuzione del programma parta dall'inizio del file di input, a meno che non fallisca nuovamente. |
Video Illustrativo: Lettura di File Sequenziali in COBOL
Per comprendere meglio uno degli aspetti fondamentali, la lettura di file sequenziali in COBOL, il seguente video fornisce una dimostrazione pratica. Sebbene non copra specificamente l'interazione DB2 o la logica di ripartenza complessa, offre una buona base sulla gestione dei file in COBOL, che è il punto di partenza per la nostra elaborazione.
Questo video mostra i concetti base dell'apertura, lettura record per record e chiusura di un file sequenziale, che sono i mattoni su cui si costruisce il ciclo di elaborazione descritto.
Domande Frequenti (FAQ)
Cosa succede se il programma fallisce durante un COMMIT?
Se un programma COBOL-DB2 fallisce durante l'esecuzione di un `EXEC SQL COMMIT WORK`, lo stato della transazione dipende dal punto esatto del fallimento e dalla gestione interna di DB2. Generalmente, DB2 tenterà di completare il commit se l'istruzione è stata ricevuta e iniziata. Se il fallimento avviene prima che DB2 possa garantire la durabilità (es. crash di sistema), DB2 eseguirà un rollback automatico della transazione durante il processo di recovery del database per garantire la consistenza. Il programma COBOL dovrebbe sempre controllare `SQLCODE` dopo l'istruzione `COMMIT`. Se `SQLCODE` indica un fallimento del commit (molto raro, ma possibile per problemi sistemici gravi), il checkpoint non deve essere aggiornato. Alla successiva ripartenza, il programma riprocesserà i record dall'ultimo checkpoint valido, e il gruppo di record il cui commit è fallito verrà ritentato.
Come gestire l'errore SQLCODE -803 (chiave duplicata) in un programma con ripartenza?
L'SQLCODE -803 (tentativo di inserire una riga con una chiave duplicata) in un programma con logica di ripartenza è un caso delicato. Può verificarsi se il programma è fallito dopo aver inserito e committato un gruppo di record, ma prima di aver potuto aggiornare con successo il file/tabella di checkpoint. Alla ripartenza, il programma potrebbe tentare di reinserire questi record. In questo scenario:
- Se il -803 si verifica per un record la cui chiave è uguale o precedente al valore nel checkpoint, potrebbe indicare un problema nella logica di posizionamento o un errore nei dati di input. Questo va investigato.
- Se il -803 si verifica per un record successivo al valore nel checkpoint (cioè, un record che il programma sta tentando di processare "per la prima volta" secondo il checkpoint), allora è un vero errore di duplicazione nei dati di input o un problema logico.
- Una strategia comune è considerare un -803 per la chiave X come "accettabile" solo se il programma è in ripartenza e la chiave X è stata effettivamente l'ultima chiave del blocco precedente il cui commit è riuscito ma il checkpoint non si è aggiornato. In tal caso, si potrebbe "saltare" quel record e procedere. Tuttavia, questo è complesso e rischioso. Una logica più sicura è assicurarsi che l'aggiornamento del checkpoint sia il più vicino possibile e atomico al commit. Se un -803 si verifica, spesso indica un problema che va analizzato piuttosto che ignorato programmaticamente, a meno che la logica di "salto" non sia estremamente ben testata e compresa.
Qual è il modo migliore per memorizzare il checkpoint? File sequenziale o tabella DB2?
Entrambi i metodi hanno pro e contro:
- File Sequenziale Dedicato:
- Pro: Semplice da implementare in COBOL, accesso generalmente veloce per un singolo record di stato, non consuma risorse DB2 aggiuntive per il checkpoint stesso (oltre all'I/O del file). Può essere indipendente dai cicli di backup/recovery del DB2 se gestito separatamente.
- Contro: Potrebbe non essere incluso nei backup standard del database DB2, rendendo il recovery coordinato più complesso. La consistenza tra il checkpoint nel file e lo stato del DB2 dipende interamente dalla logica del programma. Rischio di corruzione del file se il sistema fallisce durante la scrittura.
- Tabella DB2 Dedicata (1 riga per programma/processo):
- Pro: Il checkpoint può far parte della stessa unità di lavoro (transazione) dei dati applicativi se l'UPDATE della tabella di checkpoint è eseguito immediatamente prima del `COMMIT WORK`. Questo garantisce maggiore consistenza. Beneficia delle utility di backup, recovery e consistenza di DB2. Facilmente interrogabile e gestibile esternamente tramite SQL.
- Contro: Aggiunge un piccolo overhead di I/O DB2 (lettura e scrittura) per ogni ciclo di commit. Richiede la definizione di una tabella, indici e permessi.
È possibile utilizzare `START` per posizionare un file sequenziale durante la ripartenza?
L'istruzione `START` in COBOL è utilizzata principalmente per file con accesso indicizzato (come VSAM KSDS - Key Sequenced Data Set) o file con accesso dinamico. Permette di posizionare il puntatore del file su un record specifico basato su una chiave (`KEY IS` clause). Per i file con `ORGANIZATION IS SEQUENTIAL` (file sequenziali puri, come QSAM), l'istruzione `START` non è applicabile. Per questi file, il "posizionamento" durante una ripartenza richiede di leggere e scartare sequenzialmente i record dall'inizio del file fino a raggiungere il punto da cui si desidera riprendere l'elaborazione (cioè, il record immediatamente successivo a quello indicato dal checkpoint). Questo è l'approccio mostrato negli esempi di codice con il loop `PERFORM POSIZIONA-FILE-INPUT`.
Se il file di input fosse un VSAM KSDS (definito con `ORGANIZATION IS INDEXED` e `ACCESS MODE IS SEQUENTIAL` o `DYNAMIC`), allora sì, `START` potrebbe essere usato con la chiave specificata nel `RECORD KEY` per tentare di posizionarsi direttamente, rendendo la fase di riposizionamento molto più efficiente per file di grandi dimensioni.
Ricerche Consigliate
- Come ottimizzare la frequenza di commit in programmi COBOL DB2 per massimizzare le prestazioni e la recuperabilità?
- Quali sono le tecniche avanzate di gestione degli errori SQLCODE, incluso -911 e -913, in programmi batch COBOL DB2?
- Implementare la logica di ripartenza per file VSAM KSDS in COBOL: differenze e vantaggi rispetto ai file sequenziali.
- Utilizzo di tabelle di controllo DB2 versus file flat per il checkpointing in COBOL: analisi comparativa di robustezza e performance.
Riferimenti
Last updated May 8, 2025