
解锁图论奥秘:六大核心算法深度解析
从遍历到最短路径,再到最小生成树,一文掌握图算法精髓。
图论算法亮点一览
- 图遍历基础: 广度优先搜索(BFS)和深度优先搜索(DFS)是探索图结构、查找连通性及路径的基础。
- 最短路径求解: Dijkstra算法解决单源非负权最短路径,Floyd-Warshall算法计算所有顶点对之间的最短路径,可处理负权边(无负环)。
- 网络优化核心: Prim和Kruskal算法用于寻找加权无向图的最小生成树(MST),旨在以最小总成本连接所有顶点。
图算法世界概览:核心概念与应用
图论算法是计算机科学中解决网络结构问题的强大工具。无论是社交网络分析、地图导航、网络路由优化还是电路设计,这些算法都扮演着至关重要的角色。理解它们的工作原理、适用场景和复杂度,是高效解决实际问题的关键。下面,我们将深入探讨六种最常见且重要的图论算法。
应用: 无权图最短路径, 连通性"] id1b["深度优先搜索 (DFS)"] id1b1["特点: 深入分支
应用: 路径查找, 拓扑排序, 环检测"] id2["最短路径 (Shortest Path)"] id2a["Dijkstra 算法"] id2a1["特点: 单源, 非负权
应用: 导航, 路由"] id2b["Floyd-Warshall 算法"] id2b1["特点: 所有顶点对, 可负权 (无负环)
应用: 网络分析"] id3["最小生成树 (MST)"] id3a["Prim 算法"] id3a1["特点: 基于顶点, 稠密图
应用: 网络设计, 布线"] id3b["Kruskal 算法"] id3b1["特点: 基于边, 稀疏图
应用: 网络设计, 聚类"]
上面的思维导图清晰地展示了这六种算法所属的核心领域及其关键特性和应用场景,帮助我们从宏观上理解它们在图论中的定位。
图遍历算法
1. 广度优先搜索 (BFS - Breadth-First Search)
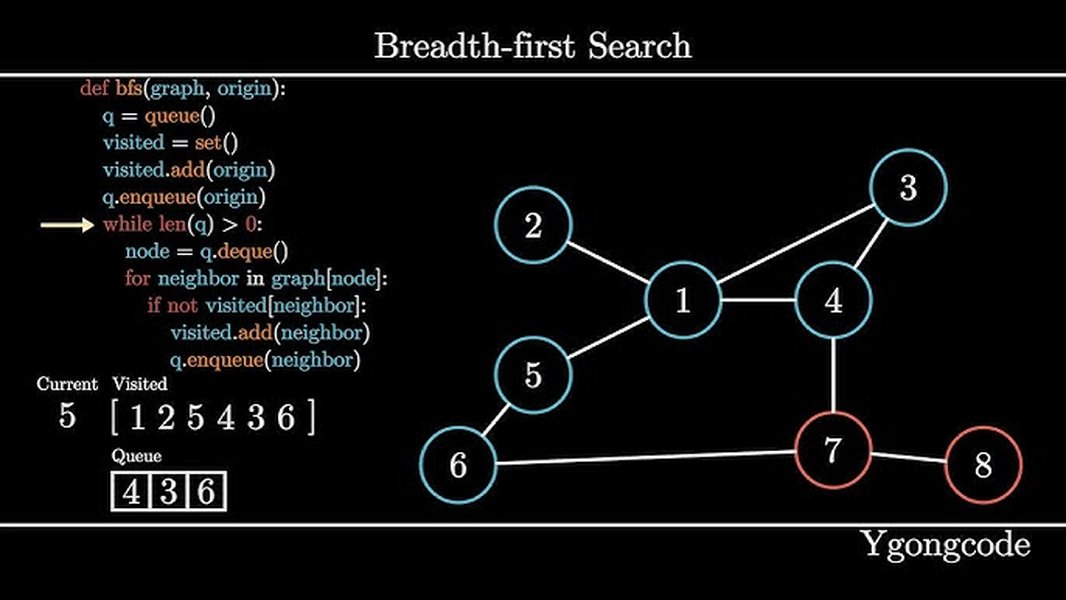
BFS 算法可视化 - 逐层探索图结构
使用范围
BFS 主要用于系统地遍历或搜索图/树结构。它特别适用于查找无权图(或所有边权重相同)中从源节点到其他所有节点的最短路径(以边数衡量)。常见应用包括:
- 寻找两个节点间的最短路径(无权图)。
- 网络爬虫按层级发现网页。
- 社交网络中查找一度、二度好友。
- 检测图的连通分量。
- 判断图是否为二分图。
算法复杂度
- 时间复杂度: O(V + E),其中 V 是顶点数,E 是边数(使用邻接链表)。若使用邻接矩阵,则为 O(V²)。
- 空间复杂度: O(V),主要用于存储访问状态的集合和用于遍历的队列。
算法原理
BFS 算法的核心思想是“逐层探索”。它从一个指定的起始节点开始,首先访问所有与起始节点直接相邻的节点,然后访问与这些相邻节点相邻的所有未访问节点,以此类推,直到图中所有可达节点都被访问过。这个过程依赖于一个队列(先进先出 FIFO)来管理待访问的节点顺序。
- 选择一个起始节点,将其标记为已访问,并放入队列中。
- 当队列不为空时,执行以下操作:
- 从队列头部取出一个节点(当前节点)。
- 访问该节点(例如打印、处理)。
- 查找当前节点的所有未被访问过的邻居节点。
- 将这些未访问的邻居节点标记为已访问,并依次放入队列尾部。
- 当队列为空时,表示所有从起始节点可达的节点均已被访问,遍历结束。
例子说明
考虑一个无向图,节点为 A, B, C, D, E, F,边为 (A, B), (A, C), (B, D), (B, E), (C, F)。从节点 A 开始 BFS:
- 队列: [A], 已访问: {A}
- 取出 A。访问 A。邻居 B, C 未访问。队列: [B, C], 已访问: {A, B, C}
- 取出 B。访问 B。邻居 D, E 未访问。队列: [C, D, E], 已访问: {A, B, C, D, E}
- 取出 C。访问 C。邻居 F 未访问。队列: [D, E, F], 已访问: {A, B, C, D, E, F}
- 取出 D。访问 D。无未访问邻居。队列: [E, F]
- 取出 E。访问 E。无未访问邻居。队列: [F]
- 取出 F。访问 F。无未访问邻居。队列: []
- 队列为空,结束。
访问顺序为 A, B, C, D, E, F。
Python 代码实现
from collections import deque  # 导入双端队列

def bfs(graph, start_node):
    # graph: 图的邻接列表表示 (字典)
    # start_node: BFS 的起始节点

    # 创建一个集合用于存储已访问的节点,避免重复访问和无限循环
    visited = {start_node}
    # 创建一个双端队列,并将起始节点放入队列
    # 队列用于存储待访问的节点,保证广度优先的顺序
    queue = deque([start_node])
    # 创建一个列表,用于存储访问节点的顺序(可选)
    traversal_order = []

    # 当队列不为空时,循环继续
    while queue:
        # 从队列的左侧(头部)取出一个节点进行处理
        current_node = queue.popleft()
        # 将当前处理的节点添加到遍历顺序列表中
        traversal_order.append(current_node)
        # 打印当前访问的节点 (或进行其他处理)
        print(current_node, end=" ")

        # 遍历当前节点的所有邻居节点
        # 使用 graph.get(current_node, []) 安全地获取邻居列表,
        # 如果节点没有邻居(或不在图中),返回空列表
        for neighbor in graph.get(current_node, []):
            # 检查邻居节点是否尚未被访问
            if neighbor not in visited:
                # 如果邻居未被访问,将其标记为已访问
                visited.add(neighbor)
                # 将该邻居节点加入队列的右侧(尾部),等待后续访问
                queue.append(neighbor)

    # 返回遍历顺序 (可选)
    return traversal_order

# 示例图(使用字典表示邻接列表)
graph_example = {
    'A': ['B', 'C'],
    'B': ['A', 'D', 'E'],
    'C': ['A', 'F'],
    'D': ['B'],
    'E': ['B', 'F'],
    'F': ['C', 'E']
}

# 从节点 'A' 开始进行 BFS
print("BFS 从节点 'A' 开始:")
bfs_result = bfs(graph_example, 'A')
print("\n遍历顺序:", bfs_result)
# 输出:
# BFS 从节点 'A' 开始:
# A B C D E F
# 遍历顺序: ['A', 'B', 'C', 'D', 'E', 'F']
2. 深度优先搜索 (DFS - Depth-First Search)
使用范围
DFS 也是一种图遍历算法,但它采用“深入优先”的策略。它沿着一条路径尽可能深地探索,直到到达末端或遇到已访问节点,然后才回溯探索其他分支。DFS 的应用场景包括:
- 检测图中是否存在环。
- 查找图中的路径(不保证最短)。
- 拓扑排序(用于有向无环图 DAG)。
- 查找图的连通分量。
- 解决迷宫问题、八皇后等回溯问题。
算法复杂度
- 时间复杂度: O(V + E)(邻接链表),O(V²)(邻接矩阵)。
- 空间复杂度: O(V),主要取决于递归调用的深度(递归实现)或显式使用的栈的大小(迭代实现)。最坏情况下,栈深度可能为 V。
算法原理
DFS 可以通过递归或栈(后进先出 LIFO)来实现。其核心思想是:
- 选择一个起始节点,标记为已访问。
- 对于当前节点的每一个未访问的邻居节点:
- 递归地对该邻居节点调用 DFS。
- (递归实现)当一个节点的所有邻居都已被访问或递归返回后,函数调用结束,实现回溯。
- (迭代实现)使用栈:
- 将起始节点压入栈。
- 当栈不为空时:弹出栈顶节点,访问它(如果未访问过),标记为已访问,将其所有未访问的邻居压入栈。
这种方式会优先探索一个分支到底,然后再回溯。
例子说明
使用与 BFS 相同的图:节点 A, B, C, D, E, F,边 (A, B), (A, C), (B, D), (B, E), (C, F)。从 A 开始 DFS(递归):
- 访问 A。标记 A 已访问。
- 看 A 的邻居 B。B 未访问,递归 DFS(B)。
- 访问 B。标记 B 已访问。
- 看 B 的邻居 A。A 已访问。
- 看 B 的邻居 D。D 未访问,递归 DFS(D)。
- 访问 D。标记 D 已访问。
- 看 D 的邻居 B。B 已访问。D 无其他未访问邻居,DFS(D) 返回。
- 回到 B。看 B 的邻居 E。E 未访问,递归 DFS(E)。
- 访问 E。标记 E 已访问。
- 看 E 的邻居 B。B 已访问。E 无其他未访问邻居,DFS(E) 返回。
- 回到 B。B 无其他未访问邻居,DFS(B) 返回。
- 回到 A。看 A 的邻居 C。C 未访问,递归 DFS(C)。
- 访问 C。标记 C 已访问。
- 看 C 的邻居 A。A 已访问。
- 看 C 的邻居 F。F 未访问,递归 DFS(F)。
- 访问 F。标记 F 已访问。
- 看 F 的邻居 C。C 已访问。F 无其他未访问邻居,DFS(F) 返回。
- 回到 C。C 无其他未访问邻居,DFS(C) 返回。
- 回到 A。A 无其他未访问邻居,DFS(A) 结束。
一种可能的访问顺序是 A, B, D, E, C, F (具体顺序取决于邻居的遍历顺序)。
Python 代码实现
# --- 递归实现 ---
def dfs_recursive(graph, current_node, visited):
    # graph: 图的邻接列表表示 (字典)
    # current_node: 当前正在访问的节点
    # visited: 存储已访问节点的集合

    # 将当前节点标记为已访问
    visited.add(current_node)
    # 打印当前访问的节点 (或进行其他处理)
    print(current_node, end=" ")

    # 遍历当前节点的所有邻居节点
    # 使用 graph.get(current_node, []) 安全地获取邻居列表
    for neighbor in graph.get(current_node, []):
        # 如果邻居节点未被访问过
        if neighbor not in visited:
            # 递归地对邻居节点调用 DFS
            dfs_recursive(graph, neighbor, visited)

# --- 迭代实现 (使用栈) ---
def dfs_iterative(graph, start_node):
    # graph: 图的邻接列表表示 (字典)
    # start_node: DFS 的起始节点

    # 创建一个集合用于存储已访问的节点
    visited = set()
    # 创建一个栈,并将起始节点放入栈中
    # 栈用于存储待访问的节点,保证深度优先的顺序
    stack = [start_node]

    # 创建一个列表,用于存储访问节点的顺序(可选)
    traversal_order = []

    # 当栈不为空时,循环继续
    while stack:
        # 从栈顶弹出一个节点
        # 注意:pop() 默认移除并返回列表最后一个元素,模拟栈 LIFO
        current_node = stack.pop()

        # 检查弹出的节点是否已被访问
        # 因为一个节点可能被多次加入栈(在其邻居被访问之前)
        if current_node not in visited:
            # 将当前节点标记为已访问
            visited.add(current_node)
            # 将当前处理的节点添加到遍历顺序列表中
            traversal_order.append(current_node)
            # 打印当前访问的节点 (或进行其他处理)
            print(current_node, end=" ")

            # 遍历当前节点的所有邻居节点
            # 注意:为了使迭代 DFS 的输出顺序更接近递归 DFS (通常先访问字典序小的邻居)
            # 我们将邻居节点 *反向* 压入栈中。
            # 例如,如果邻居是 ['B', 'C'],则先压入 'C',再压入 'B'。
            # 这样下次 pop() 时会先弹出 'B'。
            # 使用 reversed() 来反转邻居列表
            for neighbor in reversed(graph.get(current_node, [])):
                # 如果邻居未被访问过
                if neighbor not in visited:
                    # 将未访问的邻居压入栈中
                    stack.append(neighbor)

    # 返回遍历顺序 (可选)
    return traversal_order


# 示例图(与 BFS 相同)
graph_example = {
    'A': ['B', 'C'],
    'B': ['A', 'D', 'E'],
    'C': ['A', 'F'],
    'D': ['B'],
    'E': ['B', 'F'],
    'F': ['C', 'E']
}

# 从节点 'A' 开始进行 DFS (递归)
print("DFS (递归) 从节点 'A' 开始:")
visited_set = set() # 递归调用需要外部传入 visited 集合
dfs_recursive(graph_example, 'A', visited_set)
print("\n")

# 从节点 'A' 开始进行 DFS (迭代)
print("DFS (迭代) 从节点 'A' 开始:")
dfs_iter_result = dfs_iterative(graph_example, 'A')
print("\n遍历顺序 (迭代):", dfs_iter_result)
# 输出 (递归): A B D E F C (可能因字典顺序或实现略有不同)
# 输出 (迭代): A B D E F C (由于反向压栈,顺序与上述递归类似)
# 遍历顺序 (迭代): ['A', 'B', 'D', 'E', 'F', 'C']
最短路径算法
3. Dijkstra 算法
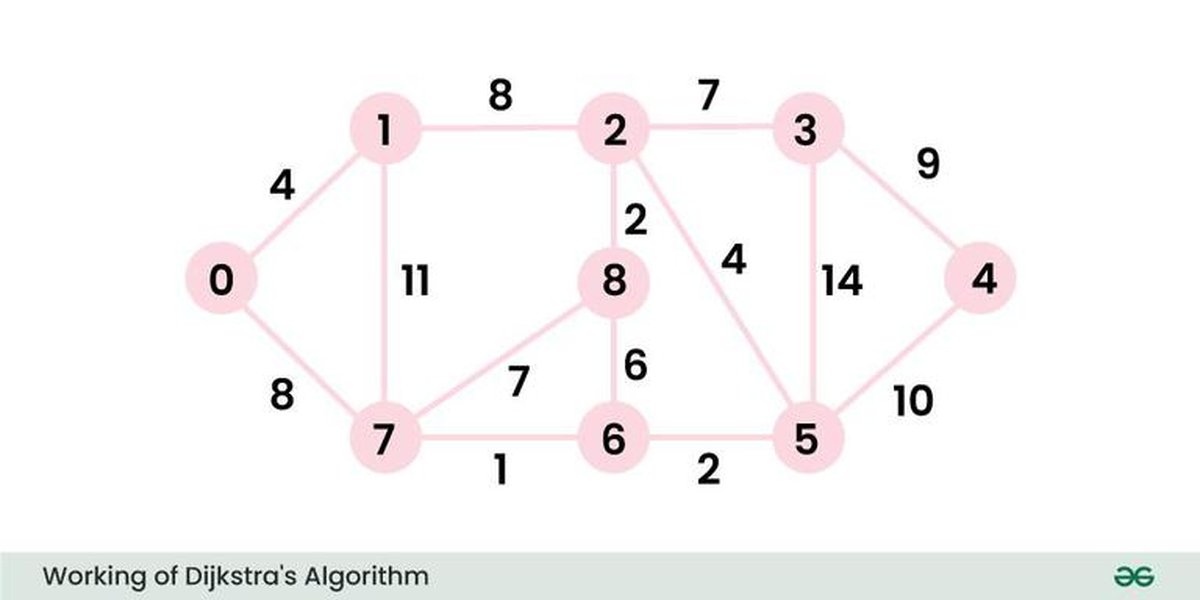
Dijkstra 算法逐步寻找最短路径的过程
使用范围
Dijkstra 算法用于解决带权图中的单源最短路径问题。具体来说,它计算从一个指定的起始节点(源点)到图中所有其他节点的最短路径。该算法的核心要求是图中所有边的权重必须为非负数。其主要应用场景包括:
- 网络路由协议(如 OSPF)。
- 地图导航应用中查找最短(或最快)路线。
- IP 网络中寻找最低延迟路径。
- 资源分配和调度问题。
算法复杂度
- 时间复杂度: 取决于优先队列的实现。
- 使用二叉堆(常用实现):O((E + V) log V) 或 O(E log V)(如果 E > V)。
- 使用斐波那契堆:O(E + V log V)。
- 简单实现(无优先队列,每次线性扫描找最小距离):O(V²)。
- 空间复杂度: O(V + E) 或 O(V),主要用于存储距离、节点访问状态和优先队列。
算法原理
Dijkstra 算法采用贪心策略。它维护一个集合 S,包含已找到最短路径的顶点,以及一个距离数组 dist,记录从源点到每个顶点的当前最短距离估计值。
- 初始化:将源点的距离
dist[source]设为 0,其他所有顶点的距离dist[v]设为无穷大。创建一个优先队列,并将(0, source)加入。 - 循环:当优先队列不为空时:
- 从优先队列中提取具有最小距离
d的顶点u。 - 如果
u已经被访问过(或取出的距离d大于dist[u],表示是旧信息),则跳过。 - 标记
u为已访问(或将其加入集合 S)。 - 对于
u的每一个邻居v:- 松弛操作 (Relaxation):如果通过
u到达v的路径比当前记录的到v的最短路径更短(即dist[u] + weight(u, v) < dist[v]),则更新dist[v] = dist[u] + weight(u, v),并将(dist[v], v)加入(或更新)优先队列。
- 松弛操作 (Relaxation):如果通过
- 从优先队列中提取具有最小距离
- 当优先队列为空或所有可达节点都被访问后,
dist数组就包含了从源点到所有其他节点的最短路径长度。
优先队列确保了每次总是选择当前看来距离源点最近的未确定最短路径的顶点进行扩展。
例子说明
考虑一个有向图:节点 A, B, C, D, E,边权重 (A, B, 4), (A, C, 2), (B, E, 3), (C, D, 2), (C, E, 5), (D, E, 1)。源点为 A。
- 初始化:dist={A:0, B:∞, C:∞, D:∞, E:∞}。优先队列 PQ = [(0, A)]。
- 取出 (0, A)。访问 A。邻居 B, C。
- 松弛 B: dist[B] = 0+4 = 4。PQ = [(4, B)]。
- 松弛 C: dist[C] = 0+2 = 2。PQ = [(2, C), (4, B)]。
- 取出 (2, C)。访问 C。邻居 D, E。
- 松弛 D: dist[D] = 2+2 = 4。PQ = [(4, B), (4, D)]。
- 松弛 E: dist[E] = 2+5 = 7。PQ = [(4, B), (4, D), (7, E)]。
- 取出 (4, B)。访问 B。邻居 E。
- 松弛 E: dist[B]+3 = 4+3 = 7。当前 dist[E]=7,不更新。PQ = [(4, D), (7, E)]。
- 取出 (4, D)。访问 D。邻居 E。
- 松弛 E: dist[D]+1 = 4+1 = 5。当前 dist[E]=7,更新 dist[E]=5。PQ = [(5, E), (7, E)]。
- 取出 (5, E)。访问 E。无邻居。PQ = [(7, E)]。
- 取出 (7, E)。此 E 的距离 7 > dist[E]=5,忽略。PQ = []。
- 队列为空,结束。
最终最短距离:dist = {A: 0, B: 4, C: 2, D: 4, E: 5}。
Python 代码实现
import heapq  # 导入 heapq 模块,用于实现优先队列(最小堆)

def dijkstra(graph, start_node):
    # graph: 加权图的表示,通常是字典的字典或字典的列表
    #   例如: {'A': {'B': 4, 'C': 2}, 'B': {'E': 3}, ...}
    #   或者: {'A': [('B', 4), ('C', 2)], 'B': [('E', 3)], ...}
    # start_node: 起始节点

    # 初始化距离字典,所有节点的距离默认为无穷大
    distances = {node: float('inf') for node in graph}
    # 起始节点到自身的距离为 0
    distances[start_node] = 0

    # 创建一个优先队列(最小堆),存储元组 (距离, 节点)
    # heapq 默认是最小堆,所以距离小的元组会优先被弹出
    priority_queue = [(0, start_node)]

    # 当优先队列不为空时,循环继续
    while priority_queue:
        # 从优先队列中弹出具有最小距离的节点
        # heapq.heappop() 弹出并返回堆中最小的元素
        current_distance, current_node = heapq.heappop(priority_queue)

        # 优化:如果弹出的距离大于已记录的该节点的最短距离,
        # 说明这是一个过时(较长路径)的信息,直接跳过
        # 这可以避免处理冗余的、更长的路径
        if current_distance > distances[current_node]:
            continue

        # 遍历当前节点的所有邻居及其对应的边的权重
        # 使用 graph.get(current_node, {}) 或类似方式安全访问邻居
        # 这里假设 graph[current_node] 返回邻居和权重的字典或列表
        # 示例使用字典: {'B': 4, 'C': 2}
        for neighbor, weight in graph.get(current_node, {}).items():
        # 或者如果用元组列表: for neighbor, weight in graph.get(current_node, []):

            # 计算通过当前节点到达邻居节点的总距离
            distance = current_distance + weight

            # 松弛操作:如果新计算出的距离比已记录的到邻居的距离短
            if distance < distances[neighbor]:
                # 更新到邻居节点的最短距离
                distances[neighbor] = distance
                # 将更新后的 (距离, 邻居节点) 推入优先队列
                heapq.heappush(priority_queue, (distance, neighbor))

    # 循环结束后,distances 字典包含了从起始节点到所有其他节点的最短距离
    return distances

# 示例有向图(使用字典表示,键是节点,值是邻居及其权重的字典)
graph_example = {
    'A': {'B': 4, 'C': 2},
    'B': {'E': 3},
    'C': {'D': 2, 'E': 5},
    'D': {'E': 1},
    'E': {} # E 没有出边
}

# 添加图中所有节点,确保即使没有出边的节点也在 distances 字典中初始化
all_nodes = set(graph_example.keys())
for neighbors in graph_example.values():
    all_nodes.update(neighbors.keys())
# 为方便,直接从 graph 的键创建完整图节点字典
full_graph_representation = {node: graph_example.get(node, {}) for node in all_nodes}


# 从节点 'A' 开始应用 Dijkstra 算法
start = 'A'
shortest_paths = dijkstra(full_graph_representation, start)

print(f"从节点 '{start}' 开始的最短距离:")
# 打印结果
for node, distance in shortest_paths.items():
    print(f"到节点 '{node}': {distance if distance != float('inf') else '不可达'}")

# 输出:
# 从节点 'A' 开始的最短距离:
# 到节点 'A': 0
# 到节点 'C': 2
# 到节点 'B': 4
# 到节点 'D': 4
# 到节点 'E': 5
4. Floyd-Warshall 算法
使用范围
Floyd-Warshall 算法用于解决所有顶点对之间的最短路径问题。与 Dijkstra 不同,它可以处理带有负权重的边,但前提是图中不能包含负权重环(负环会导致最短路径无限小)。如果图中存在负环,该算法可以检测出来。它适用于:
- 计算任意两个城市之间的最短行车距离。
- 计算网络中所有节点对之间的最小延迟。
- 传递闭包问题(判断节点间是否存在路径)。
- 适合稠密图,因为其复杂度不依赖于边数 E。
算法复杂度
- 时间复杂度: O(V³),因为算法包含三层嵌套循环,遍历所有可能的起点、终点和中间点组合。
- 空间复杂度: O(V²),用于存储记录所有顶点对之间距离的二维矩阵。
算法原理
Floyd-Warshall 算法基于动态规划思想。它维护一个二维数组(距离矩阵)dist[i][j],存储从顶点 i 到顶点 j 的当前已知最短路径长度。算法的核心思想是:对于任意一对顶点 i 和 j,它们之间的最短路径要么是直接相连的边(如果存在),要么是经过某个中间顶点 k 的路径 (i -> k -> j)。
- 初始化:创建一个 V x V 的距离矩阵
dist。- 对于所有
i,dist[i][i] = 0。 - 对于图中存在的边
(i, j),dist[i][j] = weight(i, j)。 - 对于图中不存在直接边的顶点对
(i, j),dist[i][j] = ∞。
- 对于所有
- 迭代:进行 V 次迭代,每次迭代考虑一个顶点
k(从 0 到 V-1) 作为可能的中间顶点。- 对于所有顶点对
(i, j):- 检查通过中间顶点
k的路径 (dist[i][k] + dist[k][j]) 是否比当前记录的dist[i][j]更短。 - 如果
dist[i][k] + dist[k][j] < dist[i][j],则更新dist[i][j] = dist[i][k] + dist[k][j]。
- 检查通过中间顶点
- 对于所有顶点对
- 结束后,
dist[i][j]就存储了从顶点i到顶点j的最短路径长度。 - (可选)检测负环:如果在算法结束后,存在某个顶点
i使得dist[i][i] < 0,则图中存在负权重环。
例子说明
考虑一个有向图,节点 0, 1, 2, 3。权重矩阵如下 (∞ 表示无直接边):
  0  1  2  3
0[0, 5, ∞, 10]
1[∞, 0, 3, ∞]
2[∞, ∞, 0, 1]
3[∞, ∞, ∞, 0]
应用 Floyd-Warshall:
- 初始 D⁰: (同上)
- k=0: (无变化,因为没有 i->0->j 的路径能缩短现有路径)
- k=1: 考虑通过 1 的路径。
dist[0][2]= min(∞, dist[0][1] + dist[1][2]) = min(∞, 5 + 3) = 8.
- k=2: 考虑通过 2 的路径。
dist[0][3]= min(10, dist[0][2] + dist[2][3]) = min(10, 8 + 1) = 9.dist[1][3]= min(∞, dist[1][2] + dist[2][3]) = min(∞, 3 + 1) = 4.
- k=3: 考虑通过 3 的路径 (无更短路径被发现)。 D³ = D²
最终矩阵 D³ 包含所有顶点对的最短路径。
Python 代码实现
import itertools  # 可选,用于简化循环

# 定义无穷大
INF = float('inf')

def floyd_warshall(graph_matrix):
    # graph_matrix: 图的邻接矩阵表示,大小为 V x V
    # graph_matrix[i][j] 是从节点 i 到节点 j 的直接边的权重
    # 如果没有直接边,则为 INF;对角线元素 graph_matrix[i][i] 通常为 0

    # 获取顶点数量 (假设矩阵是方形的)
    num_vertices = len(graph_matrix)

    # 创建距离矩阵的副本,算法将在此副本上操作
    # 直接修改输入矩阵可能不是好的做法,除非明确说明
    dist = [row[:] for row in graph_matrix]

    # 核心的三重循环
    # k 是允许使用的中间节点的索引 (从 0 到 num_vertices - 1)
    for k in range(num_vertices):
        # i 是起始节点的索引
        for i in range(num_vertices):
            # j 是结束节点的索引
            for j in range(num_vertices):
                # 松弛操作:检查通过中间节点 k 的路径是否更短
                # 需要确保 dist[i][k] 和 dist[k][j] 都不是无穷大
                # 因为无穷大加任何数仍然是无穷大
                if dist[i][k] != INF and dist[k][j] != INF:
                    # 如果从 i 到 k 再到 j 的路径长度小于当前记录的 i 到 j 的路径长度
                    if dist[i][k] + dist[k][j] < dist[i][j]:
                        # 更新从 i 到 j 的最短路径长度
                        dist[i][j] = dist[i][k] + dist[k][j]

    # (可选) 检测负权重环
    # 如果图中存在负环,某些从节点到自身的距离会变成负数
    for i in range(num_vertices):
        if dist[i][i] < 0:
            print("图中检测到负权重环!")
            # 根据需要,可以返回特殊值或抛出异常
            # return None

    # 返回计算得到的所有顶点对之间的最短路径距离矩阵
    return dist

# 示例图的邻接矩阵表示 (对应上面例子的图)
# 节点 0, 1, 2, 3
graph_adj_matrix = [
    [0, 5, INF, 10], # 从节点 0 出发
    [INF, 0, 3, INF], # 从节点 1 出发
    [INF, INF, 0, 1], # 从节点 2 出发
    [INF, INF, INF, 0]  # 从节点 3 出发
]

# 调用 Floyd-Warshall 算法
shortest_paths_matrix = floyd_warshall(graph_adj_matrix)

# 打印结果矩阵
print("所有顶点对之间的最短路径矩阵:")
if shortest_paths_matrix:
    for row in shortest_paths_matrix:
        # 格式化输出,将 INF 替换为易读的符号
        print([val if val != INF else "INF" for val in row])

# 输出:
# 所有顶点对之间的最短路径矩阵:
# [0, 5, 8, 9]
# ['INF', 0, 3, 4]
# ['INF', 'INF', 0, 1]
# ['INF', 'INF', 'INF', 0]

# 示例:包含负权边但无负环的图
graph_neg_edge = [
    [0, 1, -3, INF],
    [INF, 0, 2, INF],
    [INF, INF, 0, 4],
    [INF, INF, INF, 0]
]
print("\n包含负权边的图的最短路径矩阵:")
result_neg_edge = floyd_warshall(graph_neg_edge)
if result_neg_edge:
    for row in result_neg_edge:
        print([val if val != INF else "INF" for val in row])
# 输出应为:
# [0, 1, -3, 1]
# ['INF', 0, 2, 6]
# ['INF', 'INF', 0, 4]
# ['INF', 'INF', 'INF', 0]

# 示例:包含负权环的图 (1 -> 0 权重 -2)
graph_neg_cycle = [
    [0, 1],
    [-2, 0]
]
print("\n包含负权环的图示例:")
floyd_warshall(graph_neg_cycle) # 应打印负环警告
最小生成树 (MST) 算法
5. Prim 算法
使用范围
Prim 算法用于在加权的、无向的、连通的图中查找最小生成树 (Minimum Spanning Tree, MST)。MST 是原图的一个子图,它包含原图的所有顶点,并且是一棵树(无环),其所有边的权重之和最小。Prim 算法是一种贪心算法,它从一个顶点开始,逐步将最近的顶点和边添加到 MST 中。适用于:
- 网络设计:设计成本最低的通信网络连接所有地点。
- 电路布线:在电路板上连接所有引脚的最小总线长度。
- 聚类分析。
- Prim 算法在稠密图(边数接近 V²)上通常比 Kruskal 更有效率(使用斐波那契堆时)。
算法复杂度
- 时间复杂度: 取决于优先队列实现。
- 使用二叉堆:O(E log V)。
- 使用斐波那契堆:O(E + V log V)。
- 简单实现(邻接矩阵,每次线性扫描):O(V²)。
- 空间复杂度: O(V + E) 或 O(V),用于存储 MST 状态、优先队列等。
算法原理
Prim 算法维护两个集合:一个是已经包含在 MST 中的顶点集合(称为 mst_set),另一个是尚未包含的顶点集合。算法执行以下步骤:
- 初始化:选择任意一个顶点作为起始点,将其加入
mst_set。维护一个key数组,key[v]存储顶点v连接到mst_set中某个顶点的边的最小权重(初始时,源点为 0,其他为 ∞)。可能还需要一个parent数组记录连接边。可以使用优先队列存储(key[v], v)。 - 循环:重复 V 次(或直到优先队列为空):
- 从优先队列中(或从未在
mst_set中的顶点中)选出key值最小的顶点u。 - 将
u加入mst_set。将连接u和其parent[u]的边(如果需要记录具体边的话)加入 MST 结果集。 - 对于
u的每一个邻居v,如果v不在mst_set中,并且边(u, v)的权重小于当前记录的key[v]:- 更新
key[v] = weight(u, v)。 - 更新
parent[v] = u。 - 更新优先队列中
v的值(或将其加入,如果用的是支持 decrease-key 操作的堆,则效率更高)。
- 更新
- 从优先队列中(或从未在
- 算法结束后,
parent数组(或记录的边集)定义了最小生成树。
核心思想是:在每一步都将离当前已构建树最近(边权重最小)的那个顶点及其连接边纳入树中。
例子说明
考虑一个加权无向图:(A, B, 4), (A, C, 4), (B, C, 2), (C, D, 3), (C, F, 2), (D, F, 3), (D, E, 1), (E, F, 6)。从 A 开始。
- 初始化:MST={A}。边到 MST 外:(A, B, 4), (A, C, 4)。选 A。Key={A:0, B:4, C:4, D:∞, E:∞, F:∞}。PQ = [(4, B), (4, C)]。
- 取 (4, B)。MST={A, B}。边:(A, B)。看 B 的邻居 C。边 (B, C, 2)。Key[C]=min(4, 2)=2。更新 C 的 key 和 parent。PQ = [(2, C), (4, C)-旧]。看 D。边 (B, D, 2)。Key[D]=2。PQ=[(2, C), (2, D), (4, C)-旧]。
- 取 (2, C)。MST={A, B, C}。边:(B, C)。看 C 的邻居 D, F。边 (C, D, 3)。Key[D]=min(2, 3)=2 (不变)。边 (C, F, 2)。Key[F]=2。PQ = [(2, D), (2, F)]。
- 取 (2, D)。MST={A, B, C, D}。边:(C, D) 或 (B, D) - 取决于 PQ 取出顺序,假设是 (B, D)。看 D 邻居 E, F。边 (D, E, 1)。Key[E]=1。边 (D, F, 3)。Key[F]=min(2, 3)=2 (不变)。PQ = [(1, E), (2, F)]。
- 取 (1, E)。MST={A, B, C, D, E}。边:(D, E)。看 E 邻居 F。边 (E, F, 6)。Key[F]=min(2, 6)=2 (不变)。PQ = [(2, F)]。
- 取 (2, F)。MST={A, B, C, D, E, F}。边:(C, F)。所有顶点加入。结束。
MST 边集(一种可能):{(A, B, 4), (B, C, 2), (B, D, 2), (D, E, 1), (C, F, 2)}。总权重 11。(注:例子中若 B-D 权重不同,结果会变)。如果按上面文字描述过程,选 (C,D,3) 和 (C,F,2) 会得到不同的树,但总权重可能相同。精确实现需严格按 key 值和优先队列。
Python 代码实现 (使用优先队列)
import heapq # 导入 heapq 模块实现优先队列 def prim(graph): # graph: 加权无向图的邻接列表表示 # 例如: {'A': {'B': 4, 'C': 4}, 'B': {'A': 4, 'C': 2, 'D': 2}, ...} # 注意:无向图,边需要在两端都表示 # 获取图中所有节点 nodes = list(graph.keys()) # 如果图为空,返回空结果 if not nodes: return [], 0 # 选择一个起始节点(可以是任意节点) start_node = nodes[0] # <code>visited集合存储已加入 MST 的节点 visited = {start_node} #mst_edges列表存储构成 MST 的边 (u, v, weight) mst_edges = [] #total_weight记录 MST 的总权重 total_weight = 0 # 优先队列edges_heap存储待考虑的边 (weight, from_node, to_node) # 初始将起始节点的所有邻边加入优先队列 edges_heap = [] for neighbor, weight in graph.get(start_node, {}).items(): # 将 (权重, 起始节点, 邻居节点) 元组推入堆 heapq.heappush(edges_heap, (weight, start_node, neighbor)) # 当 MST 包含的节点数小于图中总节点数时,继续循环 # 或者判断当优先队列不为空时继续,并检查节点数 while edges_heap and len(visited) < len(nodes): # 从优先队列中弹出权重最小的边 weight, from_node, to_node = heapq.heappop(edges_heap) # 检查边的目标节点to_node是否已经被访问过 # 如果已访问,说明加入这条边会形成环,跳过 if to_node in visited: continue # 如果to_node未被访问,则将其加入 MST # 将to_node加入已访问集合 visited.add(to_node) # 将这条边加入 MST 边列表 mst_edges.append((from_node, to_node, weight)) # 累加总权重 total_weight += weight # 探索新加入节点to_node的所有邻边 for next_neighbor, next_weight in graph.get(to_node, {}).items(): # 如果邻居next_neighbor尚未加入 MST (未访问) if next_neighbor not in visited: # 将连接to_node和next_neighbor的边加入优先队列 heapq.heappush(edges_heap, (next_weight, to_node, next_neighbor)) # 检查是否所有节点都被包含(图是否连通) if len(visited) != len(nodes): print("图不连通,找到的是最小生成森林的一部分。") # 返回当前找到的部分 # 返回 MST 的边列表和总权重 return mst_edges, total_weight # 示例加权无向图 (确保双向表示) graph_prim_example = { 'A': {'B': 4, 'C': 4}, 'B': {'A': 4, 'C': 2, 'D': 2}, 'C': {'A': 4, 'B': 2, 'D': 3, 'F': 2}, 'D': {'B': 2, 'C': 3, 'F': 3, 'E': 1}, 'E': {'D': 1, 'F': 6}, 'F': {'C': 2, 'D': 3, 'E': 6} } # 调用 Prim 算法 minimum_spanning_tree, mst_total_weight = prim(graph_prim_example) print("Prim 算法找到的最小生成树边:") for u, v, w in minimum_spanning_tree: print(f"边: {u} - {v}, 权重: {w}") print(f"最小生成树的总权重: {mst_total_weight}") # 输出: (边的顺序和具体选择可能因起始点和堆实现略有不同,但总权重应相同) # Prim 算法找到的最小生成树边: # 边: A - B, 权重: 4 (或 A-C) # 边: B - C, 权重: 2 # 边: B - D, 权重: 2 # 边: C - F, 权重: 2 # 边: D - E, 权重: 1 # 最小生成树的总权重: 11
6. Kruskal 算法
使用范围
Kruskal 算法也是用于在加权的、无向的、连通的图中查找最小生成树 (MST)。与 Prim 不同,Kruskal 是一种基于边的贪心算法。它不需要指定起始点,而是按权重从小到大依次考虑图中的所有边。适用于:
- 同样适用于网络设计、电路布线等场景。
- Kruskal 算法在稀疏图(边数 E 远小于 V²)上通常更有效率,因为其复杂度主要取决于边的排序。
- 可以用于查找最小生成森林(如果图不连通)。
算法复杂度
- 时间复杂度: O(E log E) 或 O(E log V)。主要瓶颈在于对所有 E 条边进行排序。并查集(Disjoint Set Union, DSU)操作(带路径压缩和按秩合并优化)的平均时间复杂度接近常数 O(α(V)),其中 α 是反阿克曼函数,增长极其缓慢,总 DSU 时间接近 O(E α(V))。因此,排序是主导因素。
- 空间复杂度: O(V + E),用于存储边列表和并查集数据结构。
算法原理
Kruskal 算法的思路是:不断选择当前权重最小且不会形成环的边加入到 MST 中,直到加入了 V-1 条边。
- 初始化:创建一个包含图中所有边的列表,并按权重从小到大排序。创建一个空的 MST 边集。初始化一个并查集(DSU)数据结构,其中每个顶点最初都属于自己的独立集合。
- 遍历排序后的边列表:对于列表中的每一条边
(u, v),权重为w:- 使用并查集的
find操作检查顶点u和v是否属于同一个集合(连通分量)。 - 如果
find(u)不等于find(v),说明u和v不在同一个连通分量中,加入这条边不会形成环。- 将边
(u, v, w)加入 MST 边集。 - 使用并查集的
union操作合并u和v所在的集合。
- 将边
- 如果
find(u)等于find(v),说明加入这条边会形成环,则忽略这条边。
- 使用并查集的
- 当 MST 边集中包含 V-1 条边时(对于连通图),算法结束。如果图不连通,算法会在遍历完所有边后结束,结果是一个最小生成森林。
并查集数据结构是 Kruskal 算法高效实现的关键,它能快速判断两个顶点是否已连通,以及合并它们的连通分量。
例子说明
使用与 Prim 相同的图。边按权重排序:(D, E, 1), (B, C, 2), (C, F, 2), (B, D, 2), (C, D, 3), (D, F, 3), (A, B, 4), (A, C, 4), (E, F, 6)。顶点数 V=6。
初始化并查集:{A}, {B}, {C}, {D}, {E}, {F}。MST 边数 = 0。
- 考虑 (D, E, 1)。find(D) != find(E)。加入 MST。Union(D, E)。集合: {A}, {B}, {C}, {D, E}, {F}。边数=1。
- 考虑 (B, C, 2)。find(B) != find(C)。加入 MST。Union(B, C)。集合: {A}, {B, C}, {D, E}, {F}。边数=2。
- 考虑 (C, F, 2)。find(C) != find(F)。加入 MST。Union(C, F)。集合: {A}, {B, C, F}, {D, E}。边数=3。
- 考虑 (B, D, 2)。find(B) != find(D)。加入 MST。Union(B, D)。集合: {A}, {B, C, F, D, E}。边数=4。
- 考虑 (C, D, 3)。find(C) == find(D) (都在 {B, C, F, D, E} 中)。忽略,形成环。
- 考虑 (D, F, 3)。find(D) == find(F)。忽略。
- 考虑 (A, B, 4)。find(A) != find(B)。加入 MST。Union(A, B)。集合: {A, B, C, F, D, E}。边数=5。
- MST 包含 V-1 = 5 条边。结束。
MST 边集:{(D, E, 1), (B, C, 2), (C, F, 2), (B, D, 2), (A, B, 4)}。总权重 11。
Python 代码实现 (使用并查集)
# 定义并查集 (Disjoint Set Union - DSU) 类
class UnionFind:
    def __init__(self, vertices):
        # 初始化父节点字典,每个节点的父节点初始是它自己
        self.parent = {v: v for v in vertices}
        # 初始化秩(或大小)字典,用于按秩(或大小)合并优化,提高效率
        self.rank = {v: 0 for v in vertices} # 或者用 size = {v: 1 for v in vertices}

    # 查找元素所属集合的代表(根节点),并进行路径压缩优化
    def find(self, item):
        # 如果当前节点的父节点不是它自己,说明它不是根节点
        if self.parent[item] != item:
            # 递归查找根节点,并将路径上所有节点的父节点直接指向根节点(路径压缩)
            self.parent[item] = self.find(self.parent[item])
        # 返回根节点
        return self.parent[item]

    # 合并两个元素所在的集合(按秩合并优化)
    def union(self, set1_item, set2_item):
        # 找到两个元素各自所在集合的根节点
        root1 = self.find(set1_item)
        root2 = self.find(set2_item)

        # 如果两个根节点不同,说明它们不在同一个集合,可以合并
        if root1 != root2:
            # 按秩合并:将秩小的树合并到秩大的树上
            if self.rank[root1] < self.rank[root2]:
                # 将 root1 的父节点设为 root2
                self.parent[root1] = root2
            elif self.rank[root1] > self.rank[root2]:
                # 将 root2 的父节点设为 root1
                self.parent[root2] = root1
            else:
                # 如果秩相等,任选一个作为另一个的父节点,并将新根的秩加 1
                self.parent[root2] = root1
                self.rank[root1] += 1
            # 返回 True 表示成功合并
            return True
        # 如果根节点相同,说明已在同一集合,不合并,返回 False
        return False

def kruskal(graph):
    # graph: 加权无向图的邻接列表表示 (同 Prim)

    # 获取所有顶点
    vertices = list(graph.keys())
    # 创建边列表,存储 (权重, 节点1, 节点2)
    edges = []
    # 使用集合记录已添加的边,避免无向图边重复添加 (如 A-B 和 B-A)
    added_edges = set()

    # 遍历图的邻接列表,提取所有边
    for node, neighbors in graph.items():
        for neighbor, weight in neighbors.items():
            # 对节点对排序,确保 (u, v) 和 (v, u) 只被记录一次
            edge_tuple = tuple(sorted((node, neighbor)))
            if edge_tuple not in added_edges:
                edges.append((weight, node, neighbor))
                added_edges.add(edge_tuple)

    # 按边的权重从小到大排序
    edges.sort()

    # 初始化并查集结构,包含图中所有顶点
    disjoint_set = UnionFind(vertices)

    # 创建列表存储 MST 的边
    mst_edges = []
    # 记录 MST 的总权重
    total_weight = 0

    # 遍历排序后的边列表
    for weight, node1, node2 in edges:
        # 尝试合并这条边的两个端点所在的集合
        # union 方法会检查它们是否已在同一集合,如果是则返回 False
        if disjoint_set.union(node1, node2):
            # 如果成功合并(即加入此边不形成环)
            # 将这条边加入 MST 结果列表
            mst_edges.append((node1, node2, weight))
            # 累加总权重
            total_weight += weight

            # 优化:如果 MST 已包含 V-1 条边,则对于连通图,MST 已构建完成,可以提前结束
            if len(mst_edges) == len(vertices) - 1:
                break # 提前退出循环

    # 检查 MST 是否完整(对于连通图)
    if len(mst_edges) != len(vertices) - 1 and len(vertices) > 1:
         print("图不连通,找到的是最小生成森林。")

    # 返回 MST 的边列表和总权重
    return mst_edges, total_weight

# 使用与 Prim 相同的示例图
graph_kruskal_example = {
    'A': {'B': 4, 'C': 4},
    'B': {'A': 4, 'C': 2, 'D': 2},
    'C': {'A': 4, 'B': 2, 'D': 3, 'F': 2},
    'D': {'B': 2, 'C': 3, 'F': 3, 'E': 1},
    'E': {'D': 1, 'F': 6},
    'F': {'C': 2, 'D': 3, 'E': 6}
}

# 调用 Kruskal 算法
minimum_spanning_tree_k, mst_total_weight_k = kruskal(graph_kruskal_example)

print("Kruskal 算法找到的最小生成树边:")
for u, v, w in minimum_spanning_tree_k:
    print(f"边: {u} - {v}, 权重: {w}")

print(f"最小生成树的总权重: {mst_total_weight_k}")

# 输出: (边的顺序可能不同,但集合和总权重应与 Prim 相同)
# Kruskal 算法找到的最小生成树边:
# 边: D - E, 权重: 1
# 边: B - C, 权重: 2
# 边: C - F, 权重: 2
# 边: B - D, 权重: 2
# 边: A - B, 权重: 4
# 最小生成树的总权重: 11
算法特性对比
为了更直观地比较这些算法的关键特性,下面的雷达图和表格提供了一个概览。
雷达图从多个维度(数值越高通常表示越优或能力越强,但需结合标签理解)比较了六种算法。例如,“处理负权边能力”维度上,Floyd-Warshall得分高,而Dijkstra得分低。
| 算法 | 类型 | 图类型 | 时间复杂度 (邻接表, 常用) | 空间复杂度 | 处理负权边? |
|---|---|---|---|---|---|
| BFS | 遍历 | 无权/等权, 有向/无向 | O(V + E) | O(V) | 不适用 (按层数) |
| DFS | 遍历 | 有向/无向 | O(V + E) | O(V) | 不适用 (路径查找) |
| Dijkstra | 单源最短路径 | 加权 (非负), 有向/无向 | O(E log V) 或 O((E+V)logV) | O(V) 或 O(V+E) | 否 |
| Floyd-Warshall | 所有顶点对最短路径 | 加权, 有向/无向 | O(V³) | O(V²) | 是 (无负环) |
| Prim | 最小生成树 | 加权, 无向, 连通 | O(E log V) | O(V) 或 O(V+E) | 不适用 (MST 通常无负权) |
| Kruskal | 最小生成树 | 加权, 无向, 连通 | O(E log E) 或 O(E log V) | O(V + E) | 不适用 (MST 通常无负权) |
上表总结了各算法的核心信息,便于快速查阅和对比。
相关视频教程
想要更深入地理解图论算法及其在计算机科学中的应用吗?下面的视频提供了一个全面的介绍,由谷歌工程师讲解,涵盖了图论的基础知识和多种重要算法的设计与实现。
Algorithms Course - Graph Theory Tutorial from a Google Engineer
这个长达数小时的课程深入探讨了图的基础、表示方法,以及包括 BFS、DFS、Dijkstra 在内的多种算法。观看此视频有助于巩固本文介绍的概念,并了解它们在实际问题中的应用。
常见问题解答 (FAQ)
Q1: BFS 和 DFS 有什么主要区别?何时选择哪个?
主要区别在于搜索策略:
- BFS (广度优先): 逐层探索,像水波纹一样扩散。使用队列 (FIFO)。
- DFS (深度优先): 沿着一条路径深入,直到尽头再回溯。使用栈 (LIFO) 或递归。
选择依据:
- 找无权图最短路径:用 BFS,因为它首先找到距离最近的节点。
- 空间限制严格且图很深:BFS 可能需要存储整层节点,空间消耗大;DFS 递归深度可能很大,但迭代实现空间消耗相对可控 (O(深度))。
- 需要探索所有路径或检查连通性/环:两者都可用,但 DFS 因其递归性质常用于这些场景。
- 拓扑排序:通常用 DFS。
Q2: Dijkstra 算法为什么不能处理负权边?
Dijkstra 算法基于贪心策略:一旦一个节点被确定为最短路径已找到(即从优先队列中取出),它的距离就不会再被更新。这个假设依赖于所有边权非负。如果存在负权边,一条看起来较长的路径,在经过一条负权边后,可能反而变得比当前已确定的“最短路径”更短。这破坏了 Dijkstra 算法的基础假设,导致结果错误。例如,节点 A 到 B 距离 5,A 到 C 距离 10,C 到 B 距离 -6。Dijkstra 先确定 A->B (5) 是最短。但实际上 A->C->B (10 - 6 = 4) 更短。
对于带负权边的单源最短路径问题,应使用 Bellman-Ford 算法。对于所有顶点对最短路径,如果允许负权边(无负环),可用 Floyd-Warshall。
Q3: Prim 算法和 Kruskal 算法都是求 MST,有什么区别?
主要区别在于构建 MST 的方式和适用场景:
- Prim:
- 策略: 基于顶点。从一个顶点开始,不断将离当前树最近的顶点及其连接边加入树中。
- 过程: 维护一个包含 MST 顶点的集合,逐步扩大这个集合。
- 数据结构: 通常使用优先队列存储连接树内外顶点的边。
- 适用: 稠密图 (E 接近 V²) 效果较好。
- Kruskal:
- 策略: 基于边。按权重从小到大检查所有边,如果不形成环就加入 MST。
- 过程: 维护多个连通分量,逐步将它们合并成一个。
- 数据结构: 需要对边排序,并使用并查集 (DSU) 检测环。
- 适用: 稀疏图 (E 远小于 V²) 效果较好,因为排序是主要开销。可以处理不连通图(找到最小生成森林)。
两者都是贪心算法,都能找到正确的 MST,但实现细节和效率侧重不同。
Q4: Floyd-Warshall 算法复杂度 O(V³) 很高,为什么还要用它?
虽然 O(V³) 的时间复杂度看起来很高,但在某些场景下 Floyd-Warshall 仍然是合适的选择:
- 求解所有顶点对最短路径: 如果需要计算图中任意两个点之间的最短距离,多次运行单源最短路径算法(如 Dijkstra V 次)对于稠密图可能复杂度更高(V * O(E log V) 或 V * O(V²))。对于稠密图 (E ≈ V²),V * O(V²) = O(V³),与 Floyd-Warshall 相当,但 Floyd-Warshall 代码更简洁。
- 处理负权边: Dijkstra 不能处理负权边。如果图中存在负权边(但无负环),Floyd-Warshall 是计算所有顶点对最短路径的有效方法(或者运行 V 次 Bellman-Ford,复杂度 V * O(VE) = O(V²E),对于稠密图是 O(V⁴))。
- 实现简单: 算法逻辑相对直接,三层嵌套循环易于理解和实现。
- 图规模较小: 对于顶点数量 V 不算太大的图(例如几百个节点),O(V³) 的计算量在现代计算机上是可以接受的。
因此,在需要全对最短路径、允许负权边或图规模不大且实现简便性优先时,Floyd-Warshall 仍有其应用价值。
推荐探索
- 如何使用 Bellman-Ford 算法处理带负权边的最短路径问题?
- 图论算法在现实世界中有哪些有趣的应用实例?
- 解释 A* 搜索算法及其与 Dijkstra 算法的区别。
- 如何在 Python 中高效地实现并查集数据结构?
参考文献
Last updated April 30, 2025