
在 CUDA 12.1 环境下源码编译 bitsandbytes 0.48+ 以支持 QLoRA
一份详尽指南,助您在 Ubuntu 系统上为 LLama-Factory 微调解锁最新量化特性。
您好!您希望在 Ubuntu 环境下,针对 CUDA 12.1、Python 3.11、PyTorch 2.4.1 和 Transformers 4.45.2,通过源码编译来安装并使用版本号 0.48 及以上的 bitsandbytes 库,以便在 LLama-Factory 中进行模型微调时能够利用 QLoRA 等先进的量化技术。这是一个常见的需求,因为预编译的 bitsandbytes 版本可能无法完美适配特定的 CUDA 版本或不包含最新的功能。本指南将详细阐述如何实现这一目标。
核心洞察
- 源码编译的必要性: 对于 CUDA 12.1 环境,要使用
bitsandbytes0.48+ 版本以支持如 QLoRA 等最新量化特性,源码编译是当前最可靠的途径,因为官方预编译包可能不直接支持此组合或版本。 - 环境变量配置: 正确设置 CUDA相关的环境变量(如
CUDA_HOME,CUDA_VERSION,LD_LIBRARY_PATH)是编译成功的关键。 - 验证至关重要: 安装完成后,必须通过特定命令和代码片段验证
bitsandbytes是否正确编译并启用了 CUDA 支持,以及所需的量化功能是否可用。
为何选择源码编译?
bitsandbytes 是一个强大的库,用于在 PyTorch 中实现 k-bit 量化,广泛应用于大型语言模型 (LLM) 的训练和微调,以显著降低显存占用。QLoRA (Quantized Low-Rank Adaptation) 作为一种高效的 4-bit 量化微调技术,严重依赖于 bitsandbytes 的较新版本(通常是 0.48+)所提供的功能。
然而,PyPI上提供的 bitsandbytes 预编译包(wheels)可能存在以下限制:
- 对特定 CUDA 版本(如 12.1)的支持可能滞后,或者仅支持较旧的
bitsandbytes版本(例如,用户提到的 0.45 版本)。 - 最新的特性和优化(如针对 QLoRA 的改进)可能未包含在针对您 CUDA 版本的预编译包中。
通过源码编译,您可以:
- 针对您的 CUDA 12.1 环境定制构建
bitsandbytes。 - 使用最新的
bitsandbytes源码,从而获取包括 QLoRA 增强在内的所有最新功能。 - 解决因预编译包不兼容而导致的潜在运行时错误。
准备工作:环境与依赖
在开始编译之前,请确保您的 Ubuntu 系统环境满足以下要求:
系统与工具:
- 操作系统: Ubuntu (用户已指定)
- CUDA Toolkit: 版本 12.1。请确保已正确安装,并且
nvcc --version命令能显示正确的版本信息。CUDA 工具包通常安装在/usr/local/cuda-12.1。 - Python: 版本 3.11 (建议在 Conda 或 venv 虚拟环境中使用,例如用户提到的
llama环境)。 - PyTorch: 版本 2.4.1,且必须是支持 CUDA 12.1 的版本。您可以通过在 Python 中运行
import torch; print(torch.cuda.is_available())来检查 PyTorch 是否能检测到 CUDA。 - Transformers: 版本 4.45.2。
- 构建工具:
git:用于克隆源码仓库。build-essential:包含 GCC/G++ 编译器 (建议 GCC 版本 >= 9,最好是 11+ 以兼容 CUDA 12.1) 和make。cmake:版本 >= 3.22.1。
您可以使用以下命令安装或更新必要的构建工具:
sudo apt update
sudo apt install -y build-essential cmake git
# 验证 cmake 版本
cmake --version
# 验证 gcc 版本
gcc --version
确保您的 Conda 环境已激活:
conda activate llama # 或者您使用的环境名称源码编译与安装步骤
以下是详细的源码编译和安装步骤,旨在构建一个支持 CUDA 12.1 且包含 QLoRA 等新量化特性的 bitsandbytes 0.48+ 版本。
1. 清理与克隆源码
卸载现有版本
为避免冲突,首先卸载任何已安装的 bitsandbytes 版本:
pip uninstall bitsandbytes -y克隆 bitsandbytes 仓库
从官方 bitsandbytes-foundation 仓库克隆最新的源码。这将确保您获取到包含最新特性和修复的分支(通常是 main 分支):
git clone https://github.com/bitsandbytes-foundation/bitsandbytes.git
cd bitsandbytes
如果您希望编译特定的 0.48+ 版本(例如 v0.48.1),可以在克隆后切换到对应的标签:
# git tag # 查看所有可用标签
# git checkout v0.48.1 # 切换到指定版本,请替换为实际存在的标签
若不指定,默认将编译 main 分支的最新代码。
2. 配置环境变量
正确的环境变量配置对于编译至关重要。请根据您的 CUDA 12.1 安装路径进行设置:
export CUDA_HOME=/usr/local/cuda-12.1
export CUDA_VERSION=121 # 注意:这里通常使用不带小数点的三位数版本号
export LD_LIBRARY_PATH=/usr/local/cuda-12.1/lib64${LD_LIBRARY_PATH:+:$LD_LIBRARY_PATH}
export PATH=/usr/local/cuda-12.1/bin${PATH:+:$PATH}
您可以通过 echo $CUDA_HOME 等命令验证环境变量是否设置成功。
3. 编译与安装
我们将使用 CMake 和 make 进行编译,这种方法提供了更精细的控制,并被广泛认为是编译复杂 CUDA 项目的稳健方式。
清理旧的构建缓存 (可选,但推荐)
如果在之前尝试过编译,建议清理旧的构建文件:
rm -rf build/CMake 配置
配置 CMake 项目,指定使用 CUDA 后端,并可选择性地传递 CUDA 版本信息:
cmake -DCOMPUTE_BACKEND=cuda -DCMAKE_CUDA_ARCHITECTURES=all-major -S .
# 或者更具体地指定您的 GPU架构, 例如 Turing (75), Ampere (80, 86), Ada (89), Hopper (90)
# cmake -DCOMPUTE_BACKEND=cuda -DCMAKE_CUDA_ARCHITECTURES="75;86;89" -S .
-DCMAKE_CUDA_ARCHITECTURES=all-major 会为所有主要的GPU架构编译。如果知道确切的架构,指定它可以加快编译速度并减小库大小。
执行编译
bitsandbytes 的 Makefile 提供了针对特定 CUDA 主版本的编译目标。对于 CUDA 12.x,使用 cuda12x 目标。使用 -j$(nproc) 可以利用所有 CPU核心并行编译以加快速度:
make cuda12x -j$(nproc)编译过程可能需要一些时间,具体取决于您的硬件配置。
安装编译好的包
编译成功后,使用 pip 从当前目录安装 bitsandbytes:
pip install .为确保安装的是刚刚编译的版本,可以加上 --force-reinstall --no-cache-dir 参数:
pip install . --force-reinstall --no-cache-dir4. 验证安装
安装完成后,必须验证 bitsandbytes 是否正确安装并能够利用您的 CUDA 12.1 GPU。
基本 CUDA 支持检查
运行 bitsandbytes 内置的检查脚本:
python -m bitsandbytes如果一切正常,您应该会看到类似以下的输出,表明 CUDA 已被正确检测并设置:
++++++++++++++++++++++++++++++++++++++++++++++++++++++++++++
++++++++++++++++++ BUG REPORT INFORMATION ++++++++++++++++++
++++++++++++++++++++++++++++++++++++++++++++++++++++++++++++
++++++++++++++++++++++++++++++++++++++++++++++++++++++++++++
++++++++++++++++++ /BUG REPORT INFORMATION +++++++++++++++++
++++++++++++++++++++++++++++++++++++++++++++++++++++++++++++
++++++++++++++++++++++++++++++++++++++++++++++++++++++++++++
False
CUDA_SETUP: CUDA runtime path found: /usr/local/cuda-12.1/lib64/libcudart.so
CUDA_SETUP: CUDA compile path found: /usr/local/cuda-12.1/include/cudart.h
CUDA_SETUP: Loading binary /path/to/your/conda/env/lib/python3.11/site-packages/bitsandbytes/libbitsandbytes_cuda121.so...
CUDA_SETUP: Successfully loaded CUDA library from /path/to/your/conda/env/lib/python3.11/site-packages/bitsandbytes/libbitsandbytes_cuda121.so
CUDA_SETUP:Detected CUDA version 121
CUDA_SETUP: Library path found: /path/to/your/conda/env/lib/python3.11/site-packages/bitsandbytes/libbitsandbytes_cuda121.so
CUDA_SETUP: CUDA version lower than 11 are currently not supported for LLM.int8(). You will be only to use 8-bit optimizers and quantization routines!!
CUDA SETUP: CUDA version installed properly.
CUDA SETUP: Highest compute capability among GPUs detected: X.X # (e.g., 8.6 for RTX 3090)
CUDA SETUP: Detected CUDA version 121.
CUDA SETUP: Loading bitsandbytes native library from: /path/to/your/conda/env/lib/python3.11/site-packages/bitsandbytes/libbitsandbytes_cuda121.so
CUDA SETUP: Successfully loaded bitsandbytes native library.
注意:输出中的路径和确切消息可能略有不同。
Python 代码验证
通过 Python 脚本进一步测试,尝试导入库并创建一个量化层:
import bitsandbytes as bnb
import torch

print(f"bitsandbytes version: {bnb.__version__}")
print(f"PyTorch version: {torch.__version__}")
print(f"PyTorch CUDA available: {torch.cuda.is_available()}")

if torch.cuda.is_available():
    print(f"CUDA device count: {torch.cuda.device_count()}")
    print(f"Current CUDA device: {torch.cuda.current_device()}")
    print(f"CUDA device name: {torch.cuda.get_device_name(0)}")

    try:
        # 测试 4-bit 量化层 (QLoRA 核心)
        print("Attempting to create Linear4bit layer...")
        linear_4bit_layer = bnb.nn.Linear4bit(
            in_features=1024,
            out_features=512,
            bias=False,
            compute_dtype=torch.bfloat16, # 或者 torch.float16
            quant_type='nf4' # 'nf4' 或 'fp4'
        ).cuda()
        print("Successfully created and moved Linear4bit layer to CUDA.")

        # 测试 8-bit 量化层
        # print("Attempting to create Linear8bitLt layer...")
        # linear_8bit_layer = bnb.nn.Linear8bitLt(1024, 512, bias=False).cuda()
        # print("Successfully created and moved Linear8bitLt layer to CUDA.")

        print("bitsandbytes seems to be working correctly with CUDA.")
    except Exception as e:
        print(f"Error during bitsandbytes layer creation or usage: {e}")
else:
    print("CUDA is not available to PyTorch. bitsandbytes GPU features will not work.")
如果脚本成功运行并打印出 "Successfully created..." 等成功信息,则表明您的 bitsandbytes 已正确编译并支持 CUDA 12.1 上的 4-bit 量化。
编译流程与关键组件概览
下面的思维导图概述了从环境准备到最终验证的整个编译安装流程,帮助您理解各个阶段的任务和依赖关系。
这个流程确保了 bitsandbytes 能够充分利用您的硬件和软件栈,为 LLama-Factory 中的 QLoRA 微调提供支持。
安装方法特性对比
为了更清晰地理解源码编译的优势,尤其是针对您特定需求(CUDA 12.1 和 bitsandbytes 0.48+ 以支持 QLoRA),下面的雷达图比较了“预编译包”与“源码编译”在几个关键方面的表现:
图表解读:
- QLoRA 支持 / 最新特性: 源码编译能够获取最新版本,因此对新特性的支持更好。
- CUDA 12.1 兼容性: 源码编译可以精确匹配您的 CUDA 版本,确保最佳兼容性。
- bitsandbytes 版本控制: 源码编译让您可以选择安装包括 0.48+ 在内的任意版本。
- 安装便捷性: 预编译包通常更易于安装 (
pip install),但源码编译提供了必要的灵活性。 - 环境定制化程度: 源码编译允许针对特定硬件和软件环境进行优化。
- 潜在稳定性: 官方预编译包经过广泛测试,可能更稳定;但对于特定新CUDA版本,自编译若成功则表现优异。
此比较突显了在您的情况下,源码编译是满足所有高级需求的首选方法。
关键组件和需求总结
下表总结了成功编译和运行 bitsandbytes 所需的关键组件及其重要性:
| 组件/特性 | 详情 / 要求 | 重要性 |
|---|---|---|
| 操作系统 | Ubuntu (Linux 环境) | 关键 |
| CUDA Toolkit | 版本 12.1,确保正确安装且路径已配置 | 至关重要 |
| Python | 版本 3.11 (在隔离的 Conda/venv 环境中) | 高 |
| PyTorch | 版本 2.4.1 (CUDA-enabled, 与 CUDA 12.1 兼容) | 至关重要 |
| 构建工具 | gcc/g++ (例如, GCC >= 9, 推荐 11+), cmake (>= 3.22.1), git |
至关重要 |
bitsandbytes 源码 |
从 bitsandbytes-foundation 克隆 (最新 main 分支或特定 0.48+ 标签) |
高 |
| 环境变量 | CUDA_HOME, CUDA_VERSION=121, LD_LIBRARY_PATH, PATH 必须正确设置 |
至关重要 |
| QLoRA 支持 | 成功编译 0.48+ 版本后的预期成果 | 目标 |
| GPU 架构 | 推荐 NVIDIA GPU,支持 Compute Capability (SM) 5.0+,QLoRA 等特性在较新架构 (SM 7.0+) 上表现更佳 | 高 |
QLoRA 与 bitsandbytes 简介视频
为了更深入地理解 QLoRA 技术及其与 bitsandbytes 的关系,观看 Tim Dettmers(bitsandbytes 和 QLoRA 的主要贡献者之一)的演讲会非常有益。下面的视频详细介绍了 QLoRA 的原理和高效微调量化大语言模型的方法:
Tim Dettmers 关于 QLoRA 的演讲:高效微调量化大型语言模型。
这段视频可以帮助您理解为什么需要特定版本的 `bitsandbytes` 来充分发挥 QLoRA 的潜力,以及这项技术在减少模型微调资源消耗方面的革命性影响。
潜在问题与故障排除
源码编译过程可能会遇到一些常见问题。以下是一些排查建议:
- CUDA 库未找到 (例如
libcudart.so错误):- 确保
LD_LIBRARY_PATH环境变量正确指向了 CUDA 12.1 的lib64目录 (通常是/usr/local/cuda-12.1/lib64)。 - 确认
CUDA_HOME设置正确。 - 运行
sudo ldconfig更新共享库缓存。
- 确保
- 编译器错误 (GCC/G++ 版本问题):
- CUDA 12.x 通常需要较新版本的 GCC (例如 GCC 9.x 或更高版本,推荐 11+)。如果您的默认 GCC 版本过低,请安装新版本并通过
update-alternatives或在 CMake 命令中指定编译器路径 (-DCMAKE_C_COMPILER=gcc-11 -DCMAKE_CXX_COMPILER=g++-11)。
- CUDA 12.x 通常需要较新版本的 GCC (例如 GCC 9.x 或更高版本,推荐 11+)。如果您的默认 GCC 版本过低,请安装新版本并通过
- CMake 配置错误:
- 仔细检查 CMake 命令中的参数是否正确。
- 确保
cmake版本符合要求 (>= 3.22.1)。
- Python/PyTorch 版本不兼容:
- 确保您的 PyTorch 版本是为 CUDA 12.1 编译的。可以从 PyTorch 官网获取正确的安装命令。
- GPU 架构不支持:
- `bitsandbytes` 通常需要支持 Compute Capability (SM) 5.0 或更高的 NVIDIA GPU。较新的特性(如 4-bit 量化)可能对 GPU 架构有更高要求(例如 SM 7.0+)。通过
nvidia-smi查看您的 GPU 型号和算力。
- `bitsandbytes` 通常需要支持 Compute Capability (SM) 5.0 或更高的 NVIDIA GPU。较新的特性(如 4-bit 量化)可能对 GPU 架构有更高要求(例如 SM 7.0+)。通过
- "CUDA Setup failed despite GPU being available" 错误:
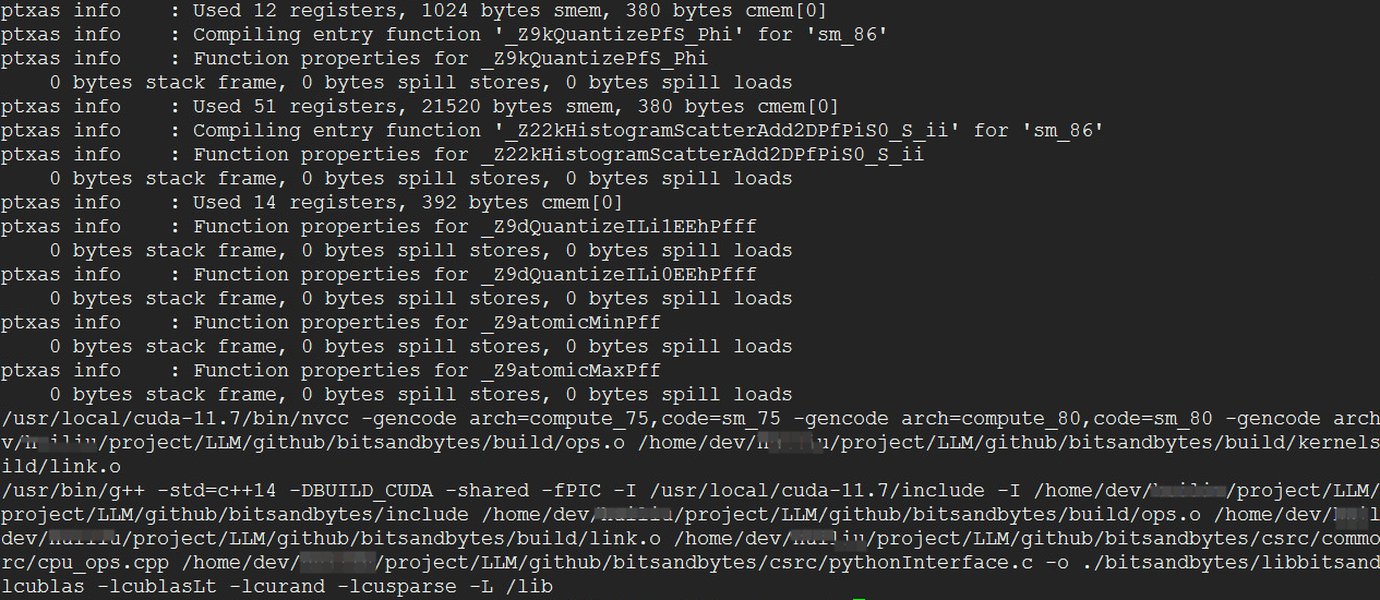
一个典型的 CUDA 设置失败错误提示。
- 此类错误通常与环境配置、CUDA 版本、驱动程序或 `bitsandbytes` 自身编译问题有关。
- 仔细检查所有环境变量。
- 尝试完全清理构建目录 (
make clean或删除build文件夹) 并重新编译。 - 查阅 `bitsandbytes` GitHub Issues 页面,搜索类似的错误报告和解决方案。
- 长时间编译或卡住:
- 确保系统有足够的内存和 CPU 资源。编译大型项目,尤其是带 CUDA 支持的,可能非常消耗资源。
- 如果使用
-j$(nproc),而 CPU 核心数非常多且内存不足,可能会导致问题。可以尝试减少并行任务数,例如-j4。
如果在编译或验证过程中遇到具体错误信息,建议将完整的错误日志复制下来,并在 `bitsandbytes` 的 GitHub Issues 区或相关社区论坛搜索,通常能找到有用的线索或解决方案。
常见问题解答 (FAQ)
为什么我不能直接用 `pip install bitsandbytes` 安装 0.48+ 版本并让它在 CUDA 12.1 上工作?
PyPI 上提供的 `bitsandbytes` 预编译包 (wheels) 是针对特定组合的操作系统、Python 版本和 CUDA 版本构建的。对于较新的 CUDA 版本(如 12.1)和较新的 `bitsandbytes` 版本(如 0.48+),可能还没有官方的预编译包直接支持这种组合。即使有支持 CUDA 12.x 的包,它也可能基于 CUDA 12.0 或 12.2 等,而非精确的 12.1,或者该包可能是一个较旧的 `bitsandbytes` 版本(如 0.45)。因此,为了确保与您的 CUDA 12.1 环境完全兼容并能使用 0.48+ 的最新特性(如 QLoRA 的特定优化),源码编译是目前最可靠的方法。
环境变量 `CUDA_VERSION=121` 是什么意思?为什么不是 `12.1`?
在 `bitsandbytes` 的编译脚本和内部检查中,CUDA 版本号通常被处理为整数形式,去除了小数点。例如,CUDA 11.7 会表示为 `117`,CUDA 12.1 则表示为 `121`。这是一种常见的简化做法,用于 Makefile 或 CMakeLists.txt 文件中的版本匹配和条件编译。因此,在设置 `CUDA_VERSION` 环境变量以供 `bitsandbytes` 编译系统使用时,通常需要遵循这种格式。使用 `121` 而非 `12.1` 可以确保编译脚本正确识别您的 CUDA 版本。
如果编译过程中遇到 CUDA 相关的错误(例如找不到符号、库链接失败等)怎么办?
CUDA 相关错误通常由以下几个原因引起:
- 环境变量配置不当:再次检查
CUDA_HOME,LD_LIBRARY_PATH, 和PATH是否正确指向您的 CUDA 12.1 安装目录。 - CUDA Toolkit 安装不完整或损坏:尝试重新安装 CUDA Toolkit 12.1。
- NVIDIA 驱动程序版本与 CUDA Toolkit 不兼容:确保您的 NVIDIA 驱动程序版本满足 CUDA 12.1 的最低要求。通常,较新的驱动程序会向后兼容。
- 编译器 (GCC/G++) 版本问题:CUDA 12.1 对 GCC 版本有要求 (通常 GCC 9+,推荐 11+)。版本过低或过高都可能导致问题。
bitsandbytes源码与 CUDA 12.1 的兼容性问题:虽然目标是编译支持,但如果使用的是非常新的主分支代码,可能存在临时的不兼容。此时可以尝试切换到最近的稳定发布标签 (tag),或者查看 GitHub Issues 是否有针对此问题的讨论或补丁。- 系统库冲突:极少数情况下,系统中其他库可能与 CUDA 库冲突。
解决步骤通常包括:仔细阅读错误信息,确认上述各项配置,清理构建目录后重试编译。如果问题持续,将详细的错误日志和您的环境信息提交到 `bitsandbytes` 的 GitHub Issues 区寻求帮助。
我如何确认 QLoRA 在我的设置中实际可用并且正在工作?
确认 QLoRA 是否工作涉及几个层面:
bitsandbytes安装成功且支持 4-bit:如前述“Python 代码验证”部分所示,能够成功创建bnb.nn.Linear4bit类型的层并将其移至 CUDA 设备是基本前提。确保没有错误抛出。- LLama-Factory 配置正确:在使用 LLama-Factory 进行微调时,您需要在配置文件中正确指定使用 QLoRA(通常涉及设置
quantization_bit=4,lora_target等参数)。 - 训练过程中的显存占用:QLoRA 的一个主要优势是显著降低显存占用。在开始微调后,监控您的 GPU 显存使用情况 (例如使用
nvidia-smi)。如果显存占用远低于全参数微调或传统的 LoRA 微调,这间接表明量化可能已生效。 - 模型性能和收敛情况:虽然 QLoRA 旨在保持与全参数微调相近的性能,但训练动态和最终结果可能略有不同。观察训练损失是否正常下降,以及微调后的模型在评估任务上是否达到预期效果。
- 日志输出:LLama-Factory 或 Transformers 库在启动 QLoRA 微调时,可能会在日志中输出相关信息,表明正在使用 4-bit 量化和 LoRA 适配器。
最直接的证据是成功运行微调任务,观察到预期的低显存占用,并且模型能够正常学习。如果遇到问题,LLama-Factory 的日志输出通常会提供线索。
推荐探索
- 如何优化 LLama-Factory 中 QLoRA 微调的超参数以获得最佳性能?
- 在 CUDA 12.1 环境下,除了 bitsandbytes,还有哪些其他的模型量化库可以考虑?
- 比较 bitsandbytes 中 NF4 和 FP4 量化类型在 QLoRA 微调中的具体差异和适用场景。
- 如何诊断和解决在 LLama-Factory 使用 bitsandbytes 进行 QLoRA 微调时出现的显存不足问题?
参考资料
Last updated May 20, 2025