
揭秘编译器核心优化:局部变量消除如何避免寄存器溢出
深入理解编译器如何智能管理变量,提升程序性能并有效利用CPU资源。
核心洞察
- 局部变量消除是编译器一项关键优化技术,旨在通过识别并移除代码中冗余或未使用的局部变量及其相关操作,从而减少对有限CPU寄存器和内存资源的占用。
- 其工作原理涉及深度代码分析(如数据流和控制流分析)来识别死代码、冗余赋值和可合并变量,同时利用公共子表达式消除和常量传播等技术进行综合优化。
- 若局部变量消除优化不足,会造成活跃变量数量虚高,导致编译器在分配寄存器时面临巨大压力,最终不得不将过多变量“溢出”到速度较慢的内存(通常是栈),引发寄存器溢出,严重拖累程序性能。
什么是局部变量消除?
局部变量消除是现代编译器中一项至关重要的代码优化技术,其核心目标是通过精细分析和处理程序中的局部变量,最大限度地减少不必要的存储、加载和赋值操作。在程序执行过程中,局部变量会占用宝贵的计算资源,如CPU内部的高速寄存器或栈内存。通过有效的消除,编译器能够显著提升程序的运行效率,降低对硬件资源的消耗,进而提高整体性能。
这种优化不仅针对函数内部声明的显式局部变量,也包括编译器为存储中间计算结果而创建的临时变量。其最终目的是在不改变程序语义和功能的前提下,让编译后的机器码更加紧凑、高效。
局部变量消除的精妙工作原理
局部变量消除的实现并非单一操作,而是编译器在多个优化阶段协同作用的结果。它依赖于复杂的代码分析技术,以识别并优化变量的使用模式。以下是其主要工作原理的详细阐述:
1. 静态分析与变量生命周期管理
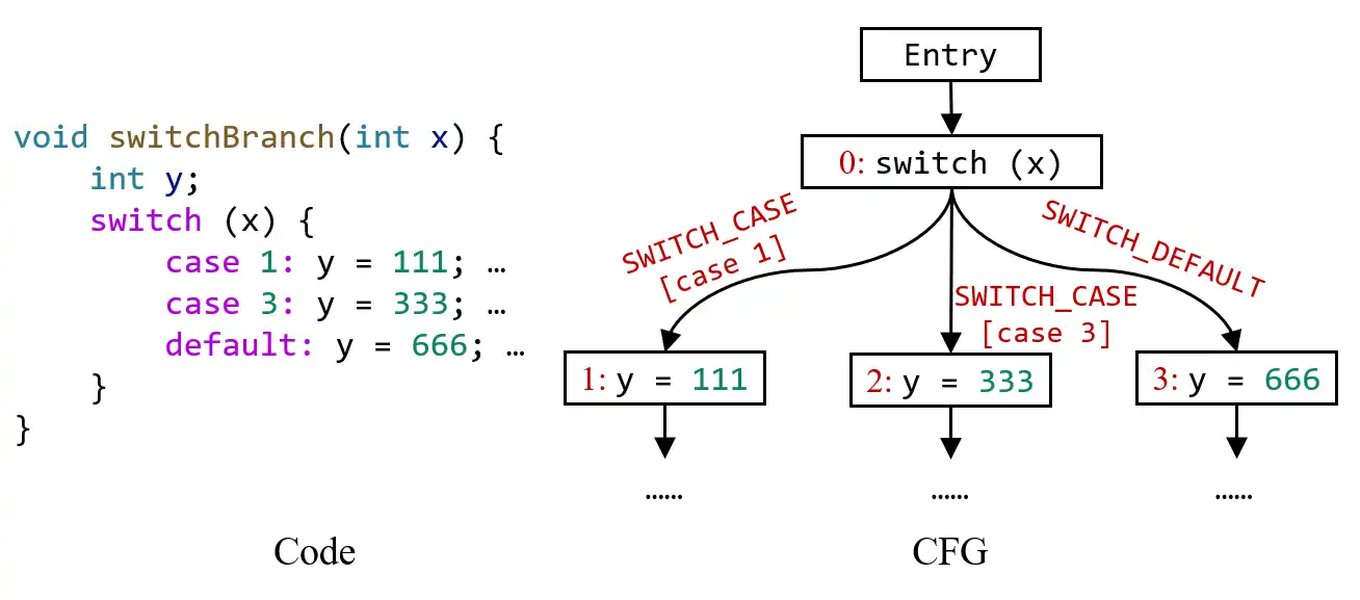
编译器首先会对程序的中间表示(IR)进行深入的静态分析,构建如控制流图(CFG)和数据流图等结构。通过这些图,编译器能够精确追踪每个局部变量的“定义”(def)和“使用”(use)点,从而确定其“活跃区间”(live range),即变量从被赋值到最后一次被使用之间的代码范围。识别出变量的活跃区间是优化的基础,因为它决定了哪些变量是“活的”(仍然需要保留),哪些变量是“死的”(可以被消除)。
图示:控制流图(CFG)示例,编译器通过此图分析代码执行路径与变量活跃区间。
2. 无用赋值与死代码消除(Dead Code Elimination, DCE)
这是局部变量消除最直接的形式之一。如果一个局部变量被赋值,但其值在后续代码中从未被读取或使用,那么这个赋值操作就是冗余的,对程序结果没有任何影响,因此可以被安全地删除。这种“死代码”的消除减少了不必要的计算和存储开销。
示例:
int a = 1; // 这个赋值是无用的,因为a的值立即被覆盖
int a = 2;
int b = a * 3;在上述代码中,int a = 1; 这行赋值操作是冗余的,编译器会将其消除,因为紧随其后的 a = 2; 覆盖了其值,且 a = 1; 之前的值未被使用。
图示:死代码消除示例,编译器识别并移除不会影响程序输出的代码块。
3. 公共子表达式消除(Common Subexpression Elimination, CSE)
CSE旨在识别并消除在不同位置重复计算的相同表达式。当多个地方计算出相同的结果并存储在局部变量中时,编译器可以只计算一次,并将结果存储在一个临时变量中,然后所有后续对该表达式的引用都直接使用这个存储的结果。这间接导致了存储中间结果的局部变量变得冗余,从而被消除或合并。
示例:
c = a * b;
d = a * b;
编译器会识别出 a * b 是一个公共子表达式,只计算一次并存储其结果,然后赋给 c 和 d,从而避免了第二次重复计算。
4. 常量传播与常量折叠(Constant Propagation and Folding)
如果一个局部变量的值在编译时就可以确定是一个常量,编译器会直接用该常量值替换所有对该变量的引用,从而完全消除该变量。常量折叠是常量传播的进一步,编译器会计算表达式中所有常量的结果,然后用最终的常量值替换整个表达式。
示例:
int x = 10;
int y = x + 5;
编译器会直接将 y 计算为 15,并可能消除 x 变量。
5. 变量存储位置优化与合并
编译器会智能地决定局部变量的存储位置:是在CPU寄存器中,还是在程序的栈内存中。对于频繁访问的变量,编译器会优先尝试将其分配到速度最快的寄存器中。如果两个局部变量的活跃区间不重叠,即使它们在源代码中是不同的变量,编译器也可能将它们映射到同一个寄存器或栈空间,从而进一步减少资源需求。
6. 循环不变量外提(Loop Invariant Code Movement)
对于在循环内部计算但其值在循环迭代过程中保持不变的表达式,编译器会将其移到循环外部进行一次计算,并将结果存储在一个局部变量中。这减少了循环内部的重复计算,并可能导致存储这些中间结果的局部变量在循环外部被有效管理,从而降低循环内部的寄存器压力。
为何局部变量消除不当会导致寄存器溢出?
理解局部变量消除的重要性,必须首先了解寄存器溢出(Register Spilling)的概念。寄存器是CPU内部用于高速存储数据的有限空间。它们是处理器访问数据最快的方式,但数量非常有限(例如,x86-64架构通常有16个通用寄存器)。当程序中需要同时存储的局部变量和中间计算结果的数量超过了CPU可用的寄存器数量时,就会发生寄存器溢出。
在这种情况下,编译器别无选择,只能将部分变量的值从快速的寄存器中“溢出”到速度较慢的内存(通常是程序的栈空间)中。从内存中读写数据比从寄存器中慢得多,这会引入显著的性能开销,从而直接影响程序的执行效率。
导致寄存器溢出的主要原因:
1. 冗余变量占用宝贵寄存器资源
如果编译器未能有效识别和消除冗余的局部变量(如无用赋值、未被使用的中间结果等),这些“无用”变量仍会持续占用有限的寄存器资源。当这些被不必要地保留的变量积累到一定数量时,就会挤占真正有用的、活跃的变量的寄存器空间,导致这些关键变量被迫溢出到内存。
这就像一个拥挤的停车场:如果许多车辆(无用变量)长时间占据车位,那么新来的、需要停车的车辆(活跃变量)就找不到车位,只能停到更远、更不方便的地方(内存)。
2. 未优化的中间计算结果堆积
很多局部变量被用于存储中间计算结果。如果编译器在代码优化阶段(例如死代码消除、公共子表达式消除)不够彻底,未能及时清理掉不再需要的中间结果,这些临时变量会持续占用寄存器。当后续的计算需要新的寄存器空间时,就可能因为寄存器不足而发生溢出。
3. 活跃变量数量虚高与寄存器分配压力
寄存器分配是编译器后端最复杂的任务之一,它尝试将尽可能多的活跃变量分配到寄存器中。局部变量消除的目标就是减少活跃变量的数量。如果这项优化做得不好,编译器在进行寄存器分配时会看到“活跃变量”的虚拟数量过高。即使使用最先进的寄存器分配算法(如图着色算法或线性扫描算法),面对如此多的“活跃”变量,也难以避免地会将部分变量溢出到栈中。
例如,一个复杂的函数可能声明了大量局部变量,如果其中大部分都可以通过消除或合并来优化,那么实际需要分配寄存器的活跃变量数量就会大大减少。反之,如果这些优化未能发生,每个变量都可能被视为“活跃”,从而造成寄存器分配的瓶颈。
4. 低效的代码生成与内存访问频率增加
当变量溢出到内存时,程序必须频繁地从内存中读取或写入这些变量的值。这会增加内存访问指令,导致CPU花费更多时间等待数据从内存中传输,而不是执行实际的计算。这种对内存的频繁依赖性会显著降低程序的执行速度,尤其是在并行度较高或对延迟敏感的应用中。
下图雷达图展示了局部变量消除对不同优化指标的影响:
这个雷达图清晰地对比了局部变量消除做得好与做得不好的两种情况对关键性能指标的影响。可以看到,良好的局部变量消除在所有方面都表现出显著的优化效果,尤其是在减少寄存器溢出方面。
局部变量消除技术实现细节
为了更全面地理解局部变量消除,我们来看一下其在编译器内部是如何与其它优化技术协同工作的:
| 优化技术 | 描述 | 与局部变量消除的关系 |
|---|---|---|
| 活跃变量分析(Liveness Analysis) | 确定变量在程序执行过程中哪些点是“活跃”的(即其值在未来会被使用)。 | 核心基础,用于识别可以被消除的非活跃变量。 |
| 复制传播(Copy Propagation) | 将一个变量的赋值(例如 x = y;)替换为直接使用被赋值变量的值。 |
可以减少中间变量的使用,从而消除部分局部变量。 |
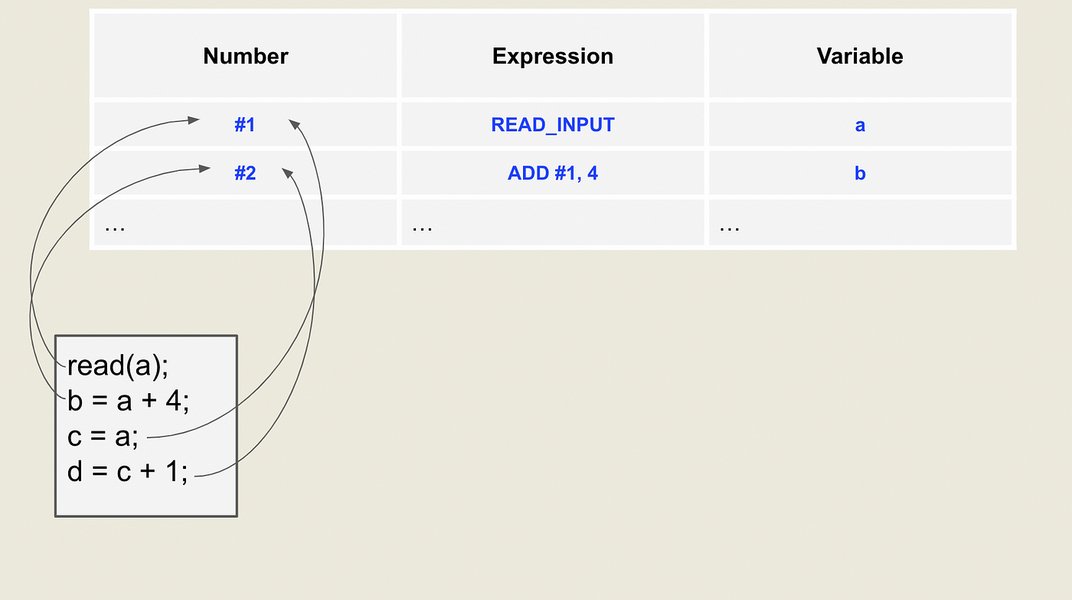
| 值编号(Value Numbering) | 为每个表达式赋予一个唯一标识符,如果两个表达式具有相同的值,则它们获得相同的标识符。 | 有助于识别公共子表达式,从而为局部变量消除提供依据。 |
| 寄存器分配(Register Allocation) | 将程序中的变量映射到CPU寄存器或内存位置。 | 局部变量消除是其前提,减少活跃变量数量可显著改善分配效果。 |
这些技术共同作用,形成一个强大的优化链条,确保编译器能够最大化地利用CPU资源,最小化不必要的内存访问。
局部变量消除在编译器优化中的角色
局部变量消除是编译器优化性能的关键环节之一。它能减少对有限寄存器资源的竞争,从而降低寄存器溢出的风险,并最终提升程序的整体运行效率。
图示:编译器优化流程中的局部变量消除定位。它在中端优化阶段发挥关键作用,直接影响后端寄存器分配的效率。
如上图所示,局部变量消除位于编译器的中端优化阶段。它的优化成果直接影响着后端寄存器分配的效率。一个高效的局部变量消除器能够为寄存器分配器提供一个“更干净”的变量列表,从而使其能够更好地完成工作,减少寄存器溢出。
深入理解寄存器溢出的原理:CSDN视频详解
为了更直观地理解寄存器溢出及其对程序性能的影响,推荐观看下方视频,它详细解释了寄存器溢出问题的原理以及它如何影响程序的性能。
视频:CSDN博客关于“深入理解计算机系统:寄存器溢出问题的原理、对性能的影响(register spilling)”的讲解视频。该视频深入剖析了寄存器溢出的根本原因,如数据类型超出字长界限、非类型安全语言的使用、不可靠内存存取以及编译器内存缓冲区设置不当等。它还强调了当并行度超过可用寄存器数量时,寄存器溢出是如何直接发生的,以及编译器为了应对这种不足如何将变量溢出到栈中,从而对程序性能造成负面影响。这为理解局部变量消除为何对避免溢出至关重要提供了直观且全面的视角。
视频内容强调,当可用的寄存器数量不足以存储所有活跃变量时,编译器会将被迫溢出到内存中的变量。这种内存访问的增加是性能下降的直接原因。
常见问题(FAQ)
局部变量消除和死代码消除有什么区别?
所有局部变量都会被消除吗?
为什么局部变量消除这么重要?
程序员可以干预局部变量消除吗?
结论
局部变量消除是编译器优化中的一项基石技术,它通过智能地识别并移除程序中冗余或未使用的局部变量及其操作,显著提升了程序的执行效率和资源利用率。这项优化减少了对有限CPU寄存器和内存资源的竞争,尤其是在避免寄存器溢出方面发挥着至关重要的作用。如果此优化未能充分执行,将导致大量的活跃变量竞争稀缺的寄存器资源,迫使编译器将数据溢出到速度较慢的内存中,从而严重拖累程序性能。因此,理解并有效利用局部变量消除,对于编写高效、高性能的软件至关重要,它在幕后默默地为我们的程序加速,确保它们能以最优状态运行。