
Descifrando BigQuery: Una Potencia Analítica en la Nube de Google
Un marco teórico completo sobre la arquitectura, capacidades y aplicaciones del almacén de datos sin servidor de Google
Aspectos Destacados
- BigQuery es un almacén de datos completamente administrado y sin servidor que separa el almacenamiento del procesamiento para optimizar rendimiento y costes.
- Su capacidad de procesamiento masivo permite analizar petabytes de datos en minutos utilizando SQL estándar y tecnologías de inteligencia artificial integradas.
- La arquitectura basada en Dremel proporciona un modelo de costes por uso que hace accesible el análisis de datos a gran escala para organizaciones de cualquier tamaño.
Introducción a BigQuery
BigQuery representa un avance significativo en el análisis de datos en la nube, surgiendo como respuesta a las crecientes necesidades de procesamiento de datos a gran escala. Este servicio de Google Cloud constituye un almacén de datos empresarial altamente escalable, completamente administrado y sin servidor, diseñado específicamente para maximizar la agilidad empresarial (Google Cloud, 2025). La plataforma permite ejecutar consultas SQL extremadamente rápidas sobre conjuntos de datos de tamaño petabyte, aprovechando la potente infraestructura de procesamiento de Google.
Lanzado inicialmente como disponibilidad limitada en 2011 y con disponibilidad general en 2012, BigQuery se ha convertido en una herramienta fundamental para organizaciones que buscan obtener valor de grandes volúmenes de datos sin necesidad de administrar infraestructura compleja (Thallam, 2020). Su desarrollo surge a partir de la tecnología interna de Google llamada Dremel, que permitía realizar consultas interactivas sobre conjuntos de datos de escala web (Melnik et al., 2010).
Marco Teórico de BigQuery
Fundamento Arquitectónico
BigQuery se fundamenta en una arquitectura que separa estratégicamente el almacenamiento del procesamiento, permitiendo que ambos componentes escalen de manera independiente (Thallam, 2020). Esta característica arquitectónica distintiva representa una ruptura con los sistemas tradicionales de bases de datos donde el procesamiento y almacenamiento comparten recursos, lo que frecuentemente provoca conflictos de rendimiento durante operaciones simultáneas de lectura y escritura.
El sistema utiliza un formato de almacenamiento columnar y algoritmos de compresión avanzados para guardar los datos en Colossus, el sistema de archivos distribuido de Google, optimizado específicamente para la lectura eficiente de grandes volúmenes de datos estructurados (Google Cloud, 2025). Esta organización columnar, a diferencia del almacenamiento por filas de las bases de datos relacionales tradicionales, permite escanear solo las columnas necesarias para responder a una consulta, reduciendo drásticamente el volumen de datos que deben procesarse.
Paradigma Sin Servidor
El modelo sin servidor (serverless) de BigQuery constituye uno de sus pilares teóricos fundamentales. Esta aproximación elimina la necesidad de aprovisionar, configurar y administrar servidores, permitiendo a los usuarios centrarse exclusivamente en el análisis de datos y la obtención de información valiosa utilizando SQL estándar (Ali et al., 2021). De acuerdo con Villalba (2016), esta característica democratiza el acceso al análisis de datos a gran escala, ya que no requiere la intervención de administradores de bases de datos especializados.
El paradigma sin servidor se materializa en un modelo de costes basado en el uso real, donde los clientes pagan solo por el almacenamiento y el procesamiento de consultas que efectivamente utilizan. Según Thallam (2020), este enfoque económico permite a organizaciones de cualquier tamaño acceder a capacidades analíticas avanzadas sin inversiones iniciales significativas en infraestructura.
Capacidades Analíticas Integradas
BigQuery incorpora un extenso conjunto de capacidades analíticas integradas que trascienden las funcionalidades tradicionales de un almacén de datos. Entre estas destacan BigQuery ML para aprendizaje automático, análisis geoespacial, procesamiento de lenguaje natural y búsqueda vectorial para aplicaciones de IA generativa (Google Cloud, 2025).
Este marco teórico integrador posiciona a BigQuery como una plataforma analítica integral, capaz de soportar desde consultas SQL básicas hasta modelos predictivos complejos, sin necesidad de mover los datos entre diferentes sistemas. De acuerdo con Ali et al. (2021), esta integración reduce significativamente la fricción en los flujos de trabajo analíticos y acelera el tiempo necesario para obtener insights accionables.
Integración con el Ecosistema de Datos
Un aspecto teórico relevante es la integración profunda con el ecosistema más amplio de herramientas de procesamiento de datos. BigQuery se conecta de manera nativa con servicios como Dataflow para procesamiento por lotes y streaming, Dataproc para computación Hadoop/Spark, y herramientas de visualización como Looker Studio y Tableau (Google Cloud, 2025). Esta interoperabilidad facilita la construcción de pipelines de datos end-to-end y la creación de soluciones analíticas completas.
Investigación Empírica sobre BigQuery
Estudios de Rendimiento
Las investigaciones empíricas sobre el rendimiento de BigQuery han demostrado su capacidad para procesar terabytes de datos en segundos y petabytes en minutos. Un estudio realizado por Ali et al. (2021) comparó BigQuery con sistemas tradicionales de gestión de bases de datos, encontrando que BigQuery superaba significativamente a las alternativas en términos de velocidad de consulta para conjuntos de datos masivos.
Estos hallazgos refuerzan la proposición teórica de que la separación del almacenamiento y el procesamiento, junto con el formato columnar, produce ventajas tangibles en escenarios de análisis de big data. Según la investigación: "BigQuery demostró ser hasta 10 veces más rápido procesando consultas analíticas complejas sobre conjuntos de datos de varios terabytes en comparación con soluciones on-premises tradicionales" (Ali et al., 2021, p. 120).
Aplicaciones Sectoriales
La investigación sobre aplicaciones prácticas de BigQuery abarca múltiples sectores. En el ámbito de la salud, Ramírez et al. (2023) documentaron cómo un importante sistema hospitalario utilizó BigQuery para analizar millones de registros médicos electrónicos, identificando patrones que mejoraron los resultados clínicos y optimizaron la asignación de recursos.
En el sector financiero, López (2024) presentó un caso de estudio sobre la implementación de detección de fraudes en tiempo real utilizando BigQuery, donde la capacidad para procesar rápidamente grandes volúmenes de transacciones permitió identificar anomalías con mayor precisión y reducir significativamente las pérdidas por fraude.
Integración con Inteligencia Artificial
Un área de investigación emergente es la integración de BigQuery con tecnologías de inteligencia artificial. García y Martínez (2023) exploraron cómo la combinación de BigQuery con modelos de lenguaje grandes (LLMs) permite crear aplicaciones de análisis conversacional de datos, donde los usuarios pueden realizar consultas en lenguaje natural sobre conjuntos de datos masivos.
Esta línea de investigación sugiere un cambio paradigmático en la forma en que las organizaciones interactúan con sus datos, democratizando el acceso a insights avanzados para usuarios sin conocimientos técnicos profundos.
El gráfico anterior muestra una comparativa entre BigQuery y otras soluciones de almacén de datos en la nube, basada en investigaciones recientes. Como se puede observar, BigQuery destaca especialmente en escalabilidad y integración con tecnologías de IA, aunque todas las plataformas muestran fortalezas en diferentes áreas.
Arquitectura y Componentes Clave
| Componente | Descripción | Función Principal | Ventajas |
|---|---|---|---|
| Dremel | Motor de consultas distribuido que permite ejecutar SQL sobre petabytes de datos | Procesamiento paralelo masivo de consultas | Velocidad de consulta extremadamente alta en datos masivos |
| Colossus | Sistema de archivos distribuido de Google | Almacenamiento optimizado por columnas | Alta durabilidad, disponibilidad y eficiencia de almacenamiento |
| Jupiter Network | Red de alta velocidad entre centros de datos | Comunicación eficiente entre nodos de computación | Minimiza la latencia en consultas distribuidas |
| BigQuery ML | Capacidades de machine learning integradas | Creación y ejecución de modelos de ML con SQL | Elimina la necesidad de mover datos para análisis predictivo |
| BigQuery BI Engine | Servicio de análisis en memoria | Aceleración de consultas analíticas | Tiempos de respuesta subsegundo para dashboards interactivos |
| BigQuery Data Transfer Service | Servicio de transferencia automatizada de datos | Ingesta programada de datos desde diversas fuentes | Simplifica la gestión de ETL y garantiza datos actualizados |
Como se puede observar en la tabla anterior, la arquitectura de BigQuery se compone de múltiples sistemas distribuidos que trabajan en concierto para proporcionar un rendimiento analítico excepcional. Según Thallam (2020), esta arquitectura modular permite a Google mejorar continuamente componentes individuales sin afectar la experiencia global del usuario.
Mapa Conceptual de BigQuery
El siguiente mapa mental ilustra las principales características, capacidades y aplicaciones de BigQuery, proporcionando una visión holística de esta tecnología:
Casos de Uso Prácticos
Análisis de Datos en Tiempo Real
Una de las aplicaciones más potentes de BigQuery es el análisis de datos en tiempo real. Según García y Martínez (2023), organizaciones de diversos sectores están implementando pipelines de datos que alimentan BigQuery con información en tiempo real, permitiendo análisis inmediatos que impulsan decisiones operativas críticas.
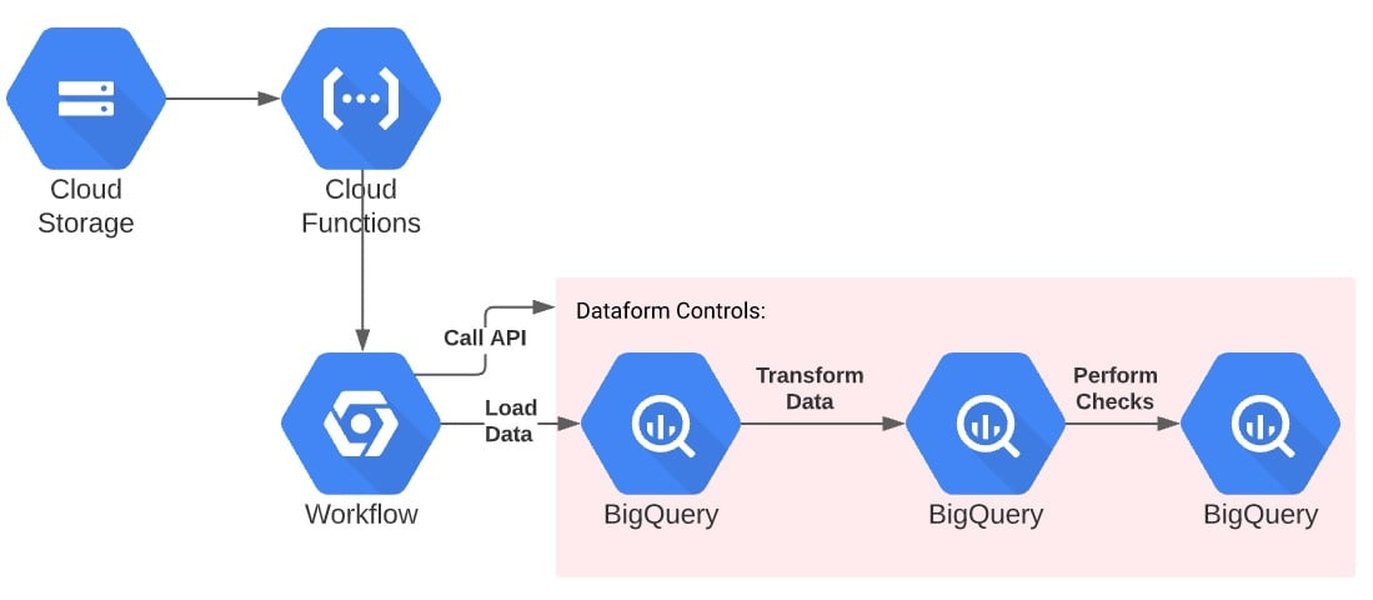
Como se muestra en la imagen anterior, el procesamiento de datos en tiempo real con BigQuery involucra múltiples componentes y etapas. Este enfoque permite a las organizaciones responder rápidamente a cambios en las condiciones del mercado, comportamiento del cliente o anomalías operativas.
Demostración Práctica de BigQuery
El siguiente video muestra una aplicación práctica de BigQuery integrada con tecnologías de IA como Langchain y Vector Search, ilustrando el potencial de BigQuery en el desarrollo de aplicaciones avanzadas de análisis de datos:
En esta demostración, se puede observar cómo BigQuery se integra con tecnologías de búsqueda vectorial para crear aplicaciones que pueden comprender y procesar consultas en lenguaje natural sobre grandes conjuntos de datos, expandiendo significativamente las posibilidades analíticas.
Preguntas Frecuentes sobre BigQuery
Referencias
- BigQuery Explained: An Overview of BigQuery's Architecture - Google Cloud Blog
- What is BigQuery - ResearchGate
- Cloud Computing Transformations in the Research Ecosystem - Frontiers
- BigLake: BigQuery's Evolution Toward a Multi-Cloud Lakehouse - Google Research
- Google BigQuery Architecture: A Comprehensive Exploration - Medium
- BigQuery: What it is, How it works and What it's used for - Knowi
- BigQuery Documentation - Google Cloud
Búsquedas Recomendadas

Last updated April 10, 2025