
Generative Adversarial Networks (GAN): Concetti Chiave
Una spiegazione dettagliata dei principali aspetti delle GAN
Principali Takeaway
- La funzione di perdita è cruciale per l'addestramento delle GAN
- Architetture moderne migliorano la stabilità e la qualità delle GAN
- Il mode collapse è uno dei problemi principali nelle GAN, ma esistono soluzioni efficaci
1. Funzione di Perdita nelle GAN
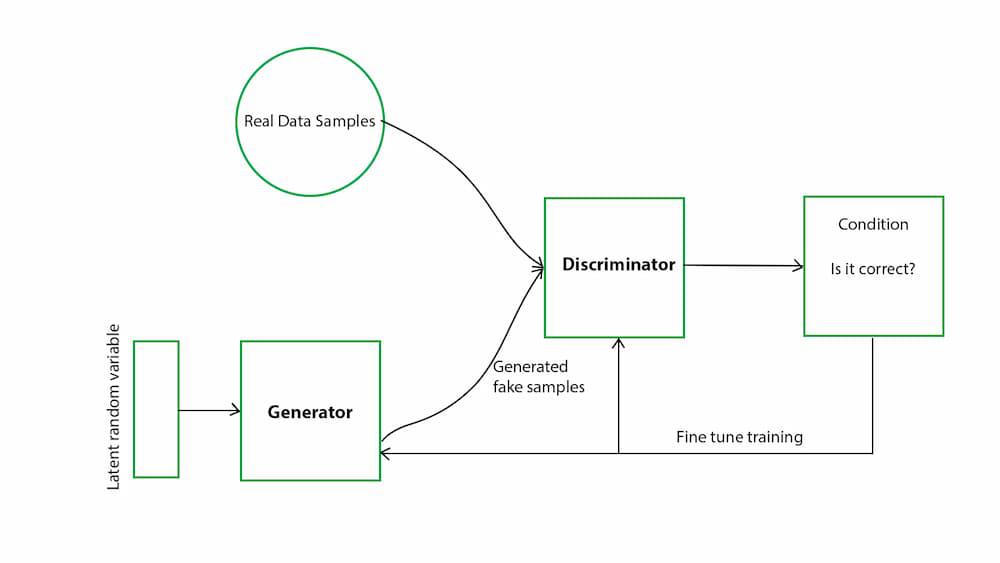
La funzione di perdita nelle Generative Adversarial Networks (GAN) è fondamentale per l'addestramento sia del generatore (G) che del discriminatore (D). La funzione di perdita determina quanto bene il generatore riesce a creare dati realistici che possono ingannare il discriminatore, mentre il discriminatore si sforza di distinguere tra dati reali e generati.
Tipi di Funzioni di Perdita
Binary Cross-Entropy (BCE)
Nelle GAN tradizionali, viene utilizzata la Binary Cross-Entropy (BCE) come funzione di perdita. Questa misura la divergenza tra le distribuzioni dei dati reali e generati. Tuttavia, la BCE può portare a problemi come il vanishing gradient, dove i gradienti diventano troppo piccoli per aggiornare efficacemente i pesi delle reti neurali, e il mode collapse, in cui il generatore produce una varietà limitata di output.
Wasserstein Loss (W-Loss)
Per affrontare i problemi della BCE, è stata introdotta la Wasserstein Loss (W-loss) nelle Wasserstein GAN (WGAN). La W-loss utilizza la distanza di Wasserstein per misurare la differenza tra le distribuzioni di dati reali e generati, fornendo gradienti più stabili e mitigando i problemi di vanishing gradient e mode collapse. La W-loss favorisce una convergenza più regolare e migliora la qualità dei campioni generati.
Least Squares Loss
Un'altra variante è la Least Squares Loss, che riduce la probabilità di creare confini decisionali troppo netti nel discriminatore. Questo approccio favorisce una maggiore diversità negli output del generatore, contribuendo a superare il mode collapse.
2. Architetture Moderne (Modern Backbones)
Le architetture moderne nelle GAN si riferiscono a configurazioni avanzate di reti neurali che migliorano la qualità e la stabilità dell'addestramento. Queste architetture incorporano tecniche come le connessioni residue, l'attenzione auto-regolata e la normalizzazione, permettendo alle GAN di generare dati più realistici e mantenere un addestramento stabile.
Principali Architetture
ResNet
La ResNet introduce connessioni residue che facilitano l'addestramento di reti molto profonde. Queste connessioni permettono ai gradienti di fluire più facilmente attraverso la rete, riducendo il problema del vanishing gradient e migliorando la performance complessiva del modello.
EfficientNet
EfficientNet ottimizza il rapporto tra accuratezza e complessità computazionale, rendendo le GAN più efficienti senza sacrificare la qualità dei dati generati. Questa architettura scala in modo uniforme le dimensioni della rete, migliorando la capacità del generatore e del discriminatore di apprendere rappresentazioni complesse.
Transformer-based GANs
Le Transformer-based GANs adattano architetture basate su Transformer, integrando meccanismi di attenzione auto-regolata per catturare dipendenze a lungo raggio nei dati. Questo migliora la capacità delle GAN di modellare relazioni complesse all’interno dei dati, risultando in output più coerenti e realistici.
StyleGAN
StyleGAN è un'architettura avanzata che separa lo stile (caratteristiche globali) dal rumore (caratteristiche locali) nelle immagini generate. Questo consente un controllo più fine sulla generazione delle immagini, permettendo di manipolare aspetti specifici come l'illuminazione, l'espressione facciale o lo sfondo.
3. RPGAN (Relativistic Paired GAN)
Le RPGAN (Relativistic Paired GAN) sono una variante delle GAN che modificano la funzione di perdita per considerare le relazioni relative tra coppie di esempi anziché trattare i dati reali e generati in modo assoluto. Questo approccio migliora la stabilità dell'addestramento e produce risultati di qualità superiore rispetto alle GAN tradizionali.
Caratteristiche Principali
- Funzione Obiettivo Relativistica: Invece di assegnare una probabilità assoluta al discriminatore, RPGAN considera la probabilità relativa che un dato sia reale rispetto a un altro.
- Migliore Stabilità: La considerazione delle relazioni relative riduce il rischio di oscillazioni instabili durante l'addestramento.
- Qualità Migliorata: Le RPGAN tendono a generare immagini più realistiche e diversificate, grazie alla funzione di perdita più sofisticata.
Applicazioni
Le RPGAN sono particolarmente utili in applicazioni dove la qualità e la diversità dei dati generati sono cruciali, come nella generazione di immagini ad alta risoluzione, nella creazione di contenuti multimediali e nella sintesi di dati per la ricerca scientifica.
4. Gradient Penalty (Penalità del Gradiente)
La gradient penalty è una tecnica utilizzata principalmente nelle Wasserstein GAN con Gradient Penalty (WGAN-GP) per garantire che il discriminatore sia 1-Lipschitz continuo, una condizione necessaria per l'applicazione efficace della Wasserstein Loss. La gradient penalty aggiunge un termine alla funzione di perdita che penalizza le deviazioni dalla norma del gradiente pari a 1.
Scopo e Implementazione
La gradient penalty stabilizza l'addestramento assicurando che i gradienti del discriminatore non esplodano o scompaiono, prevenendo così problemi come il mode collapse. Viene implementata aggiungendo un termine di regolarizzazione alla funzione di perdita:
  \[
  \lambda \cdot \mathbb{E} \left[ (\|\nabla D(x)\|_2 - 1)^2 \right]
  \]
dove λ è un fattore di penalizzazione e \|\nabla D(x)\|_2 è la norma del gradiente del discriminatore rispetto ai suoi input.
Benefici
- Stabilità Migliorata: Previene oscillazioni instabili durante l'addestramento.
- Prevenzione del Mode Collapse: Favorisce una distribuzione più ampia e diversificata dei dati generati.
- Convergenza più Affidabile: Aiuta le GAN a convergere in modo più prevedibile verso un equilibrio stabile.
5. Convergenza Locale (Local Convergence)
La convergenza locale si riferisce al comportamento delle GAN durante l'ottimizzazione, dove il modello può convergere verso un equilibrio locale piuttosto che verso un'ottima soluzione globale. Questo fenomeno è spesso dovuto alla natura non convessa e competitiva dell'addestramento delle GAN, che può portare a stagnazione o oscillazioni.
Fattori Influenzanti
- Funzione di Perdita Complessa: La natura minimax della funzione di perdita rende difficile raggiungere una convergenza globale.
- Architettura del Modello: Scelte di architettura possono influenzare la stabilità e la capacità di convergenza.
- Iperparametri: Parametri come il tasso di apprendimento e la dimensione del batch possono impattare significativamente l'addestramento.
Strategie per Migliorare la Convergenza
- Utilizzo di Wasserstein Loss: Fornisce gradienti più significativi e stabilizza l'addestramento.
- Gradient Penalty: Garantisce che il discriminatore mantenga una continuità Lipschitz, migliorando la convergenza.
- Aggiustamenti del Tasso di Apprendimento: Ottimizzare i tassi di apprendimento per entrambi il generatore e il discriminatore può facilitare una convergenza più stabile.
- Regularizzazione: Tecniche di regularizzazione come batch normalization possono aiutare a prevenire oscillazioni durante l'addestramento.
6. Mode Collapse (Collasso dei Modi)
Il mode collapse è un problema comune nelle GAN in cui il generatore produce una varietà limitata di output, spesso ripetendo lo stesso pattern o "modo". Questo comportamento limita la diversità dei dati generati e riduce l'efficacia del modello.
Cause del Mode Collapse
- Divergenza nella Funzione di Perdita: La funzione di perdita può portare il generatore a trovare una "scorciatoia" che inganna il discriminatore senza riflettere la vera diversità dei dati reali.
- Architettura Non Adeguata: Architetture insufficientemente complesse possono limitare la capacità del generatore di apprendere una distribuzione completa.
- Scelta degli Iperparametri: Parametri non ottimizzati possono causare uno squilibrio nell'addestramento tra generatore e discriminatore.
Soluzioni per Mitigare il Mode Collapse
-
Wasserstein GAN con Gradient Penalty (WGAN-GP): Utilizza la Wasserstein Loss e la gradient penalty per stabilizzare l'addestramento e prevenire il mode collapse.
-
Minibatch Discrimination: Compara campioni all'interno di batch per incoraggiare la diversità nei dati generati.
-
Unrolled GANs: Permettono al generatore di anticipare i futuri gradienti del discriminatore, prevenendo l'overfitting a pochi modi.
-
Regularizzazione: Tecniche di regularizzazione aiutano a mantenere una distribuzione diversificata dei dati generati.
-
Bilanciamento del Tasso di Apprendimento: Ottimizzare i tassi di apprendimento per mantenere un equilibrio tra generatore e discriminatore.
Impatto del Mode Collapse
Il mode collapse riduce la capacità delle GAN di generare dati vari e realistici, limitando l'applicabilità del modello in scenari dove la diversità è essenziale, come nella generazione di immagini ad alta risoluzione, nella creazione di contenuti artistici e nella sintesi di dati per applicazioni scientifiche.
Conclusione
Le Generative Adversarial Networks (GAN) rappresentano una potente tecnologia per la generazione di dati realistici attraverso un processo di addestramento competitivo tra generatore e discriminatore. Comprendere e ottimizzare concetti chiave come la funzione di perdita, le architetture moderne, la gradient penalty, la convergenza locale e il mode collapse è essenziale per sviluppare GAN efficaci e performanti. Attraverso l'adozione di tecniche avanzate e architetture innovative, è possibile migliorare significativamente la qualità e la stabilità delle GAN, ampliando le loro applicazioni nel settore tecnologico e scientifico.
Riferimenti
Last updated January 22, 2025