
Як Створити Власний Benchmark для Штучних Інтелектів Типу ChatGPT, DeepSeek та Інших
Покроковий Гід для Оцінки та Порівняння Потужності AI Моделей
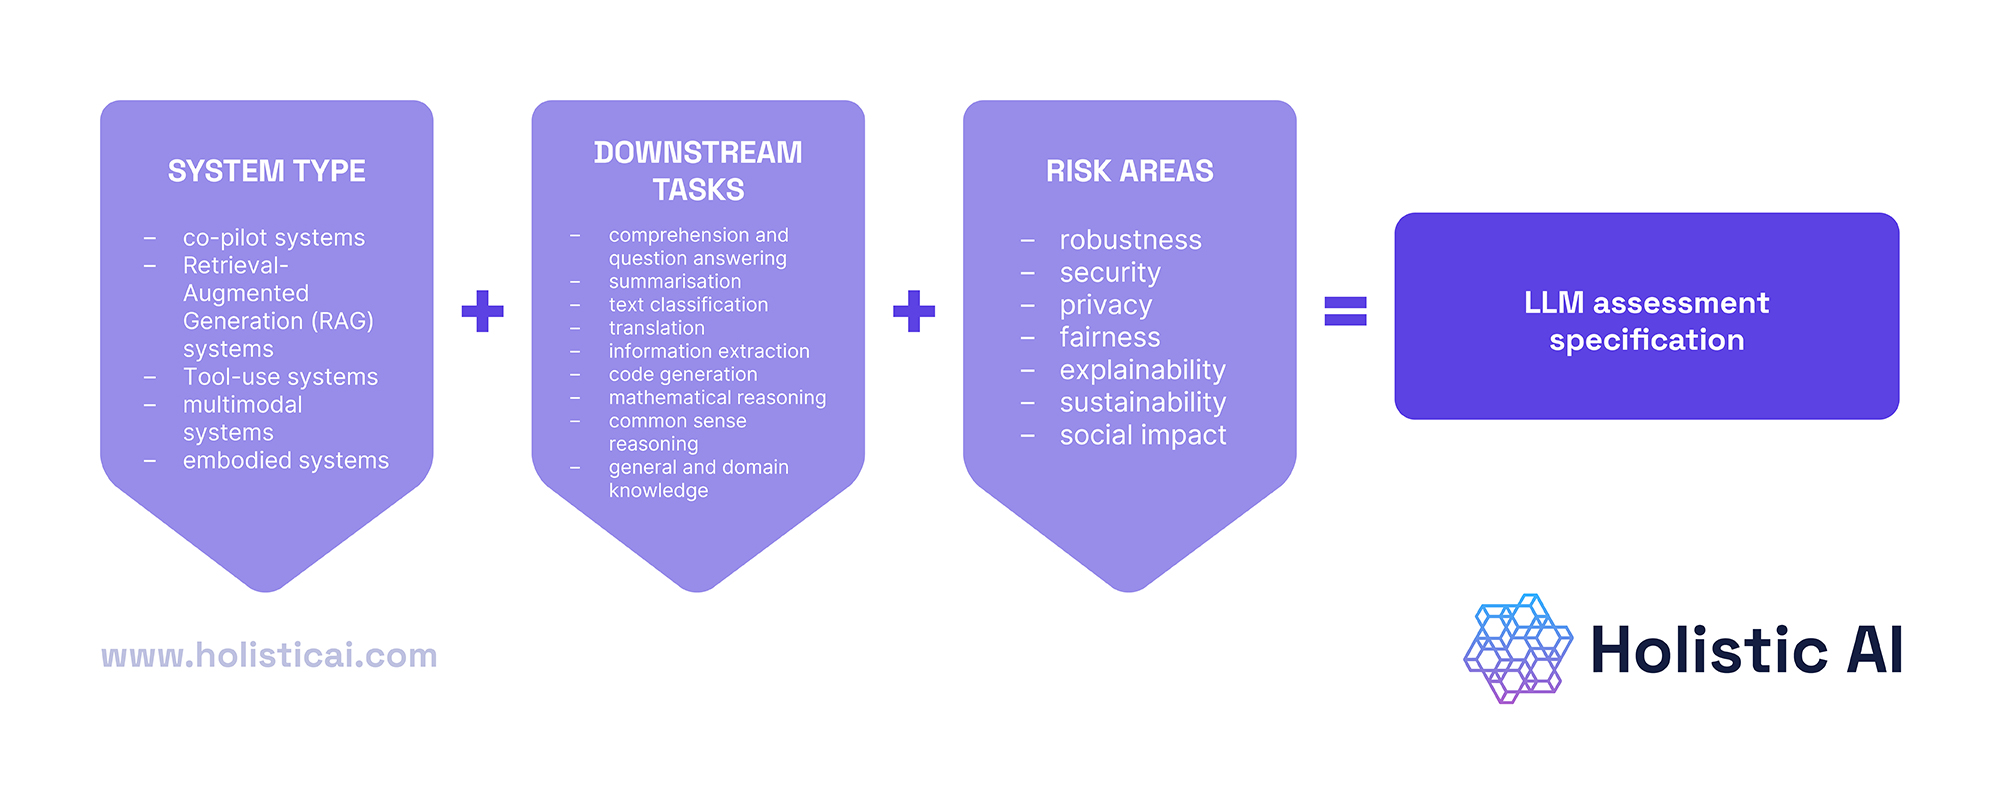
Ключові Висновки
- Визначення Цілей: Чітке формулювання мети бенчмарку є фундаментальним для вибору відповідних метрик та створення релевантного набору даних.
- Вибір Метрик та Наборів Даних: Правильний вибір показників ефективності та створення репрезентативного набору даних забезпечують об'єктивність та точність оцінки моделей.
- Аналіз та Документування: Детальний аналіз результатів та ретельне документування процесу дозволяє інтерпретувати отримані дані та сприяє повторюваності досліджень.
1. Визначення Мети та Завдань Бенчмарку
Першим кроком у створенні власного бенчмарку є чітке визначення його мети та завдань. Це дозволяє спрямувати подальші дії та забезпечити релевантність тестування.
1.1. Мета Бенчмарку
- Оцінка якості відповідей: точність, повнота, релевантність.
- Вимірювання швидкості обробки запитів та генерації відповідей.
- Здатність розуміти контекст та підтримувати послідовний діалог.
- Визначення креативності та логічного мислення моделі.
- Ефективність використання ресурсів: споживання GPU/CPU, оперативної пам'яті.
2. Вибір Метрик Оцінки
Вибір правильних метрик є критично важливим для об'єктивної оцінки продуктивності штучних інтелектів.
2.1. Кількісні Метрики
- Точність (Accuracy): Відсоток правильних відповідей на загальні запитання.
- BLEU та ROUGE Score: Метрики для оцінки збігу тексту відповіді моделі з еталонною відповіддю.
- Perplexity: Міра «передбачуваності» моделі на заданому текстовому наборі.
- F1-Score: Баланс між точністю та повнотою у класифікаційних завданнях.
2.2. Якісні Метрики
- Оцінка Людиною: Суб'єктивна оцінка якості відповідей експертами чи кінцевими користувачами.
- Аналіз Помилок: Визначення типів та частоти помилок, які допускає модель.
3. Створення Набору Даних
Набір даних повинен бути репрезентативним та охоплювати різні сценарії використання, що дозволить всебічно оцінити модель.
3.1. Види Даних
- Текстові запитання різної складності.
- Відповіді з різних предметних областей: медицина, економіка, фізика тощо.
- Завдання на кодування, математичні задачі, творче письмо.
- Сценарії для тестування послідовності та логічного мислення.
3.2. Розділення Набору Даних
- Навчальний Набір: Для тренування моделей.
- Тестовий Набір: Для оцінки продуктивності моделей на нових даних.
- Валідаційний Набір: Для налаштування параметрів моделі.
4. Вибір Моделей для Порівняння
Для об'єктивності порівняння необхідно вибрати декілька моделей штучного інтелекту, які будуть оцінюватися за однаковими критеріями.
4.1. Популярні Моделі
- ChatGPT
- DeepSeek
- Claude
- LLaMA
- Rytr
4.2. Характеристики Моделей
- Архітектура та розмір моделі.
- Технології, на яких побудовані моделі.
- Обсяг навчальних даних.
- Специфічні можливості та функціональності.
5. Розробка Тестових Завдань
Створення набору завдань, які будуть використовуватися для тестування моделей, є ключовим етапом бенчмарку.
5.1. Типи Завдань
- Відповіді на фактичні запитання.
- Генерація текстів на задану тему.
- Переклад текстів з однієї мови на іншу.
- Розв'язання математичних задач та кодування.
- Тестування логічного мислення та креативності.
5.2. Кількість та Репрезентативність
Необхідно забезпечити достатню кількість завдань для кожного типу, щоб результати тестування були статистично значущими та репрезентативними.
6. Методологія Тестування
Чітко визначена методологія забезпечує об'єктивність та точність проведення бенчмарку.
6.1. Застосування Різних Режимів Тестування
- Zero-shot Learning: Тестування моделей на завданнях, яких вони не бачили під час тренування.
- Few-shot Learning: Надання моделей кількох прикладів перед виконанням завдання для оцінки здатності до швидкого навчання.
- Fine-tuned Model Tests: Оцінка моделей після їх тонкого налаштування на специфічних даних.
6.2. Автоматизація Процесу Тестування
- Розробка скриптів для автоматичного запуску моделей на тестових завданнях.
- Автоматичне обчислення метрик за результатами виконання.
- Забезпечення однакових умов тестування для всіх моделей.
7. Оцінювання та Аналіз Результатів
Після проведення тестування необхідно ретельно проаналізувати отримані дані для визначення сильних та слабких сторін кожної моделі.
7.1. Порівняльний Аналіз
- Порівняння продуктивності моделей за обраними метриками.
- Визначення моделей, які показали найкращі результати у різних категоріях.
- Аналіз відхилень та аномалій у відповідях моделей.
7.2. Візуалізація Даних
Використання графіків та діаграм для наочного представлення результатів дозволяє легше інтерпретувати дані та виявити тенденції.
8. Документування Процесу та Результатів
Документування є важливим аспектом, що забезпечує повторюваність досліджень та дозволяє іншим дослідникам використовувати ваші дані для подальшого аналізу.
8.1. Опис Методології
- Детальний опис вибраних метрик та обґрунтування їх вибору.
- Опис створеного набору даних та критеріїв його формування.
- Покроковий опис процесу тестування та оцінювання моделей.
8.2. Звіти та Публікації
-
Створення детального звіту з результатами бенчмарку.
-
Публікація звітів у доступних форматах для спільноти дослідників.
-
Надання доступу до сирих даних для забезпечення прозорості дослідження.
9. Оновлення та Підтримка Бенчмарку
Штучний інтелект швидко розвивається, тому важливо регулярно оновлювати бенчмарк для відображення сучасних тенденцій та нових моделей.
9.1. Додавання Нових Моделей
Регулярно включайте нові моделі штучного інтелекту для забезпечення актуальності бенчмарку.
9.2. Розширення Набору Даних
Додавайте нові типи завдань та даних, щоб покращити об'єктивність та всебічність тестування.
Корисні Ресурси
Last updated January 28, 2025