
ปลดล็อกศักยภาพโปรเจกต์ CRYPPO ของคุณ: แนวทางตรวจสอบและแก้ไขข้อผิดพลาดอย่างละเอียด!
คู่มือฉบับสมบูรณ์เพื่อวิเคราะห์ปัญหา ปรับปรุงโค้ด และทำให้ระบบเทรดคริปโต RL ของคุณทำงานได้อย่างราบรื่น
การพัฒนาโปรเจกต์ขนาดใหญ่อย่าง CRYPPO ซึ่งเป็นระบบจำลองการเทรดคริปโตเคอร์เรนซีด้วย Reinforcement Learning (RL) นั้นมาพร้อมกับความท้าทายมากมาย โดยเฉพาะอย่างยิ่งเมื่อโค้ดเริ่มมีขนาดใหญ่และซับซ้อน ทำให้เกิดข้อผิดพลาด (error) และปัญหาต่างๆ ได้ง่าย คู่มือนี้มีจุดมุ่งหมายเพื่อช่วยให้คุณตรวจสอบโค้ดทุกส่วนของโปรเจกต์ CRYPPO ที่อยู่บน GitHub (https://github.com/GodEyeTee/cryppo) อย่างละเอียด พร้อมเสนอแนวทางการปรับปรุงและแก้ไขโค้ดเพื่อให้โปรเจกต์สามารถทำงานได้อย่างเต็มประสิทธิภาพในทุกฟังก์ชัน
ไฮไลท์สำคัญในการตรวจสอบและแก้ไขโปรเจกต์ CRYPPO
- การตรวจสอบ Dependencies และสภาพแวดล้อม: ให้ความสำคัญกับการตั้งค่าสภาพแวดล้อมการพัฒนาให้ถูกต้อง รวมถึงเวอร์ชันของ Python, PyTorch และไลบรารีอื่นๆ ที่ระบุใน
requirements.txtเพื่อหลีกเลี่ยงปัญหาความเข้ากันไม่ได้ - การจัดการข้อมูลอย่างมีประสิทธิภาพ: ตรวจสอบกระบวนการดาวน์โหลด ประมวลผล และจัดการข้อมูลตลาด (โดยเฉพาะไฟล์ Parquet และ PyTorch Tensors) อย่างละเอียด เพื่อให้มั่นใจว่าข้อมูลที่ป้อนเข้าสู่โมเดลมีความถูกต้องและไม่ก่อให้เกิดปัญหาคอขวดทางประสิทธิภาพ
- ความสมจริงของระบบจำลองการเทรด: ทบทวน Logic ในการจำลองสภาพแวดล้อมการเทรด เช่น การคำนวณค่าธรรมเนียม, Slippage, การจัดการสถานะ (Position) และเงื่อนไขการ Liquidation ให้มีความสมจริงมากที่สุด
- การปรับจูนและดีบักโมเดล RL: วิเคราะห์สถาปัตยกรรมของโมเดล Reinforcement Learning (DQN, Double DQN, Dueling DQN), Hyperparameters, และ Training Loop เพื่อให้มั่นใจว่าโมเดルสามารถเรียนรู้ได้อย่างมีประสิทธิภาพ
ขั้นตอนการตรวจสอบและปรับปรุงโค้ด CRYPPO โดยละเอียด
เพื่อให้การตรวจสอบและแก้ไขโปรเจกต์ CRYPPO เป็นไปอย่างมีระบบ เราจะแบ่งการพิจารณาออกเป็นส่วนต่างๆ ดังนี้:
1. การตั้งค่าสภาพแวดล้อมและการจัดการ Dependencies
ปัญหาหลายอย่างมักเริ่มต้นจากสภาพแวดล้อมการพัฒนาที่ไม่ถูกต้อง หรือ Dependencies ที่ขัดแย้งกัน
การตรวจสอบเบื้องต้น:
- Python Version: ตรวจสอบให้แน่ใจว่าคุณใช้ Python เวอร์ชัน 3.12 ขึ้นไป ตามที่ระบุใน README ของโปรเจกต์
- Virtual Environment: ควรสร้างและใช้งาน Virtual Environment (เช่น venv หรือ conda) เสมอ เพื่อแยก Dependencies ของโปรเจกต์นี้ออกจากโปรเจกต์อื่นๆ ป้องกันปัญหาเวอร์ชันชนกัน
python -m venv .venv # On Windows # .venv\Scripts\activate # On macOS/Linux # source .venv/bin/activate - Installation from
requirements.txt: ติดตั้ง Dependencies ทั้งหมดด้วยคำสั่ง:
ในระหว่างการติดตั้ง ให้สังเกตข้อผิดพลาดที่อาจเกิดขึ้น หากมีปัญหาเกี่ยวกับแพ็คเกจใดแพ็คเกจหนึ่ง (เช่น PyTorch, PyArrow) อาจต้องตรวจสอบเวอร์ชันที่ระบุในpip install -r requirements.txtrequirements.txtให้เข้ากันได้กับระบบปฏิบัติการและ Hardware ของคุณ (โดยเฉพาะ CUDA version สำหรับ PyTorch หากใช้ GPU) - PyTorch Installation: หากพบปัญหาในการติดตั้ง PyTorch หรือการใช้งาน GPU ตรวจสอบให้แน่ใจว่าคุณติดตั้งเวอร์ชันที่ถูกต้องและสอดคล้องกับไดรเวอร์ CUDA ของคุณ สามารถดูคำสั่งติดตั้งเฉพาะได้จากเว็บไซต์ทางการของ PyTorch
- Dependency Check: หลังจากการติดตั้ง ลองใช้คำสั่ง
pip checkเพื่อตรวจสอบว่ามี Dependencies ที่ไม่เข้ากันหรือขาดหายไปหรือไม่
ข้อเสนอแนะในการปรับปรุง:
- ระบุเวอร์ชันที่เจาะจง: ในไฟล์
requirements.txtควรระบุเวอร์ชันของแต่ละแพ็คเกจให้ชัดเจน (เช่นpandas==2.0.3แทนที่จะเป็นpandas) เพื่อให้มั่นใจว่าทุกคนในทีมพัฒนาใช้เวอร์ชันเดียวกันและลดปัญหาความเข้ากันไม่ได้ในอนาคต - การจัดการ Error ใน
setup.py(ถ้ามี): หากโปรเจกต์มีไฟล์setup.pyสามารถเพิ่มการตรวจสอบเวอร์ชัน Python เบื้องต้นได้# Example in setup.py or a pre-run script import sys if sys.version_info < (3, 12): sys.exit("Python 3.12+ is required.")
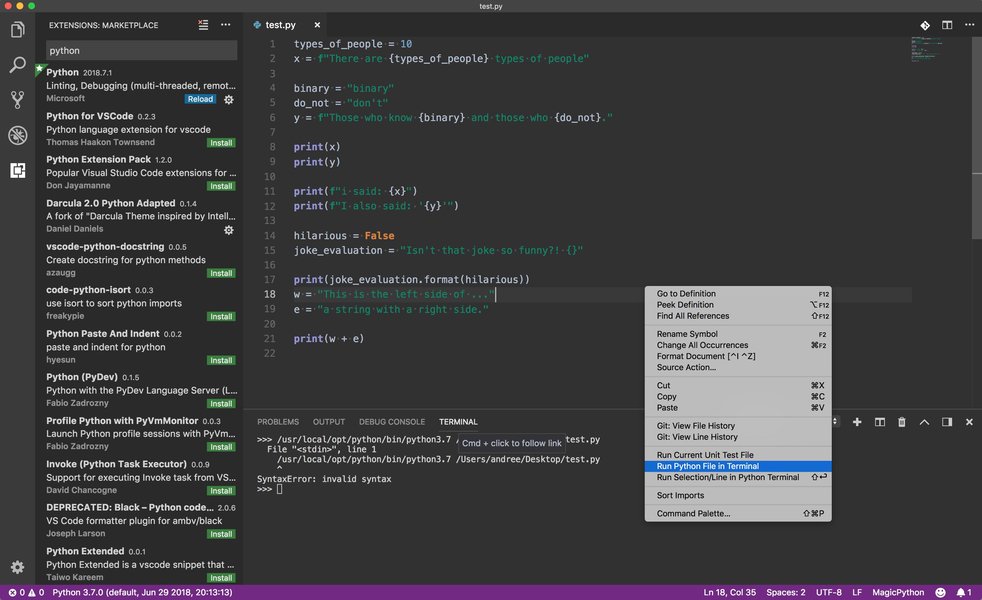
ภาพตัวอย่างข้อความแสดงข้อผิดพลาด Syntax Error ที่อาจพบระหว่างการพัฒนา
2. การจัดการข้อมูล: หัวใจสำคัญของ CRYPPO
CRYPPO ใช้ข้อมูลตลาดจำนวนมากในรูปแบบ Parquet และประมวลผลด้วย PyTorch Tensors การจัดการข้อมูลจึงเป็นส่วนสำคัญที่ต้องตรวจสอบอย่างละเอียด
การตรวจสอบการดาวน์โหลดและประมวลผลข้อมูล:
- CLI Commands: ตรวจสอบการทำงานของคำสั่ง CLI สำหรับดาวน์โหลดข้อมูล (
python -m src.cli.main data download ...) และประมวลผลข้อมูล (python -m src.cli.main data process ...)- ตรวจสอบ Path ของไฟล์และโฟลเดอร์ที่ระบุในคำสั่งและในไฟล์ Configuration
- ตรวจสอบว่าไฟล์ Parquet ถูกสร้างขึ้นอย่างถูกต้องในตำแหน่งที่คาดหวัง
- หากใช้ API ของ Binance ในการดึงข้อมูลดิบ ตรวจสอบการเชื่อมต่ออินเทอร์เน็ตและ API Key (ถ้ามี)
src.data.managers.data_manager.py:- Memory Mapping: ตรวจสอบการใช้งาน
memory_map=Trueเพื่อลดการใช้ RAM โดยเฉพาะเมื่อทำงานกับชุดข้อมูลขนาดใหญ่ - Batch Size: การตั้งค่า
batch_sizeที่ใหญ่เกินไปอาจทำให้เกิด MemoryError ควรปรับให้เหมาะสมกับทรัพยากรเครื่อง - Data Loading Logic: ตรวจสอบ Logic ในการโหลด Slice และ Batch ข้อมูลจากไฟล์ Parquet ไปยัง PyTorch Tensors
- Memory Mapping: ตรวจสอบการใช้งาน
src.data.processors.data_processor.pyและsrc.data.transforms.data_transforms.py:- Data Integrity: ตรวจสอบความถูกต้องของ Logic ในการทำความสะอาดข้อมูล, การจัดการ Missing Values, และการสร้าง Features เพิ่มเติม
- Normalization: การทำ Log Transform และ Z-score Normalization ควรตรวจสอบว่าดำเนินการอย่างถูกต้องและไม่ทำให้ข้อมูลผิดเพี้ยนไป
ข้อเสนอแนะในการปรับปรุง Data Handling:
- เพิ่ม Logging: ในโมดูลที่เกี่ยวข้องกับการจัดการข้อมูล (
data_manager.py,data_processor.py) ควรเพิ่ม Logging statement เพื่อติดตามขั้นตอนการทำงาน, ขนาดของข้อมูล, หรือข้อผิดพลาดที่อาจเกิดขึ้น เช่น การไม่พบไฟล์, ปัญหาการอ่านไฟล์ Parquet# In data_manager.py, for example import logging logger = logging.getLogger(__name__) # ... inside a method ... file_path = "path/to/your/data.parquet" if not os.path.exists(file_path): logger.error(f"Data file not found: {file_path}") raise FileNotFoundError(f"Data file not found: {file_path}") try: self.data = pd.read_parquet(file_path) logger.info(f"Successfully loaded data from {file_path}, shape: {self.data.shape}") except Exception as e: logger.error(f"Error loading parquet file {file_path}: {e}") raise - Error Handling ที่แข็งแกร่งขึ้น: ใช้
try-exceptblock ครอบส่วนที่อาจเกิดข้อผิดพลาด เช่น การอ่านไฟล์ หรือการแปลงข้อมูล เพื่อให้โปรแกรมสามารถแจ้งเตือนหรือจัดการกับปัญหาได้อย่างเหมาะสม แทนที่จะ Crash ทันที - ตรวจสอบ Path อย่างละเอียด: ก่อนการดำเนินการใดๆ กับไฟล์ ควรมีการตรวจสอบว่า Path นั้นถูกต้องและไฟล์มีอยู่จริงหรือไม่ เพื่อป้องกัน
FileNotFoundError
3. เจาะลึกระบบจำลองการเทรด
ความถูกต้องของระบบจำลองการเทรด (Trading Environment) ใน src.environment.trading_env.py และ src.environment.simulators.trading_simulator.py เป็นสิ่งสำคัญอย่างยิ่งต่อประสิทธิภาพของโมเดล RL
จุดที่ต้องตรวจสอบ:
- การจัดการ Action และ Position: ตรวจสอบ Logic การรับ Action จาก Agent (LONG, SHORT, EXIT) และการอัปเดตสถานะของ Position (ขนาด, ราคาเข้า, PnL)
- การคำนวณทางการเงิน:
- Fee Rate: ค่าธรรมเนียมการเทรดถูกนำมาคำนวณอย่างถูกต้องหรือไม่?
- Slippage: มีการจำลอง Slippage หรือไม่ และสมเหตุสมผลเพียงใด?
- Profit/Loss Calculation: สูตรการคำนวณกำไรขาดทุนถูกต้องหรือไม่?
- เงื่อนไขพิเศษ:
- Liquidation: เงื่อนไขการ Liquidation (ล้างพอร์ต) ถูกต้องและทำงานตามที่คาดหวังหรือไม่?
- Stop Loss/Take Profit: หากมีการใช้งาน ตรวจสอบ Logic การทำงานให้ดี
- State Representation: ข้อมูล State ที่ส่งกลับไปยัง Agent ครบถ้วนและสะท้อนสภาวะตลาดและ Portfolio ได้อย่างถูกต้องหรือไม่?
- Reward Function: Reward ที่ให้แก่ Agent สอดคล้องกับเป้าหมายการเทรดหรือไม่?
ข้อเสนอแนะในการปรับปรุง Environment:
- Unit Tests สำหรับ Trading Logic: สร้าง Unit Test เพื่อทดสอบสถานการณ์ต่างๆ ในการเทรด เช่น การเปิด Long Position, การปิด Short Position ที่มีกำไร/ขาดทุน, การเกิด Liquidation, การทำงานของ Stop Loss สิ่งนี้จะช่วยให้มั่นใจได้ว่า Logic หลักทำงานถูกต้อง
- Parameterization: ค่าต่างๆ เช่น fee_rate, slippage_rate, leverage ควรสามารถปรับเปลี่ยนได้ง่ายผ่านไฟล์ Configuration เพื่อให้สามารถทดลองกับเงื่อนไขตลาดที่แตกต่างกันได้
- Detailed Logging: บันทึกทุก Transaction และการเปลี่ยนแปลง State ที่สำคัญใน Simulator เพื่อช่วยในการ Debugging เมื่อผลลัพธ์การเทรดไม่เป็นไปตามที่คาดหวัง
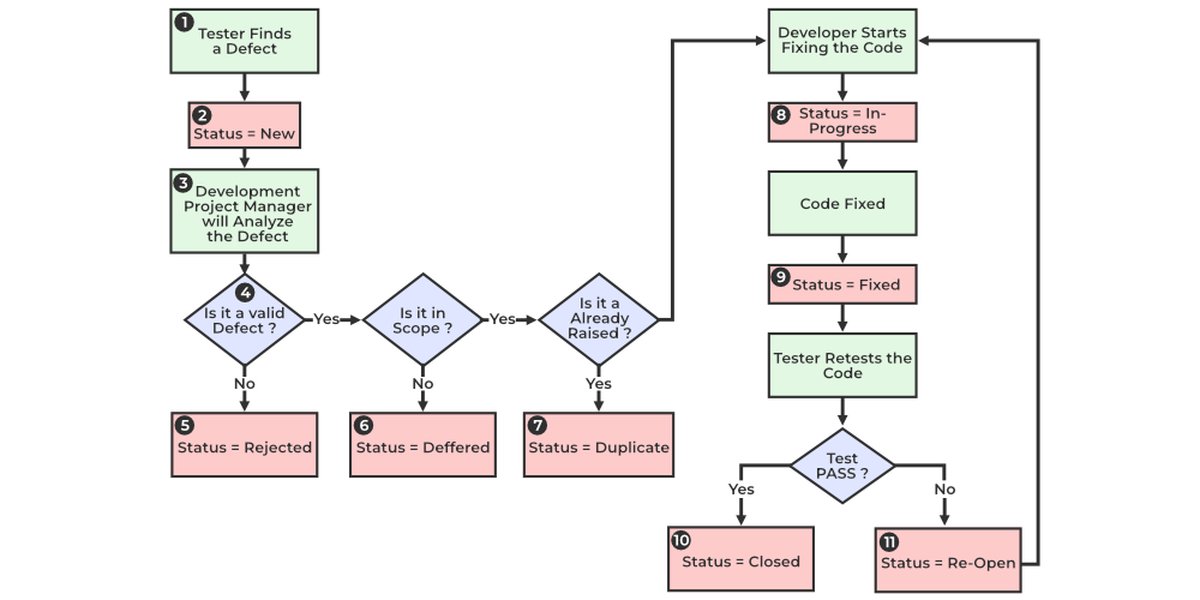
ภาพแสดงวงจรชีวิตของ Bug ซึ่งช่วยให้เข้าใจกระบวนการจัดการข้อผิดพลาดในการพัฒนาซอฟต์แวร์
4. การพัฒนาและดีบักโมเดล Reinforcement Learning
ส่วนของโมเดล RL (DQN, Double DQN, Dueling DQN) ใน src.models เป็นหัวใจหลักในการตัดสินใจเทรด ปัญหาในส่วนนี้อาจทำให้โมเดลไม่เรียนรู้หรือมีประสิทธิภาพต่ำ
จุดที่ควรตรวจสอบ:
- Network Architecture (ใน
src.models.components.networks):- Input/Output Shapes: ตรวจสอบว่า Input Shape ของ Network ตรงกับข้อมูล State ที่มาจาก Environment และ Output Shape ตรงกับจำนวน Action ที่เป็นไปได้
- Layer Configuration: ความเหมาะสมของจำนวน Layer, ชนิดของ Layer (Dense, LSTM, Conv), และ Activation Functions
- Hyperparameters: Learning Rate, Batch Size, Gamma (Discount Factor), Epsilon (for Epsilon-Greedy policy), Target Network Update Frequency เป็นค่าที่สำคัญและส่งผลต่อการเรียนรู้ของโมเดลอย่างมาก
- Training Loop (ในไฟล์โมเดลแต่ละตัว เช่น
dqn.py):- Loss Function: ตรวจสอบว่า Loss Function ที่ใช้ (เช่น MSELoss) เหมาะสมหรือไม่
- Optimizer: การเลือก Optimizer (เช่น Adam, RMSprop) และการตั้งค่า Learning Rate
- Gradient Clipping: อาจจำเป็นต้องใช้เพื่อป้องกัน Exploding Gradients
- Data Sampling from Replay Memory (ใน
src.models.components.memories): ตรวจสอบ Logic การสุ่ม Batch จาก Replay Memory
- CUDA / GPU Usage:
- ตรวจสอบว่าโมเดลและ Tensors ถูกย้ายไปยัง Device ที่ถูกต้อง (
.to(device)) - หากใช้ GPU หลายตัว ตรวจสอบการตั้งค่า DataParallel หรือ DistributedDataParallel
- ตรวจสอบว่าโมเดลและ Tensors ถูกย้ายไปยัง Device ที่ถูกต้อง (
ข้อเสนอแนะในการปรับปรุง RL Models:
- Experiment Tracking: ใช้เครื่องมือเช่น TensorBoard หรือ Weights & Biases เพื่อติดตามค่า Loss, Reward, Epsilon และ Metrics อื่นๆ ในระหว่างการ Training จะช่วยให้เห็นภาพรวมและดีบักได้ง่ายขึ้น
- Simplify First: หากโมเดลซับซ้อนเกินไปและไม่เรียนรู้ ลองเริ่มจากสถาปัตยกรรมที่ง่ายกว่า หรือลดจำนวน State Variables เพื่อดูว่าปัญหาอยู่ที่ใด
- Hyperparameter Tuning: ใช้เทคนิคการปรับจูน Hyperparameter เช่น Grid Search, Random Search หรือ Bayesian Optimization
- ตรวจสอบ Input Data ที่เข้าโมเดล: ก่อนเริ่ม Training ให้ลองตรวจสอบค่าของ Batch ข้อมูลที่ป้อนเข้าโมเดลว่ามีลักษณะตามที่คาดหวังหรือไม่ (เช่น Normalized, ไม่มีค่า NaN)
- เพิ่ม
try-exceptใน Training Loop: เพื่อจับข้อผิดพลาดที่อาจเกิดขึ้นระหว่างการคำนวณ Loss หรือ Backpropagation# Example in a training step within a model file try: # ... your training code, loss calculation, optimizer step ... loss = self.criterion(current_q_values, target_q_values) self.optimizer.zero_grad() loss.backward() # torch.nn.utils.clip_grad_norm_(self.policy_net.parameters(), MAX_GRAD_NORM) # Optional self.optimizer.step() if epoch % 10 == 0: # Log loss periodically logger.info(f"Epoch {epoch}, Loss: {loss.item()}") except Exception as e: logger.error(f"Training error at epoch {epoch}: {e}", exc_info=True) # Potentially save model or break loop raise # or break
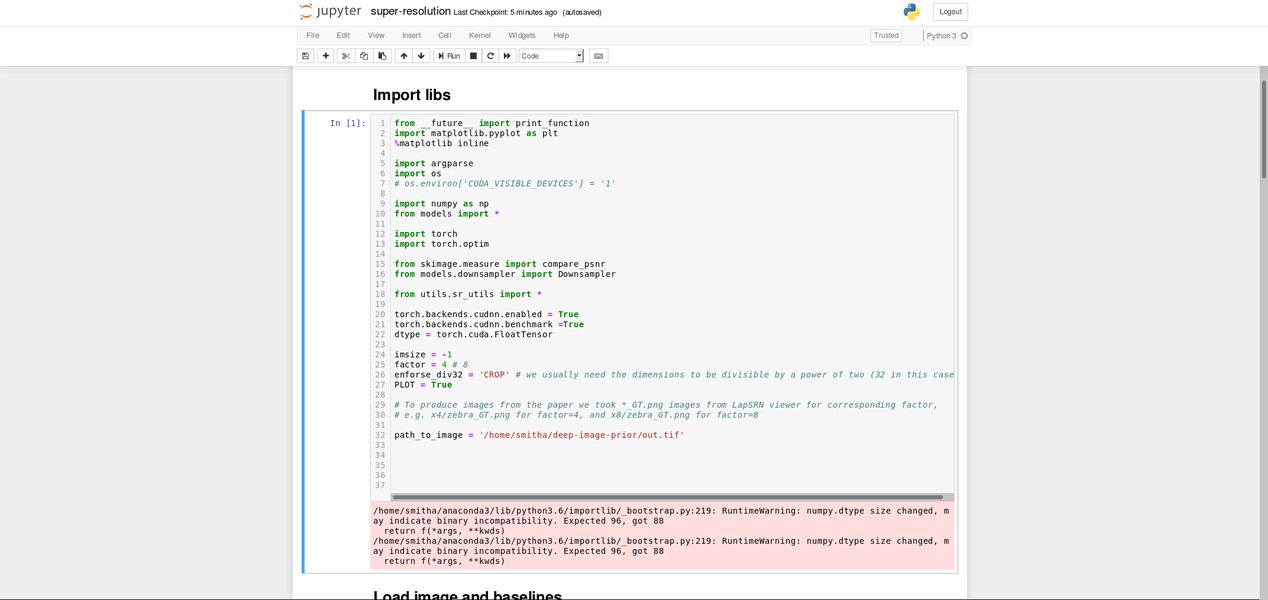
ภาพตัวอย่าง Runtime Error ที่พบบ่อยใน PyTorch เมื่อขนาดของ Input และ Target ไม่ตรงกัน ซึ่งอาจเกิดขึ้นใน Training Loop
5. เครื่องมือ CLI และการกำหนดค่า (Configuration)
โปรเจกต์ CRYPPO มี Command Line Interface (CLI) ใน src.cli สำหรับการทำงานต่างๆ และใช้ไฟล์ Configuration ใน configs/
จุดตรวจสอบ:
- Argument Parsing: ตรวจสอบว่า CLI สามารถ Parse Arguments ต่างๆ ได้อย่างถูกต้อง และมี Default Value ที่เหมาะสม
- Configuration File Loading: ตรวจสอบ Logic การโหลดไฟล์ Config (เช่น YAML, JSON) และการเข้าถึงค่า Config ต่างๆ ภายในโปรเจกต์ (อาจผ่าน
src.utils.config_manager.pyหากมี) - Clarity of CLI Commands: คำสั่ง CLI เข้าใจง่ายและใช้งานสะดวกหรือไม่? มี Help Message ที่ชัดเจนหรือไม่?
- Validation of Config Values: มีการตรวจสอบความถูกต้องของค่าในไฟล์ Config หรือไม่? (เช่น leverage ต้องมากกว่า 0, fee_rate อยู่ระหว่าง 0 ถึง 1)
ข้อเสนอแนะในการปรับปรุง CLI และ Configs:
- Input Validation ใน CLI: เพิ่มการตรวจสอบ (Validation) สำหรับ Arguments ที่รับเข้ามา เช่น ประเภทข้อมูล, ช่วงของค่าที่ยอมรับได้
# Example in a CLI command function (e.g., using Click or Argparse) import click @click.command() @click.option('--batch-size', type=int, default=64, help='Size of each training batch.') def train(batch_size): if batch_size <= 0: raise click.BadParameter("Batch size must be a positive integer.") # ... rest of the training logic ... - Schema Validation สำหรับ Configs: ใช้ไลบรารีเช่น
PydanticหรือJSONSchemaเพื่อ Validate โครงสร้างและประเภทข้อมูลของไฟล์ Configuration ซึ่งจะช่วยลดข้อผิดพลาดจากการตั้งค่าที่ไม่ถูกต้อง - Verbose/Logging Level Option: เพิ่ม Option ใน CLI เพื่อให้ผู้ใช้สามารถกำหนดระดับของ Logging (เช่น
--verboseหรือ--log-level DEBUG) เพื่อช่วยในการดีบัก
การประเมินภาพรวมสุขภาพโปรเจกต์ CRYPPO (Radar Chart)
Radar chart ด้านล่างนี้แสดงการประเมินภาพรวมสุขภาพของโปรเจกต์ CRYPPO ในด้านต่างๆ โดยเปรียบเทียบ "สถานะปัจจุบัน (โดยประมาณ)" กับ "เป้าหมายที่ควรจะเป็น" เพื่อให้เห็นภาพรวมของจุดที่ควรให้ความสำคัญในการปรับปรุง (ค่าประเมินเป็นเพียงสมมติฐานเพื่อเป็นแนวทาง)
การปรับปรุงในแต่ละด้านที่แสดงใน Radar chart จะช่วยยกระดับคุณภาพและความน่าเชื่อถือของโปรเจกต์ CRYPPO ได้อย่างมาก
แผนผังแนวทางการตรวจสอบและแก้ไขปัญหา (Mindmap)
Mindmap นี้จะช่วยให้เห็นภาพรวมของส่วนประกอบหลักในโปรเจกต์ CRYPPO และจุดที่มักเกิดปัญหา เพื่อเป็นแนวทางในการตรวจสอบและแก้ไขอย่างเป็นระบบ
Troubleshooting Roadmap"] id1["การติดตั้งและ Dependencies
(Installation & Dependencies)"] id1_1["ตรวจสอบ Python/PyTorch versions"] id1_2["ตั้งค่า Virtual Environment"] id1_3["จัดการ
requirements.txt"]
id1_4["ปัญหา CUDA/GPU Compatibility"]
id2["การจัดการข้อมูล(Data Management)"] id2_1["ดาวน์โหลด/ประมวลผลข้อมูล
(CLI Commands)"] id2_2["การทำงานกับ Parquet
& PyTorch Tensors"] id2_3["ปัญหา MemoryError
(Batch Size, Memory Map)"] id2_4["ความถูกต้องของ Normalization"] id2_5["Path และ File Access"] id3["Environment จำลอง
(Trading Environment)"] id3_1["Trading Logic
(Fees, Slippage, PnL)"] id3_2["การจัดการ State/Action"] id3_3["เงื่อนไข Liquidation/StopLoss"] id3_4["Reward Function Design"] id4["โมเดล RL
(RL Models - DQN, etc.)"] id4_1["ตรวจสอบ Hyperparameters"] id4_2["สถาปัตยกรรม Network
(Input/Output Shapes)"] id4_3["Training Loop Logic
(Loss, Optimizer)"] id4_4["Replay Memory"] id4_5["การใช้งาน CUDA"] id5["CLI และ Configs
(CLI & Configuration)"] id5_1["Argument Parsing
ใน CLI"] id5_2["การโหลดไฟล์ Config
และความถูกต้องของค่า"] id6["การทดสอบและ Logging
(Testing & Logging)"] id6_1["เพิ่ม Unit Tests
(PyTest)"] id6_2["เพิ่ม Detailed Logging
ทั่วทั้งโปรเจกต์"] id6_3["ใช้ Debugger
(pdb, VSCode Debugger)"]
การไล่ตรวจสอบตามแผนผังนี้จะช่วยให้คุณสามารถระบุและแก้ไขปัญหาได้อย่างมีทิศทางมากขึ้น
ตารางสรุปปัญหาที่พบบ่อยและแนวทางการแก้ไขใน CRYPPO
ตารางด้านล่างนี้รวบรวมปัญหาที่มักพบบ่อยในการพัฒนาโปรเจกต์ลักษณะนี้ พร้อมสาเหตุที่เป็นไปได้และแนวทางการแก้ไขเบื้องต้น:
| ปัญหา (Issue) | สาเหตุที่เป็นไปได้ (Potential Cause) | แนวทางแก้ไข (Suggested Solution) |
|---|---|---|
ModuleNotFoundError |
- แพ็คเกจยังไม่ได้ติดตั้ง - Virtual Environment ไม่ได้ Activate - ชื่อโมดูล Import ผิดพลาด - ปัญหา PYTHONPATH |
- ติดตั้งแพ็คเกจด้วย pip install -r requirements.txt- Activate Virtual Environment - ตรวจสอบการสะกดชื่อโมดูลและโครงสร้างโปรเจกต์ - ตรวจสอบการตั้งค่า PYTHONPATH (ถ้ามี) |
MemoryError หรือ โปรแกรมช้ามาก |
- batch_size ใหญ่เกินไป- โหลดข้อมูลทั้งหมดเข้า RAM โดยไม่จำเป็น - ไม่ได้ใช้ memory_map=True สำหรับข้อมูลขนาดใหญ่- Memory Leak ในโค้ด |
- ลดขนาด batch_size- ใช้ Data Generator หรือโหลดข้อมูลเท่าที่จำเป็น - เปิดใช้งาน memory_map=True ใน data_manager.py- Profiling โค้ดเพื่อหาจุดที่เกิด Memory Leak (เช่น ด้วย memory_profiler) |
FileNotFoundError (สำหรับไฟล์ข้อมูล) |
- Path ที่ระบุไม่ถูกต้อง - ไฟล์ยังไม่ได้ดาวน์โหลดหรือประมวลผล - พิมพ์ชื่อไฟล์ผิด |
- ตรวจสอบ Path ให้ถูกต้องทั้งในโค้ดและไฟล์ Config - รันคำสั่ง CLI สำหรับดาวน์โหลด/ประมวลผลข้อมูลก่อน - เพิ่มการตรวจสอบ Path และการมีอยู่ของไฟล์ก่อนใช้งาน |
| โมเดล RL ไม่เรียนรู้ (Loss ไม่ลดลง, Reward ไม่เพิ่มขึ้น) | - Hyperparameters ไม่เหมาะสม (เช่น Learning Rate สูง/ต่ำไป) - สถาปัตยกรรม Network ไม่เหมาะสม - Reward Function ออกแบบไม่ดี - Bug ใน Training Loop หรือ Environment - ข้อมูล Input มีปัญหา (เช่น ไม่ได้ Normalize, มีค่าผิดปกติ) |
- ทำ Hyperparameter Tuning - ลองปรับสถาปัตยกรรม Network (เริ่มจากแบบง่ายๆ) - ทบทวนและปรับปรุง Reward Function - ดีบัก Training Loop และ Environment อย่างละเอียด - ตรวจสอบคุณภาพของข้อมูล Input |
| ผลลัพธ์ Backtest ไม่สมจริง (กำไรสูง/ต่ำเกินไป) | - Bug ใน Trading Simulator (เช่น การคำนวณ Fee, Slippage, PnL ผิดพลาด) - Look-ahead Bias (ใช้ข้อมูลอนาคตในการตัดสินใจ) - Overfitting กับชุดข้อมูล Test - การตั้งค่า Parameter ใน Backtest ไม่เหมาะสม |
- ทำ Unit Test สำหรับ Trading Simulator - ตรวจสอบให้แน่ใจว่าไม่มีการใช้ข้อมูลอนาคต - แบ่งข้อมูล Train/Validation/Test ให้ดี - ตรวจสอบและปรับ Parameter ของ Backtest (เช่น Initial Balance, Leverage) |
| CUDA/GPU Errors (เช่น "CUDA out of memory") | - Model หรือ Tensor ไม่ได้ถูกย้ายไป GPU (.to(device))- VRAM ไม่เพียงพอสำหรับ Model และ Batch Size ปัจจุบัน - ไดรเวอร์ CUDA หรือ PyTorch เวอร์ชันไม่เข้ากัน |
- ตรวจสอบการใช้ .to(device) ให้ถูกต้อง- ลด batch_size, ใช้ Mixed Precision (torch.cuda.amp), หรือใช้ Model ที่เล็กกว่า- อัปเดตไดรเวอร์ CUDA และตรวจสอบความเข้ากันได้ของเวอร์ชัน PyTorch |
กลยุทธ์การดีบักและการทดสอบเพิ่มเติม
การเพิ่มประสิทธิภาพและการจัดการทรัพยากร
torch.no_grad(): ในระหว่างการ Evaluation หรือ Inference ให้ใช้with torch.no_grad():เพื่อปิดการคำนวณ Gradient ซึ่งจะช่วยประหยัดหน่วยความจำและเพิ่มความเร็วpin_memory=True: ใน DataLoader ของ PyTorch การตั้งค่าpin_memory=True(เมื่อใช้ GPU) สามารถช่วยเร่งการถ่ายโอนข้อมูลจาก CPU ไป GPU ได้num_workers: ใน DataLoader การเพิ่มnum_workersสามารถช่วยให้การโหลดข้อมูลเป็นแบบ Multi-process ทำให้ CPU ไม่ได้เป็นคอขวด- Mixed Precision Training: หากใช้ GPU ที่รองรับ (เช่น NVIDIA Tensor Cores) การใช้
torch.cuda.amp(Automatic Mixed Precision) สามารถลดการใช้ VRAM และเร่งการ Training ได้อย่างมาก โดยที่ยังคงความแม่นยำของโมเดลได้ดี
การใช้ Debugger และ Logging
- Python Debugger (pdb): ใช้
import pdb; pdb.set_trace()ในจุดที่ต้องการตรวจสอบค่าของตัวแปรหรือ Flow การทำงานของโปรแกรม - IDE Debuggers: หากใช้ IDE เช่น VSCode หรือ PyCharm ให้ใช้ Debugger ที่มาพร้อมกับ IDE ซึ่งมักจะใช้งานง่ายและมี Feature ครบครัน
- Logging ที่ละเอียด: กำหนดค่า Logging Level (DEBUG, INFO, WARNING, ERROR, CRITICAL) และเขียน Log Message ที่มีประโยชน์ในส่วนต่างๆ ของโค้ด จะช่วยให้ติดตามการทำงานและหาสาเหตุของปัญหาได้ง่ายขึ้น โดยเฉพาะเมื่อรันโปรแกรมเป็นเวลานานหรือบน Server
การเขียน Unit Tests
การเขียน Unit Test สำหรับโมดูลที่สำคัญ (เช่น Data Processor, Trading Simulator, ส่วนประกอบของ RL Model) จะช่วยให้มั่นใจได้ว่าแต่ละส่วนทำงานถูกต้องตามที่คาดหวัง และช่วยป้องกัน Regression (Bug ที่กลับมาใหม่) เมื่อมีการแก้ไขโค้ดในอนาคต ใช้ Framework เช่น pytest เพื่อช่วยในการเขียนและรัน Test
# ตัวอย่างโครงสร้าง Test ใน tests/data/test_data_manager.py ด้วย pytest
# import pytest
# from src.data.managers.data_manager import MarketDataManager # สมมติ

# def test_load_data_successfully(tmp_path):
#     # สร้างไฟล์ Parquet จำลองใน tmp_path
#     # d = tmp_path / "sub"
#     # d.mkdir()
#     # p = d / "test_data.parquet"
#     # # สร้าง DataFrame ตัวอย่างและ save เป็น parquet ที่ p
#     # mock_df = pd.DataFrame({'col1': [1, 2], 'col2': [3, 4]})
#     # mock_df.to_parquet(p)

#     # manager = MarketDataManager(file_path=str(p), ...)
#     # data = manager.load_data() # หรือ method ที่เกี่ยวข้อง
#     # assert data is not None
#     # assert not data.empty
#     # assert data.shape[0] > 0
#     pass # Placeholder for actual test logic

# def test_handle_missing_file():
#     # manager = MarketDataManager(file_path="non_existent_file.parquet", ...)
#     # with pytest.raises(FileNotFoundError):
#     #    manager.load_data()
#     pass # Placeholder
การรัน Test สามารถทำได้ด้วยคำสั่ง pytest ใน Terminal
คำถามที่พบบ่อย (FAQ)
คำแนะนำสำหรับการค้นคว้าเพิ่มเติม
หากคุณต้องการศึกษาเพิ่มเติมในประเด็นที่เกี่ยวข้อง ลองใช้คำค้นหาเหล่านี้:
- เทคนิคการดีบักโปรแกรม Python สำหรับโปรเจกต์ขนาดใหญ่
- วิธีเพิ่มประสิทธิภาพการใช้หน่วยความจำใน PyTorch
- แนวทางการแก้ไขปัญหาโมเดル Reinforcement Learning ไม่ยอม Converge
- การเขียน Unit Test สำหรับระบบจำลองการเทรดด้วย PyTest
แหล่งอ้างอิง
Last updated May 11, 2025