
揭秘CUDA GEMM精度之谜:为何GPU矩阵乘法与黄金标准存在差异?
深入探究CUDA通用矩阵乘法(GEMM)在与参考结果对比时产生误差的深层原因与缓解策略。
当在CUDA环境下实现通用矩阵乘法(GEMM)算法时,与“黄金标准”(通常指CPU上的精确参考实现或优化后的库函数如cuBLAS的理想输出)进行对比,常常会观察到计算结果存在微小误差。这种误差并非CUDA的缺陷,而是由多种复杂因素共同作用的结果,涵盖了浮点数运算的本质限制、GPU架构的并行特性、以及算法和库实现的具体细节。
核心洞察:CUDA GEMM误差的成因
- 浮点数的固有局限性:计算机中浮点数(如FP32、FP16)采用有限二进制位表示,导致无法精确表示所有实数,从而产生舍入误差,这些误差在大量运算中累积。
- GPU并行计算的不确定性:GPU的并行特性可能导致运算顺序与CPU不同,由于浮点运算不完全满足结合律,不同的累加顺序会引入微小差异。
- 硬件与库实现的复杂性:NVIDIA GPU上的Tensor Cores与CUDA Cores在计算精度和优化策略上存在差异,cuBLAS等库的算法选择和内部优化也可能影响最终结果。
本文将详细剖析这些误差的成因,并探讨相关的技术细节,帮助您更深入地理解CUDA GEMM的数值行为。
浮点数本质:精度限制与累积误差
理解CUDA GEMM误差的根本,在于浮点数在计算机中的表示方式。无论是CPU还是GPU,都采用IEEE 754标准来表示浮点数,但这是一种近似表示,而非精确表示。
有限精度与舍入误差
浮点数(例如单精度FP32或双精度FP64)使用有限数量的二进制位来存储。这意味着许多十进制小数(如0.1)无法被精确地表示为有限位的二进制小数,这类似于十进制中1/3无法被精确表示为有限位小数。这种固有的不精确性导致了舍入误差。
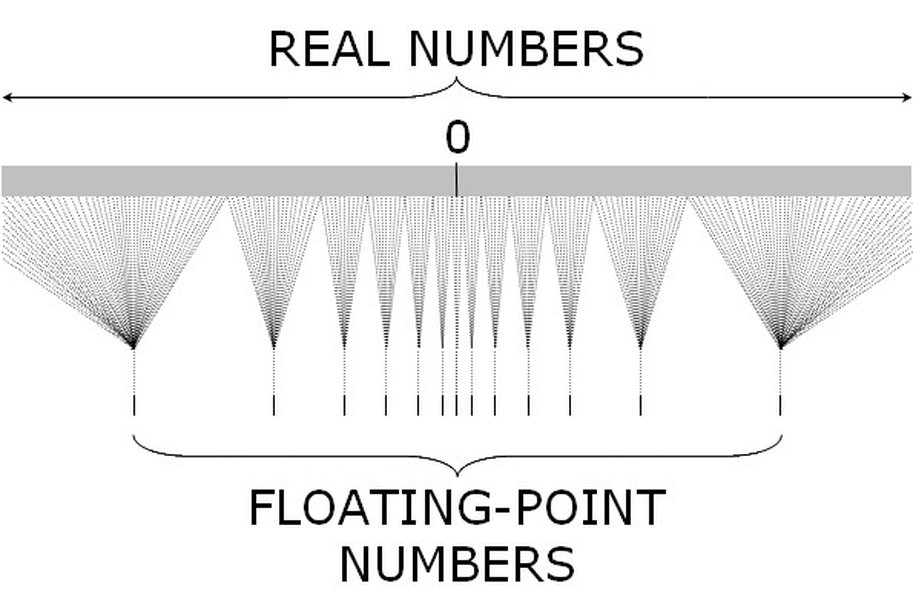
图1:截断误差与舍入误差对比
在GEMM算法中,矩阵乘法涉及大量的乘法和加法运算。每一次浮点运算都可能引入微小的舍入误差。这些看似微不足道的误差在数百万甚至数十亿次的运算后会累积起来,最终导致与“黄金”结果的显著差异。特别是在将非常小的数字与非常大的数字组合时,可能会因为大数字的精度不足以表示小数字而导致精度丢失。
IEEE 754标准与精度局限
IEEE 754标准定义了浮点数的表示格式。例如,单精度浮点数(FP32)使用32位,其中23位用于表示有效数字(尾数)。这意味着FP32只能精确表示约7位十进制有效数字。当浮点数的值达到某个范围(例如,大于8,388,608时),其精度可能会降到1,即在该范围内,能添加到浮点值的最小单位就是1,小数位后的所有精度都已丢失。这在矩阵乘法中尤其重要,因为累加的结果可能迅速变大,从而放大精度损失。
GPU并行计算的特性与非确定性
GPU的并行计算架构是其实现高性能GEMM的关键,但同时也引入了与CPU串行计算不同的误差来源。
运算顺序差异
在GPU上,多个线程同时执行计算。这导致浮点加法运算的顺序可能与CPU的串行执行顺序不同。由于浮点加法不满足严格的结合律(即 \( (a + b) + c \) 可能不等于 \( a + (b + c) \) ),不同的运算顺序会导致最终结果的微小差异。GPU上的线程调度和数据加载模式可能导致每次运行时的加法顺序不同,从而产生非比特级再现的误差。
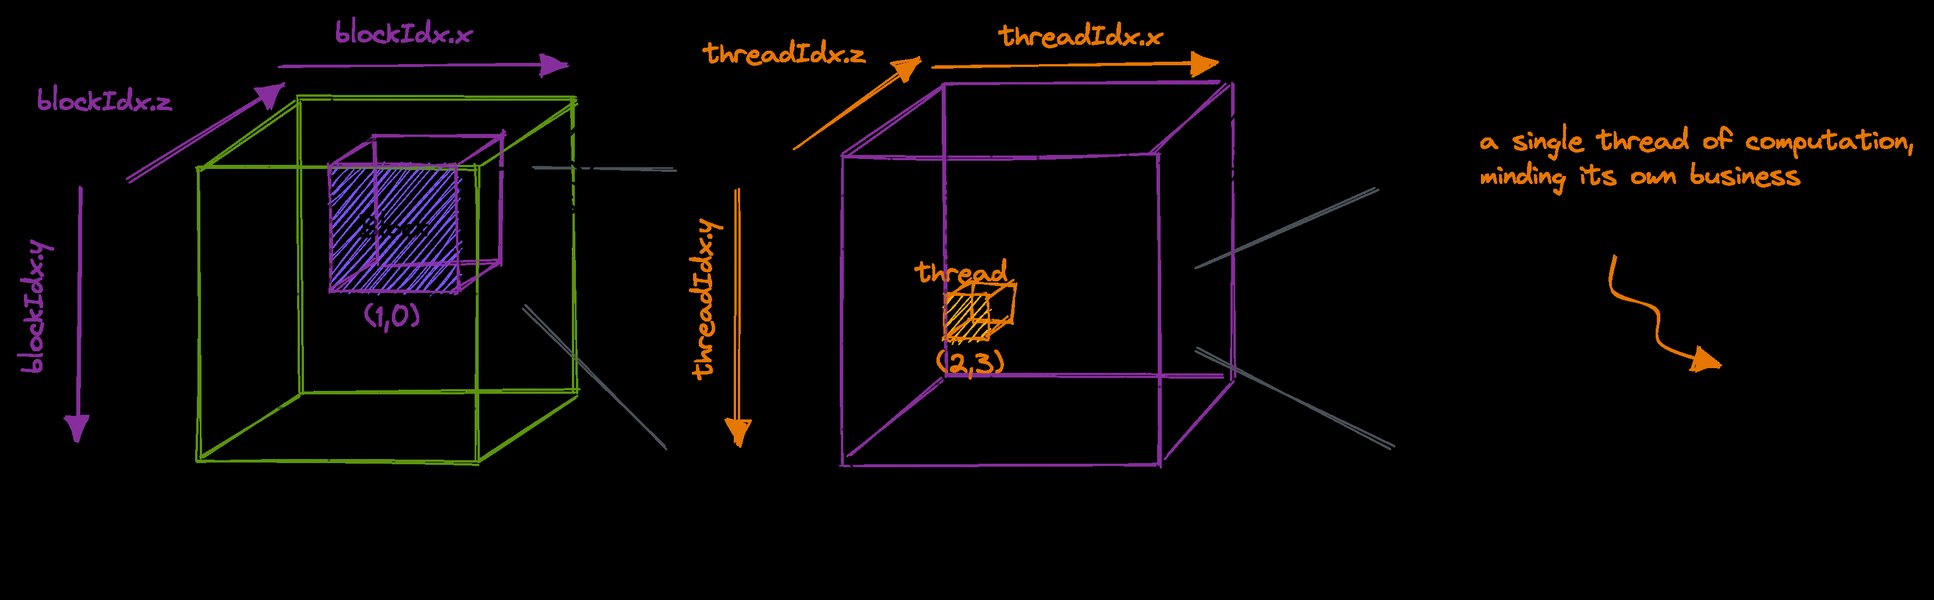
图2:CUDA线程层次结构示意图
并行归约与竞争条件
在GEMM的某些实现中,特别是在执行求和归约时,如果使用原子操作或者以不确定的顺序累加结果,可能会导致结果的微小波动。虽然高性能库(如cuBLAS)会尽量优化以减少这种影响,但其底层并行性质仍然可能引入细微的非确定性。
硬件架构、库实现与优化策略
NVIDIA GPU的独特硬件设计以及CUDA库的复杂优化策略,也是导致GEMM误差的重要因素。
Tensor Core与CUDA Core的精度差异
NVIDIA GPU包含两种主要类型的核心:传统的CUDA Cores和专为矩阵乘法设计的Tensor Cores。它们在执行浮点运算时可能采用不同的精度或内部优化方式。例如,Tensor Cores在执行混合精度(如FP16输入,FP32累加)GEMM时,其计算路径和累积精度可能与传统CUDA Cores使用的纯FP32计算路径有所不同,这可能导致最终结果的差异。有报告指出,Tensor Cores的结果可能比CUDA Cores更精确,但与纯FP32或FP64的黄金标准相比,仍然可能存在差异。
低精度计算与混合精度累加
为了追求极致性能,现代AI模型越来越多地采用低精度浮点格式(如FP16、甚至FP8)进行训练和推理。虽然这些低精度格式显著提高了计算速度并降低了内存带宽,但它们的有效数字位数更少,导致舍入误差更频繁且累积效应更明显。在某些情况下,即使输入是FP16,Tensor Cores也可能使用FP32进行内部累加,但最终结果仍需转换回FP16,这一转换过程会丢失精度。
cuBLAS库的算法选择与工作空间
cuBLAS是NVIDIA提供的高度优化线性代数库,其内部为GEMM提供了多种算法实现。库会根据矩阵大小、数据类型和硬件特性动态选择最佳算法。如果库未能找到最优算法(例如,由于内存不足导致CUBLAS_STATUS_ALLOC_FAILED或Failed to find best cuBLAS algorithm警告),或者使用了次优的算法,这不仅会影响性能,还可能间接影响结果的精确性。此外,cuBLAS在执行某些例程时会使用工作空间,不正确的工作空间大小也可能影响计算的正确性或效率。
分块与平铺策略
高性能GEMM实现通常采用分块(tiling)和平铺(blocking)策略,将大矩阵分解成小块进行计算,以优化内存访问和利用GPU缓存。不同的分块大小、数据布局(如行主序或列主序)和中间结果的累加顺序,都会影响最终结果的舍入,从而导致与黄金标准的差异。
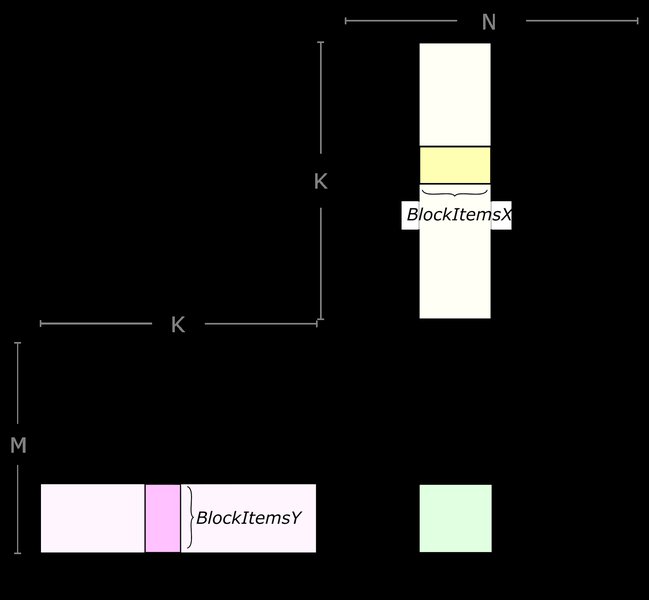
图3:GEMM分块结构示意图
其他影响因素
除了上述核心因素,还有一些编程和环境相关的因素可能导致或放大GEMM的误差。
编译器优化与代码实现
NVIDIA的nvcc编译器或其他C++编译器在编译CUDA代码时会进行各种优化。这些优化可能会改变浮点运算的顺序,甚至可能使用快速近似算法(如快速倒数平方根),进而影响最终的精度。此外,内存访问模式(如非对齐内存访问导致的CUDA error: misaligned address)虽然通常影响性能,但在某些情况下也可能导致计算错误。
CUDA驱动与库版本
不同版本的CUDA驱动、cuBLAS或其他相关库(如PyTorch、TensorFlow)可能包含不同的优化和浮点运算实现。这意味着即使是相同的源代码,在不同的CUDA版本或驱动环境下也可能产生不同的结果。例如,cublasSgemm在CUDA 9.1和CUDA 8.0之间就可能产生非微不足道的差异。
环境配置与内存管理
诸如内存不足(Blas GEMM launch failed: out of memory)等环境问题,虽然不直接是精度问题,但可能导致无法正确分配矩阵或工作空间,进而影响GEMM的执行和结果的正确性或稳定性。
CUDA GEMM误差成因综合评估
为了更直观地理解各项因素对CUDA GEMM误差的综合影响,以下雷达图展示了各主要成因在“潜在影响程度”和“缓解难度”两个维度上的评估。请注意,这是一个基于综合分析的定性评估,具体影响会因GEMM的应用场景和实现细节而异。
图4:CUDA GEMM误差成因雷达图
此雷达图旨在可视化地呈现各种误差源的相对重要性。例如,“浮点精度限制”和“低精度计算”通常被认为是影响程度最高且缓解难度较大的因素,因为它们涉及数值表示的根本限制。而“内存访问模式”虽然可能导致错误,但通常更容易通过良好的编程实践来避免。
深入理解:浮点数精度工作原理
为了更好地掌握这些误差,理解浮点数如何在计算机内部工作至关重要。以下视频将简要介绍浮点数不精确性的根本原因。
视频1:理解浮点数精度问题
这个视频解释了为什么浮点数在计算机中常常出现“奇怪”的行为,通过对十进制到二进制转换的深入剖析,揭示了浮点数精度限制的根源。对于GEMM这类依赖大量浮点运算的算法来说,这种不精确性是误差累积的起点。
常见GEMM误差成因速览
以下思维导图概括了导致CUDA GEMM与黄金标准存在误差的主要成因及其分支。
图5:CUDA GEMM误差成因思维导图
误差成因详细列表
下表总结了CUDA GEMM与黄金标准之间误差的详细成因,并提供简要说明。
| 误差成因类别 | 具体原因 | 详细说明 |
|---|---|---|
| 浮点数精度问题 | 有限精度存储 | 浮点数在计算机中用有限的二进制位表示,无法精确表示所有实数,导致精度损失。 |
| 舍入误差累积 | 大量乘加运算中,每次运算都可能引入微小舍入误差,这些误差在累积后显著影响最终结果。 | |
| IEEE 754 标准限制 | 某些十进制数无法精确转换为二进制浮点数,以及浮点数在大范围数值上的精度下降。 | |
| GPU并行计算结构 | 运算顺序不确定性 | GPU并行执行导致浮点加法顺序与CPU串行不同,由于浮点加法不满足结合律,会引入差异。 |
| 并行归约与原子操作 | 在求和归约时,不确定的累加顺序或原子操作可能导致结果微小波动。 | |
| 硬件特性与库实现 | Tensor Core与CUDA Core差异 | NVIDIA GPU上的Tensor Cores与CUDA Cores采用不同计算路径和累积精度,影响最终浮点结果。 |
| 低精度计算(FP16/FP8) | 为提高性能,使用半精度或更低精度浮点数进行计算,虽然速度快但精度更低,舍入误差增大。 | |
| cuBLAS算法选择 | cuBLAS库根据输入选择不同GEMM算法,选择次优算法可能影响精度或性能。 | |
| 分块与平铺策略 | 分块优化改变计算顺序和数据累积方式,可能导致中间结果舍入差异。 | |
| 编程与环境因素 | 编译器优化 | nvcc编译器可能重排序浮点运算或使用近似算法,引入微小误差。 |
| 内存访问对齐 | 非对齐内存访问可能导致性能下降,甚至引入计算错误。 | |
| CUDA驱动/库版本 | 不同版本的CUDA驱动、cuBLAS或其他库可能存在不同的浮点实现和优化,导致结果不一致。 | |
| 环境资源限制 | 内存不足等问题可能导致计算中断或选择次优路径,间接影响精度。 |
常见问题解答 (FAQ)
GEMM的误差是否意味着CUDA实现是错误的?
如何判断误差是否在可接受范围内?
使用双精度(double)是否能完全消除误差?
cuBLAS库是否能避免这些误差?
结论
CUDA实现的GEMM算法与黄金标准结果之间存在误差,是浮点数计算的本质限制、GPU并行执行的非确定性、以及硬件架构与库实现细节共同作用的结果。理解这些成因对于在高吞吐量计算中管理精度至关重要。虽然完全消除这些误差通常是不可能的,但通过选择合适的数据类型(如双精度)、采用数值稳定的算法、利用高度优化的库(如cuBLAS),并了解特定硬件与软件环境的影响,可以有效地缓解和控制这些误差,确保计算结果在可接受的精度范围内。
推荐阅读
- 如何选择CUDA GEMM的最佳数据类型以平衡性能与精度?
- NVIDIA Tensor Core的混合精度计算如何影响GEMM结果?
- 在CUDA中,是否存在实现确定性浮点计算的最佳实践?
- 在高性能计算中,有哪些工具可以帮助诊断和调试浮点误差?