
Proceso de Ciencia de Datos
Una guía estructurada para transformar datos en conocimientos valiosos
3 Puntos Clave a Recordar
- Definición precisa de problemas y objetivos: Comprender el problema a resolver es esencial para orientar todas las etapas posteriores.
- Preparación y limpieza de datos: Garantizar la calidad de los datos mediante la recolección, integración y transformación es fundamental.
- Iteración y comunicación: La retroalimentación constante, la iteración en los modelos y la comunicación efectiva con los stakeholders aseguran el éxito del proceso.
Introducción al Proceso de Ciencia de Datos
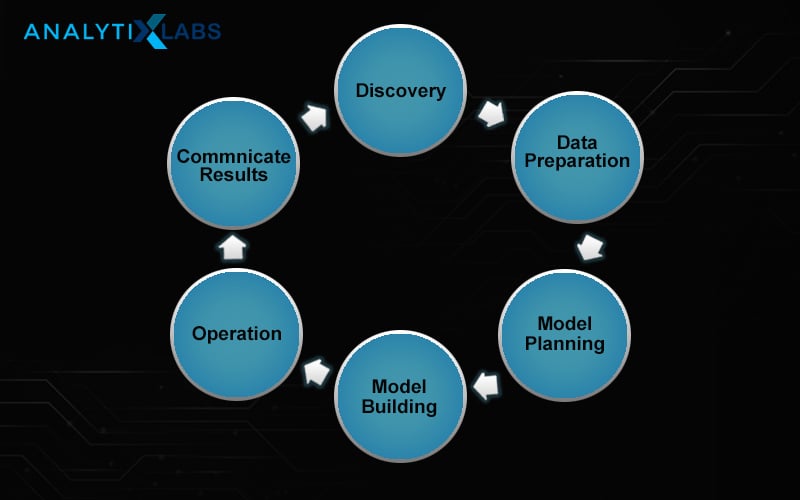
El proceso de ciencia de datos es un enfoque sistemático y estructurado utilizado para abordar problemas complejos mediante el manejo y análisis de grandes volúmenes de datos. Desde la definición del problema hasta la implementación del modelo final, cada paso del proceso contribuye a transformar datos en información procesable y a construir soluciones basadas en evidencia. Esta metodología no solo abarca la parte técnica, sino que también involucra una comunicación clara y una iteración constante para adaptarse a nuevos datos y requisitos.
Fases Clave del Proceso de Ciencia de Datos
1. Definición del Problema
Descripción y Objetivos
La fase inicial es crucial, ya que se centra en articular de manera precisa el problema a resolver y los objetivos que se desean alcanzar. Esto implica realizar entrevistas con los stakeholders, entender el impacto comercial o de investigación, y definir criterios de éxito. Una problema bien definido sienta las bases para una estrategia de análisis eficaz y para la selección adecuada de métodos y herramientas.
En esta etapa se deben establecer preguntas de investigación o objetivos específicos que permitirán centrar los esfuerzos del equipo. Los criterios de éxito se utilizan para validar el impacto de la solución implementada.
2. Recolección y Adquisición de Datos
Identificación de Fuentes y Métodos
Una vez que el problema ha sido definido, el siguiente paso es recolectar datos relevantes. Esto puede implicar la obtención de datos internos existentes, la extracción de datos de fuentes externas a través de APIs, web scraping o la realización de encuestas y entrevistas. La calidad y la source de los datos son factores determinantes en el éxito del análisis posterior.
Este proceso también involucra tener en cuenta aspectos éticos y legales, como la privacidad y la seguridad de los datos, asegurando el cumplimiento de normativas vigentes.
3. Preparación y Limpieza de Datos
Transformación y Estandarización
La recolección de datos rara vez garantiza datos en un formato inmediatamente usable. Por ello, la limpieza y preparación de datos se convierten en una fase crítica del proceso. Esta etapa se encarga de manejar valores faltantes, eliminar duplicados, corregir errores y transformar los datos en un formato coherente y normatizado. La integración de diferentes conjuntos de datos para formar un conjunto de datos unificado es esencial para el análisis posterior.
La transformación de datos puede incluir la normalización, escalado de características y la generación de nuevas variables (ingeniería de características) que permitan mejorar el desempeño del modelo.
4. Análisis Exploratorio de Datos (EDA)
Descubrimiento y Visualización
La fase de análisis exploratorio es donde los datos comienzan a "hablar". Se usa para comprender distribuciones estadísticamente, identificar patrones, outliers y relaciones entre variables. La visualización de datos juega un papel esencial, utilizando herramientas gráficas para ilustrar tendencias y anomalías. Este análisis ayuda a formular hipótesis que pueden guiar la modelación posterior.
En EDA se suelen aplicar técnicas estadísticas y métodos de visualización para detallar la naturaleza de los datos, lo que permite ajustar la estrategia analítica y, de ser necesario, regresar a la etapa de recolección o limpieza de datos.
5. Ingeniería de Características y Selección
Optimización de Variables
En este paso se crea y selecciona un conjunto de características relevantes que puedan potenciar la capacidad predictiva de los modelos. A través de técnicas como el análisis de correlación y el uso de la experiencia del dominio, se identifican las variables más influyentes. Además, se pueden generar nuevas características a partir de las existentes para capturar mejor la información latente en los datos.
La ingeniería de características es fundamental para mejorar el desempeño del modelo, reduciendo el ruido y mejorando la precisión de las predicciones.
6. Construcción y Validación de Modelos
Selección y Entrenamiento
Con datos ya limpios y transformados, se procede a la selección y entrenamiento de modelos predictivos o descriptivos adecuados. Este paso incluye dividir los datos en conjuntos de entrenamiento, validación y prueba, lo que ayuda a evitar el sobreajuste (overfitting). Se experimenta con diferentes algoritmos y se ajustan parámetros (tuneo de hiperparámetros) para seleccionar el modelo que mejor se adapte a los objetivos planteados.
Las métricas de evaluación, como la precisión, la exactitud, el recall o la raíz del error cuadrático medio (RMSE), permiten comparar modelos y seleccionar el más robusto. La validación cruzada es una técnica común para asegurar que el modelo generalice bien a nuevos datos.
7. Despliegue y Mantenimiento del Modelo
Integración y Monitorización
Una vez que el modelo ha sido validado y se considera adecuado, se despliega en un entorno de producción. Esta integración puede implicar la creación de APIs o la integración en sistemas de toma de decisiones en tiempo real. Posteriormente, es necesario monitorear continuamente el desempeño del modelo, ya que los datos pueden cambiar con el tiempo y afectar su precisión.
La monitorización no solo se enfoca en detectar la degradación del rendimiento, sino también en la recolección de feedback de los usuarios y la incorporación de nuevos datos que permitan reentrenar el modelo. Este proceso iterativo garantiza que la solución siga siendo efectiva y responda a cambios en el entorno o en el negocio.
8. Comunicación y Reporte de Resultados
Divulgación y Documentación
La última fase del proceso involucra la elaboración de reportes y presentaciones que sintetizan los hallazgos del análisis. Esta etapa es vital para garantizar que los stakeholders comprendan los resultados y puedan tomar decisiones informadas basadas en los insights descubiertos.
La efectiva comunicación requiere el uso de visualizaciones, dashboards y análisis detallados, los cuales facilitan la interpretación de datos complejos. La documentación completa del proceso, desde la definición del problema hasta los métodos utilizados, es indispensable para mantener la transparencia, la reproducibilidad y la continuidad de futuros proyectos.
Detalle del Proceso en una Tabla
| Etapa | Actividades Clave | Objetivos |
|---|---|---|
| Definición del Problema | Entrevistas, análisis del impacto, establecer criterios y objetivos | Alinear las metas del negocio o investigación |
| Recolección de Datos | Identificación de fuentes; extracción de datos desde bases, APIs o encuestas | Obtener datos relevantes y de calidad |
| Preparación y Limpieza | Eliminación de errores, normalización, integración, transformación | Transformar información en un formato usable |
| Análisis Exploratorio (EDA) | Visualizaciones, análisis estadístico, detección de patrones | Obtener entendimiento inicial y formular hipótesis |
| Ingeniería de Características | Generación y selección de variables, escalado, transformación | Optimizar variables para mejorar la predictibilidad |
| Construcción y Validación de Modelos | Entrenamiento, ajuste de hiperparámetros, validación cruzada | Construir modelos robustos y generalizables |
| Despliegue y Mantenimiento | Integración, monitorización continua, reentrenamiento | Asegurar la operatividad y su actualización |
| Reporte y Comunicación | Dashboards, reportes, presentaciones, documentación completa | Facilitar la toma de decisiones y garantizar la transparencia |
Consideraciones Adicionales y Mejores Prácticas
Iteración y Flexibilidad
Es importante subrayar que el proceso de ciencia de datos es inherentemente iterativo. Los avances en cualquier etapa pueden resultar en revisitar pasos anteriores. Por ejemplo, el análisis exploratorio puede revelar la necesidad de recolectar más datos o ajustar la limpieza y transformación. Esta flexibilidad permite que los equipos de ciencia de datos optimicen continuamente su enfoque y respondan rápidamente a imprevistos o cambios en los datos.
Automatización y Escalabilidad
Con el crecimiento exponencial de los datos, la automatización es vital para mantener la eficiencia. La implementación de pipelines automatizados mediante herramientas de orquestación facilita la replicación y escalabilidad de procesos. Automatizar tareas rutinarias reduce la probabilidad de errores humanos, aumenta la velocidad del análisis y libera tiempo para enfoques analíticos más complejos.
Ética y Privacidad
Al manejar datos, especialmente aquellos de naturaleza sensible, es crucial adherirse a principios éticos y normativas de privacidad. Esto no solo protege la información, sino que también fortalece la confiabilidad de la organización y la fidelidad de sus clientes. La implementación de controles rigurosos y el cumplimiento de las normativas son aspectos que deben considerarse en cada fase del proceso.
Documentación y Colaboración
Cada etapa del proceso debe estar debidamente documentada para asegurar la transparencia y permitir la replicación. La colaboración entre equipos multidisciplinarios enriquece la perspectiva y mejora la calidad del análisis al incorporar distintas áreas de conocimiento. Una documentación exhaustiva respalda futuras actualizaciones y mejora la comunicación tanto interna como externa.
Herramientas y Tecnologías Usadas en la Ciencia de Datos
Herramientas para la Recolección y Almacenamiento
La diversidad de orígenes de datos implica que se utilicen diferentes herramientas para la recolección. Bases de datos SQL y NoSQL, junto con servicios de nube como Amazon Redshift o Google BigQuery, son frecuentemente empleadas para almacenar y gestionar grandes volúmenes de datos de manera eficiente.
Software para la Limpieza y Preparación
Herramientas como OpenRefine, Trifacta Wrangler, y bibliotecas de Python (pandas y NumPy) permiten transformar y limpiar datos de manera efectiva. Estas herramientas aseguran que los datos estén en un formato adecuado para un análisis detallado.
Plataformas para Análisis y Modelado
Las librerías y frameworks de Python, como scikit-learn, TensorFlow y PyTorch, así como herramientas estadística en R, son ampliamente utilizadas para entrenamiento y validación de modelos. Estos entornos permiten la implementación de algoritmos de machine learning y estadística avanzada que son el núcleo del modelado predictivo.
Sistemas de Visualización
La interpretación de los datos se potencia con herramientas de visualización como Tableau, Power BI y los módulos de gráficos en Python (Matplotlib, Seaborn), que facilitan la creación de dashboards y reportes interactivos para una comunicación efectiva de los resultados.
Aspectos de los Flujos de Trabajo en Ciencia de Datos
Además de seguir las fases definidas, es importante notar que el concepto de flujos de trabajo (workflows) abarca la secuencia estructurada de tareas que garantizan la eficiencia en la manipulación y análisis de datos. Un flujo de trabajo bien diseñado no solo identifica posibles cuellos de botella, sino que también optimiza la asignación de recursos.
Estos flujos se pueden dividir en varios tipos, tales como:
- Flujos de integración: Combinan datos provenientes de múltiples fuentes, creando un dataset cohesivo.
- Flujos de transformación: Convierten datos de un formato a otro, asegurando compatibilidad y facilidad de análisis.
- Flujos de análisis: Se enfocan en extraer tendencias y generar insights mediante técnicas estadísticas y de visualización.
La implementación de estos flujos de trabajo optimiza la eficiencia operativa, permitiendo a los equipos identificar rápidamente áreas de mejora e implementar cambios sin afectar la totalidad del proceso.
Casos de Uso y Aplicaciones Prácticas
Sector Salud
En el sector salud, los flujos de trabajo de datos permiten gestionar registros de pacientes, combinar información de distintas fuentes (hospitales, laboratorios y dispositivos médicos) y analizar tendencias para mejorar el diagnóstico y tratamiento. La integración efectiva de datos puede llevar a insights que optimicen la atención al paciente y faciliten la detección temprana de enfermedades.
Servicios Financieros
La capacidad para recolectar y analizar datos en tiempo real es esencial para la detección de fraudes y el análisis crediticio. Los flujos de trabajo permiten analizar transacciones y comportamientos financieros, proporcionando una plataforma sólida para identificar patrones sospechosos y prevenir actividades maliciosas.
Retail y Marketing
En el ámbito del comercio, la integración de datos de ventas, comportamiento de compra y datos demográficos permite crear estrategias de marketing personalizadas. La minería de grandes volúmenes de datos facilita la segmentación de clientes y la creación de campañas dirigidas que maximicen el retorno de inversión.
Ciencias Ambientales y Sociales
La recopilación y análisis de datos ambientales permite identificar tendencias en el cambio climático y sus efectos en distintos ecosistemas. De manera similar, el análisis de datos sociales contribuye a la comprensión de fenómenos culturales y de comportamiento, ayudando a diseñar políticas públicas basadas en evidencia.
Implementación y Buenas Prácticas en el Proceso de Ciencia de Datos
Automatización y Gestión de Pipelines
Automatizar tareas repetitivas mediante pipelines de datos es esencial para mejorar la eficiencia y reducir la probabilidad de errores. Herramientas de orquestación como Apache Airflow o Luigi permiten ejecutar secuencias complejas de procesamiento de datos de forma programada. De este modo, se aseguran procesos consistentes y escalables que se adaptan al crecimiento del volumen de datos.
Control de Versiones y Documentación
Mantener un control de versiones tanto de los conjuntos de datos como del código asociado permite restaurar y replicar procesos. La documentación detallada de cada etapa – desde la recolección hasta la implementación – es vital para la continuidad de proyectos y facilita la colaboración entre equipos multidisciplinarios.
Monitoreo y Retroalimentación
Una vez que el modelo se encuentra en producción, es fundamental establecer mecanismos de monitoreo constantes. La retroalimentación proveniente de la monitorización, junto con la evaluación del rendimiento utilizando métricas específicas, permite detectar desviaciones y realizar ajustes necesarios, garantizando la vigencia y precisión del modelo a lo largo del tiempo.
Conclusión
En resumen, el proceso de ciencia de datos es una metodología sistemática y flexible que abarca desde la definición minuciosa del problema hasta la implementación y el seguimiento de soluciones basadas en datos. Con etapas interrelacionadas que incluyen la recolección, limpieza, análisis y modelación, cada fase es vital para transformar datos crudos en valiosos insights que impulsan el éxito de estrategias empresariales y de investigación. Adoptar buenas prácticas – como la automatización, el control de versiones y la comunicación efectiva – no solo mejora la eficiencia operativa, sino que también garantiza la confiabilidad y escalabilidad en un entorno de datos en constante evolución.
Referencias
- Data Science Process - GeeksforGeeks
- Data Science Process - AnalytixLabs
- Data Science Lifecycle - Database Town
- 5 Steps in Data Science Lifecycle - Institute Data
- Data Science Process - DataScience-PM
Más
Last updated February 18, 2025