
Databricks in Azure: Ihr Schlüssel zu fortschrittlicher Datenanalyse und KI – ein Vergleich mit Microsoft Fabric
Entdecken Sie, was Databricks ist, warum Azure die ideale Cloud-Umgebung dafür darstellt und wie es sich von Microsoft Fabric unterscheidet.
Wichtige Erkenntnisse auf einen Blick
- Databricks ist eine vereinheitlichte, auf Apache Spark basierende Analyseplattform, die den gesamten Datenlebenszyklus von Engineering über Data Science bis hin zu Machine Learning abdeckt und für Big Data und KI optimiert ist.
- Azure Databricks bietet eine nahtlose Integration in das Azure-Ökosystem, optimierte Leistung, verbesserte Sicherheit und kosteneffiziente Skalierbarkeit als First-Party-Dienst von Microsoft.
- Im Vergleich zu Microsoft Fabric zeichnet sich Databricks durch überlegene Fähigkeiten in komplexen KI-Anwendungen, Big-Data-Verarbeitung und feingranularer Kontrolle aus, während Fabric durch Benutzerfreundlichkeit und eine integrierte Suite für breitere Unternehmensanalysen punktet.
Was genau ist Databricks? Eine umfassende Einführung
Databricks ist eine cloudbasierte Plattform, die speziell für Datenanalyse und künstliche Intelligenz (KI) entwickelt wurde. Gegründet von den ursprünglichen Entwicklern von Apache Spark, zielt Databricks darauf ab, den gesamten Prozess der Datenverarbeitung – von Data Engineering über Data Science bis hin zu Machine Learning (ML) – zu vereinfachen und zu beschleunigen. Die Plattform ermöglicht die effiziente Verarbeitung und Analyse riesiger Datenmengen, seien sie strukturiert oder unstrukturiert, und unterstützt sowohl Batch-Verarbeitung als auch Echtzeit-Datenströme. Im Kern basiert Databricks auf leistungsstarken Open-Source-Technologien wie Apache Spark für die schnelle Datenverarbeitung und Delta Lake für zuverlässige Datenspeicherung und -verwaltung im Data Lakehouse.
Unternehmen setzen Databricks ein, um ihre Datenbestände zu verwalten, zu veredeln und wertvolle Erkenntnisse daraus zu gewinnen, datengesteuerte Entscheidungen zu treffen und innovative KI-Lösungen zu entwickeln.
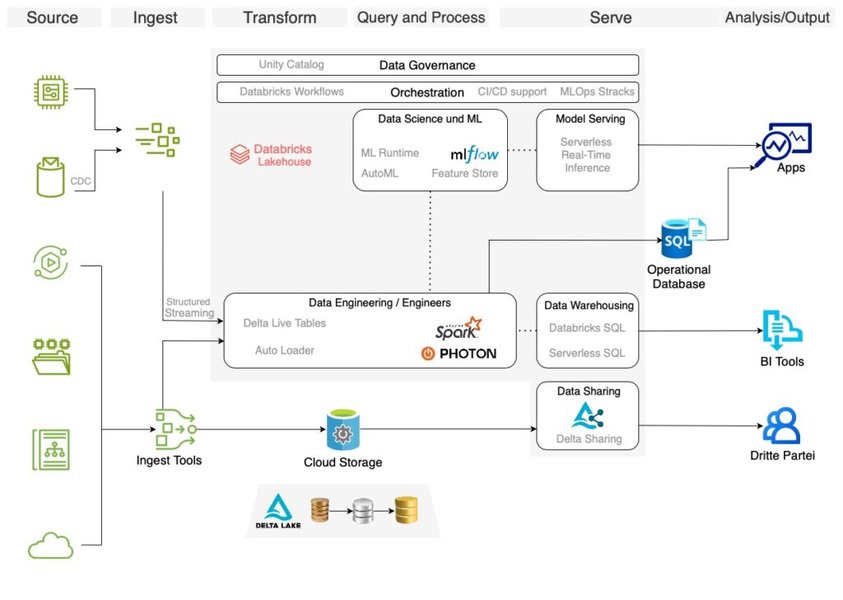
Visualisierung der Databricks Lakehouse-Architektur.
Kernkomponenten und Architektur: Das Lakehouse-Konzept
Databricks popularisierte das Konzept des "Lakehouse", einer modernen Datenarchitektur, die die besten Eigenschaften von Data Lakes und Data Warehouses vereint. Ein Data Lake bietet kostengünstige, skalierbare Speicherung für Rohdaten in verschiedenen Formaten, während ein Data Warehouse strukturierte Daten für Business Intelligence und Reporting bereitstellt. Das Lakehouse, ermöglicht durch Delta Lake, bringt ACID-Transaktionen, Datenqualitätsmanagement und Schema-Enforcement in den Data Lake, was eine zuverlässige und performante Datenbasis für diverse Analyse-Workloads schafft.
- Apache Spark: Das Herzstück von Databricks ist eine optimierte Version von Apache Spark, die eine schnelle und verteilte Verarbeitung großer Datensätze ermöglicht.
- Delta Lake: Eine Open-Source-Speicherschicht, die ACID-Transaktionen, Datenversionierung und Skalierbarkeit für Data Lakes bietet und so die Zuverlässigkeit und Leistung verbessert.
- MLflow: Eine Open-Source-Plattform zur Verwaltung des gesamten Machine-Learning-Lebenszyklus, einschließlich Experimenten, Reproduzierbarkeit und Bereitstellung von Modellen.
- Kollaborative Notebooks: Interaktive Arbeitsbereiche, die es Datenwissenschaftlern, Ingenieuren und Analysten ermöglichen, gemeinsam Code (z.B. in Python, Scala, SQL, R) zu entwickeln, Visualisierungen zu erstellen und Ergebnisse zu teilen.
Vielseitige Anwendungsfälle
Databricks wird branchenübergreifend für eine Vielzahl von Anwendungsfällen eingesetzt, darunter:
- Big Data Engineering: Aufbau robuster und skalierbarer ETL/ELT-Pipelines zur Transformation und Aufbereitung von Rohdaten.
- Data Science und Machine Learning: Entwicklung, Training und Bereitstellung von ML-Modellen im großen Maßstab.
- Echtzeitanalysen: Verarbeitung und Analyse von Streaming-Daten für sofortige Einblicke, z.B. für Betrugserkennung oder personalisierte Empfehlungen.
- Business Intelligence und Reporting: Anbindung an BI-Tools zur Erstellung interaktiver Dashboards und Berichte auf Basis zuverlässiger Daten.
- Genomik und Life Sciences: Analyse großer Genomdatensätze für Forschung und Medikamentenentwicklung.
Die Plattform ist multi-cloud-fähig und auf den großen Cloud-Anbietern wie Azure, AWS und Google Cloud verfügbar, wobei jede Implementierung für die jeweilige Cloud-Umgebung optimiert ist.
Warum Azure Databricks? Die Synergie mit der Microsoft Cloud
Azure Databricks ist die für die Microsoft Azure Cloud-Plattform optimierte Version von Databricks. Als First-Party-Dienst von Microsoft bietet Azure Databricks eine tiefe Integration mit dem Azure-Ökosystem, was zahlreiche Vorteile für Unternehmen mit sich bringt, die bereits auf Azure setzen oder eine leistungsstarke Analyseumgebung in der Microsoft Cloud suchen.
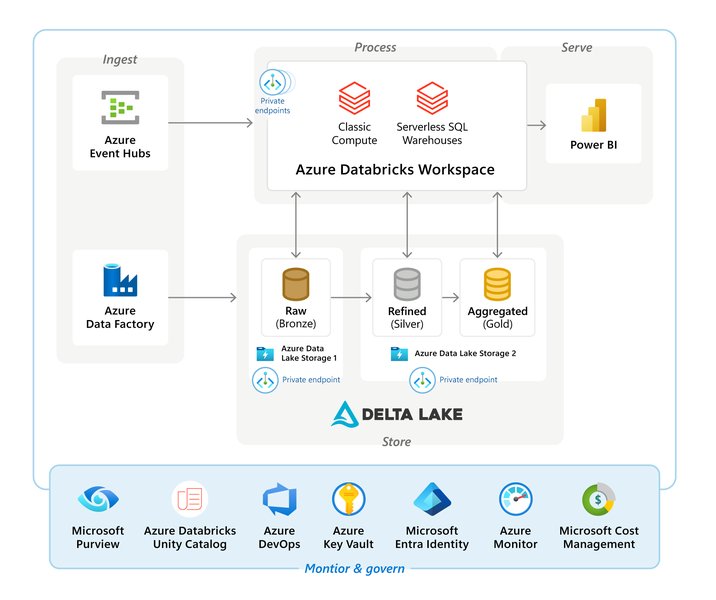
Architektur von Azure Databricks, integriert in die Azure-Infrastruktur.
Optimale Integration und Leistung
Einer der Hauptgründe für die Nutzung von Azure Databricks ist die nahtlose Integration mit anderen Azure-Diensten. Dazu gehören:
- Azure Data Lake Storage (ADLS Gen2): Hochgradig skalierbarer und sicherer Speicher für Big-Data-Analyse.
- Azure Blob Storage: Kosteneffizienter Objektspeicher.
- Azure Data Factory (ADF): Ein Cloud-basierter Datenintegrationsdienst zur Orchestrierung und Automatisierung von Daten-Workflows.
- Azure Synapse Analytics: Ein umfassender Analysedienst, der Data Warehousing und Big-Data-Analysen vereint.
- Microsoft Power BI: Ein führendes Business-Intelligence-Tool zur Visualisierung von Daten und Erstellung von Berichten.
- Azure Machine Learning: Zur Erweiterung der ML-Funktionen und zur Verwaltung des Modell-Lebenszyklus.
Diese enge Verzahnung ermöglicht einen reibungslosen Datenfluss und vereinfacht die Erstellung komplexer Analyse-Pipelines. Azure Databricks ist für die Azure-Infrastruktur optimiert, was zu verbesserter Leistung und Effizienz führt. Die Einrichtung ist unkompliziert und kann mit nur wenigen Klicks im Azure Portal erfolgen.
Produktivität und Zusammenarbeit
Azure Databricks fördert die Zusammenarbeit zwischen Dateningenieuren, Datenwissenschaftlern und Geschäftsanalysten durch interaktive Notebooks, gemeinsame Arbeitsbereiche und integrierte Versionskontrolle. Dies kann die Produktivität von Datenteams erheblich steigern – Schätzungen zufolge um bis zu 25 %. Die Plattform automatisiert viele Aspekte des Cluster-Managements und der Infrastrukturwartung, sodass sich Teams auf die Wertschöpfung aus Daten konzentrieren können.
Sicherheit und Kosteneffizienz
Als nativer Azure-Dienst profitiert Azure Databricks von den robusten Sicherheitsfunktionen der Azure-Plattform, einschließlich Azure Active Directory für die Identitäts- und Zugriffsverwaltung, virtuellen Netzwerken für die Netzwerkisolation und Azure Key Vault für die sichere Speicherung von Geheimnissen. Die Abrechnung erfolgt nutzungsbasiert pro Sekunde (über Databricks Units - DBUs), was Flexibilität bietet. Zudem gibt es Optionen, durch den Vorkauf von Commit Units (DBCU) für ein oder drei Jahre Kosten zu sparen, was die Lösung besonders für Unternehmen mit planbaren Workloads attraktiv macht.
Der Databricks-Vorteil: Ein Radar-Chart-Vergleich
Um die Stärken von Databricks, insbesondere im Vergleich zu anderen Plattformen wie Microsoft Fabric, besser zu visualisieren, betrachten wir einen Radar-Chart. Dieser Chart bewertet verschiedene Aspekte wie KI/ML-Fähigkeiten, Benutzerfreundlichkeit, Big-Data-Verarbeitung, Ökosystem-Integration, Flexibilität des Kostenmodells, Echtzeit-Verarbeitung und feingranulare Kontrolle. Die Werte sind auf einer Skala von 5 (Grundfunktionalität) bis 10 (Herausragend) angesiedelt, basierend auf einer allgemeinen Einschätzung der Plattformfähigkeiten.
Wie der Chart andeutet, glänzt Databricks besonders bei KI/ML-Fähigkeiten, Big-Data-Verarbeitung, Echtzeit-Verarbeitung und der Möglichkeit zur feingranularen Kontrolle. Microsoft Fabric punktet stärker bei der allgemeinen Benutzerfreundlichkeit und der Breite seiner integrierten Dienste. Beide Plattformen zeigen eine starke Integration in das Azure-Ökosystem.
Databricks im Kontext: Ein Vergleich mit Microsoft Fabric
Microsoft Fabric ist eine relativ neue, umfassende Analyseplattform von Microsoft, die darauf abzielt, den gesamten Daten-Stack zu vereinheitlichen – von der Datenintegration über Data Engineering, Data Warehousing, Data Science, Echtzeitanalysen bis hin zu Business Intelligence. Es integriert bestehende Microsoft-Dienste wie Azure Data Factory, Azure Synapse Analytics und Power BI in einer einzigen SaaS-Umgebung mit einem zentralen Data Lake namens OneLake. Der Vergleich zwischen Azure Databricks und Microsoft Fabric ist wichtig, da beide leistungsstarke Lösungen für Datenanalysen in der Azure-Cloud darstellen, aber unterschiedliche Schwerpunkte und Stärken haben.
| Merkmal | Azure Databricks | Microsoft Fabric |
|---|---|---|
| Primärer Fokus | Fortgeschrittene KI/ML, Big-Data-Verarbeitung, Echtzeit-Streaming, Lakehouse-Architektur | Vereinheitlichte End-to-End-Analytics-Suite, BI, Reporting, Benutzerfreundlichkeit |
| Zugrundeliegende Technologie | Optimiertes Apache Spark, Delta Lake, MLflow | OneLake (basierend auf ADLS Gen2), Power BI, integrierte Azure-Dienste (Data Factory, Synapse-Komponenten) |
| Architektur | Offenes Lakehouse (Data Lake + Data Warehouse-Funktionen) | Integrierte SaaS-Plattform, "Lake-centric" mit OneLake als zentralem Speicher |
| Benutzerfreundlichkeit | Sehr leistungsstark, erfordert oft spezifisches Fachwissen (Spark, Python, Scala) | Sehr benutzerfreundlich, grafische Oberflächen, weniger Code-intensiv für viele Aufgaben, geringerer Admin-Aufwand |
| KI/ML-Funktionen | Sehr fortgeschritten, native Integration von MLflow, optimiert für komplexe Modelle | Unterstützt Data Science und ML, Integration mit Azure Machine Learning, aber weniger tiefgehend als Databricks |
| Echtzeit-Streaming | Stark, optimiert durch Spark Structured Streaming | Unterstützt Echtzeitanalysen (z.B. Real-Time Hub, KQL-Datenbanken), aber Databricks ist oft performanter für komplexe Streams |
| Datenintegration (ETL/ELT) | Hochgradig flexibel und anpassbar, programmatische Kontrolle über Pipelines | Vereinfacht durch Dataflows Gen2 und Datenpipelines, viele Konnektoren, Fokus auf Low-Code/No-Code |
| Integration in Azure | Tiefe Integration als First-Party-Dienst, nahtlos mit ADLS, Azure AD etc. | Native Microsoft-Plattform, inhärent tief integriert |
| Kollaboration | Kollaborative Notebooks, Git-Integration, Job-Scheduling | Geteilte Arbeitsbereiche, enge Power BI-Zusammenarbeit, Git-Integration für bestimmte Artefakte |
| Preis-Modell | Verbrauchsabhängig (DBUs pro Sekunde), flexible Cluster-Skalierung | Kapazitätsbasiert (Fabric Capacity Units - CUs), bietet Vorhersagbarkeit, kann aber für sporadische Workloads teurer sein |
| Ideal für | Datenintensive Projekte, komplexe KI/ML-Anwendungen, Data-Science-Teams, die feingranulare Kontrolle benötigen | Unternehmensweite BI, Self-Service Analytics, Vereinheitlichung verschiedener Daten-Workloads mit Fokus auf Einfachheit |
Wann Databricks wählen?
Azure Databricks ist oft die bevorzugte Wahl, wenn:
- Fortgeschrittene KI und Machine Learning im Mittelpunkt stehen. Die native MLflow-Integration und die optimierte Spark-Umgebung sind ideal für komplexe Modellentwicklung und -bereitstellung.
- Umfangreiche Big-Data-Verarbeitung mit Apache Spark erforderlich ist, insbesondere bei sehr großen Datenmengen und komplexen Transformationen.
- Echtzeit-Streaming-Anwendungen mit hohen Leistungsanforderungen entwickelt werden sollen.
- Feingranulare Kontrolle über Cluster-Konfigurationen, Bibliotheken und den Ausführungskontext benötigt wird.
- Teams bereits über fundierte Kenntnisse in Spark, Python oder Scala verfügen und eine programmatisch orientierte Umgebung bevorzugen.
- Eine offene Architektur mit Delta Lake und die Vermeidung von Vendor-Lock-in Priorität haben.
Wann Microsoft Fabric die bessere Wahl sein könnte
Microsoft Fabric kann vorteilhafter sein, wenn:
- Eine vereinheitlichte All-in-One-Lösung für verschiedene Analyseaufgaben (von Datenintegration bis BI) mit einer zentralen Verwaltungsoberfläche gesucht wird.
- Der Fokus auf Benutzerfreundlichkeit und schneller Implementierung liegt, insbesondere für Citizen Data Scientists oder Analysten mit weniger Programmiererfahrung.
- Starke Integration mit Power BI und anderen Microsoft-Anwendungen entscheidend ist.
- Die Vorhersagbarkeit der Kosten durch ein kapazitätsbasiertes Preismodell bevorzugt wird.
- Eine SaaS-Lösung mit minimalem Verwaltungsaufwand für die zugrundeliegende Infrastruktur gewünscht ist.
Es ist auch wichtig zu beachten, dass Databricks und Fabric nicht unbedingt als reine Konkurrenten gesehen werden müssen. Sie können sich in bestimmten Szenarien ergänzen. Beispielsweise können Daten, die in Databricks verarbeitet und aufbereitet wurden, über OneLake-Shortcuts in Fabric für Reporting und BI zugänglich gemacht werden.
Databricks und Fabric im Ökosystem der Datenplattformen: Eine Mindmap-Übersicht
Die folgende Mindmap bietet eine vereinfachte Darstellung der Positionierung von Databricks (insbesondere Azure Databricks) und Microsoft Fabric innerhalb des breiteren Ökosystems von Datenanalyseplattformen. Sie hebt Kernmerkmale und typische Einsatzbereiche hervor, um die konzeptionellen Unterschiede und Stärken der jeweiligen Plattformen zu verdeutlichen.
Tiefe KI/ML-Fähigkeiten (MLflow)
Hochleistungs-Big-Data-Verarbeitung
Echtzeit-Analyse & Streaming
Feingranulare Kontrolle"] id1_4["Kollaborative Umgebung:
Notebooks (Python, Scala, SQL, R)"] id1_5["Integration in Azure:
First-Party-Dienst
Anbindung an ADLS, Azure ML, Power BI etc."] id1_6["Ideal für:
Data Scientists & Engineers
Komplexe, datenintensive Projekte"] id2["Microsoft Fabric"] id2_1["Kernkonzept: Vereinheitlichte SaaS-Plattform"] id2_2["Architektur: Lake-centric mit OneLake"] id2_3["Stärken:
End-to-End-Analytics aus einer Hand
Hohe Benutzerfreundlichkeit (Low-Code/No-Code)
Starke Power BI-Integration
Vereinfachtes Datenmanagement"] id2_4["Komponenten:
Data Factory, Synapse (Teile), Power BI, Data Activator"] id2_5["Ideal für:
Business-Analysten, Citizen Data Scientists
Unternehmensweite BI & Reporting
Schnelle Prototypenerstellung"] id3["Gemeinsamkeiten & Ergänzungen"] id3_1["Beide in Azure tief integriert"] id3_2["Ziel: Datengetriebene Entscheidungen ermöglichen"] id3_3["Können sich ergänzen (z.B. Databricks für Aufbereitung, Fabric für BI)"]
Diese Mindmap illustriert, dass Databricks sich durch seine Tiefe in spezialisierten Bereichen wie KI/ML und Big Data auszeichnet, während Fabric seine Stärke in der Breite und der Vereinfachung des gesamten Analyseprozesses hat. Die Wahl hängt stark von den spezifischen Anforderungen, den vorhandenen Fähigkeiten im Team und der strategischen Ausrichtung des Unternehmens ab.
Ein tieferer Einblick: Databricks erklärt
Um ein noch besseres Verständnis dafür zu bekommen, was Databricks ist und wie es funktioniert, kann ein Video oft sehr hilfreich sein. Das folgende Video bietet eine anfängerfreundliche Einführung in Databricks und erklärt die Kernkonzepte und Vorteile der Plattform.
Video: "What is Databricks? Beginner's Guide to Databricks!" - Eine visuelle Einführung in die Plattform.
Dieses Video beleuchtet, wie Databricks die Arbeit mit großen Datenmengen vereinfacht und als einheitliche Plattform für Data Engineering, Data Science und Machine Learning dient. Es erklärt die Bedeutung von Apache Spark als zugrundeliegender Engine und wie die Lakehouse-Architektur die Vorteile von Data Lakes und Data Warehouses kombiniert. Solche visuellen Erklärungen können besonders nützlich sein, um die abstrakten Konzepte hinter modernen Datenplattformen greifbarer zu machen.
Häufig gestellte Fragen (FAQ)
Was ist der Hauptunterschied zwischen einem Data Lake und einem Data Warehouse, und wie passt Databricks (Lakehouse) hier hinein? +
Ein Data Warehouse speichert typischerweise strukturierte, verarbeitete Daten, die für Business Intelligence und Reporting optimiert sind. Die Daten sind oft in einem vordefinierten Schema organisiert.
Ein Data Lake hingegen speichert riesige Mengen an Rohdaten in verschiedenen Formaten (strukturiert, unstrukturiert, semistrukturiert) ohne ein festes Schema. Dies bietet Flexibilität, kann aber zu Herausforderungen bei Datenqualität und -verwaltung führen ("Data Swamp").
Das Databricks Lakehouse kombiniert die Vorteile beider Ansätze. Es nutzt die kostengünstige, skalierbare Speicherung eines Data Lakes (oft auf Basis von Technologien wie Delta Lake), fügt aber wichtige Data-Warehouse-Funktionen hinzu, wie ACID-Transaktionen, Datenqualitätsprüfungen, Schema-Enforcement und Datenversionierung. Dies ermöglicht es, eine einzige, zuverlässige Datenquelle für verschiedenste Analyse-Workloads zu haben, von BI bis hin zu KI/ML.
Ist Databricks nur für sehr große Unternehmen mit riesigen Datenmengen geeignet? +
Obwohl Databricks für seine Fähigkeit bekannt ist, Petabyte-Skala-Daten zu verarbeiten, ist es nicht ausschließlich für sehr große Unternehmen konzipiert. Dank der Cloud-basierten Natur und flexibler Preismodelle (z.B. Pay-as-you-go in Azure Databricks) können auch kleinere und mittlere Unternehmen (KMU) von Databricks profitieren.
Die Skalierbarkeit bedeutet, dass man mit kleineren Datenmengen und Clustern beginnen und diese bei Bedarf erweitern kann. Die einheitliche Plattform für Data Engineering, Data Science und ML kann auch für kleinere Teams vorteilhaft sein, da sie die Komplexität reduziert und die Zusammenarbeit fördert. Entscheidend ist eher die Art der Datenprobleme, die gelöst werden sollen (z.B. Bedarf an fortgeschrittener Analytik, ML, Verarbeitung verschiedener Datenquellen), als die reine Unternehmensgröße.
Welche Programmiersprachen werden in Databricks primär unterstützt? +
Databricks ist eine polyglotte Plattform und unterstützt mehrere gängige Programmiersprachen für die Datenverarbeitung und -analyse. Die primär unterstützten Sprachen in Databricks Notebooks sind:
- Python: Aufgrund seiner umfangreichen Bibliotheken für Data Science (z.B. Pandas, NumPy, Scikit-learn, TensorFlow, PyTorch) und seiner einfachen Syntax ist Python sehr populär.
- Scala: Als native Sprache von Apache Spark bietet Scala oft die beste Leistung für komplexe Spark-Anwendungen.
- SQL: Weit verbreitet für Datenabfragen, Transformationen und Analysen, insbesondere für Analysten und Dateningenieure. Delta SQL erweitert die Möglichkeiten von SQL im Lakehouse.
- R: Eine beliebte Sprache für statistische Analysen und Datenvisualisierung, ebenfalls gut in Databricks integriert.
Benutzer können in einem einzigen Notebook oft sogar zwischen diesen Sprachen wechseln, was eine hohe Flexibilität für verschiedene Aufgaben und Teampräferenzen bietet.
Wie sicher sind meine Daten in Azure Databricks? +
Azure Databricks bietet robuste Sicherheitsfunktionen, die auf den Sicherheitsmechanismen der Microsoft Azure-Plattform aufbauen. Dazu gehören:
- Identitäts- und Zugriffsverwaltung: Integration mit Azure Active Directory (Azure AD) für die Authentifizierung und Autorisierung von Benutzern. Rollenbasierte Zugriffskontrolle (RBAC) für Databricks-Arbeitsbereiche, Cluster, Notebooks und andere Objekte.
- Netzwerksicherheit: Möglichkeit zur Bereitstellung von Azure Databricks-Arbeitsbereichen in Ihrem eigenen virtuellen Netzwerk (VNet Injection), Nutzung von Netzwerksicherheitsgruppen (NSGs) und Firewalls.
- Datenverschlüsselung: Verschlüsselung von Daten im Ruhezustand (at rest) in Azure Data Lake Storage oder Blob Storage, oft mit von Microsoft verwalteten Schlüsseln oder kundenseitig verwalteten Schlüsseln (CMK). Verschlüsselung von Daten während der Übertragung (in transit) mittels TLS/SSL.
- Compliance: Azure Databricks erfüllt eine Vielzahl von Industriestandards und Compliance-Zertifizierungen, die von der Azure-Plattform abgedeckt werden.
- Audit-Protokollierung: Detaillierte Protokolle über Aktivitäten im Arbeitsbereich für Überwachungs- und Sicherheitszwecke.
Durch die Kombination dieser Funktionen bietet Azure Databricks eine sichere Umgebung für die Verarbeitung sensibler Daten, vorausgesetzt, die Sicherheitsrichtlinien und Best Practices werden konsequent umgesetzt.
Empfohlene Weiterführungen
- Wie implementiere ich eine Lakehouse-Architektur mit Azure Databricks Schritt für Schritt?
- Welche konkreten Kosteneinsparungen sind durch den Einsatz von Azure Databricks im Vergleich zu On-Premise-Lösungen möglich?
- Können Databricks und Microsoft Fabric effektiv zusammenarbeiten und wie sieht eine solche hybride Architektur aus?
- Welche Best Practices gibt es für die Leistungsoptimierung von Spark-Jobs in Azure Databricks?
Referenzen
Last updated May 8, 2025