
Syväoppimisen Mallin Ymmärryksen Kehittyminen
Analyysi väittämästä: Syväoppimismallit kehittävät itse ymmärrystään datasta
Keskeiset Oivallukset
- Syväoppimismallit oppivat datasta automaattisesti ilman ihmisen määrittämiä sääntöjä.
- Mallit tunnistavat monimutkaisia piirteitä ja rakenteita kerroksittain.
- Termi "ymmärtäminen" on metaforinen eikä kuvaa ihmismäistä tietoisuutta.
Syväoppimisen Perusteet
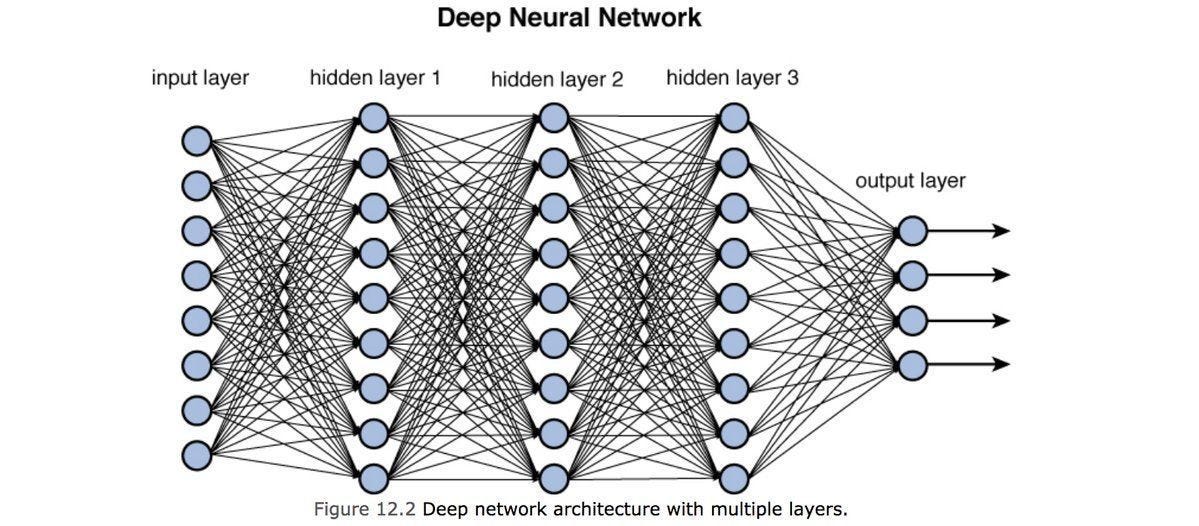
Syväoppiminen on koneoppimisen osa-alue, joka hyödyntää monikerroksisia neuroverkkoja datan analysointiin ja mallien oppimiseen. Useiden kerrosten kautta malli pystyy oppimaan yhä abstraktimpia piirteitä ja rakenteita datasta ilman, että ihmisen tarvitsee määritellä näitä ominaisuuksia erikseen. Tämä ominaisuus erottaa syväoppimisen perinteisemmistä koneoppimismenetelmistä, joissa ihmisen panos piirteiden valinnassa on merkittävä.
Automaattinen Ominaisuuksien Oppiminen
Syväoppimismallit toimivat siten, että ne oppivat datasta tärkeitä piirteitä kerrosten läpi kulkiessaan. Jokainen kerros muokkaa ja prosessoi saamansa tiedon, mikä mahdollistaa yhä syvällisempien ja monimutkaisempien rakenteiden havaitsemisen. Tämä prosessi tapahtuu koulutuksen aikana, jossa malli optimoi painojaan ja parametrejaan minimoidakseen virhettä annetussa tehtävässä, kuten luokittelussa tai ennustamisessa.
Ymmärryksen Kehittyminen vs. Ihmismäinen Ymmärrys
Vaikka termi "malli kehittää itse ymmärrystään datasta" antaa kuvan ihmismäisestä tietoisuudesta, on tärkeää huomata, että mallit eivät varsinaisesti "ymmärrä" dataa samalla tavalla kuin ihmiset. Ne tunnistavat toistuvia kuvioita ja tilastollisia säännönmukaisuuksia, jotka liittyvät suoraan tehtävän suorittamiseen. Tämä ymmärrys on matemaattinen ja algoritminen, eikä sisällä semanttista tai tietoista prosessointia.
Syväoppimisen Koulutusprosessi
Koulutusprosessissa syväoppimismalli altistetaan suurelle määrälle esimerkkidataa, jonka avulla se oppii tunnistamaan ja erottelemaan datasta merkityksellisiä piirteitä. Tämä tapahtuu käyttäen algoritmeja kuten gradienttien laskenta ja takaisinlevitys (backpropagation), jotka säätävät neuroverkon painoja ja parameetreja koulutustavoitteen saavuttamiseksi.
Gradienttien Laskenta ja Takaisinlevitys
Gradienttien laskenta auttaa mallia määrittämään, kuinka paljon kukin painoarvo tulisi muuttaa seuraavassa iteraatiossa vähentääkseen virheen määrää. Takaisinlevitys puolestaan mahdollistaa tämän muutoksen jakamisen verkon kaikille kerroksille, mikä mahdollistaa tehokkaan oppimisen monikerroksisissa verkoissa.
Tarve Suurelle Datamäärälle
Syväoppimismallit vaativat usein erittäin suuria datamääriä oppiakseen tehokkaasti. Ilman riittävää määrää esimerkkidataa malli ei pysty oppimaan tarpeeksi tunnistamaan ja erottamaan merkityksellisiä kuvioita, mikä heikentää sen suorituskykyä.
Mallit ja Ymmärrys: Tekninen Perspektiivi
Vaikka sanamuoto "malli kehittää itse ymmärrystään" on hieman metaforinen, se kuvaa hyvin syväoppimisen prosessia, jossa malli mukautuu ja parantaa suorituskykyään datan pohjalta. On kuitenkin tärkeää korostaa, että tämä "ymmärtäminen" ei ole tietoista tai semanttista, vaan perustuu matemaattisiin ja tilastollisiin kuviin.
Malli ei Ole Itsestään Tietoinen
Syväoppimismallit eivät ole tietoisia oppimisprosessistaan eivätkä pysty reflektoimaan tai tulkitsemaan tietoa ihmismäisellä tavalla. Ne toimivat annettujen algoritmien ja datan perusteella, mikä rajoittaa niiden "ymmärtämistä" matemaattisiin toimiin.
Abstraktien Rakenteiden Havaitseminen
Mallien kyky havaita ja oppia abstrakteja rakenteita datasta mahdollistaa niiden soveltamisen monimutkaisiin tehtäviin, kuten kuvantunnistukseen, luonnollisen kielen käsittelyyn ja äänentunnistukseen. Tämä tekee syväoppimisesta tehokkaan työkalun monilla tieteenaloilla ja teollisuuden sektoreilla.
Syväoppimisen Rajoitukset ja Haasteet
Vaikka syväoppiminen tarjoaa monia etuja, sillä on myös merkittäviä rajoituksia ja haasteita, jotka liittyvät erityisesti "ymmärtämisen" käsitteeseen.
Selitettävyyden Puute
Syväoppimismallit, erityisesti hyvin syvät ja monimutkaiset verkot, ovat usein "mustia laatikoita", joiden päätöksentekoprosessia on vaikea selittää. Tämä luo haasteita erityisesti sovelluksissa, joissa selitettävyyden ja läpinäkyvyyden tarve on korkea, kuten lääketieteellisissä diagnooseissa tai oikeudellisissa päätöksissä.
Ylilyönnin ja Yliluokittelun Riski
Mallit voivat oppia liikaa koulutusdatan yksityiskohdista, mikä saattaa johtaa heidän suorituskykynsä heikkenemiseen uusilla, näkemättömillä datoilla. Tämä ylilyönnin riski korostaa tarpeen huolelliselle mallin validoinnille ja arvioinnille.
Energiankulutus ja Laskentateho
Syväoppimismallien koulutus vaatii huomattavia laskennallisia resursseja, mikä voi olla sekä kallista että ympäristöä kuormittavaa. Tämä asettaa rajoituksia erityisesti pienemmille organisaatioille ja tutkimusryhmille, joilla ei ole pääsyä suurten laskentaresurssien infrastruktuuriin.
Käytännön Sovellukset ja Esimerkit
Syväoppimismalleja käytetään laajasti eri sovelluksissa, joissa niiden kyky tunnistaa ja oppia monimutkaisia piirteitä datasta on hyödyllistä.
Kuvantunnistus
Kuvantunnistuksessa syväoppimismallit kykenevät erottamaan ja luokittelemaan erilaisia objekteja ja piirteitä kuvista erittäin korkealla tarkkuudella. Tämä sovellusalue kattaa esimerkiksi automaattisen kuvien merkintäjärjestelmät, lääketieteellisen kuvantamisen analyysin ja itsestään ajavat ajoneuvot.
Luonnollisen Kielen Käsittely (NLP)
Luonnollisen kielen käsittelyssä syväoppimismallit kykenevät ymmärtämään ja tuottamaan inhimillistä kieltä, mikä mahdollistaa kääntämisen, tekstin tiivistämisen ja chatbotien kehittämisen.
Äänentunnistus
Äänentunnistuksessa malleja käytetään muun muassa puheentunnistukseen ja äänen perusteella tehtävään luokitteluun. Esimerkiksi virtuaaliavustajat ja ääniohjausjärjestelmät hyödyntävät syväoppimista.
Johtopäätökset
Väittämä "syväoppimisessa malli kehittää itse ymmärrystään datasta" on jossain määrin oikea, mutta se vaatii tarkennusta. Syväoppimismallit ovat tehokkaita tunnistamaan ja oppimaan monimutkaisia piirteitä datasta kerroksittain ilman ihmisen suoraa ohjausta. Kuitenkin termi "ymmärtäminen" on metaforinen ja ei vastaa ihmismäistä tietoista prosessointia. Mallit eivät ole tietoisia oppimisprosessistaan eikä niillä ole semanttista ymmärrystä datasta. Ne toimivat matemaattisten ja tilastollisten algoritmien perusteella, mikä rajoittaa niiden kykyä tulkita tai ymmärtää dataa ihmisen tavoin.
Tämä erotus on tärkeä ymmärtää, erityisesti silloin, kun syväoppimismalleja käytetään sovelluksissa, jotka vaativat korkean tason selitettävyyttä ja luotettavuutta. Vaikka mallit ovat tehokkaita monimutkaisten tehtävien suorittamisessa, niiden ymmärrys on sisäänrakennettua ja rajoittunutta siihen, mitä algoritmi mahdollistaa.
Referenssit
Last updated January 23, 2025