
解鎖深度強化學習的引擎:TD 誤差的計算與深刻意涵
深入探索時間差分誤差 (Temporal Difference Error) 如何驅動智能體學習與決策。
核心亮點
- TD 誤差定義: 時間差分 (TD) 誤差是衡量強化學習智能體對未來累積獎勵的預測值與實際觀測(即時獎勵 + 下一狀態的預測值)之間差異的關鍵指標。
- 計算公式: 其核心計算涉及即時獎勵、折扣因子以及對當前狀態和下一狀態價值的估計,具體形式取決於是估計狀態價值 V(s) 還是動作價值 Q(s,a)。
- 學習驅動力: TD 誤差作為一個學習信號,指導價值函數(或深度學習模型中的神經網路權重)的更新,旨在逐步減少預測偏差,從而優化智能體的決策策略。
理解時間差分學習 (Temporal Difference Learning) 的基石
融合蒙地卡羅與動態規劃的智慧
時間差分學習(Temporal Difference Learning, TD Learning)是強化學習領域中的一個核心概念。它巧妙地結合了蒙地卡羅(Monte Carlo, MC)方法和動態規劃(Dynamic Programming, DP)方法的思想。與 MC 方法一樣,TD 學習可以直接從經驗(episodes)中學習,無需事先知道環境的完整動態模型(model-free)。與 DP 方法相似,TD 學習利用現有的價值估計來更新其他的價值估計,這種基於自身估計進行更新的方式被稱為「自舉」(bootstrapping)。TD 學習允許智能體在每個時間步後更新其知識,而不是像 MC 方法那樣需要等待整個經驗序列結束,這使得它在連續或長期運行的任務中特別高效。
時間差分學習概念圖
自舉 (Bootstrapping) 的概念
「自舉」是指 TD 學習在更新當前狀態的價值估計時,會依賴於對後續狀態價值的 *估計*。換句話說,它使用一個猜測(下一狀態的價值估計)來更新另一個猜測(當前狀態的價值估計)。這與 MC 方法形成對比,後者使用實際觀測到的完整回報(return)來更新價值估計,不涉及中間估計。自舉使得 TD 學習能夠在經驗序列未完成時就進行學習和更新。
學習的核心:計算 TD 誤差
TD 誤差(\( \delta \),delta)是 TD 學習算法中的關鍵計算部分,它量化了智能體預測的準確性。其具體計算方式取決於我們是估計狀態的價值(State Value Function, V(s))還是狀態-動作對的價值(Action Value Function, Q(s,a))。
狀態價值函數 V(s) 的 TD 誤差
對於估計狀態價值 V(s) 的最基本 TD 方法(如 TD(0)),TD 誤差在時間步 \(t\) 的計算公式如下:
\[ \delta_t = R_{t+1} + \gamma V(S_{t+1}) - V(S_t) \]其中:
- \( \delta_t \):時間步 \(t\) 的 TD 誤差。
- \( R_{t+1} \):智能體從狀態 \(S_t\) 轉移到狀態 \(S_{t+1}\) 後,在時間步 \(t+1\) 獲得的即時獎勵 (immediate reward)。
- \( \gamma \) (gamma):折扣因子 (discount factor),是一個介於 0 和 1 之間的數,用來衡量未來獎勵相對於當前獎勵的重要性。較大的 \( \gamma \) 表示更看重長期回報。
- \( V(S_{t+1}) \):智能體對下一個狀態 \(S_{t+1}\) 的 *當前* 價值估計。
- \( V(S_t) \):智能體對當前狀態 \(S_t\) 的 *當前* 價值估計。
這個公式計算的是「觀測到的目標值」(\( R_{t+1} + \gamma V(S_{t+1}) \))與「當前預測值」(\( V(S_t) \))之間的差異。
動作價值函數 Q(s,a) 的 TD 誤差
在許多強化學習任務中,尤其是需要進行控制(選擇動作)的任務,我們更關心估計狀態-動作對的價值 Q(s,a)。不同的算法使用略有不同的 TD 誤差計算方式:
Q-Learning (Off-Policy)
Q-learning 是一種 Off-Policy(離策略)算法,它學習的是最佳動作價值函數, unabhängig von der aktuell ausgeführten Policy。其 TD 誤差計算如下:
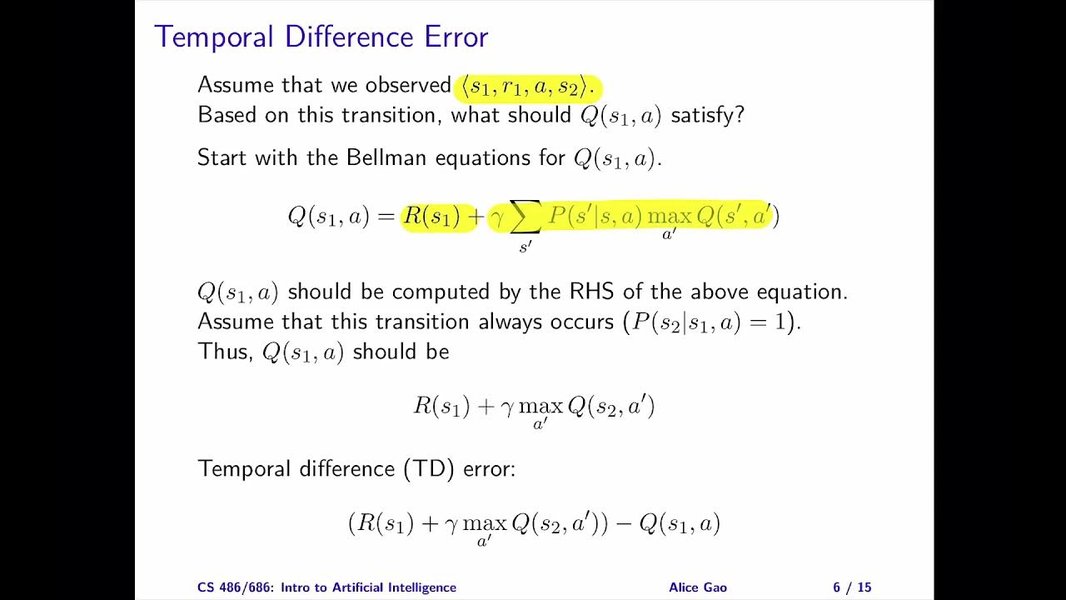
\[ \delta_t = R_{t+1} + \gamma \max_{a'} Q(S_{t+1}, a') - Q(S_t, a_t) \]這裡的關鍵區別在於目標值部分:它使用了下一狀態 \(S_{t+1}\) 所有可能動作 \(a'\) 中能夠產生最大 Q 值的那個動作來計算目標,即 \( \max_{a'} Q(S_{t+1}, a') \)。這代表了在下一狀態能獲得的理論上的最佳價值。
- \( Q(S_t, a_t) \):智能體對在狀態 \(S_t\) 採取動作 \(a_t\) 的 *當前* 價值估計。
- \( \max_{a'} Q(S_{t+1}, a') \):智能體對下一狀態 \(S_{t+1}\) 可能達到的最大動作價值的 *當前* 估計。
SARSA (On-Policy)
SARSA 是一種 On-Policy(同策略)算法,它學習的是智能體 *當前遵循的策略* 下的動作價值函數。其 TD 誤差計算如下:
\[ \delta_t = R_{t+1} + \gamma Q(S_{t+1}, a_{t+1}) - Q(S_t, a_t) \]這裡,目標值的計算使用的是智能體在狀態 \(S_{t+1}\) *實際選擇* 的下一個動作 \(a_{t+1}\) 的 Q 值,即 \( Q(S_{t+1}, a_{t+1}) \)。這反映了當前策略的實際表現。
- \( Q(S_{t+1}, a_{t+1}) \):智能體對在下一狀態 \(S_{t+1}\) 實際採取動作 \(a_{t+1}\) 的 *當前* 價值估計。
理解 TD 目標 (TD Target)
在上述公式中,形如 \( R_{t+1} + \gamma V(S_{t+1}) \) 或 \( R_{t+1} + \gamma \max_{a'} Q(S_{t+1}, a') \) 或 \( R_{t+1} + \gamma Q(S_{t+1}, a_{t+1}) \) 的部分被稱為 **TD 目標 (TD Target)**。它代表了基於單步實際獎勵和下一狀態價值估計所構成的、對當前狀態(或狀態-動作對)價值的一個更可靠的估計值。TD 誤差本質上就是當前估計值與這個 TD 目標之間的差距。
TD 誤差為何如此重要:在深度強化學習中的意義
TD 誤差不僅僅是一個數學公式,它是驅動強化學習智能體學習和適應的核心機制,在深度強化學習(DRL)中尤為關鍵。
量化預測準確性:「驚訝」的信號
TD 誤差最直接的意義是作為一個 **預測誤差 (Prediction Error)** 或 **獎勵預測誤差 (Reward Prediction Error)** 的衡量指標。它量化了智能體對未來獎勵的預期(基於當前價值估計)與實際經歷(即時獎勵加上對後續狀態的價值估計)之間的差距。
正負誤差的啟示
- 正 TD 誤差 (\( \delta_t > 0 \)): 表示實際獲得的結果(獎勵 + 下一狀態價值)比預期的要好。這意味著當前對 \(V(S_t)\) 或 \(Q(S_t, a_t)\) 的估計可能過於悲觀(低估了),需要向上調整。
- 負 TD 誤差 (\( \delta_t < 0 \)): 表示實際結果不如預期。這意味著當前的估計可能過於樂觀(高估了),需要向下調整。
- 零 TD 誤差 (\( \delta_t = 0 \)): 表示預測與實際觀測(在單步自舉的意義上)完全一致,當前估計相對準確。
這個誤差信號就像一個「驚訝」的程度指示器,告訴智能體它的預期在多大程度上偏離了現實。
學習的引擎:驅動價值更新
TD 誤差最重要的作用是作為 **學習信號 (Learning Signal)**,直接用於更新價值函數的估計。
價值函數的迭代更新
典型的 TD 更新規則如下(以 V(s) 為例):
\[ V(S_t) \leftarrow V(S_t) + \alpha \delta_t \]或者對於 Q(s,a):
\[ Q(S_t, a_t) \leftarrow Q(S_t, a_t) + \alpha \delta_t \]其中 \( \alpha \) (alpha) 是學習率 (learning rate),控制每次更新的步長。這個更新規則直觀地體現了 TD 誤差的作用:如果誤差為正,則增加價值估計;如果誤差為負,則降低價值估計。學習率 \( \alpha \) 決定了每次更新對原有估計的影響程度。
指導神經網路訓練
在深度強化學習中,價值函數(V 或 Q)通常由深度神經網路來近似。TD 誤差在這裡扮演了計算 **損失函數 (Loss Function)** 的關鍵角色。例如,在 Deep Q-Network (DQN) 中,常用的損失函數是 TD 誤差的均方誤差 (Mean Squared Error, MSE):
\[ \text{Loss} = \frac{1}{2} (\delta_t)^2 = \frac{1}{2} ( (R_{t+1} + \gamma \max_{a'} Q_{target}(S_{t+1}, a')) - Q_{network}(S_t, a_t) )^2 \](注意:這裡通常使用一個獨立的 target 網路 \(Q_{target}\) 來計算目標值以提高穩定性)。然後,通過反向傳播 (backpropagation) 算法計算損失函數相對於網路權重的梯度,並使用梯度下降等優化算法來更新網路參數,目標是最小化 TD 誤差,從而使網路輸出的 Q 值越來越接近真實的動作價值。
實現高效學習
逐步更新與自舉 (Bootstrapping)
TD 誤差使得學習能夠在每一步之後進行更新,而不是像蒙地卡羅方法那樣需要等待整個回合結束。這種基於「自舉」(使用 \(V(S_{t+1})\) 或 \(Q(S_{t+1}, \cdot)\) 的估計值)的更新方式,通常比 MC 方法具有更低的變異數 (variance),並且在處理連續性任務或無限長度的任務時更加自然和高效。
無模型方法 (Model-Free)
基於 TD 誤差的學習算法(如 Q-learning, SARSA)屬於無模型方法,意味著它們不需要事先了解環境的完整動態模型(狀態轉移概率和獎勵函數)。智能體可以直接從與環境互動的經驗中學習,這使得 TD 方法非常適用於現實世界中模型未知或過於複雜難以建立的場景。
連接基礎理論
與貝爾曼方程 (Bellman Equation) 的關係
TD 誤差與強化學習的基礎理論——貝爾曼方程密切相關。貝爾曼方程描述了最優價值函數應滿足的遞迴關係。TD 誤差可以被看作是衡量當前價值估計在多大程度上違反了貝爾曼方程所描述的一致性。通過不斷驅動 TD 誤差趨近於零,TD 學習算法實際上是在試圖找到一個滿足貝爾曼方程的價值函數解,從而收斂到(或逼近)真實的最優價值函數。
在先進 DRL 架構中的角色
TD 誤差是許多先進 DRL 算法的核心組件:
- Deep Q-Networks (DQN): 如前所述,TD 誤差是計算 DQN 損失函數的基礎,用於訓練 Q 網路。
- Actor-Critic 方法: 在 Actor-Critic 架構中,Critic(評論家)通常負責估計價值函數(V 或 Q),並計算 TD 誤差。這個 TD 誤差隨後被用作指導 Actor(行動家)更新其策略的信號。正的 TD 誤差鼓勵 Actor 增加導致該狀態/動作的概率,負的 TD 誤差則相反。
- Prioritized Experience Replay (PER): 在 DQN 的一種重要改進 PER 中,TD 誤差的絕對值 \( |\delta_t| \) 被用來衡量某個經驗(transition)的重要性或「驚訝程度」。誤差越大的經驗被認為包含更多學習信息,因此在從經驗回放緩衝區中採樣進行訓練時,會被賦予更高的優先級。
TD 學習方法比較:雷達圖視角
為了更直觀地理解 TD 學習的特性,我們可以將其與蒙地卡羅 (MC) 和動態規劃 (DP) 方法在幾個關鍵維度上進行比較。下方的雷達圖展示了這三種方法在樣本效率、偏差、變異數、計算成本、是否需要模型以及線上學習能力方面的相對表現(評分越高代表在該維度上越有優勢,注意低偏差/低變異數/低成本在此圖中對應高分)。
從圖中可以看出,TD 學習在多個方面取得了良好的平衡,尤其是在無模型要求、線上學習能力和相對較低的計算成本方面表現突出,同時保持了不錯的樣本效率和變異數控制,儘管可能引入一定的偏差(由於自舉)。
TD 誤差概念關聯圖
下面的心智圖總結了 TD 誤差及其在強化學習,特別是深度強化學習中的核心地位和相關概念。
(Prediction Error)"] id1b["計算公式"] id1b1["V(s): R + γV(S') - V(S)"] id1b2["Q(s,a) Q-learning: R + γ max Q(S', a') - Q(S, a)"] id1b3["Q(s,a) SARSA: R + γ Q(S', a') - Q(S, a)"] id1c["角色: 學習信號
(Learning Signal)"] id1c1["價值函數更新"] id1c2["損失函數 (DRL)"] id1c3["策略改進 (Actor-Critic)"] id2["關鍵特性"] id2a["自舉 (Bootstrapping)"] id2b["無模型 (Model-Free)"] id2c["線上學習 (Online Learning)"] id3["關聯理論/方法"] id3a["貝爾曼方程 (Bellman Eq.)"] id3b["蒙地卡羅 (MC)"] id3c["動態規劃 (DP)"] id4["在 DRL 中的應用"] id4a["Deep Q-Network (DQN)"] id4b["Actor-Critic 方法"] id4c["TD(λ) / Eligibility Traces"] id4d["優先經驗重放 (PER)"]
這張圖清晰地展示了 TD 誤差是如何作為 TD 學習的核心,連接了基本計算、學習機制、理論基礎以及在現代深度強化學習算法中的廣泛應用。
TD 誤差公式變體總結
為了方便比較,下表總結了用於狀態價值函數 (V(s)) 和兩種常見動作價值函數 (Q(s,a)) 學習算法(Q-learning 和 SARSA)的 TD 誤差計算及其關鍵特性。
| 特徵 (Feature) | 狀態價值函數 (V(s)) TD 誤差 | Q-learning TD 誤差 | SARSA TD 誤差 |
|---|---|---|---|
| 計算公式 (Formula) | \( \delta_t = R_{t+1} + \gamma V(S_{t+1}) - V(S_t) \) | \( \delta_t = R_{t+1} + \gamma \max_{a'} Q(S_{t+1}, a') - Q(S_t, a_t) \) | \( \delta_t = R_{t+1} + \gamma Q(S_{t+1}, a_{t+1}) - Q(S_t, a_t) \) |
| TD 目標 (Target Value) | \( R_{t+1} + \gamma V(S_{t+1}) \) | \( R_{t+1} + \gamma \max_{a'} Q(S_{t+1}, a') \) | \( R_{t+1} + \gamma Q(S_{t+1}, a_{t+1}) \) |
| 學習類型 (Learning Type) | 狀態價值預測 (State Value Prediction) | 控制 (Control) / 動作價值學習 (Action Value Learning) | 控制 (Control) / 動作價值學習 (Action Value Learning) |
| 策略依賴性 (Policy Dep.) | 可用於 On-Policy 或 Off-Policy 評估 | Off-Policy (離策略) | On-Policy (同策略) |
| 下一動作選擇 (Next Action in Target) | 不直接涉及動作選擇 | 基於下一狀態的理論最佳動作 (Hypothetical Best Action) | 基於當前策略實際選擇的下一動作 (Actual Next Action) |
| 主要應用 (Primary Use) | 策略評估 (Policy Evaluation) | DQN, Off-Policy Control Tasks | On-Policy Control Tasks |
深入理解 TD 學習:影片講解
以下影片提供了對時間差分學習(包括 Q-Learning)的更深入解釋和視覺化示例,有助於理解 TD 誤差在實際學習過程中的作用。
影片:時間差分學習 (包含 Q-Learning)
觀看此影片可以幫助您:
- 視覺化理解 TD 更新過程。
- 看到 TD 學習與蒙地卡羅方法的比較示例。
- 了解 N-Step TD 學習的概念。
- 掌握 Q-Learning 作為一種重要的 TD 控制算法。
常見問題解答 (FAQ)
TD 誤差和蒙地卡羅 (MC) 誤差有什麼不同?
主要區別在於計算目標值的方式和更新時機:
- TD 誤差:基於單步實際獎勵和 *下一狀態的價值估計*(自舉)來計算目標值。可以在每個時間步後立即更新價值函數。通常具有較低的變異數但可能引入偏差。
- MC 誤差:基於從當前狀態開始直到 *整個回合結束* 所獲得的實際累積回報來計算目標值。必須等到回合結束才能進行更新。通常具有較高的變異數但偏差較低(因為使用實際回報)。
為什麼在 TD 誤差計算中使用折扣因子 γ?
折扣因子 \( \gamma \) (介於 0 和 1 之間) 有幾個重要作用:
- 權衡未來獎勵:它決定了未來獎勵相對於即時獎勵的重要性。\( \gamma \) 接近 1 表示非常看重長期回報,接近 0 則更關注短期利益。
- 數學收斂性:在無限時間範圍的任務中,折扣因子確保了價值函數的計算是有界的,有助於算法收斂。
- 模擬偏好:可以模擬現實世界中對延遲獎勵的不確定性或偏好即時滿足的行為。
學習率 α 如何影響 TD 誤差的更新?
學習率 \( \alpha \) (通常介於 0 和 1 之間) 控制了每次 TD 誤差對價值估計更新的影響程度:
- 較大的 \( \alpha \):意味著新的經驗(由 TD 誤差反映)對價值估計的影響更大,學習速度更快,但可能導致估計值波動較大,不易穩定收斂。
- 較小的 \( \alpha \):意味著價值估計的更新更為平滑,更多地依賴於歷史平均,收斂可能更穩定,但學習速度較慢。
選擇合適的學習率(可能隨時間衰減)對算法性能至關重要。
TD 誤差一定是越小越好嗎?
總體目標是使價值函數收斂,這通常意味著 TD 誤差趨近於零。然而,在學習過程中,TD 誤差的大小本身提供了有用的信息:
- 學習初期:較大的 TD 誤差是正常的,表明模型正在從經驗中學習並調整其預測。
- 學習信號:非零的 TD 誤差是驅動學習的必要條件。如果誤差始終為零,則表示學習停滯。
- 診斷工具:持續的、系統性的大誤差(例如總是正或總是負)可能指示學習參數(如學習率、折扣因子)設置不當、模型容量不足或環境非平穩等問題。
- 探索與利用:在某些情況下,探索新狀態可能暫時導致較大的 TD 誤差,但這是發現更優策略所必需的。
因此,雖然最終目標是讓誤差變小,但在學習過程中,誤差的存在和大小是學習機制的一部分。
推薦探索
如果您對 TD 誤差和相關概念感興趣,可以進一步探索以下問題:
- TD(λ) 演算法是如何結合 TD 誤差和資格跡 (eligibility traces) 的?
- 在深度強化學習中估計 TD 誤差會遇到哪些挑戰?
- 比較 Q-learning 和 SARSA 演算法的優缺點。
- 如何使用 TD 誤差進行優先經驗重放 (Prioritized Experience Replay)?
參考資料
Last updated April 30, 2025