
Dévoiler les Mystères du Modèle MLP : Votre Guide Complet sur le Perceptron Multicouche
Plongez au cœur d'un des piliers de l'intelligence artificielle et découvrez comment le MLP façonne le machine learning.
Les Essentiels du Modèle MLP en Un Clin d'Œil
- Architecture en Couches : Le MLP (Perceptron Multicouche) est un réseau de neurones artificiels structuré avec une couche d'entrée, une ou plusieurs couches cachées, et une couche de sortie.
- Apprentissage Supervisé Puissant : Il excelle dans les tâches de classification et de régression en apprenant à partir de données étiquetées grâce à l'algorithme de rétropropagation.
- Non- linéarité Clé : L'utilisation de fonctions d'activation non linéaires dans les couches cachées permet au MLP de modéliser des relations complexes et non linéaires, impossibles à capturer par des modèles linéaires simples.
Qu'est-ce que le Modèle MLP (Perceptron Multicouche) ?
Définition Fondamentale
Le Modèle MLP, acronyme de Multilayer Perceptron (ou Perceptron Multicouche en français), est un type fondamental de réseau de neurones artificiels (RNA) largement utilisé en intelligence artificielle et en apprentissage automatique (machine learning). Il appartient à la classe des réseaux de neurones à propagation avant (feedforward), ce qui signifie que l'information y circule dans une seule direction, de l'entrée vers la sortie, sans cycles ni boucles de rétroaction directes lors de la phase de prédiction.
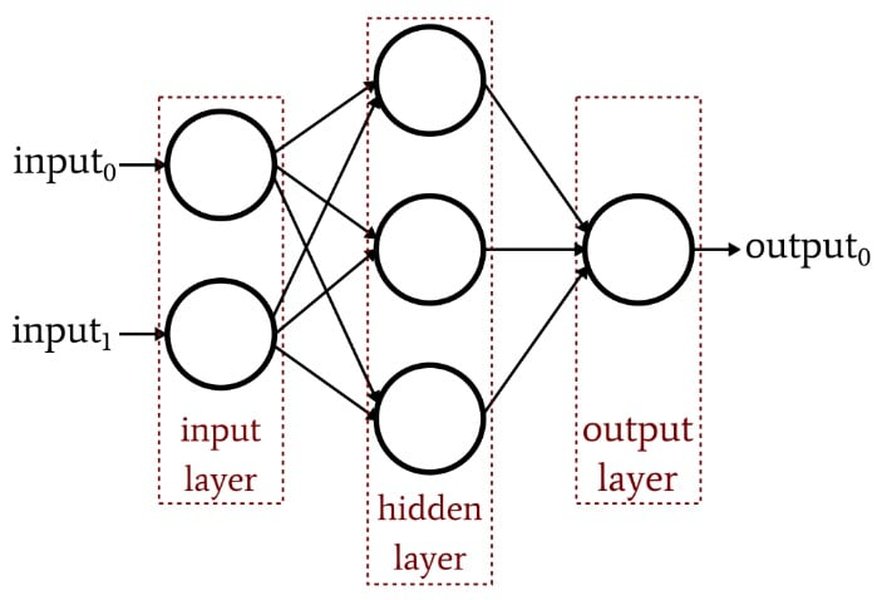
Un MLP est caractérisé par sa structure en plusieurs couches de neurones (ou nœuds) :
- Une couche d'entrée (input layer) qui reçoit les données brutes ou les caractéristiques du problème à traiter.
- Au moins une couche cachée (hidden layer) qui effectue des transformations non linéaires sur les données reçues de la couche précédente. La présence de ces couches cachées est ce qui distingue le MLP du perceptron simple et lui confère sa puissance.
- Une couche de sortie (output layer) qui produit le résultat final du réseau, que ce soit une classification (par exemple, attribuer une étiquette à une image) ou une valeur de régression (par exemple, prédire un prix).
Les neurones de chaque couche sont typiquement entièrement connectés aux neurones de la couche suivante, signifiant que la sortie de chaque neurone d'une couche sert d'entrée à tous les neurones de la couche subséquente. La capacité du MLP à apprendre des motifs complexes découle principalement de l'utilisation de fonctions d'activation non linéaires au sein de ses neurones cachés.

Architecture typique d'un Perceptron Multicouche illustrant les connexions entre les couches.
L'Architecture Détaillée d'un MLP
Comprendre l'architecture d'un MLP est essentiel pour saisir son fonctionnement. Chaque composant joue un rôle précis dans le traitement de l'information et l'apprentissage.
La Couche d'Entrée : La Porte des Données
La couche d'entrée ne réalise aucun calcul. Son rôle est de recevoir les données initiales, souvent appelées caractéristiques (features). Chaque neurone (ou nœud) de cette couche correspond généralement à une caractéristique du jeu de données. Par exemple, pour prédire le prix d'une maison, les entrées pourraient être sa superficie, son nombre de chambres, et son âge.
Les Couches Cachées : Le Cœur du Traitement
C'est au sein des couches cachées que la "magie" opère. Un MLP peut posséder une ou plusieurs couches cachées. Plus il y a de couches cachées (et de neurones), plus le modèle est dit "profond" et capable, en théorie, d'apprendre des représentations hiérarchiques et complexes des données. Chaque neurone d'une couche cachée reçoit des entrées pondérées de tous les neurones de la couche précédente, calcule une somme pondérée à laquelle un biais est ajouté, puis applique une fonction d'activation non linéaire à ce résultat. C'est cette non-linéarité qui permet au MLP de résoudre des problèmes qui ne sont pas linéairement séparables, une limitation majeure du perceptron simple.
La Couche de Sortie : Le Verdict Final
La couche de sortie produit la prédiction finale du réseau. Le nombre de neurones et la fonction d'activation utilisée dans cette couche dépendent de la nature de la tâche :
- Pour la classification binaire (ex: spam ou non-spam), un seul neurone avec une fonction d'activation sigmoïde est courant.
- Pour la classification multiclasse (ex: reconnaissance de chiffres de 0 à 9), on utilise souvent autant de neurones qu'il y a de classes, avec une fonction d'activation softmax.
- Pour la régression (ex: prédire une valeur continue comme un prix), un seul neurone avec une fonction d'activation linéaire (ou aucune activation explicite) est typique.
Neurones, Poids et Biais : Les Briques Élémentaires
Chaque connexion entre deux neurones de couches adjacentes est associée à un poids. Ce poids détermine l'importance (la force) du signal transmis. Chaque neurone (sauf ceux de la couche d'entrée) possède également un biais, qui permet d'ajuster la sortie de la fonction d'activation indépendamment des entrées. Les poids et les biais sont les paramètres du modèle que le MLP apprend durant la phase d'entraînement.
La carte mentale ci-dessous visualise la structure et les composants clés d'un modèle MLP, offrant une vue d'ensemble de son organisation interne.
(Input Layer)"] id1_2["Couches Cachées (≥1)
(Hidden Layers)"] id1_2_1["Neurones (Nodes)"] id1_2_2["Fonctions d'activation non linéaires
(ex: ReLU, Sigmoïde, Tanh)"] id1_3["Couche de Sortie
(Output Layer)"] id1_4["Connexions (Poids & Biais)"] id2["Fonctionnement"] id2_1["Propagation Avant (Feedforward)
Flux d'information"] id2_2["Calcul de l'Erreur
(Fonction de Perte / Loss Function)"] id2_3["Rétropropagation (Backpropagation)
Ajustement des poids et biais"] id3["Apprentissage (Training)"] id3_1["Supervisé
(Données étiquetées)"] id3_2["Processus itératif (Époques)"] id3_3["Optimisation
(ex: Descente de Gradient)"] id4["Applications Principales"] id4_1["Classification
(ex: reconnaissance d'images, détection de fraude)"] id4_2["Régression
(ex: prédiction de prix, analyse de séries temporelles)"] id5["Caractéristiques Clés"] id5_1["Approximations universelles de fonctions"] id5_2["Capacité à modéliser des relations non linéaires complexes"] id5_3["Fondation pour le Deep Learning"]
Le Fonctionnement Interne : De la Propagation à l'Apprentissage
Le MLP apprend en deux phases principales : la propagation avant (pour faire des prédictions) et la rétropropagation (pour ajuster ses paramètres).
Propagation Avant (Feedforward) : Le Flux d'Information
Lors de la phase de propagation avant, les données d'entrée traversent le réseau couche par couche. Pour chaque neurone dans une couche cachée ou la couche de sortie :
- Il calcule une somme pondérée de ses entrées (provenant des neurones de la couche précédente), à laquelle un terme de biais est ajouté. Mathématiquement, si \(x_i\) sont les sorties des neurones de la couche précédente et \(w_i\) les poids des connexions respectives, et \(b\) le biais, l'entrée nette du neurone est : \[ z = \sum_{i} (w_i \cdot x_i) + b \]
- Le résultat \(z\) est ensuite passé à travers une fonction d'activation non linéaire \(f\) pour produire la sortie \(a\) du neurone : \(a = f(z)\).
Ce processus se répète jusqu'à ce que la couche de sortie produise la prédiction finale du réseau.
Le cycle d'entraînement d'un réseau neuronal implique la propagation avant pour la prédiction et la rétropropagation pour l'ajustement des poids.
Rôle Crucial des Fonctions d'Activation Non Linéaires
Sans fonctions d'activation non linéaires dans les couches cachées, un MLP, peu importe le nombre de ses couches, se comporterait comme un simple perceptron à une seule couche, capable uniquement de modéliser des relations linéaires. Les fonctions non linéaires introduisent la complexité nécessaire pour apprendre des frontières de décision non linéaires et approximer des fonctions arbitraires. Les fonctions courantes incluent :
- Sigmoïde : Comprime les valeurs entre 0 et 1. Historiquement populaire, mais peut souffrir du problème de "vanishing gradient".
- Tangente Hyperbolique (Tanh) : Comprime les valeurs entre -1 et 1. Similaire à la sigmoïde mais centrée sur zéro.
- Unité Linéaire Rectifiée (ReLU) : \(f(x) = \max(0, x)\). Très populaire en deep learning car elle est simple à calculer et aide à atténuer le problème du "vanishing gradient". Des variantes comme Leaky ReLU existent.
Fonction de Perte : Mesurer l'Erreur
Après la propagation avant, la prédiction du réseau est comparée à la valeur réelle (cible) issue des données d'entraînement. Une fonction de perte (ou fonction de coût) quantifie cette différence (l'erreur). Le choix de la fonction de perte dépend de la tâche :
- Erreur Quadratique Moyenne (MSE) pour la régression.
- Entropie Croisée (Cross-Entropy) pour la classification.
L'objectif de l'entraînement est de minimiser cette fonction de perte.
Rétropropagation (Backpropagation) : L'Art d'Apprendre de ses Erreurs
L'algorithme de rétropropagation est le moteur de l'apprentissage dans les MLP. Il calcule le gradient de la fonction de perte par rapport à chaque poids et biais du réseau, en propageant l'erreur "vers l'arrière", de la couche de sortie vers la couche d'entrée. Ces gradients indiquent comment chaque poids et biais doit être ajusté pour réduire l'erreur. Un algorithme d'optimisation, typiquement une variante de la descente de gradient (comme Adam, SGD, RMSprop), utilise ensuite ces gradients pour mettre à jour itérativement les poids et les biais du réseau, rapprochant ainsi progressivement les prédictions du modèle des valeurs cibles.
Entraînement d'un MLP : Un Processus Itératif
L'entraînement d'un MLP est un processus d'optimisation qui nécessite des données, des choix de conception et un suivi attentif.
Apprentissage Supervisé et Données Étiquetées
Le MLP est un modèle d'apprentissage supervisé. Cela signifie qu'il apprend à partir d'un ensemble de données d'entraînement où chaque exemple d'entrée est associé à une sortie correcte (une étiquette ou une valeur cible). Le modèle ajuste ses paramètres internes (poids et biais) pour minimiser la différence entre ses prédictions et ces sorties correctes.
Hyperparamètres Clés à Considérer
La performance d'un MLP dépend fortement de la configuration de ses hyperparamètres. Ce sont des paramètres qui ne sont pas appris directement par le modèle mais qui sont définis avant le début du processus d'entraînement. Le tableau suivant résume quelques hyperparamètres courants et leur rôle :
| Hyperparamètre | Description | Impact Typique sur le Modèle |
|---|---|---|
| Nombre de couches cachées | Définit la profondeur du réseau. Plus il y a de couches, plus le modèle peut potentiellement apprendre des caractéristiques complexes et abstraites. | Augmente la capacité à apprendre des fonctions complexes, mais aussi le risque de surapprentissage et le coût computationnel. |
| Nombre de neurones par couche cachée | Détermine la largeur de chaque couche. Plus de neurones permettent de capturer plus d'informations. | Augmente la capacité de la couche à représenter des informations, mais peut aussi mener au surapprentissage si excessif. |
| Fonctions d'activation | Transformation non linéaire appliquée à la sortie de chaque neurone dans les couches cachées et de sortie. Ex: ReLU, Sigmoïde, Tanh, Softmax. | Crucial pour permettre au réseau de modéliser la non-linéarité. Le choix dépend de la tâche et des propriétés souhaitées. |
| Taux d'apprentissage (Learning Rate) | Taille du pas effectué lors de l'ajustement des poids et biais par l'algorithme d'optimisation (ex: descente de gradient). | Un taux trop élevé peut empêcher la convergence ; un taux trop bas peut rendre l'entraînement excessivement lent. |
| Optimiseur (Optimizer) | Algorithme utilisé pour minimiser la fonction de perte en ajustant les poids (ex: SGD, Adam, RMSprop). | Affecte la vitesse, la stabilité et la qualité de la convergence du modèle. |
| Fonction de perte (Loss Function) | Mesure l'écart entre les prédictions du modèle et les valeurs réelles (cibles). Ex: Erreur Quadratique Moyenne, Entropie Croisée. | Guide le processus d'optimisation. Le choix est dicté par le type de problème (régression, classification). |
| Nombre d'époques (Epochs) | Nombre de fois que l'ensemble complet des données d'entraînement est présenté au modèle pendant l'entraînement. | Trop peu d'époques peuvent entraîner un sous-apprentissage ; trop d'époques peuvent mener au surapprentissage. |
| Taille du lot (Batch Size) | Nombre d'échantillons de données d'entraînement traités avant que les poids du modèle ne soient mis à jour. | Influence la stabilité de l'apprentissage, la vitesse de convergence et l'utilisation de la mémoire. |
L'ajustement de ces hyperparamètres, souvent appelé "réglage des hyperparamètres" (hyperparameter tuning), est une étape cruciale pour obtenir de bonnes performances.
Applications Courantes du MLP
Grâce à sa capacité à modéliser des relations non linéaires complexes, le Perceptron Multicouche est utilisé dans une vaste gamme d'applications.
Classification : Catégoriser le Monde
En classification, le MLP apprend à assigner une étiquette de catégorie à une entrée. Parmi les exemples notables, on trouve :
- Reconnaissance d'images : Identifier des objets dans des images (par exemple, distinguer un chat d'un chien). Bien que les CNN (Convolutional Neural Networks) soient souvent préférés pour les tâches d'images complexes, les MLP peuvent être efficaces sur des images plus simples ou des caractéristiques extraites.
- Détection de spam : Classifier les emails comme étant du spam ou non.
- Diagnostic médical : Aider à identifier des maladies à partir de données de patients.
- Reconnaissance de l'écriture manuscrite : Comme pour le célèbre jeu de données MNIST des chiffres manuscrits.
Régression : Prédire des Valeurs Continues
En régression, le MLP apprend à prédire une valeur numérique continue. Quelques applications :
- Prédiction de prix : Estimer le prix d'une action, d'un bien immobilier, etc.
- Prévisions météorologiques : Prédire la température, les précipitations.
- Analyse de séries temporelles : Modéliser et prédire des tendances dans des données séquentielles.
Le diagramme radar ci-dessous offre une perspective sur l'adéquation relative et les défis des MLP pour différents types de tâches. Les scores sont une évaluation qualitative générale : plus le score est élevé vers l'extérieur, meilleure est l'adéquation ou plus l'aspect est prononcé.
Ce graphique illustre que si les MLP sont polyvalents, leur efficacité et les ressources nécessaires (données, complexité de configuration) peuvent varier significativement selon le domaine d'application. Par exemple, ils sont très performants sur des données tabulaires ou pour la reconnaissance de formes simples, mais peuvent nécessiter plus d'ajustements ou être supplantés par des architectures spécialisées pour des tâches très complexes comme le traitement avancé du langage naturel.
Avantages et Limites du Perceptron Multicouche
Les Forces du MLP
- Apprentissage de relations non linéaires : Grâce aux fonctions d'activation non linéaires, les MLP peuvent modéliser des dépendances complexes que les modèles linéaires ne peuvent pas capturer.
- Approximateur universel : Théoriquement, un MLP avec une seule couche cachée (suffisamment large) et une fonction d'activation appropriée peut approximer n'importe quelle fonction continue avec une précision arbitraire. C'est le théorème d'approximation universelle.
- Flexibilité : L'architecture (nombre de couches, de neurones) peut être adaptée à la complexité du problème.
- Efficacité sur données structurées : Ils performent bien sur des données tabulaires ou lorsque les caractéristiques sont bien définies.
Les Défis à Relever
- Surapprentissage (Overfitting) : Les MLP, surtout ceux avec de nombreux paramètres, peuvent "mémoriser" les données d'entraînement au lieu de généraliser à de nouvelles données. Des techniques de régularisation (comme Dropout, L1/L2) sont souvent nécessaires.
- Besoin en données : Ils requièrent généralement une quantité significative de données d'entraînement pour bien performer et éviter le surapprentissage.
- Sensibilité aux hyperparamètres : Leur performance peut être très sensible au choix des hyperparamètres (taux d'apprentissage, nombre de couches/neurones, etc.), nécessitant un réglage soigneux.
- Coût computationnel : L'entraînement de grands MLP peut être gourmand en ressources de calcul, bien que moins que certaines architectures de deep learning plus récentes et plus vastes.
- Interprétabilité limitée ("Boîte noire") : Comprendre pourquoi un MLP prend une décision spécifique peut être difficile, car les calculs dans les couches cachées sont complexes et pas directement intuitifs.
- Sensibilité à la mise à l'échelle des caractéristiques : Les MLP fonctionnent mieux lorsque les caractéristiques d'entrée sont normalisées ou standardisées (par exemple, mises à l'échelle entre 0 et 1, ou avec une moyenne de 0 et un écart-type de 1).
Le MLP dans l'Écosystème de l'Apprentissage Profond
Le Perceptron Multicouche est souvent considéré comme l'une des formes les plus simples de réseau de neurones profonds (deep learning), surtout lorsqu'il comporte plusieurs couches cachées. Bien que des architectures plus spécialisées comme les Réseaux de Neurones Convolutifs (CNN) pour la vision par ordinateur ou les Réseaux de Neurones Récurrents (RNN) et les Transformers pour les données séquentielles (comme le texte ou les séries temporelles) aient émergé pour des tâches spécifiques, le MLP reste une brique fondamentale.
De nombreux concepts clés du deep learning, tels que la rétropropagation, les fonctions d'activation, les optimiseurs et les fonctions de perte, sont au cœur du fonctionnement des MLP. Comprendre le MLP est donc une étape essentielle pour quiconque souhaite s'aventurer dans le domaine plus vaste de l'apprentissage profond.
Cette vidéo (en anglais) offre une introduction visuelle et conceptuelle au Perceptron Multicouche, expliquant ses composantes et son fonctionnement dans le contexte du machine learning.
La vidéo ci-dessus, intitulée "What is Multilayer Perceptron (MLP) in Machine Learning?", propose une explication accessible de ce qu'est un MLP. Elle aborde sa structure en couches, l'importance des fonctions d'activation non linéaires pour traiter des données complexes, et le processus d'apprentissage via la rétropropagation. C'est une ressource utile pour visualiser les concepts discutés et comprendre comment un MLP apprend à partir des données pour effectuer des prédictions ou des classifications.
FAQ sur le Modèle MLP
Quelle est la différence fondamentale entre un Perceptron simple et un Perceptron Multicouche (MLP) ?
La différence majeure réside dans leur architecture et leur capacité. Un Perceptron simple n'a qu'une seule couche de traitement (la couche de sortie, directement connectée aux entrées) et utilise généralement une fonction d'activation à seuil (comme la fonction de Heaviside). Il ne peut résoudre que des problèmes linéairement séparables.
Un Perceptron Multicouche (MLP) possède au moins une couche cachée entre la couche d'entrée et la couche de sortie. Ces couches cachées utilisent des fonctions d'activation non linéaires (comme ReLU ou sigmoïde). Cette structure multicouche et la non-linéarité permettent au MLP de modéliser des relations complexes et de résoudre des problèmes non linéairement séparables, ce qui est bien au-delà des capacités d'un perceptron simple.
Un MLP est-il toujours considéré comme faisant partie du "deep learning" ?
La distinction peut être nuancée. Techniquement, tout réseau neuronal avec au moins une couche cachée est un pas au-delà des modèles linéaires simples. Le terme "deep learning" (apprentissage profond) est généralement associé aux réseaux neuronaux possédant plusieurs couches cachées (par exemple, 2, 5, 10, voire des centaines).
Ainsi, un MLP avec une seule couche cachée est un réseau neuronal, mais pas toujours qualifié de "profond". Cependant, un MLP avec de multiples couches cachées est définitivement une architecture de deep learning. Les principes d'entraînement (comme la rétropropagation) sont communs, et les MLP servent de fondation à la compréhension des réseaux plus profonds.
Quelles sont les fonctions d'activation les plus couramment utilisées dans les couches cachées d'un MLP et pourquoi ?
Les fonctions d'activation introduisent la non-linéarité, essentielle pour que le MLP apprenne des modèles complexes. Les plus courantes pour les couches cachées sont :
- ReLU (Rectified Linear Unit) : \(f(x) = \max(0, x)\). Elle est très populaire car elle est simple à calculer, aide à mitiger le problème de la disparition du gradient (vanishing gradient) pour les valeurs positives, et conduit souvent à un entraînement plus rapide.
- Sigmoïde : \(f(x) = 1 / (1 + e^{-x})\). Elle produit une sortie entre 0 et 1, ce qui peut être interprété comme une probabilité. Historiquement très utilisée, elle est moins favorisée dans les couches cachées des réseaux profonds en raison du problème de "vanishing gradient" et du fait que ses sorties ne sont pas centrées sur zéro.
- Tanh (Tangente Hyperbolique) : \(f(x) = (e^x - e^{-x}) / (e^x + e^{-x})\). Similaire à la sigmoïde mais produit une sortie entre -1 et 1. Ses sorties étant centrées sur zéro, elle peut parfois converger plus rapidement que la sigmoïde, mais souffre aussi du "vanishing gradient".
Le choix dépend souvent de l'architecture spécifique du réseau et du problème à résoudre, mais ReLU et ses variantes (Leaky ReLU, Parametric ReLU) sont devenues un standard de facto pour de nombreuses applications de deep learning.
Comment peut-on éviter le surapprentissage (overfitting) lors de l'entraînement d'un MLP ?
Le surapprentissage se produit lorsqu'un modèle apprend trop bien les données d'entraînement, y compris le bruit, et performe mal sur des données nouvelles et invisibles. Plusieurs techniques peuvent aider à l'éviter avec un MLP :
- Augmentation des données (Data Augmentation) : Créer artificiellement plus de données d'entraînement à partir des données existantes (ex: rotations, recadrages pour les images).
- Régularisation : Ajouter une pénalité à la fonction de perte pour la complexité du modèle. Les techniques courantes sont la régularisation L1 (qui encourage la parcimonie des poids) et L2 (qui encourage des poids de faible magnitude).
- Dropout : Pendant l'entraînement, désactiver aléatoirement un certain pourcentage de neurones à chaque itération. Cela force le réseau à apprendre des représentations plus robustes.
- Arrêt précoce (Early Stopping) : Surveiller la performance du modèle sur un ensemble de validation distinct pendant l'entraînement et arrêter l'entraînement lorsque la performance sur cet ensemble commence à se dégrader, même si la performance sur l'ensemble d'entraînement continue de s'améliorer.
- Simplification du modèle : Utiliser moins de couches cachées ou moins de neurones par couche.
- Validation croisée (Cross-validation) : Utiliser des techniques de validation croisée pour obtenir une estimation plus robuste de la performance du modèle et pour le réglage des hyperparamètres.
Pour Aller Plus Loin
Si vous souhaitez approfondir votre compréhension des Perceptrons Multicouches et des concepts associés, voici quelques pistes de recherche :
- Comment implémenter un Perceptron Multicouche en Python avec Scikit-learn ou TensorFlow ?
- Quelles sont les différences entre les MLP, les CNN et les RNN et quand utiliser chacun ?
- Exploration détaillée des techniques de régularisation pour les réseaux de neurones.
- Le rôle des optimiseurs (Adam, SGD, etc.) dans l'entraînement des MLP.
Références
Last updated May 6, 2025