
Diffusion Models: Creazione e Generazione di Video Basati su Keypoints
Una guida completa per comprendere e implementare modelli di diffusione per video animati
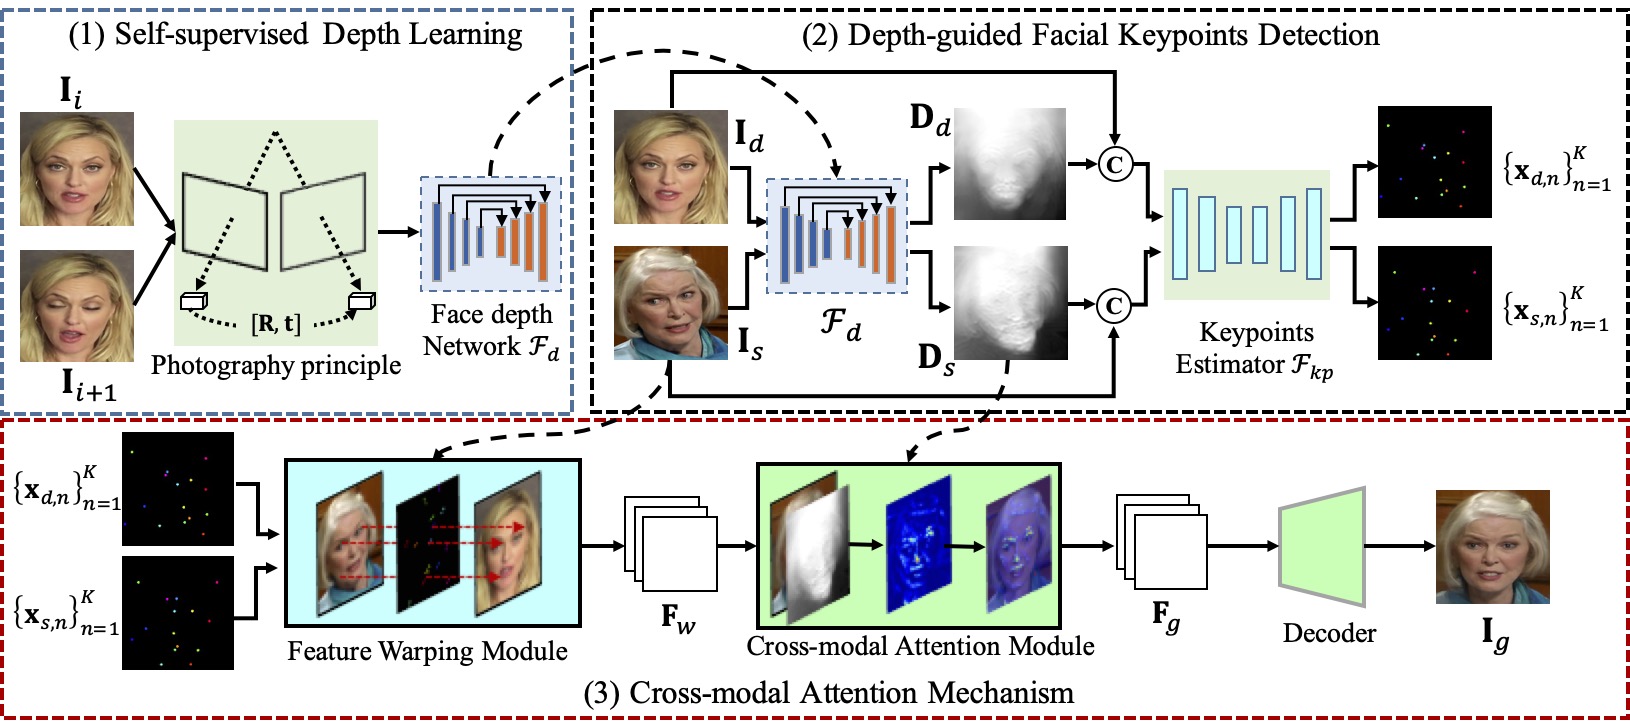
Punti Chiave
- Definizione e funzionalità: I diffusion models sono modelli generativi che creano dati di alta qualità attraverso un processo di aggiunta e rimozione del rumore.
- Architettura e addestramento: Utilizzano architetture avanzate come U-Net estese per gestire dati temporali e spaziali, condizionati da keypoints.
- Applicazioni e strumenti: Sono impiegati in numerosi ambiti, dalla generazione di pose umane realistiche all'animazione di oggetti, supportati da strumenti come PyTorch e TensorFlow.
Introduzione ai Diffusion Models
Cos'è un Diffusion Model?
I Diffusion Models sono una classe di modelli generativi nel campo del machine learning, progettati per creare dati complessi e di alta qualità come immagini, video e audio. Funzionano attraverso un processo in due fasi principali: la diffusione del rumore (forward process) e la denoising (reverse process).
Processo di Diffusione
-
Fase di Diffusione (Forward Process)
In questa fase, al dato originale (ad esempio, un'immagine o un video) viene aggiunto progressivamente del rumore gaussiano. Questo processo continua fino a trasformare il dato in una distribuzione completamente casuale, caratterizzata da rumore puro.
-
Fase di Denoising (Reverse Process)
Il modello apprende a invertire il processo di diffusione, rimuovendo gradualmente il rumore per ricostruire il dato originale o generarne uno nuovo. Questo processo di denoising avviene tramite una serie di passaggi ricorsivi in cui ogni iterazione produce una versione meno rumorosa del dato.
Creazione di un Diffusion Model per Video Basati su Keypoints
Definizione del Problema
La generazione di video basati su keypoints implica la creazione di sequenze video che seguono movimenti specifici definiti dai keypoints, ovvero punti chiave che rappresentano parti significative di un oggetto o di una scena (ad esempio, le articolazioni di una persona in un video di pose umane). L'obiettivo è generare video che mantengano coerenza temporale e spaziale seguendo la traiettoria definita dai keypoints.
Architettura del Modello
Utilizzo di U-Net Esteso
L'architettura di base utilizzata nei diffusion models è spesso una variante di U-Net, che viene estesa per gestire la dimensione temporale dei video. Questa estensione permette al modello di mantenere la coerenza spaziale e temporale nei dati generati.
Modulo di Elaborazione dei Keypoints
È necessario incorporare un modulo che processi i keypoints, come un encoder che trasforma le coordinate dei keypoints in rappresentazioni vettoriali comprese dal modello. Questo permette al modello di condizionare la generazione del video in base ai movimenti specificati.
Meccanismo di Condizionamento
Il condizionamento può essere implementato concatenando le rappresentazioni dei keypoints con le feature spaziali e temporali del modello. Questo guida il processo di generazione, assicurando che i movimenti nel video seguano le traiettorie definite dai keypoints.
Addestramento del Modello
Preparazione del Dataset
È essenziale preparare un dataset di video annotati con keypoints. Dataset come Human3.6M o PoseTrack sono comunemente utilizzati per questo scopo, fornendo una vasta gamma di pose umane annotate temporalmente.
Processo di Forward and Reverse
Durante l'addestramento, si aggiunge rumore ai video nel dataset attraverso il processo di forward diffusion. Il modello viene quindi addestrato a rimuovere questo rumore durante il reverse process, ricostruendo i video originali condizionati dai keypoints.
Funzione di Perdita
Una funzione di perdita comune utilizzata è l'Errore Quadratico Medio (MSE), che misura la differenza tra i video generati e quelli reali, incentivando il modello a produrre output il più possibile simili ai dati autentici.
Generazione del Video
Una volta addestrato, il modello può generare nuovi video fornendo una sequenza di keypoints. Il processo di denoising inverso utilizza queste sequenze per creare video che seguono le traiettorie specificate, mantenendo coerenza temporale e spaziale.
Ottimizzazione e Valutazione
Metriche di Valutazione
Per valutare la qualità dei video generati, si utilizzano metriche come la Fréchet Video Distance (FVD) e l'Structural Similarity Index (SSIM), che misurano rispettivamente la qualità globale e la somiglianza strutturale tra video generati e reali.
Ottimizzazione del Modello
Il modello può essere ottimizzato migliorando la coerenza temporale e la fedeltà ai keypoints. Ciò può includere l'affinamento dei parametri di diffusione e l'integrazione di tecniche di post-processing per una resa più fluida e realistica dei video.
Applicazioni Pratiche
Generazione di Video di Pose Umane
Partendo da una sequenza di keypoints che rappresentano le articolazioni di una persona, i diffusion models possono generare video realistici di movimenti umani, utili in ambiti come l'animazione, la realtà virtuale e il monitoraggio del movimento.
Animazione di Oggetti
Utilizzando keypoints che definiscono la struttura di un oggetto, i modelli possono generare video di oggetti in movimento, applicandosi a campi come la robotica, la simulazione e l'animazione computerizzata.
Strumenti e Librerie Utili
Framework di Machine Learning
Librerie come PyTorch e TensorFlow offrono supporto esteso per la creazione e l'addestramento di modelli di diffusione. Toolkit specializzati come Diffusion Toolkit o versioni personalizzate di Stable Diffusion facilitano ulteriormente il processo.
Framework Specifici
Framework pre-esistenti come StableKeypoints, che combinano keypoints con modelli di diffusione, possono accelerare lo sviluppo e la sperimentazione, permettendo di concentrarsi sull'ottimizzazione piuttosto che sulla costruzione di architetture da zero.
Implementazioni Pratiche
Esistono numerose implementazioni su piattaforme come GitHub, che offrono codici pronti all'uso e guide dettagliate per la configurazione di modelli di diffusione per la generazione di video.
Avanzamenti Recenti
Condizionamento dei Keypoints
Innovazioni recenti nel campo del condizionamento dei keypoints tramite diffusion models hanno permesso di generare video ancora più realistici e coerenti, sfruttando modelli pre-addestrati per l'individuazione automatica dei keypoints.
Tecnologie Correlate
- ControlNet: Permette di modificare pose, profondità e altre proprietà durante la generazione video, offrendo un controllo più preciso sui movimenti.
- Co-Speech Video Generation: Integra keypoints per generare video sincronizzati con movimenti specifici, come gesti associati a dialoghi o audio.
Raccomandazioni e Risorse
Risorse Online
- Generative Models by Stability AI
- Stable Video Diffusion on Hugging Face
- Stable Video Diffusion News
- Awesome Video Diffusion on GitHub
Ulteriori Letture
- Unsupervised Keypoints from Pretrained Diffusion Models
- Co-Speech Gesture Video Generation via Motion-Decoupled Diffusion Model
- Diffusion Models for Video Generation Summary
Conclusione
I diffusion models rappresentano una frontiera avanzata nel campo dei modelli generativi, offrendo capacità una volta inimmaginabili nella creazione di dati complessi come i video. La loro applicazione nella generazione di video basati su keypoints apre numerose opportunità in settori quali l'animazione, la realtà virtuale e il monitoraggio dei movimenti. Grazie all'evoluzione continua delle architetture e degli strumenti, è possibile sviluppare modelli sempre più sofisticati e realistici, spingendo oltre i limiti della creatività e della tecnologia.
Riferimenti
Last updated January 22, 2025