
揭秘DMA Barrier:确保CPU与外设数据同步的幕后英雄
深入剖析直接内存访问(DMA)中的内存屏障机制,保障数据一致性与系统稳定性。
核心要点
- DMA Barrier: 这是一种关键的内存屏障机制,用于协调CPU与DMA控制器之间的内存操作,确保数据读写顺序一致性,尤其在多核和带缓存的系统中至关重要。
- 必要性: 现代CPU和编译器为提高性能会进行乱序执行和缓存优化,若无DMA Barrier,可能导致DMA控制器读取到过时数据或CPU无法及时感知DMA写入的最新数据,从而引发数据不一致和系统错误。
- 实现原理: 它结合了硬件内存屏障指令(如ARM的DMB、DSB)、CPU缓存管理(刷新与失效)以及操作系统层面的DMA同步API,以强制内存操作的顺序并确保数据的可见性。
什么是DMA Barrier?深度解析其在计算机系统中的作用
DMA Barrier,即直接内存访问(Direct Memory Access)屏障,是计算机体系结构中一个至关重要的概念,尤其是在高性能计算和嵌入式系统中。它本质上是一种内存屏障(Memory Barrier),其核心作用是确保中央处理器(CPU)和直接内存访问(DMA)控制器在访问系统内存时,能够保持严格的数据读写顺序和一致性。简单来说,DMA Barrier就是一道“栅栏”,它强制CPU或编译器对屏障前后的内存操作执行特定的排序约束,以避免因乱序执行或缓存不一致而导致的数据错误。
DMA:高效数据传输的基石
为了理解DMA Barrier的重要性,首先需要了解DMA的基本原理。DMA是一种允许外部设备(如硬盘控制器、图形显示卡、网卡等)不通过CPU直接与系统内存进行数据交换的技术。在没有DMA的情况下,CPU需要频繁地参与到每一次数据传输中,这会大量占用CPU资源,降低系统整体效率。DMA的引入极大地解放了CPU,使其能够更专注于计算和控制等核心任务,从而显著提高系统吞吐量。
图1: DMA基本原理,展示了DMA控制器如何独立完成数据传输。
DMA控制器作为一个独立的硬件模块,负责管理外设和内存之间的数据传输。CPU只需对其进行初始化,设定好源地址、目标地址和传输数据量等参数后,DMA控制器便会独立完成数据的搬运工作。当数据传输完成后,DMA控制器会通知CPU。
为何需要DMA Barrier:乱序、缓存与同步挑战
现代CPU为了提高性能,普遍采用乱序执行(Out-of-Order Execution)和多级缓存(Cache)机制。编译器也可能对指令进行重排序优化。这意味着程序代码中内存访问的逻辑顺序,可能与实际硬件执行时的物理顺序不一致。当CPU和DMA控制器同时访问同一块内存区域时,这些优化措施就可能引发一系列数据一致性问题:
- 乱序执行问题: CPU可能会重排内存操作,例如CPU先写数据到缓冲区,再写一个“启动DMA”的寄存器。如果没有屏障,CPU可能先写入“启动DMA”寄存器,而缓冲区数据尚未完全写入主内存,导致DMA读取到旧数据。
- 缓存一致性问题: CPU拥有本地缓存,数据可能存在于CPU缓存中而非主内存。DMA控制器通常直接访问主内存。如果CPU修改了缓存中的数据但尚未写回主内存,DMA控制器可能读取到过时的数据。反之,如果DMA控制器写入了主内存,CPU的缓存中可能仍存有旧数据,导致CPU读取到陈旧信息。
- 多主体访问内存: 在多核处理器和多设备系统中,多个主体(CPU核心、DMA控制器)并发访问共享内存,需要一种机制来保证它们对内存有一致性的视角,防止数据竞争和错误。
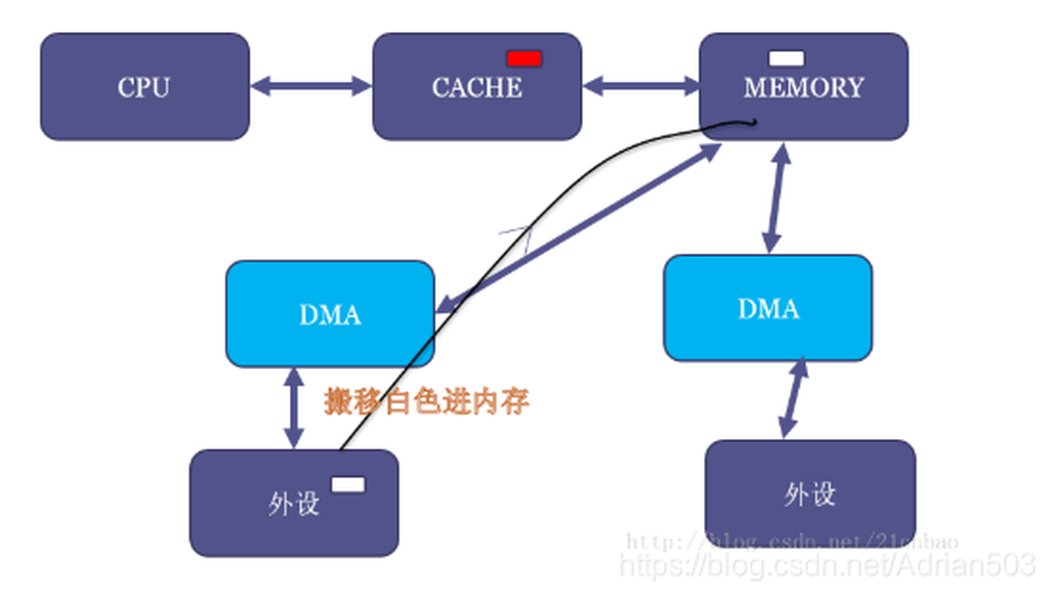
图2: DMA与CPU缓存一致性挑战。DMA直接访问主内存,而CPU通过缓存访问,可能导致数据视图不一致。
DMA Barrier正是为了解决这些挑战而生,它确保了CPU和DMA控制器之间对内存访问的顺序性和可见性,从而保障了数据传输的正确性和系统的稳定性。
DMA Barrier的实现原理:软硬件协同的精妙
DMA Barrier的实现原理是硬件指令、编译器优化阻止以及操作系统API的协同作用。它确保在关键时刻,内存操作按照预期的顺序完成并对所有相关的硬件单元可见。
硬件层面的核心指令
在不同的处理器架构中,实现内存屏障的硬件指令有所不同。以ARM架构为例,常用的指令包括:
- DMB (Data Memory Barrier): 数据内存屏障,确保在DMB指令之前的内存访问操作(特别是写操作)对其他设备可见,并且在DMB之后的内存访问操作开始之前完成。这是DMA屏障中最核心的指令之一,常用于确保CPU写完数据后,DMA设备才能启动传输。
- DSB (Data Synchronization Barrier): 数据同步屏障,比DMB更严格。它确保所有之前的内存访问和指令都已完成,并且所有的缓存、写缓冲都被清空或刷新。DSB在某些情况下用于更强的同步,例如在DMA传输结束后的清理操作。
- ISB (Instruction Synchronization Barrier): 指令同步屏障,主要用于刷新指令流水线,确保在ISB之后的指令能够看到ISB之前的所有内存修改。在DMA场景中较少直接使用,但对于指令流的同步至关重要。
这些硬件指令通过控制CPU的流水线、缓存行为以及与内存控制器的交互,来强制内存操作的顺序。例如,DMB指令可以确保CPU缓存中的数据在指定点刷新到主内存,并阻止CPU乱序执行,从而保证DMA设备访问内存时能看到最新数据。
图3: DMA数据传输路径与内存屏障的潜在位置。
软件层面的抽象与应用
在操作系统层面(如Linux内核),DMA Barrier通常通过封装好的API函数来提供,这些函数内部会结合硬件指令和必要的缓存操作。常见的DMA屏障类型包括:
- 写内存屏障 (Write Memory Barrier -
wmb()/dma_wmb()): 确保在屏障之前CPU对内存的所有写入操作都已经完成并写入到主内存中。这对于CPU设置DMA描述符(包含数据地址和长度)后,在启动DMA传输之前至关重要,防止DMA控制器获取到过时或不完整的数据。 - 读内存屏障 (Read Memory Barrier -
rmb()/dma_rmb()): 确保在屏障之后CPU读取内存时,能够读取到DMA控制器写入的最新数据。这意味着CPU会刷新或无效化其缓存中对应的内存区域,从主内存中获取数据,而不是从可能包含旧数据的缓存中读取。 - 双向内存屏障 (Memory Barrier -
mb()): 结合了读写屏障的功能,确保屏障前所有读写操作在屏障后所有读写操作之前完成。 - 编译器屏障 (
barrier()): 这是一个软件层面的屏障,它告诉编译器不要将屏障之后的内存访问重排到屏障之前,也不要将屏障之前的内存访问重排到屏障之后。它只影响编译器优化,不直接影响硬件层的内存顺序。
在Linux内核中,DMA操作通常会使用特定的API来确保数据一致性,例如dma_map_single()、dma_unmap_single()、dma_sync_single_for_cpu()和dma_sync_single_for_device()。这些API在底层会根据硬件架构自动插入适当的内存屏障和缓存同步操作,从而为设备驱动开发者提供一个更高级、更安全的抽象接口。
缓存一致性的处理
对于带有CPU缓存的系统,DMA Barrier的实现还需要考虑缓存一致性。这通常涉及:
- 缓存刷新 (Cache Flush): 在DMA读取CPU写入的数据之前,CPU必须将其缓存中“脏”的数据(已修改但未写回主内存的数据)刷新到主内存,以确保DMA能够看到最新的数据。
- 缓存失效 (Cache Invalidate): 在CPU读取DMA写入的数据之后,CPU必须使其缓存中对应的内存区域失效,强制CPU从主内存重新加载数据,而不是读取可能包含旧数据的缓存。
DMA Barrier 工作流程与应用场景
DMA Barrier的典型工作流程可以概括为以下步骤,以一个设备驱动程序通过DMA传输数据为例:
- CPU准备数据: 设备驱动程序将要传输的数据写入内存中的一个缓冲区。
- 插入写屏障: 在写入数据完成后,CPU插入一个写内存屏障(如
dma_wmb())。这个屏障确保所有缓冲区数据的写入操作都已完成,并且数据已对外部可见(即已刷新到主内存或可被DMA访问)。 - CPU配置DMA: CPU将DMA传输所需的参数(如缓冲区地址、数据长度、传输方向等)写入DMA控制器或DMA描述符寄存器。
- 启动DMA: CPU通过写入某个寄存器(如“doorbell”寄存器)来启动DMA传输。由于写屏障的存在,CPU确保了DMA描述符在启动前也已写入。
- DMA传输数据: DMA控制器独立地将数据从源地址搬运到目标地址。
- DMA完成通知: DMA传输完成后,DMA控制器通常会通过中断通知CPU。
- 插入读屏障: CPU响应中断后,如果需要读取DMA传输过来的数据或状态,会插入一个读内存屏障(如
dma_rmb())。这个屏障确保CPU的缓存失效,从而读取到DMA写入的最新数据或状态。 - CPU处理数据: CPU从内存中读取DMA传输后的数据进行处理。
这种流程有效地避免了DMA控制器读取到不完整或过时的CPU写入数据,也防止了CPU读取到DMA写入后但仍存在于旧缓存中的数据。
实际应用场景:
DMA Barrier在许多场景中都扮演着关键角色:
- 设备驱动开发: 在各种外设驱动程序(如网卡、图形处理器、存储控制器)中,当CPU与DMA硬件交互时,DMA Barrier是确保数据流正确和系统稳定的必要手段。
- 多核系统: 在多核处理器系统中,不同核心之间通过共享内存进行通信或数据交换时,DMA Barrier有助于维护缓存一致性和内存访问顺序。
- DMA描述符更新: 当CPU更新DMA描述符(数据结构,告诉DMA控制器如何传输数据)并准备启动DMA传输时,需要使用写屏障来确保描述符的所有字段都已写入内存。
- DMA数据读取: 当DMA传输完成后,CPU需要从内存读取DMA传输过来的数据时,需要使用读屏障来确保CPU读取到的是DMA写入的最新数据。
图4: DMA Barrier能力雷达图。该图展示了DMA Barrier在不同维度下的能力评估,如数据一致性、性能影响、实现复杂度和跨平台兼容性,以直观的方式展现其综合特性。
DMA Barrier的性能影响是一个需要权衡的因素。虽然它保障了数据一致性,但每次屏障操作都会带来一定的性能开销,因为它可能涉及CPU流水线的停顿或缓存的刷新。因此,在实际开发中,需要根据具体需求和硬件特性,在数据一致性和性能之间找到最佳平衡点。
DMA Barrier 知识结构概览
为了更好地理解DMA Barrier的各个组成部分及其相互关系,下面通过一个思维导图对其知识结构进行总结。
图5: DMA Barrier知识结构思维导图。此图概述了DMA Barrier的定义、必要性、实现原理和应用场景,展现了其概念的层次性。
DMA Barrier关键概念对比
为了更好地理解DMA Barrier在整个内存同步机制中的位置,下表对比了几个相关的关键概念:
| 概念 | 作用 | 主要针对问题 | 实现层面 | 典型指令/API |
|---|---|---|---|---|
| DMA | 实现外部设备与内存直接数据传输,解放CPU | CPU占用高 | 硬件(DMA控制器) | N/A |
| 内存屏障 (通用) | 强制CPU/编译器遵守内存操作顺序 | 乱序执行,缓存一致性(广义) | 硬件指令,编译器指令,OS API | mb(), wmb(), rmb() |
| DMA Barrier | 专门协调CPU与DMA之间内存操作的顺序与可见性 | CPU-DMA数据不一致,乱序访问 | 硬件指令 (DMB, DSB),OS DMA API | dma_wmb(), dma_rmb(), dma_sync_single_for_device() |
| 缓存一致性协议 | 多处理器/多核心环境下,确保所有缓存和主内存中的数据副本保持一致 | 多核/多缓存环境下的数据不一致 | 硬件(如MESI协议) | N/A (底层硬件自动维护) |
表1: DMA Barrier与其他内存同步机制的对比。该表突出显示了DMA Barrier的特定定位和作用,将其与更通用的内存屏障及底层硬件机制区分开来。
常见问题解答 (FAQ)
DMA Barrier会影响系统性能吗?
DMA Barrier和通用的内存屏障有什么区别?
在Linux内核中,如何使用DMA Barrier?
dma_map_single()、dma_unmap_single()、dma_sync_single_for_cpu()和dma_sync_single_for_device()。这些API会在底层自动处理必要的内存屏障和缓存同步操作,从而简化了设备驱动程序的开发,并确保了跨架构的兼容性。DMA Barrier能否解决所有缓存一致性问题?
结论
DMA Barrier是现代计算机系统中确保CPU与DMA控制器之间数据一致性和顺序性的关键机制。通过结合硬件内存屏障指令、缓存管理操作以及操作系统层面的抽象API,它有效地解决了乱序执行和缓存不一致性带来的挑战。正确理解和使用DMA Barrier对于开发稳定、高效的设备驱动程序和构建可靠的多核系统至关重要。虽然它会带来一定的性能开销,但在保障数据完整性和系统行为可预测性方面,其价值无可替代。
推荐阅读
- 内存屏障在多核系统中的作用有哪些?
- Linux内核DMA框架如何实现高效数据传输?
- CPU缓存一致性协议MESI的工作原理是什么?
- Direct Memory Access (DMA) 在嵌入式系统中的编程实践是怎样的?