
Odkryj Najszybsze Połączenia Lokalne z LM Studio: Poza Ograniczeniami HTTP
Maksymalizuj responsywność aplikacji, integrując LM Studio lokalnie za pomocą najbardziej wydajnych metod komunikacji międzyprocesowej.
Najważniejsze Informacje
- Najwyższa Wydajność: Metody oparte na pamięci współdzielonej (Shared Memory) oferują najniższe opóźnienia, eliminując narzut sieciowy.
- Standard LM Studio: Domyślnie LM Studio udostępnia API zgodne z OpenAI przez HTTP/TCP/IP na localhost, co jest najłatwiejsze w implementacji, ale może wprowadzać opóźnienia.
- Praktyczne Alternatywy: Gniazda domeny Unix (Unix Domain Sockets) oraz dedykowane biblioteki Pythona (np.
lmstudio-python) oferują kompromis między wydajnością a złożonością implementacji dla komunikacji lokalnej.
Wprowadzenie: Potrzeba Szybszej Komunikacji Lokalnej
LM Studio zrewolucjonizowało sposób, w jaki możemy uruchamiać duże modele językowe (LLM) na lokalnych maszynach. Standardowo udostępnia ono serwer API zgodny z interfejsem OpenAI, działający na porcie lokalnym (np. 1234) i komunikujący się przez protokół HTTP. Chociaż jest to wygodne i szeroko kompatybilne, protokół HTTP, nawet w komunikacji lokalnej (localhost), wprowadza pewien narzut i opóźnienia związane z nagłówkami, zarządzaniem połączeniem i serializacją/deserializacją danych.
Dla aplikacji wymagających maksymalnej responsywności – na przykład interaktywnych agentów AI, narzędzi do edycji w czasie rzeczywistym czy systemów sterowania (jak potencjalnie MCP - Model Context Protocol w zastosowaniach wymagających niskich opóźnień) – opóźnienia te mogą być nieakceptowalne. Celem jest znalezienie metod komunikacji międzyprocesowej (IPC - Inter-Process Communication), które minimalizują lub eliminują ten narzut, zapewniając niemal natychmiastową wymianę danych między LM Studio a inną lokalną aplikacją.
Przegląd Metod Łączenia Lokalnego z LM Studio
Poniżej przedstawiamy przegląd różnych metod łączenia się z LM Studio lokalnie, od standardowej metody HTTP po bardziej zaawansowane i wydajne techniki IPC.
1. API HTTP/TCP/IP (Metoda Domyślna)
Opis
LM Studio uruchamia serwer na localhost (domyślnie port 1234), który naśladuje API OpenAI. Aplikacje klienckie wysyłają standardowe żądania HTTP (np. POST z danymi JSON) do odpowiednich endpointów (np. /v1/chat/completions).
Wydajność i Responsywność
Najłatwiejsza w implementacji, ale najmniej responsywna z powodu narzutu protokołu HTTP. Opóźnienia, choć minimalne na localhost, mogą być zauważalne przy dużej liczbie zapytań lub w aplikacjach krytycznych czasowo.
Zalety
- Prosta konfiguracja i użycie.
- Szeroka kompatybilność z bibliotekami HTTP w różnych językach (Python
requests,openaiSDK itp.). - Oficjalnie wspierana przez LM Studio.
Wady
- Wprowadza opóźnienia związane z HTTP.
- Nie spełnia kryterium unikania "czekania na HTTP".
2. Komunikacja Oparta na Gniazdach (Sockets)
Bezpośrednie użycie gniazd sieciowych lub domenowych może zredukować narzut w porównaniu do pełnego stosu HTTP.
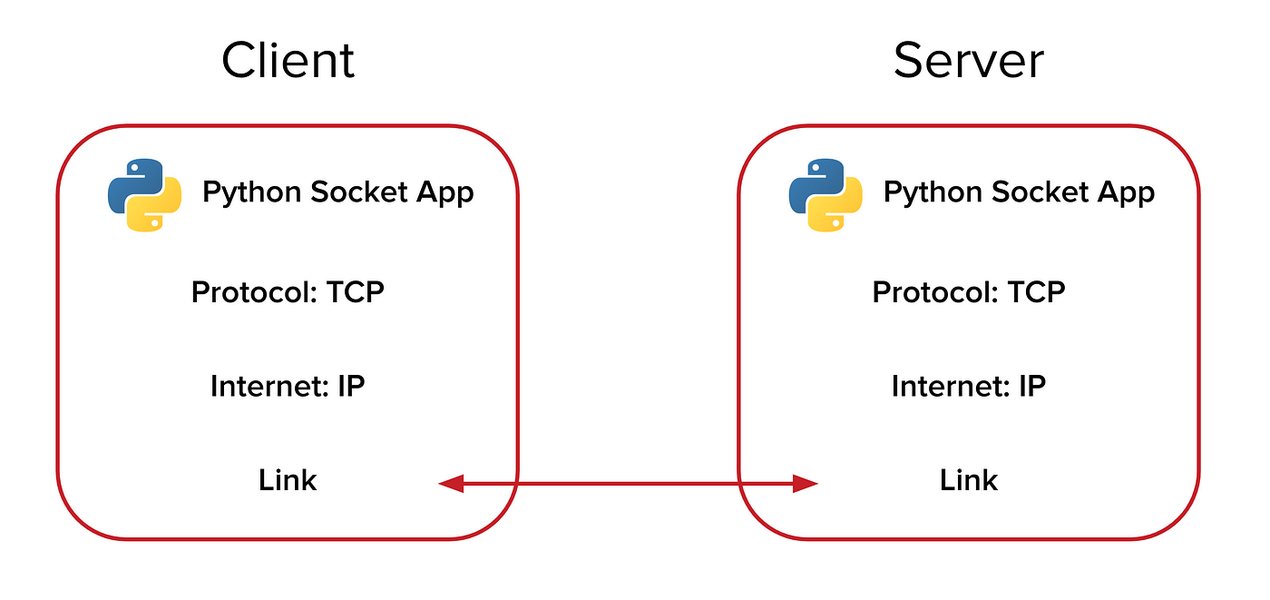
Diagram ilustrujący podstawową komunikację klient-serwer za pomocą gniazd (Sockets).
Surowe Gniazda TCP/IP (localhost)
Możliwość komunikacji bezpośrednio przez gniazda TCP na adresie 127.0.0.1 i porcie LM Studio, wysyłając dane w formacie oczekiwanym przez API (np. ręcznie tworząc nagłówki i ciało żądania HTTP). Jest to bardziej złożone niż użycie bibliotek HTTP i potencjalny zysk wydajności może być niewielki, ponieważ biblioteki HTTP są często zoptymalizowane.
Gniazda Domeny Unix (Unix Domain Sockets)
Dostępne tylko w systemach Unix-podobnych (Linux, macOS). Oferują znacznie szybszą komunikację lokalną niż gniazda TCP/IP, ponieważ omijają stos sieciowy systemu operacyjnego. Idealne do szybkiej komunikacji między procesami na tej samej maszynie.
Wydajność i Responsywność
Wyższa niż HTTP, szczególnie w przypadku gniazd domeny Unix. Narzut jest mniejszy, co prowadzi do niższych opóźnień.
Integracja z LM Studio
Wymaga stworzenia pośrednika (proxy), który odbiera dane przez gniazdo (np. Unix) i przekazuje je do API HTTP LM Studio, lub niestandardowej implementacji, jeśli LM Studio w przyszłości udostępni taką możliwość.
3. Pamięć Współdzielona (Shared Memory)
Opis
Jedna z najszybszych metod IPC. Procesy uzyskują bezpośredni dostęp do tego samego regionu pamięci fizycznej, co eliminuje potrzebę kopiowania danych i komunikacji sieciowej. W Pythonie można to zaimplementować za pomocą modułu multiprocessing.shared_memory lub bibliotek wykorzystujących pamięć mapowaną do plików (mmap).
Wydajność i Responsywność
Najwyższa możliwa responsywność i przepustowość dla komunikacji lokalnej. Opóźnienia są minimalne, ograniczone jedynie szybkością dostępu do pamięci.
Integracja z LM Studio
Najbardziej złożona w implementacji. Wymaga mechanizmów synchronizacji (np. semaforów, blokad), aby uniknąć konfliktów zapisu/odczytu. Bezpośrednia integracja wymagałaby niestandardowego oprogramowania pośredniczącego lub modyfikacji LM Studio (co jest niemożliwe dla użytkowników). Można stworzyć system, gdzie aplikacja zapisuje prompt w pamięci współdzielonej, proces pośredniczący odczytuje go, wysyła do API HTTP LM Studio, a odpowiedź umieszcza z powrotem w pamięci współdzielonej.
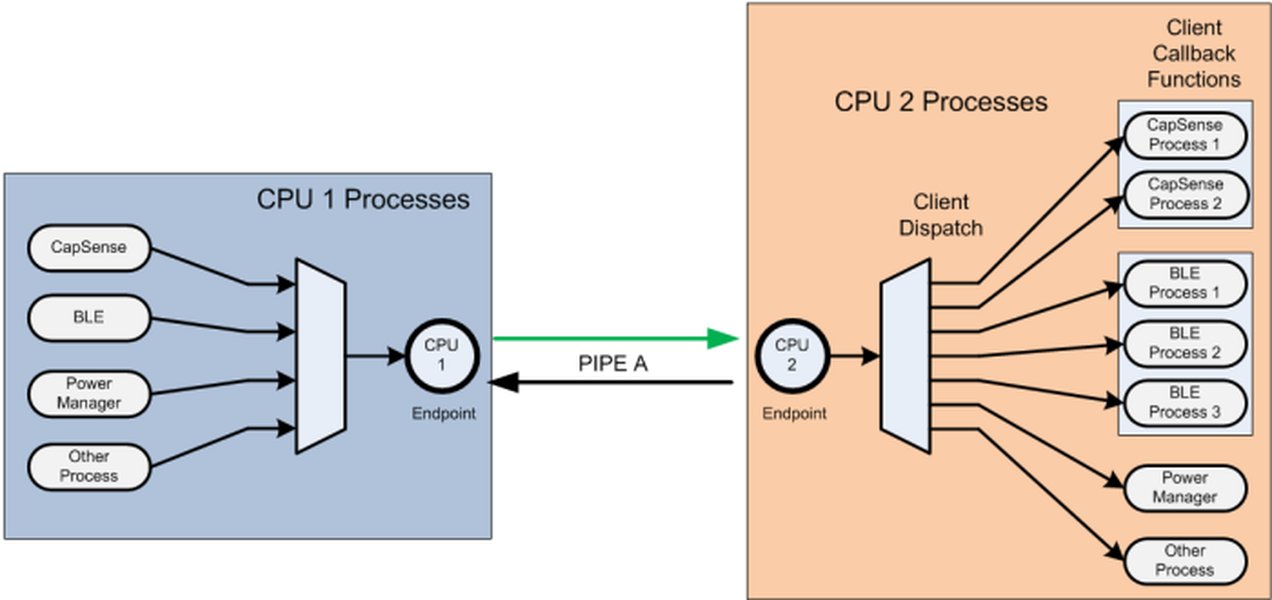
Uproszczony diagram ilustrujący koncepcję komunikacji międzyprocesowej (IPC).
4. Nazwane Potoki (Named Pipes)
Opis
Mechanizm IPC dostępny głównie w systemach Unix-podobnych (podobny do plików specjalnych FIFO). Umożliwiają komunikację jednokierunkową między procesami poprzez zapis i odczyt do/z potoku jak ze zwykłego pliku. Na Windows istnieją podobne mechanizmy.
Wydajność i Responsywność
Szybsze niż TCP/IP na localhost, ale zazwyczaj wolniejsze niż gniazda domeny Unix czy pamięć współdzielona. Prostsze w użyciu niż pamięć współdzielona.
Integracja z LM Studio
Podobnie jak gniazda, wymagałaby warstwy pośredniczącej lub niestandardowej implementacji po stronie LM Studio.
5. Python SDK (lmstudio-python)
Opis
Jeśli LM Studio oferuje oficjalne lub nieoficjalne SDK dla Pythona (jak wspomniane w jednym z źródeł lmstudio-python), które pozwala na bezpośrednie ładowanie i interakcję z modelami w pamięci w ramach tego samego procesu Pythona co aplikacja kliencka, jest to bardzo wydajna metoda.
Wydajność i Responsywność
Potencjalnie bardzo wysoka, bliska pamięci współdzielonej, ponieważ komunikacja odbywa się wewnątrz jednego procesu (in-process), omijając serializację i komunikację sieciową/IPC.
Integracja z LM Studio
Zależy od dostępności i funkcjonalności takiego SDK. Jeśli istnieje, może być jednym z najlepszych rozwiązań dla aplikacji Pythonowych.
6. Model Context Protocol (MCP)
Opis
MCP to protokół zaprojektowany do integracji modeli AI z różnymi narzędziami, umożliwiający efektywne zarządzanie kontekstem i zasobami. Sam protokół nie definiuje mechanizmu transportowego - często jest implementowany nad HTTP.
Wydajność i Responsywność
Jeśli MCP jest używane nad standardowym HTTP, dziedziczy jego opóźnienia. Jednakże, serwer MCP *można* zaimplementować tak, aby komunikował się z LM Studio (lub innym backendem LLM) za pomocą szybszych metod IPC (np. pamięci współdzielonej, gniazd domeny Unix) lub aby sam działał na tych szybszych mechanizmach transportowych zamiast HTTP. Wydajność zależy więc od konkretnej implementacji serwera MCP i jego integracji z LM Studio.
Integracja z LM Studio
Wymaga uruchomienia serwera MCP, który pośredniczy w komunikacji. Aby uzyskać maksymalną responsywność, serwer ten musiałby być zoptymalizowany pod kątem użycia szybkiego IPC do komunikacji z LM Studio (co wymagałoby niestandardowego rozwiązania) lub do komunikacji z klientem MCP.
Porównanie Wydajności Metod Połączeń
Poniższy wykres radarowy przedstawia subiektywną ocenę różnych metod połączeń lokalnych z LM Studio pod kątem kilku kluczowych kryteriów. Wyższe wartości oznaczają lepszy wynik w danej kategorii (np. wyższa responsywność, łatwiejsza implementacja).
Jak widać, istnieje wyraźny kompromis między wydajnością (responsywnością) a złożonością implementacji i natywnym wsparciem ze strony LM Studio. Pamięć współdzielona oferuje najwyższą prędkość, ale jest najtrudniejsza do wdrożenia i zarządzania. Standardowe API HTTP jest najłatwiejsze, ale najwolniejsze.
Wizualizacja Strategii Połączeń
Poniższa mapa myśli przedstawia różne ścieżki integracji LM Studio z lokalnymi aplikacjami, podkreślając kluczowe cechy każdej metody.
Mapa myśli ilustruje, że wybór metody zależy od priorytetów projektu – czy kluczowa jest absolutna minimalizacja opóźnień, czy może łatwość wdrożenia i kompatybilność.
Przykłady Implementacji (Python i MCP)
Przykłady w Pythonie
Poniżej znajdują się przykładowe fragmenty kodu ilustrujące różne podejścia do łączenia się z LM Studio za pomocą Pythona.
1. Użycie biblioteki openai (Standardowe API HTTP)
Najprostsza i oficjalnie zalecana metoda, wykorzystująca API HTTP LM Studio.
from openai import OpenAI

# Skonfiguruj klienta OpenAI, aby wskazywał na lokalny serwer LM Studio
client = OpenAI(
    base_url="http://localhost:1234/v1", # Upewnij się, że port jest poprawny
    api_key="not-needed" # Klucz API zazwyczaj nie jest wymagany
)

try:
    completion = client.chat.completions.create(
        model="nazwa_twojego_modelu", # Zmień na nazwę załadowanego modelu
        messages=[
            {"role": "system", "content": "Jesteś pomocnym asystentem."},
            {"role": "user", "content": "Jak działa komunikacja przez API HTTP?"}
        ],
        max_tokens=100,
        stream=False # Ustawienie stream=True może poprawić odczuwalną responsywność
    )
    print(completion.choices[0].message.content)

except Exception as e:
    print(f"Błąd połączenia z LM Studio: {e}")
    print("Sprawdź, czy LM Studio jest uruchomione, model załadowany, a serwer API włączony.")
2. Użycie Pamięci Współdzielonej (multiprocessing.shared_memory)
Przykład koncepcyjny pokazujący wymianę danych przez pamięć współdzieloną. Wymaga dodatkowej logiki do komunikacji z API LM Studio (np. procesu pośredniczącego).
import multiprocessing as mp
from multiprocessing.shared_memory import SharedMemory
import time
import numpy as np # Przykład użycia NumPy

# Załóżmy, że inny proces (np. pośrednik) nasłuchuje zmian w tej pamięci
# i komunikuje się z LM Studio API, a wynik zapisuje z powrotem.

def client_process(shm_name_req, shm_name_resp):
    try:
        # Dostęp do pamięci współdzielonej dla zapytań
        existing_shm_req = SharedMemory(name=shm_name_req)
        # Mapowanie jako bufor NumPy (zakładając strukturę, np. na string)
        # W praktyce wymaga bardziej złożonego kodowania/dekodowania
        prompt_buffer = np.ndarray((1024,), dtype=np.byte, buffer=existing_shm_req.buf)

        # Zapisanie promptu (przykład uproszczony)
        prompt = "Opowiedz o pamięci współdzielonej."
        prompt_bytes = prompt.encode('utf-8')
        prompt_buffer[:len(prompt_bytes)] = np.frombuffer(prompt_bytes, dtype=np.byte)
        prompt_buffer[len(prompt_bytes)] = 0 # Znak końca stringa

        print(f"Klient: Wysłał prompt: '{prompt}'")
        # Tutaj proces pośredniczący powinien odczytać prompt i wysłać do LM Studio

        # Oczekiwanie na odpowiedź w innej pamięci współdzielonej
        print("Klient: Oczekiwanie na odpowiedź...")
        existing_shm_resp = SharedMemory(name=shm_name_resp)
        response_buffer = np.ndarray((4096,), dtype=np.byte, buffer=existing_shm_resp.buf)

        # Odczekaj na odpowiedź (w realnym systemie użyj semaforów/eventów)
        time.sleep(5) # Symulacja oczekiwania

        # Odczytanie odpowiedzi
        # Znajdź koniec stringa (null terminator)
        try:
             end_index = np.where(response_buffer == 0)[0][0]
             response = response_buffer[:end_index].tobytes().decode('utf-8')
             print(f"Klient: Odebrał odpowiedź: '{response[:100]}...'")
        except IndexError:
             print("Klient: Nie znaleziono odpowiedzi w pamięci współdzielonej.")


        existing_shm_req.close()
        existing_shm_resp.close()

    except FileNotFoundError:
        print("Klient: Nie znaleziono pamięci współdzielonej. Uruchom najpierw serwer/pośrednika.")
    except Exception as e:
        print(f"Klient: Wystąpił błąd: {e}")

if __name__ == "__main__":
    # W głównym procesie (lub procesie pośredniczącym) trzeba najpierw utworzyć pamięć
    try:
        # Pamięć na zapytania
        shm_req = SharedMemory(name='lm_studio_request', create=True, size=1024)
        # Pamięć na odpowiedzi
        shm_resp = SharedMemory(name='lm_studio_response', create=True, size=4096)

        print("Serwer/Pośrednik: Utworzono pamięć współdzieloną.")
        # Tutaj powinien działać proces pośredniczący, który czyta z shm_req,
        # wysyła do LM Studio API HTTP, odbiera odpowiedź i zapisuje do shm_resp.

        # Uruchomienie procesu klienta
        client = mp.Process(target=client_process, args=('lm_studio_request', 'lm_studio_response'))
        client.start()
        client.join()

    finally:
        # Posprzątanie pamięci współdzielonej
        print("Serwer/Pośrednik: Sprzątanie pamięci współdzielonej.")
        try:
            shm_req.close()
            shm_req.unlink()
        except NameError: pass
        except FileNotFoundError: pass
        try:
            shm_resp.close()
            shm_resp.unlink()
        except NameError: pass
        except FileNotFoundError: pass
Uwaga: Powyższy kod jest uproszczonym przykładem koncepcyjnym. Pełna implementacja wymagałaby solidnej obsługi kodowania/dekodowania danych, synchronizacji między procesami (np. za pomocą multiprocessing.Lock lub multiprocessing.Event) oraz procesu pośredniczącego, który faktycznie komunikuje się z API HTTP LM Studio.
3. Użycie Gniazd Domeny Unix (Tylko Linux/macOS)
Przykład serwera i klienta komunikujących się przez gniazdo domeny Unix. Serwer mógłby pełnić rolę proxy do LM Studio.
import socket
import os
import threading
import time
import requests # Do komunikacji z LM Studio API przez proxy

SOCKET_PATH = "/tmp/lmstudio_proxy.sock"
LM_STUDIO_API_URL = "http://localhost:1234/v1/chat/completions" # URL API LM Studio

# Funkcja serwera proxy
def unix_socket_proxy_server():
    if os.path.exists(SOCKET_PATH):
        os.remove(SOCKET_PATH)

    server = socket.socket(socket.AF_UNIX, socket.SOCK_STREAM)
    server.bind(SOCKET_PATH)
    server.listen(1)
    print(f"Serwer proxy nasłuchuje na {SOCKET_PATH}")

    while True:
        try:
            conn, addr = server.accept()
            print("Proxy: Połączono z klientem")
            # Odbierz dane (np. prompt w JSON)
            data = conn.recv(4096)
            if not data:
                conn.close()
                continue

            prompt_json = data.decode('utf-8')
            print(f"Proxy: Odebrano dane: {prompt_json[:100]}...")

            # Przekaż zapytanie do LM Studio API HTTP
            try:
                headers = {'Content-Type': 'application/json'}
                # Uwaga: Ten przykład zakłada, że klient wysyła pełny JSON zgodny z API OpenAI
                response = requests.post(LM_STUDIO_API_URL, data=prompt_json.encode('utf-8'), headers=headers)
                response.raise_for_status() # Sprawdź błędy HTTP
                api_response = response.text
                print("Proxy: Otrzymano odpowiedź z LM Studio.")
                conn.sendall(api_response.encode('utf-8'))
            except requests.exceptions.RequestException as e:
                print(f"Proxy: Błąd komunikacji z LM Studio API: {e}")
                conn.sendall(f"Błąd API: {e}".encode('utf-8'))
            except Exception as e:
                print(f"Proxy: Inny błąd: {e}")
                conn.sendall(f"Błąd serwera proxy: {e}".encode('utf-8'))

            conn.close()
            print("Proxy: Zamknięto połączenie z klientem.")

        except KeyboardInterrupt:
            print("Proxy: Zamykanie serwera...")
            break
        except Exception as e:
            print(f"Proxy: Błąd serwera: {e}")
            # W razie błędu, próbuj kontynuować nasłuchiwanie
            time.sleep(1)


    server.close()
    if os.path.exists(SOCKET_PATH):
        os.remove(SOCKET_PATH)
    print("Proxy: Serwer zamknięty.")


# Funkcja klienta
def unix_socket_client():
    time.sleep(1) # Daj serwerowi chwilę na start
    client = socket.socket(socket.AF_UNIX, socket.SOCK_STREAM)
    try:
        client.connect(SOCKET_PATH)
        # Przygotuj zapytanie JSON zgodne z API OpenAI
        request_payload = {
            "model": "nazwa_twojego_modelu",
            "messages": [{"role": "user", "content": "Jak działają gniazda domeny Unix?"}],
            "max_tokens": 50
        }
        import json
        client.sendall(json.dumps(request_payload).encode('utf-8'))
        print("Klient: Wysłał zapytanie.")

        response_data = client.recv(8192) # Odbierz większy bufor
        print(f"Klient: Odebrano odpowiedź:\n{response_data.decode('utf-8', errors='ignore')}")

    except FileNotFoundError:
        print("Klient: Nie można połączyć. Serwer proxy nie działa?")
    except Exception as e:
        print(f"Klient: Wystąpił błąd: {e}")
    finally:
        client.close()

if __name__ == "__main__":
    # Uruchom serwer proxy w osobnym wątku
    server_thread = threading.Thread(target=unix_socket_proxy_server, daemon=True)
    server_thread.start()

    # Uruchom klienta
    unix_socket_client()

    # Poczekaj na zakończenie serwera (np. przez Ctrl+C w konsoli serwera)
    # W tym przykładzie główny wątek zakończy się po kliencie,
    # ale serwer działa dalej w tle jako daemon.
    # Dla poprawnego zamknięcia można dodać obsługę sygnałów.
    # server_thread.join() # Odkomentuj, jeśli chcesz czekać na serwer
    print("Główny wątek zakończony.")
4. Użycie SDK lmstudio-python (jeśli dostępne)
Przykład oparty na informacji z jednego ze źródeł, zakładający istnienie takiego SDK.
# Ten kod jest koncepcyjny i zakłada istnienie biblioteki 'lmstudio'
try:
    import lmstudio as lms

    # Załaduj model, który jest aktywny w LM Studio GUI lub skonfigurowany
    # Zakładamy, że SDK potrafi połączyć się z działającą instancją LM Studio
    # lub zarządzać modelami bezpośrednio.
    print("Ładowanie modelu przez SDK...")
    # Sposób inicjalizacji może się różnić w zależności od rzeczywistego SDK
    llm = lms.get_active_llm()
    # Lub: llm = lms.LLM(model_identifier="nazwa/modelu")

    print("Model załadowany. Generowanie odpowiedzi...")
    prompt = "Wyjaśnij działanie Python SDK dla LM Studio."
    # Przykład użycia streamingu dla lepszej responsywności
    response_stream = llm.respond_stream(prompt)

    print("Odpowiedź:")
    full_response = ""
    for chunk in response_stream:
        print(chunk, end="", flush=True)
        full_response += chunk
    print("\n--- Koniec odpowiedzi ---")

except ImportError:
    print("Błąd: Biblioteka 'lmstudio' nie jest zainstalowana lub dostępna.")
    print("Sprawdź, czy istnieje oficjalne lub społecznościowe SDK i jak je zainstalować.")
except Exception as e:
    print(f"Wystąpił błąd podczas używania SDK: {e}")
Przykłady dla MCP (Model Context Protocol)
MCP to protokół, a nie konkretna metoda transportu. Poniższy przykład pokazuje, jak można zbudować prosty serwer MCP w Pythonie, który mógłby używać szybkiego IPC do komunikacji z LM Studio (choieważ standardowo używa HTTP).
Aby uzyskać maksymalną responsywność z MCP, należałoby:
- Zbudować serwer MCP, który komunikuje się z klientami MCP (np. przez WebSockets lub Unix Sockets zamiast HTTP).
- Wewnątrz handlera zapytań serwera MCP, zamiast wywoływać API HTTP LM Studio, użyć jednej z szybkich metod IPC (np. pamięci współdzielonej) do wysłania promptu do procesu pośredniczącego LM Studio i odebrania odpowiedzi.
Poniżej bardzo uproszczony przykład serwera MCP używającego biblioteki mcp (zakładając jej istnienie i podstawową funkcjonalność), który w handlerze symuluje szybką odpowiedź (w rzeczywistości musiałby tutaj użyć IPC do komunikacji z LM Studio).
# Przykład koncepcyjny serwera MCP
# Wymaga zainstalowania potencjalnej biblioteki 'mcp' lub napisania własnej implementacji protokołu.

try:
    # Załóżmy istnienie biblioteki do tworzenia serwerów MCP
    from mcp import MCPServer, MCPContext

    # Funkcja obsługująca zapytania do serwera MCP
    def my_mcp_handler(context: MCPContext):
        """
        Ta funkcja jest wywoływana, gdy klient MCP wysyła zapytanie.
        'context' zawiera dane zapytania, np. prompt.
        """
        prompt = context.get_data().get("prompt", "Brak promptu")
        print(f"Serwer MCP: Otrzymano prompt: '{prompt}'")

        # === TUTAJ KLUCZOWA OPTYMALIZACJA ===
        # W tym miejscu, zamiast wywoływać LM Studio przez HTTP:
        # 1. Zapisz 'prompt' do pamięci współdzielonej / gniazda Unix / potoku.
        # 2. Powiadom proces pośredniczący (nasłuchujący na IPC), że są nowe dane.
        # 3. Poczekaj na odpowiedź od procesu pośredniczącego (również przez IPC).
        # 4. Odczytaj odpowiedź z IPC.

        # Symulacja szybkiej odpowiedzi uzyskanej przez IPC (zamiast realnej komunikacji)
        print("Serwer MCP: Symulowanie uzyskania odpowiedzi przez szybkie IPC...")
        time.sleep(0.05) # Bardzo małe opóźnienie symulujące IPC
        response_from_llm = f"Odpowiedź na '{prompt}' uzyskana błyskawicznie przez IPC!"

        print("Serwer MCP: Wysyłanie odpowiedzi do klienta MCP.")
        # Zwróć wynik do klienta MCP
        return {"response": response_from_llm}

    if __name__ == "__main__":
        # Utwórz i uruchom serwer MCP
        # Port i host mogą być inne; dla maksymalnej responsywności lokalnej
        # serwer mógłby nasłuchiwać na gnieździe Unix zamiast TCP.
        print("Uruchamianie serwera MCP...")
        # Sposób inicjalizacji serwera zależy od konkretnej biblioteki MCP
        # Poniżej przykład hipotetyczny:
        # server = MCPServer(host='localhost', port=12346, handler=my_mcp_handler)
        # server.serve_forever()

        # Symulacja działania serwera przez chwilę (ponieważ nie mamy realnej biblioteki)
        print("Serwer MCP (symulacja): Nasłuchiwanie na żądania...")
        # Wywołanie handlera dla testu
        class MockContext:
            def get_data(self):
                return {"prompt": "Testowy prompt dla MCP"}
        result = my_mcp_handler(MockContext())
        print(f"Serwer MCP (symulacja): Wynik handlera: {result}")

        print("Serwer MCP (symulacja): Zakończono.")

except ImportError:
    print("Błąd: Biblioteka 'mcp' nie jest dostępna.")
    print("Implementacja MCP wymaga znalezienia odpowiedniego pakietu lub stworzenia własnego.")
except Exception as e:
    print(f"Wystąpił błąd: {e}")
Podsumowując dla MCP: Aby osiągnąć maksymalną responsywność, należy unikać HTTP zarówno w komunikacji klient-serwer MCP, jak i serwer MCP-LM Studio, zastępując je szybkimi mechanizmami IPC. Wymaga to jednak znaczącego nakładu pracy programistycznej.
Praktyczne Rekomendacje i Podsumowanie Tabelaryczne
Wybór najlepszej metody zależy od konkretnych wymagań projektu:
- Dla maksymalnej prostoty: Użyj standardowego API HTTP LM Studio z biblioteką
openaiw Pythonie. - Dla wysokiej responsywności w Pythonie (jeśli SDK jest dostępne i działa in-process): Wypróbuj dedykowane SDK jak
lmstudio-python. - Dla wysokiej responsywności na Linux/macOS (z dodatkowym kodem): Rozważ proxy oparte na Gniazdach Domeny Unix.
- Dla absolutnie najwyższej responsywności (najbardziej złożone): Zaimplementuj rozwiązanie oparte na Pamięci Współdzielonej z procesem pośredniczącym.
Poniższa tabela podsumowuje kluczowe cechy omawianych metod:
| Metoda Połączenia | Szacowana Responsywność | Złożoność Implementacji | Natywne Wsparcie LM Studio | Platforma | Główne Zastosowanie / Uwagi |
|---|---|---|---|---|---|
| API HTTP (localhost) | Niska | Bardzo Niska | Tak (pełne) | Wszystkie | Standardowa, najprostsza metoda. Dobra na początek. |
| Gniazda Domeny Unix (z proxy) | Wysoka | Średnia | Nie (wymaga proxy) | Linux, macOS | Dobra wydajność lokalna na systemach Unix-like. |
| Pamięć Współdzielona (z pośrednikiem) | Bardzo Wysoka | Bardzo Wysoka | Nie (wymaga pośrednika i synchronizacji) | Wszystkie (zależnie od biblioteki) | Najszybsza metoda, ale wymaga zaawansowanego programowania. |
| Nazwane Potoki (z pośrednikiem) | Średnia/Wysoka | Średnia/Wysoka | Nie (wymaga pośrednika) | Głównie Unix-like | Alternatywa dla gniazd Unix, potencjalnie prostsza. |
| Python SDK (in-process) | Bardzo Wysoka | Niska/Średnia | Zależne od SDK | Zależne od SDK (głównie Python) | Idealne, jeśli aplikacja i model mogą działać w tym samym procesie Pythona. |
| MCP (backend IPC) | Wysoka/Bardzo Wysoka | Wysoka | Nie (wymaga serwera MCP i integracji IPC) | Wszystkie (zależnie od implementacji) | Elastyczny protokół, wydajność zależy od implementacji transportu i integracji z LM Studio. |
Wideo Tutorial: LM Studio jako Lokalny Serwer z Pythonem
Poniższe wideo demonstruje, jak skonfigurować LM Studio do działania jako lokalny serwer API i jak się z nim połączyć za pomocą Pythona, używając standardowej metody HTTP. Jest to dobry punkt wyjścia do zrozumienia podstawowej integracji, zanim zdecydujesz się na bardziej złożone metody IPC.
Tutorial pokazujący konfigurację serwera LM Studio i interakcję z nim przy użyciu Pythona (źródło: YouTube).
Często Zadawane Pytania (FAQ)
Jaka jest najłatwiejsza metoda połączenia z LM Studio lokalnie?
Najłatwiejszą metodą jest użycie wbudowanego serwera API HTTP LM Studio. Wystarczy uruchomić serwer w aplikacji LM Studio i wysyłać żądania HTTP (np. za pomocą biblioteki `requests` lub `openai` w Pythonie) na adres `http://localhost:1234/v1` (lub inny skonfigurowany port).
Czy pamięć współdzielona jest zawsze najlepszym wyborem dla wydajności?
Pamięć współdzielona oferuje teoretycznie najwyższą wydajność (najniższe opóźnienia) dla komunikacji międzyprocesowej na tej samej maszynie. Jednak jej implementacja jest znacznie bardziej złożona niż innych metod. Wymaga starannego zarządzania dostępem (synchronizacji), aby uniknąć problemów takich jak warunki wyścigu czy uszkodzenie danych. Dla wielu aplikacji zysk wydajności może nie być wart dodatkowej złożoności w porównaniu do np. gniazd domeny Unix lub dobrze zoptymalizowanego SDK.
Czy LM Studio natywnie wspiera szybsze metody IPC jak gniazda Unix czy pamięć współdzieloną?
Obecnie LM Studio oficjalnie udostępnia jedynie interfejs API oparty na HTTP/TCP/IP. Nie ma wbudowanego, natywnego wsparcia dla bezpośredniej komunikacji przez gniazda domeny Unix, pamięć współdzieloną czy nazwane potoki. Implementacja tych szybszych metod wymaga stworzenia dodatkowej warstwy oprogramowania (np. proxy lub procesu pośredniczącego), która będzie komunikować się z API HTTP LM Studio z jednej strony, a z drugą aplikacją za pomocą wybranej metody IPC.
Które metody działają na Windows, macOS i Linux?
- API HTTP / TCP Sockets (localhost): Działa na wszystkich platformach (Windows, macOS, Linux).
- Pamięć Współdzielona: Działa na wszystkich platformach, ale konkretna implementacja i dostępne biblioteki (np. `mmap`, `multiprocessing.shared_memory`) mogą mieć pewne różnice systemowe.
- Python SDK: Zależy od SDK, ale zazwyczaj powinno działać tam, gdzie działa Python i LM Studio.
- Gniazda Domeny Unix (Unix Domain Sockets): Działają tylko na systemach Unix-podobnych (Linux, macOS). Nie są dostępne na Windows w standardowej formie (choć istnieją pewne obejścia/emulacje).
- Nazwane Potoki (Named Pipes): Głównie mechanizm Unix-podobny (FIFO). Windows ma swój odpowiednik nazwanych potoków, ale działają one inaczej.
- MCP: Jako protokół jest niezależny od platformy, ale jego implementacja i użyty mechanizm transportowy (HTTP, WebSockets, IPC) mogą mieć ograniczenia platformowe.
Czym dokładnie jest MCP (Model Context Protocol) w tym kontekście?
Model Context Protocol (MCP) to protokół (zestaw reguł komunikacji) zaprojektowany w celu ułatwienia integracji między modelami sztucznej inteligencji (jak te w LM Studio) a różnymi narzędziami i aplikacjami klienckimi. Umożliwia on np. współdzielenie kontekstu, zarządzanie zasobami i efektywną wymianę danych. MCP samo w sobie nie jest mechanizmem transportowym (jak HTTP czy pamięć współdzielona), ale definiuje, *jak* dane powinny być strukturyzowane i wymieniane. Może być implementowany nad różnymi warstwami transportowymi. Aby uzyskać wysoką responsywność, implementacja MCP musiałaby wykorzystywać szybkie mechanizmy IPC zamiast standardowego HTTP.
Polecane Dalsze Kroki
- Jak zaimplementować proxy dla LM Studio używając gniazd domeny Unix w Pythonie?
- Porównanie wydajności pamięci współdzielonej i gniazd domeny Unix dla IPC w Pythonie.
- Czy istnieje oficjalne Python SDK dla LM Studio i jakie są jego możliwości?
- Przykłady użycia Model Context Protocol (MCP) do integracji z lokalnymi LLM.
Referencje
Last updated May 5, 2025