
解锁Elasticsearch的向量搜索潜力:深度解析与性能优化
全面掌握Elasticsearch作为高效向量数据库的核心技术与最佳实践
核心洞察
- Elasticsearch的向量能力日益强大: 随着
dense_vector数据类型和基于HNSW的kNN搜索(自Elasticsearch 7.3+版本引入并持续优化)的成熟,Elasticsearch已成为一个功能全面的向量数据库解决方案,能够高效处理大规模高维向量数据的存储和检索。 - 混合搜索是未来趋势: 将传统的关键词搜索(如倒排索引和BM25算法)与语义向量搜索相结合,可以提供更精准、更全面的搜索结果,满足复杂业务场景的需求。
- 性能优化是关键: 无论是服务器端的硬件配置、索引参数调整,还是客户端的查询设计、批量操作和参数微调(特别是
k和num_candidates),全面的调优策略对于实现毫秒级响应和高召回率至关重要。
向量数据库概念详解:连接数据与语义的桥梁
向量数据库是一种专门设计用于存储、管理和检索高维向量(Vector Embeddings)的数据库系统。这些向量是数据对象(如文本、图像、音频、视频等)的数值表示,通过机器学习模型(如深度神经网络)将原始数据转换为固定长度的浮点数数组。在向量空间中,语义上相似的数据点在空间中彼此靠近,而语义不相似的数据点则相距遥远。
什么是向量嵌入?
向量嵌入是将非结构化数据或半结构化数据转换为高维数值向量的过程。这个过程通常利用预训练的机器学习模型,如BERT、Sentence Transformers或OpenAI的text-embedding-3-small等。生成的向量能够捕捉原始数据的深层语义信息和上下文关系。
例如,一句“天气真好”和“阳光明媚,微风和煦”这两段文本,尽管词汇不同,但通过高质量的嵌入模型转换后,它们在向量空间中的距离会非常接近,因为它们表达了相似的语义。
向量的维度(dims)取决于所使用的嵌入模型,例如text-embedding-3-small模型可以生成1536维的向量。更高的维度可以表示更细致的语义信息,但也会增加存储和查询的计算开销。因此,选择合适的向量维度是性能与准确性之间的权衡。
传统数据库与向量数据库的区别
传统数据库(如关系型数据库或传统的搜索引擎)主要基于结构化数据进行精确匹配或关键词匹配。它们通过索引(如倒排索引)来加速基于文本关键词的搜索(例如TF/IDF或BM25算法)。
而向量数据库则专注于非结构化和半结构化数据,其核心在于通过计算向量之间的距离或角度来衡量语义相似度。这意味着即使没有精确的关键词匹配,也能找到与查询意图高度相关的结果。这种能力使其在语义搜索、推荐系统、多模态检索和RAG(Retrieval-Augmented Generation)等AI应用中发挥着不可替代的作用。
传统数据库与向量数据库在数据处理上的概念差异
向量搜索的核心技术:相似度度量与索引算法
向量数据库能够快速找到相似向量的关键在于以下两项核心技术:
相似度度量
- 余弦相似度 (Cosine Similarity): 这是最常用的相似度度量之一,通过计算两个向量夹角的余弦值来衡量它们的方向相似性。其值范围在-1到1之间,值越接近1表示向量方向越一致,语义越相似。Elasticsearch默认使用余弦相似度进行向量搜索。
- 欧几里得距离 (Euclidean Distance / L2 Norm): 衡量两个向量在多维空间中的直线距离。距离越小表示向量越相似。
- 点积 (Dot Product): 衡量两个向量方向和幅度的相似性。通常,为了避免负得分,会将点积结果加1.0。在某些情况下,点积与余弦相似度在向量归一化后是等价的。
向量索引算法:近似最近邻 (ANN) 搜索
对于大规模的向量数据集,进行精确的暴力搜索(Brute-Force Search)是不可行的,因为它需要计算查询向量与所有存储向量的相似度,时间复杂度为O(N),效率低下。因此,向量数据库普遍采用近似最近邻 (Approximate Nearest Neighbor, ANN) 搜索算法来加速查询,以牺牲少量精度换取显著的性能提升。
- HNSW (Hierarchical Navigable Small World) 算法: 这是Elasticsearch(以及Apache Lucene)用于实现高效ANN搜索的核心算法。HNSW构建了一个多层级的图结构,允许在不同层级上进行高效的导航搜索,从而快速找到近似的最近邻。它在搜索准确性和速度之间提供了良好的平衡。
- 精确蛮力搜索: 尽管不适合大规模数据集,但Elasticsearch也支持通过
script_score查询执行精确的蛮力搜索,用于小规模、高精度需求的场景。
Elasticsearch如何实现向量数据库功能
Elasticsearch自7.x版本开始引入并不断完善对向量搜索的支持,使其能够作为一个功能强大的向量数据库。其核心实现机制依赖于`dense_vector`数据类型和基于Lucene的HNSW算法。
`dense_vector`数据类型
Elasticsearch通过`dense_vector`数据类型来存储浮点数值的向量。这是存储向量嵌入的基础。在索引映射中定义此字段时,需要指定向量的固定维度(`dims`)。例如,一个1536维的文本嵌入可以被定义为:
PUT /my_vector_index
{
  "mappings": {
    "properties": {
      "text_embedding": {
        "type": "dense_vector",
        "dims": 1536,
        "index": true,
        "similarity": "cosine"
      }
    }
  }
}
其中,`"index": true` 启用了向量索引,`"similarity"` 指定了默认的相似度计算算法,如`cosine`(余弦相似度)或`l2_norm`(欧几里得距离)。
k-Nearest Neighbor (kNN) 搜索
Elasticsearch提供了专门的`knn`查询功能,用于查找与给定查询向量最相似的K个向量。这个功能利用了底层的HNSW算法,实现了高效的近似最近邻搜索。
Elasticsearch的kNN搜索流程通常包括:
- 数据摄取 (Ingest): 原始数据通过配置好的摄取管道(Ingest Pipeline)发送到Elasticsearch。
- 生成嵌入: 摄取管道中的推理处理器(Inference Processor)可以调用预部署的嵌入模型,将文本内容转换为向量嵌入。或者,客户端在索引前生成向量。
- 存储: 生成的向量嵌入存储在`dense_vector`类型的字段中。
- 索引构建: Elasticsearch(基于Lucene的HNSW)为这些向量构建索引,以实现快速的近似最近邻搜索。
- 查询: 用户提交一个查询向量,Elasticsearch利用其kNN搜索能力找到最相似的文档。
混合搜索能力
Elasticsearch的一大优势在于其强大的混合搜索能力。它能够无缝结合传统的关键词搜索(利用倒排索引和BM25等算法)与向量语义搜索。这意味着用户可以同时利用精确的关键词匹配和基于语义相似度的模糊匹配来获取更全面、更相关的搜索结果。例如,一个查询可以同时包含关键词过滤和向量相似度搜索,通过`bool`查询和`should`子句来实现。
这种混合搜索特别适用于复杂的搜索场景,如问答系统中的RAG(Retrieval-Augmented Generation)架构,它允许检索到不仅包含特定关键词,而且在语义上高度相关的文档,从而为大型语言模型(LLM)提供更丰富、更准确的上下文信息。
该视频深入探讨了Elasticsearch的向量搜索和混合搜索能力,展示了如何将传统关键词搜索与现代机器学习模型生成的向量搜索相结合,以实现更智能、更准确的搜索体验。它对于理解Elasticsearch如何超越传统TF/IDF算法,在AI时代提供更高级的搜索维度,具有很高的参考价值。
Elasticsearch集群架构概览
Elasticsearch的分布式架构是其能够作为高效向量数据库的基础。一个典型的Elasticsearch集群包含不同角色的节点:
- 主节点 (Master Node): 负责管理集群状态,如索引的创建/删除、节点加入/离开等。
- 数据节点 (Data Node): 存储索引数据,并执行数据相关的操作,如搜索、聚合。向量数据主要存储在数据节点上。
- 协调节点 (Coordinating Node): 负责处理客户端请求,并将请求分发到正确的分片,然后收集结果并返回给客户端。
- 投票专用节点 (Voting-only Node): 参与主节点选举,但不存储数据。
向量索引(特别是HNSW图)通常存储在数据节点的内存(off-heap RAM)中,以确保查询时的高速访问。
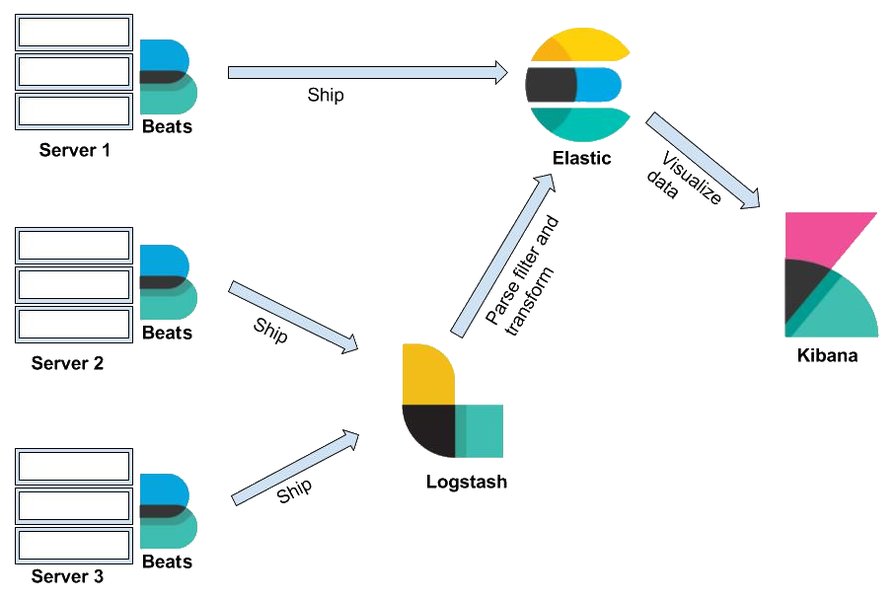
Elastic Stack的典型架构示意图
如何使用Elasticsearch的向量数据库
使用Elasticsearch作为向量数据库涉及以下几个核心步骤:数据准备、索引创建、数据导入和查询向量搜索。
1. 数据准备:生成向量嵌入
这是构建向量数据库的第一步。你需要将原始数据(如文本、图片等)转换为高维向量。这通常通过以下两种方式完成:
- 客户端生成: 在你的应用程序中,使用外部的预训练或自定义机器学习模型(如OpenAI的
text-embedding-3-small、HuggingFace的sentence-transformers模型)来生成向量嵌入。然后,将原始数据和生成的向量一同发送到Elasticsearch进行索引。 - Elasticsearch内部生成(推荐): 利用Elasticsearch的机器学习功能,部署一个文本嵌入模型,并创建摄取管道(Ingest Pipeline)。当数据被索引时,摄取管道中的`inference`处理器会自动调用模型,将指定字段的内容转换为向量嵌入,并存储到`dense_vector`字段中。这大大简化了数据摄取过程。
2. 索引创建与映射定义
在Elasticsearch中,你需要创建一个索引,并定义一个包含`dense_vector`类型字段的映射(mapping)。这个字段将用于存储你的向量嵌入。
PUT /my_documents_index
{
  "mappings": {
    "properties": {
      "content": {
        "type": "text"
      },
      "content_embedding": {
        "type": "dense_vector",
        "dims": 1536,       <span comment="根据你使用的模型设置向量维度"></span>
        "index": true,      <span comment="必须设置为true以启用HNSW索引"></span>
        "similarity": "cosine" <span comment="指定相似度度量,cosine是默认且常用选项"></span>
      },
      "category": {
        "type": "keyword"   <span comment="其他元数据字段,可用于过滤"></span>
      },
      "created_at": {
        "type": "date"
      }
    }
  }
}
注意:"index": true至关重要,它告诉Elasticsearch为该dense_vector字段构建HNSW索引,从而实现高效的kNN搜索。
3. 数据导入
将准备好的数据(包括原始内容和生成的向量)导入到Elasticsearch索引中。如果使用摄取管道,只需发送原始数据;如果客户端生成向量,则需要将向量作为字段的一部分发送。
PUT /my_documents_index/_doc/1?pipeline=text-embedding-pipeline <span comment="如果使用了摄取管道"></span>
{
  "content": "人工智能的最新进展,包括深度学习和大型语言模型。",
  "category": "科技"
}

<span comment="或者,如果客户端生成向量"></span>
PUT /my_documents_index/_doc/2
{
  "content": "自然语言处理是AI的重要分支。",
  "content_embedding": [0.123, 0.456, ..., 0.789], <span comment="这里是实际的1536维向量"></span>
  "category": "科技"
}
最佳实践: 总是使用批量API(`_bulk`)进行数据导入,以减少网络开销和提高索引效率。
4. 查询向量搜索 (kNN 查询)
Elasticsearch提供了`knn`查询来执行向量相似度搜索。
GET /my_documents_index/_search
{
  "knn": {
    "field": "content_embedding",
    "query_vector": [0.1, 0.2, 0.3, ..., 0.1536], <span comment="你的查询向量,与索引向量维度一致"></span>
    "k": 10, <span comment="返回最相似的10个结果"></span>
    "num_candidates": 100 <span comment="HNSW算法在搜索阶段需要考虑的候选数量"></span>
  },
  "fields": ["content", "_score", "category"] <span comment="指定返回的字段"></span>
}
从Elasticsearch 8.7+版本开始,你还可以使用`query_vector_builder`让Elasticsearch在服务器端根据查询文本自动生成向量,进一步简化客户端逻辑:
GET /my_documents_index/_search
{
  "knn": {
    "field": "content_embedding",
    "query_vector_builder": {
      "text_embedding": {
        "model_id": "your-deployed-model-id", <span comment="部署在Elasticsearch中的模型ID"></span>
        "model_text": "关于深度学习的最新研究"
      }
    },
    "k": 10,
    "num_candidates": 100
  }
}
5. 混合搜索 (Hybrid Search)
为了获得更精准的搜索结果,强烈推荐使用混合搜索,结合关键词搜索和向量搜索。这可以通过Elasticsearch的`bool`查询实现:
GET /my_documents_index/_search
{
  "query": {
    "bool": {
      "should": [
        {
          "match": {
            "content": "深度学习" <span comment="关键词匹配查询"></span>
          }
        },
        {
          "knn": {
            "field": "content_embedding",
            "query_vector": [0.1, 0.2, 0.3, ...],
            "k": 10,
            "num_candidates": 100,
            "boost": 2 <span comment="调整向量搜索的重要性,高于关键词搜索"></span>
          }
        }
      ],
      "filter": { <span comment="可选:在搜索前进行过滤"></span>
        "term": {
          "category": "科技"
        }
      }
    }
  },
  "size": 10
}
通过`filter`子句可以极大地提高性能,因为它会在向量相似度计算之前筛选出不符合条件的文档。
Elasticsearch向量数据库调优详解
为了充分发挥Elasticsearch作为向量数据库的性能,并确保查询高效且准确,需要从服务器端和客户端两方面进行详细的调优。特别是查询语句的优化,是提升用户体验的关键。
服务器端调优措施
1. 硬件资源规划与配置
- 内存: 向量索引(HNSW图)主要存储在节点的非堆(off-heap)内存中。为Elasticsearch数据节点配置足够的RAM至关重要。通常,越多越好,以确保HNSW图能够完全加载到内存中,避免频繁的磁盘I/O。建议JVM堆大小设置合理(不超过物理内存的50%,通常在16GB-32GB),并为操作系统缓存留出足够内存。
- CPU: 向量相似度计算是CPU密集型任务。选择高核心数、高主频的CPU有助于提高查询并行度和吞吐量。多核CPU能有效支持HNSW算法的并行搜索。
- 磁盘I/O: 尽管HNSW索引在内存中,但数据的持久化、索引的加载和日志记录仍依赖于I/O性能。使用SSD或NVMe存储能够显著提升读写速度,防止I/O成为瓶颈。
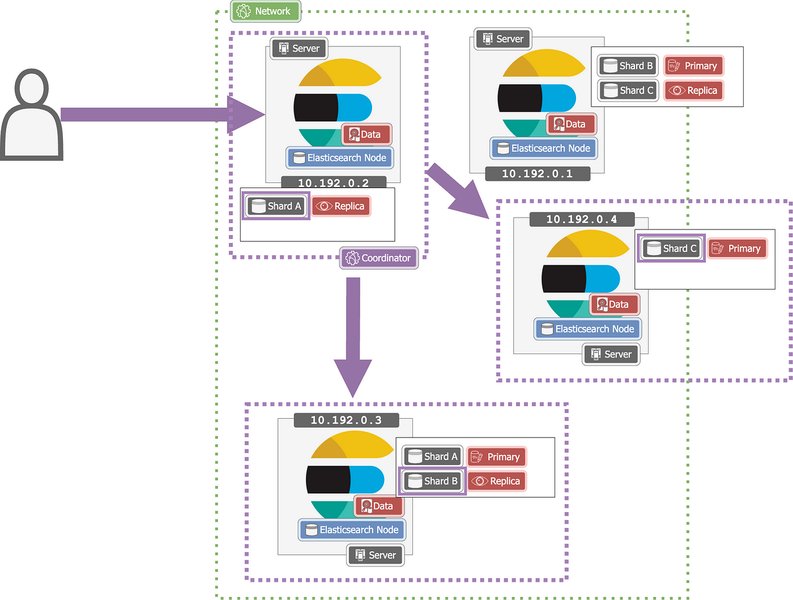
Elasticsearch系统设计中的关键组件与资源依赖
2. 索引配置优化
- HNSW参数调整: 在`dense_vector`字段的索引映射中,HNSW算法有两个关键参数影响索引构建和查询性能:
- `m` (maximum connections per node):每个节点连接的最大邻居数量。值越高,构建的HNSW图越稠密,搜索准确性越高,但索引构建时间、索引大小和内存消耗也越大。
- `ef_construction` (build time search scope):影响HNSW图的构建质量。值越高,索引构建越慢,但构建的图质量越高,搜索准确性也越高。
- 向量维度 (`dims`): 向量维度越高,表示的语义信息越丰富,但存储和计算开销也越大。在满足业务需求的前提下,选择合适的维度。对于某些场景,可以考虑使用向量压缩或量化技术(如Elasticsearch 8.x+支持的Scalar Quantization),以降低存储和计算成本。
- 分片 (Sharding) 和副本 (Replication) 规划:
- 合理规划分片数量,避免过多或过少。过多分片会增加管理开销,过少分片可能导致单个分片过大,影响性能。数据分区策略应考虑向量数据的特性,确保查询时能够均匀分布到各个分片。
- 配置适当的副本数量,既能提高数据的可用性,又能增加查询的并行处理能力(读取可以从副本节点进行)。但副本会增加存储和索引开销。
3. 集群和节点配置
- 节点角色分离: 在大型集群中,明确数据节点、主节点和协调节点的角色,避免资源争抢。例如,不要在主节点上存储数据或执行大量的查询。
- 扩容策略: 随着数据量的增长和查询负载的增加,及时增加数据节点是扩展存储和计算能力的有效手段。Elasticsearch的分布式特性使其水平扩容变得相对简单。
- 内存管理: 除了JVM堆大小,也要关注操作系统缓存的使用,确保有足够的空间缓存文件系统数据,特别是经常访问的索引段。
4. 监控与日志
- 持续监控: 使用Kibana或其他监控工具,持续监控Elasticsearch集群的性能指标,包括CPU使用率、内存使用率、磁盘I/O、GC(垃圾回收)延迟、查询延迟和吞吐量。
- 日志分析: 定期审查Elasticsearch日志,及时发现并解决性能瓶颈、错误和异常活动。
客户端调优措施
1. 查询语句优化 (重点)
- `k` 和 `num_candidates` 参数的选择:
- `k`:指期望返回的最相似结果的数量。
- `num_candidates`:HNSW算法在搜索阶段需要考虑的候选数量。这是性能与准确性之间最关键的权衡点。`num_candidates`越大,召回率可能越高,但查询延迟也会越高,计算成本更大。反之,`num_candidates`越小,查询越快,但可能错过一些相关结果。
- 结合过滤条件 (`filter`): 在`knn`查询中结合结构化过滤条件可以极大地提高性能,因为过滤器可以在向量相似度计算之前筛选出不符合条件的文档,从而显著减少需要进行向量计算的文档数量。例如:
GET /my_vector_index/_search
{
  "knn": {
    "field": "text_embedding",
    "query_vector": [...],
    "k": 10,
    "num_candidates": 100,
    "filter": { <span comment="过滤条件"></span>
      "term": {
        "genre": "科技"
      }
    }
  }
}
建议: 总是优先使用`filter`子句来缩小搜索范围,而不是在查询结果上进行后过滤。
- 混合搜索中的`boost`: 在混合搜索中,通过`boost`参数调整关键词搜索和向量搜索结果的相对重要性。根据业务需求,可以赋予向量搜索更高的权重,以强调语义相关性。
- `query_vector_builder` 的使用: 如果你的Elasticsearch版本支持(8.7+),利用`query_vector_builder`让服务器端生成查询向量,可以减少客户端的计算负担和网络传输。
- 避免复杂脚本: 尽管`script_score`可以实现自定义相似度计算,但如果脚本过于复杂或计算密集,会严重影响查询性能。优先使用Elasticsearch内置的`knn`查询。
- 控制返回结果数量 (`size`) 和字段 (`_source` 或 `fields`): 仅返回业务所需的字段,避免返回整个文档,减少网络传输和客户端处理开销。合理设置`size`参数,避免一次性返回过多结果。
2. 批量操作
- 批量索引 (`_bulk`): 避免单条文档频繁索引。使用批量API进行数据摄取,可以显著减少网络往返时间(RTT)和Elasticsearch的内部处理成本,提高数据导入效率。
- 批量查询 (`_msearch`): 如果有多个独立的查询需要执行,考虑使用`_msearch` API,它允许在一个请求中发送多个搜索请求,从而减少网络开销和延迟。
3. 连接管理与并发
- 连接池: 在应用程序中使用Elasticsearch客户端库提供的连接池,避免频繁地创建和关闭连接,减少连接建立的开销。
- 异步和并发调用: 使用异步API或多线程/协程并发执行查询,特别是在需要同时处理大量用户请求时,以提升客户端的吞吐量。
- 超时设置: 合理设置查询超时时间,防止长时间运行的查询阻塞系统资源,提高系统的鲁棒性。
4. 向量预处理与归一化
- 向量归一化: 对输入向量进行归一化处理(例如,L2归一化),确保相似度计算的准确性。某些相似度度量(如余弦相似度)在向量归一化后能提供更稳定的结果。
- 选择合适的嵌入模型: 确保所使用的嵌入模型与你的数据类型和业务场景高度匹配。高质量的嵌入是向量搜索准确性的基础。
5. 错误处理与重试机制
- 实现健壮的错误处理和重试逻辑,以应对网络瞬时故障、Elasticsearch集群的临时负载高峰或索引操作失败。
综合调优策略的关键维度评估
以下雷达图展示了Elasticsearch向量数据库在多个关键调优维度上的相对重要性和影响,帮助您更直观地理解调优的侧重点。
这张雷达图直观地展示了不同调优措施在“性能影响”和“调优复杂度”两个维度上的表现。可以看到,硬件资源配置、HNSW索引参数以及查询参数的精准调优对性能影响最大,但相应地,HNSW参数和查询参数的调整也具有较高的复杂性,需要深入理解和反复测试。
Elasticsearch向量数据库调优思维导图
以下思维导图概括了Elasticsearch向量数据库调优的各项关键因素及其相互关系,帮助您形成一个系统的调优框架。
这张思维导图清晰地勾勒出Elasticsearch向量数据库调优的各个方面,从宏观的服务器资源到微观的查询参数,帮助您全面思考和规划调优策略。
常见问题解答 (FAQ)
什么是Elasticsearch中的dense_vector字段?
dense_vector是Elasticsearch中用于存储高维浮点数向量(即向量嵌入)的数据类型。它是实现向量搜索的基础,每个文档可以有一个或多个此类型的字段,每个字段需要指定向量的固定维度。HNSW算法在Elasticsearch向量搜索中扮演什么角色?
dense_vector字段构建索引。它通过构建多层级图结构,显著加速了在大规模数据集上的向量相似度查询,实现了性能和准确性的平衡。如何平衡Elasticsearch向量搜索的性能和准确性?
knn查询中的k和num_candidates参数,以及服务器端HNSW索引的m和ef_construction参数。增加num_candidates和ef_construction通常能提高准确性(召回率),但会增加查询延迟和索引构建时间。需要通过反复测试和评估,找到适合您应用场景的最佳参数组合。Elasticsearch的混合搜索有什么优势?
结论
Elasticsearch凭借其强大的搜索和分析能力,结合`dense_vector`数据类型和基于HNSW的kNN算法,已经发展成为一个功能成熟且高效的向量数据库。它不仅能够存储和检索高维向量,还能无缝集成传统的关键词搜索,提供强大的混合搜索能力,以满足现代AI应用中日益复杂的语义搜索需求。通过对服务器端(硬件、索引配置)和客户端(查询设计、批量操作)进行精细的调优,特别是对`k`和`num_candidates`等查询参数的理解和优化,可以显著提升Elasticsearch向量搜索的性能、准确性和用户体验。持续的监控、测试和迭代是确保Elasticsearch向量数据库高效稳定运行的关键。
推荐深入探索的查询
- Elasticsearch中的向量压缩和量化技术如何优化存储和查询?
- 如何在Elasticsearch中部署和管理机器学习模型以生成嵌入?
- Elasticsearch向量搜索与专门向量数据库的性能比较和适用场景分析
- 在RAG(Retrieval-Augmented Generation)架构中,Elasticsearch向量数据库有哪些最佳实践?