
ปลดล็อกพลังการทำนายขั้นสูง: เจาะลึก Ensemble Learning และกลยุทธ์การเลือกผลลัพธ์
คู่มือฉบับสมบูรณ์เพื่อทำความเข้าใจเทคนิคการรวมโมเดลหลายตัวเพื่อเพิ่มประสิทธิภาพและความแม่นยำในการเรียนรู้ของเครื่อง
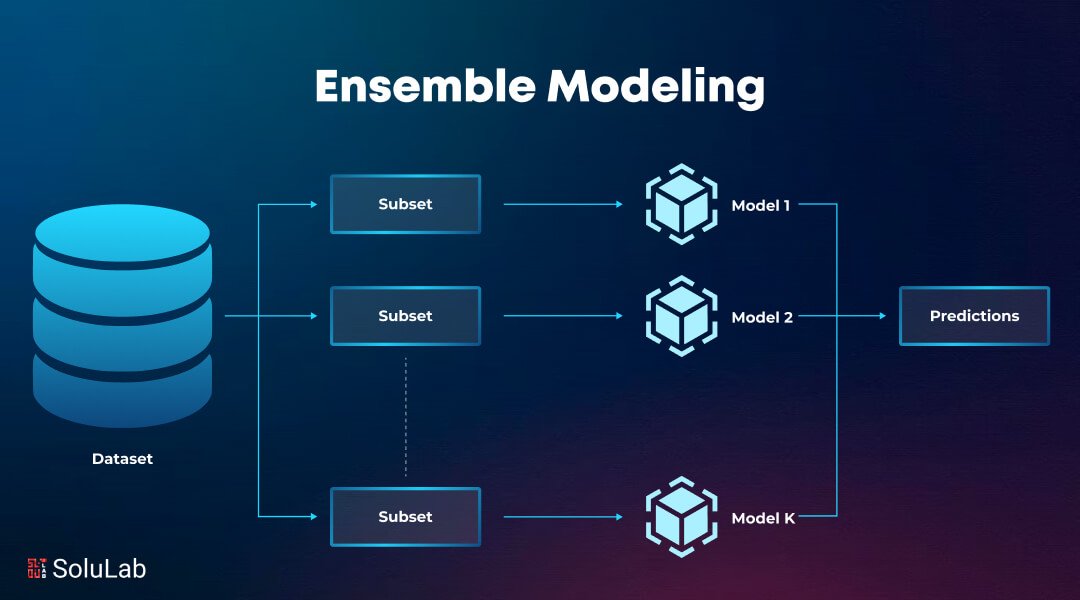
ภาพแสดงแนวคิดของการรวมหลายโมเดลเพื่อสร้างการทำนายที่ทรงพลังยิ่งขึ้น
ประเด็นสำคัญที่คุณจะได้รับ
- ความหมายและประโยชน์: ทำความเข้าใจว่า Ensemble Learning คืออะไร และเหตุใดจึงเป็นเครื่องมือสำคัญในการปรับปรุงประสิทธิภาพของโมเดล Machine Learning โดยช่วยลดความแปรปรวน ลดความลำเอียง และป้องกัน Overfitting
- ประเภทหลักของ Ensemble: เรียนรู้เทคนิค Ensemble ที่นิยมใช้ เช่น Bagging, Boosting, Stacking, และ Voting พร้อมตัวอย่างอัลกอริทึมที่เกี่ยวข้อง
- กลยุทธ์การตัดสินใจสุดท้าย: ค้นพบวิธีการต่างๆ ในการรวมผลการทำนายจากโมเดลย่อยหลายตัวเพื่อให้ได้ผลลัพธ์สุดท้ายที่แม่นยำที่สุด ทั้งสำหรับงานจำแนกประเภท (Classification) และงานถดถอย (Regression)
Ensemble Learning คืออะไร? ทำไมจึงสำคัญ?
Ensemble Learning หรือ การเรียนรู้แบบรวมกลุ่ม เป็นกระบวนทัศน์ในสาขาการเรียนรู้ของเครื่อง (Machine Learning) ที่มีเป้าหมายเพื่อเพิ่มประสิทธิภาพการทำนายโดยการสร้างและรวมผลลัพธ์จากโมเดลการเรียนรู้หลายๆ ตัว แทนที่จะพึ่งพาโมเดลเพียงตัวเดียว หลักการพื้นฐานคือ "หลายหัวย่อมดีกว่าหัวเดียว" โดยโมเดลแต่ละตัวที่เรียกว่า "ผู้เรียนพื้นฐาน" (base learners) หรือ "ผู้เรียนที่อ่อนแอ" (weak learners) อาจมีจุดแข็งและจุดอ่อนที่แตกต่างกัน เมื่อนำมารวมกันอย่างชาญฉลาด จุดอ่อนของโมเดลหนึ่งอาจถูกชดเชยด้วยจุดแข็งของโมเดลอื่น ทำให้โมเดลรวม (ensemble model) หรือ "ผู้เรียนที่แข็งแกร่ง" (strong learner) มีความแม่นยำ (accuracy) เสถียรภาพ (stability) และความทนทาน (robustness) สูงกว่าการใช้โมเดลเดี่ยวๆ
ประโยชน์หลักของ Ensemble Learning ได้แก่:
- การลดความแปรปรวน (Variance Reduction): เทคนิคอย่าง Bagging ช่วยลดความอ่อนไหวของโมเดลต่อการเปลี่ยนแปลงเล็กน้อยในชุดข้อมูลฝึกสอน ทำให้โมเดลมีความเสถียรมากขึ้น
- การลดความลำเอียง (Bias Reduction): เทคนิคอย่าง Boosting มุ่งเน้นไปที่การแก้ไขข้อผิดพลาดของโมเดลก่อนหน้า ทำให้สามารถจับรูปแบบที่ซับซ้อนในข้อมูลได้ดีขึ้น
- การปรับปรุงประสิทธิภาพการทำนาย: โดยทั่วไปแล้ว Ensemble model มักให้ผลการทำนายที่ดีกว่าโมเดลเดี่ยวที่ดีที่สุดที่อยู่ในกลุ่มนั้น
- การป้องกันการเกิด Overfitting: การรวมโมเดลหลายตัวช่วยลดโอกาสที่โมเดลจะเรียนรู้เฉพาะเจาะจงกับข้อมูลฝึกสอนมากเกินไป จนไม่สามารถนำไปใช้ได้ดีกับข้อมูลใหม่ที่ไม่เคยเห็นมาก่อน
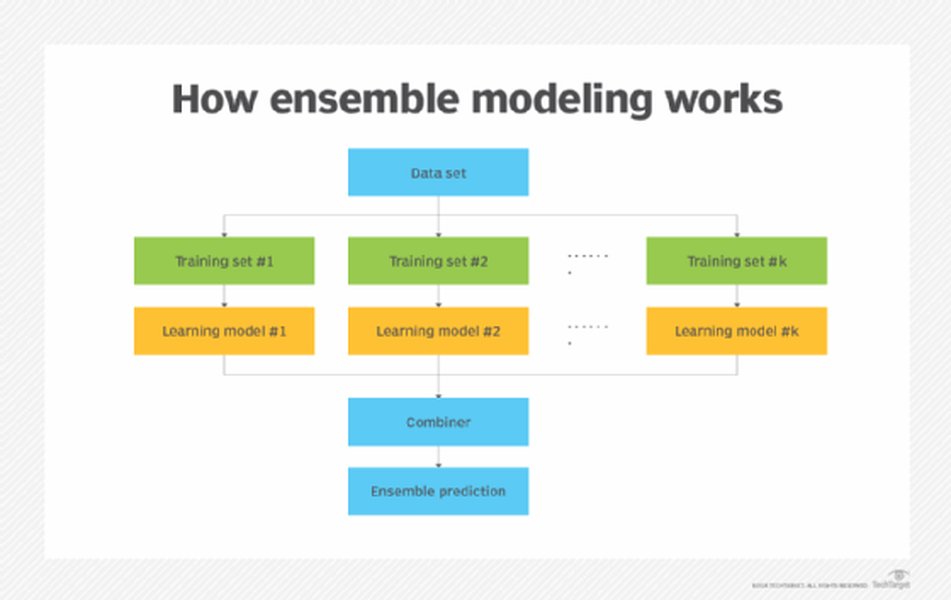
แผนภาพแสดงการรวมผลลัพธ์จากโมเดลพื้นฐานหลายตัวเพื่อสร้างผลการทำนายสุดท้าย
Ensemble Learning สามารถแบ่งตามลักษณะการสร้างโมเดลพื้นฐานได้เป็น 2 กลุ่มใหญ่ๆ:
- Sequential Ensemble Learning: โมเดลพื้นฐานถูกสร้างขึ้นตามลำดับ โดยโมเดลที่สร้างขึ้นทีหลังจะพยายามแก้ไขหรือปรับปรุงข้อผิดพลาดที่เกิดจากโมเดลก่อนหน้า เทคนิคนี้มักช่วยลดความลำเอียง
- Parallel Ensemble Learning: โมเดลพื้นฐานถูกสร้างขึ้นอย่างอิสระจากกันและพร้อมกัน (หรือขนานกัน) จากนั้นผลลัพธ์ของแต่ละโมเดลจะถูกนำมารวมกัน เทคนิคนี้มักช่วยลดความแปรปรวน
ประเภทของ Ensemble Learning ที่ควรรู้จัก
มีเทคนิค Ensemble Learning ที่ได้รับความนิยมและใช้งานอย่างแพร่หลายหลายวิธี แต่ละวิธีมีแนวทางในการสร้างและรวมโมเดลที่แตกต่างกันไป:
1. Bagging (Bootstrap Aggregating)
หลักการทำงาน
Bagging เป็นเทคนิคในกลุ่ม Parallel Ensemble Learning ที่สร้างโมเดลพื้นฐานหลายตัว โดยแต่ละโมเดลจะถูกฝึกฝนบนชุดข้อมูลย่อยที่แตกต่างกัน ชุดข้อมูลย่อยเหล่านี้ได้มาจากการสุ่มตัวอย่างแบบ Bootstrap (สุ่มตัวอย่างแบบมีการใส่คืน) จากชุดข้อมูลฝึกสอนดั้งเดิม การสุ่มตัวอย่างแบบนี้ทำให้โมเดลแต่ละตัวเห็นข้อมูลที่แตกต่างกันเล็กน้อย ซึ่งช่วยสร้างความหลากหลาย (diversity) ให้กับโมเดลในกลุ่ม หลังจากที่โมเดลทั้งหมดถูกฝึกฝนแล้ว ผลการทำนายสุดท้ายจะมาจากการรวมผลของทุกโมเดล เช่น การลงคะแนนเสียงข้างมาก (Majority Voting) สำหรับปัญหาการจำแนกประเภท หรือการหาค่าเฉลี่ย (Averaging) สำหรับปัญหาการถดถอย
ตัวอย่างอัลกอริทึมยอดนิยม
Random Forest เป็นตัวอย่างที่โดดเด่นที่สุดของ Bagging โดยใช้ Decision Trees เป็นโมเดลพื้นฐาน แต่ละ Tree ใน Random Forest จะถูกสร้างขึ้นจากตัวอย่าง Bootstrap และในแต่ละโหนดของการแตกกิ่ง จะมีการสุ่มเลือกกลุ่มย่อยของ features มาพิจารณาเพื่อหา feature ที่ดีที่สุดในการแบ่ง แทนที่จะพิจารณาทุก features ซึ่งช่วยเพิ่มความหลากหลายให้กับ Trees มากยิ่งขึ้น
ข้อดี
Bagging มีประสิทธิภาพในการลดความแปรปรวนของโมเดล ทำให้โมเดลมีความเสถียรและลดโอกาสการเกิด Overfitting โดยเฉพาะเมื่อใช้กับโมเดลพื้นฐานที่มีความแปรปรวนสูง เช่น Decision Trees ที่ไม่ได้ตัดกิ่ง (unpruned)
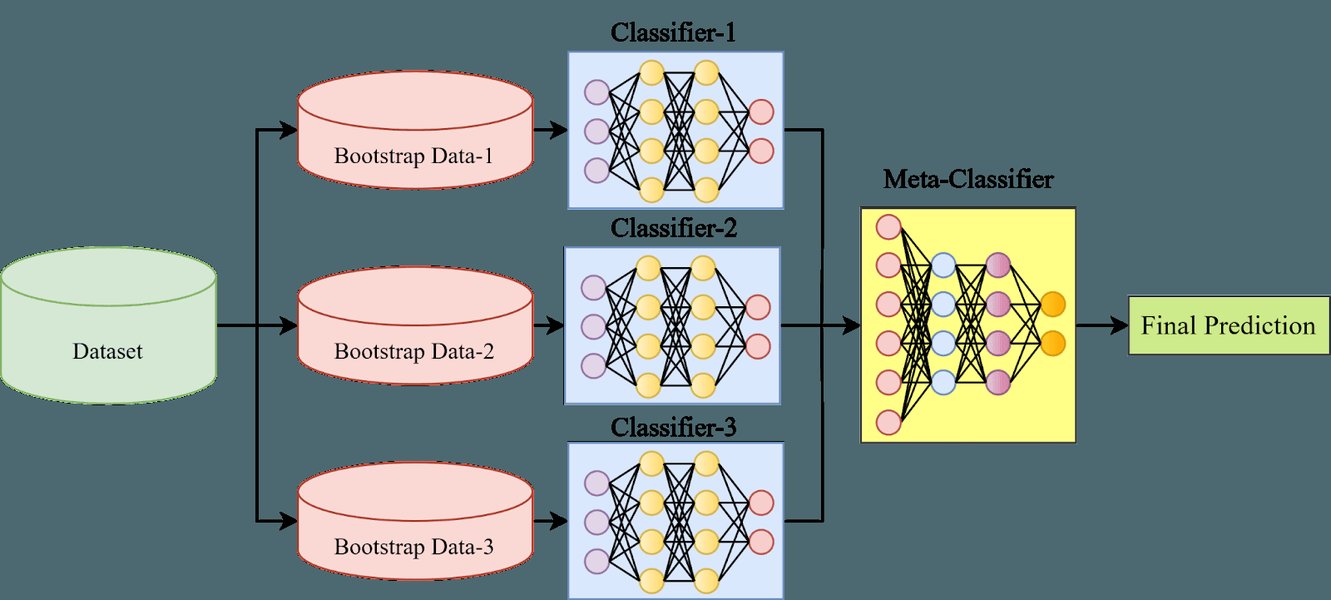
แผนภาพแสดงกระบวนการ Bagging ที่มีการสุ่มตัวอย่างข้อมูลและฝึกโมเดลหลายตัวแบบขนาน
2. Boosting
หลักการทำงาน
Boosting เป็นเทคนิคในกลุ่ม Sequential Ensemble Learning ซึ่งสร้างโมเดลพื้นฐานตามลำดับ แต่ละโมเดลที่สร้างขึ้นใหม่จะให้ความสำคัญกับตัวอย่างข้อมูลที่โมเดลก่อนหน้าทำนายผิดพลาดหรือทำนายได้ไม่ดี โดยทั่วไป โมเดลใน Boosting จะเป็น "weak learners" (เช่น Decision Trees ขนาดเล็ก หรือ stumps) และค่อยๆ พัฒนาเป็น "strong learner" โดยการรวมผลการเรียนรู้จากข้อผิดพลาด
ตัวอย่างอัลกอริทึมยอดนิยม
- AdaBoost (Adaptive Boosting): ปรับน้ำหนักของตัวอย่างข้อมูลในแต่ละรอบ โดยเพิ่มน้ำหนักให้กับตัวอย่างที่ถูกทำนายผิด และโมเดลที่ทำนายได้ดีจะได้รับน้ำหนักมากขึ้นในการรวมผลสุดท้าย
- Gradient Boosting Machines (GBM): สร้างโมเดลใหม่เพื่อทำนายค่าความคลาดเคลื่อน (residuals) ของโมเดลก่อนหน้า และพยายามลดค่า loss function โดยใช้วิธี Gradient Descent
- XGBoost (Extreme Gradient Boosting): เป็นการปรับปรุงต่อจาก Gradient Boosting โดยเพิ่ม regularization เพื่อป้องกัน Overfitting และมีประสิทธิภาพในการคำนวณสูง
- LightGBM และ CatBoost: เป็นอัลกอริทึม Boosting ที่ใหม่กว่า ซึ่งมีประสิทธิภาพสูงและจัดการกับข้อมูลประเภทต่างๆ ได้ดี
ข้อดี
Boosting มักให้ความแม่นยำสูงมาก และมีประสิทธิภาพในการลดความลำเอียงของโมเดล อย่างไรก็ตาม Boosting อาจมีความอ่อนไหวต่อข้อมูลที่มี noise และมีโอกาสเกิด Overfitting ได้หากไม่ได้ปรับ hyperparameters อย่างเหมาะสม
3. Stacking (Stacked Generalization)
หลักการทำงาน
Stacking เป็นเทคนิค Ensemble ที่มีความซับซ้อนกว่า Bagging และ Boosting โดยแนวคิดหลักคือการรวมการทำนายจากโมเดลพื้นฐาน (base models หรือ level-0 models) หลายๆ ตัว แล้วใช้ผลการทำนายเหล่านั้นเป็น input features ใหม่สำหรับโมเดลอีกตัวหนึ่งที่เรียกว่า "meta-model" หรือ "level-1 model" (หรือ "blender") Meta-model นี้จะเรียนรู้วิธีการรวมผลลัพธ์จากโมเดลพื้นฐานอย่างเหมาะสมที่สุดเพื่อให้ได้การทำนายสุดท้าย
กระบวนการ Stacking โดยทั่วไปประกอบด้วย:
- แบ่งชุดข้อมูลฝึกสอนออกเป็นส่วนๆ (folds) เพื่อใช้ใน cross-validation
- ฝึกโมเดลพื้นฐานหลายๆ ตัว (ซึ่งอาจเป็นอัลกอริทึมประเภทต่างๆ กัน) บนข้อมูลฝึกสอนส่วนหนึ่ง และทำนายผลบนข้อมูลอีกส่วนหนึ่ง (validation/hold-out set)
- ผลการทำนายจากโมเดลพื้นฐานบน validation set จะถูกนำมาสร้างเป็นชุดข้อมูลใหม่ (meta-features)
- ฝึก meta-model โดยใช้ meta-features เหล่านี้เป็น input และ target variable เดิมเป็น output
ข้อดี
Stacking สามารถให้ประสิทธิภาพที่สูงมาก เนื่องจากใช้ประโยชน์จากจุดแข็งของโมเดลที่หลากหลายและเรียนรู้วิธีการรวมผลที่ดีที่สุด อย่างไรก็ตาม Stacking มีความซับซ้อนในการสร้างและปรับแต่ง และอาจใช้เวลาในการฝึกนานกว่า
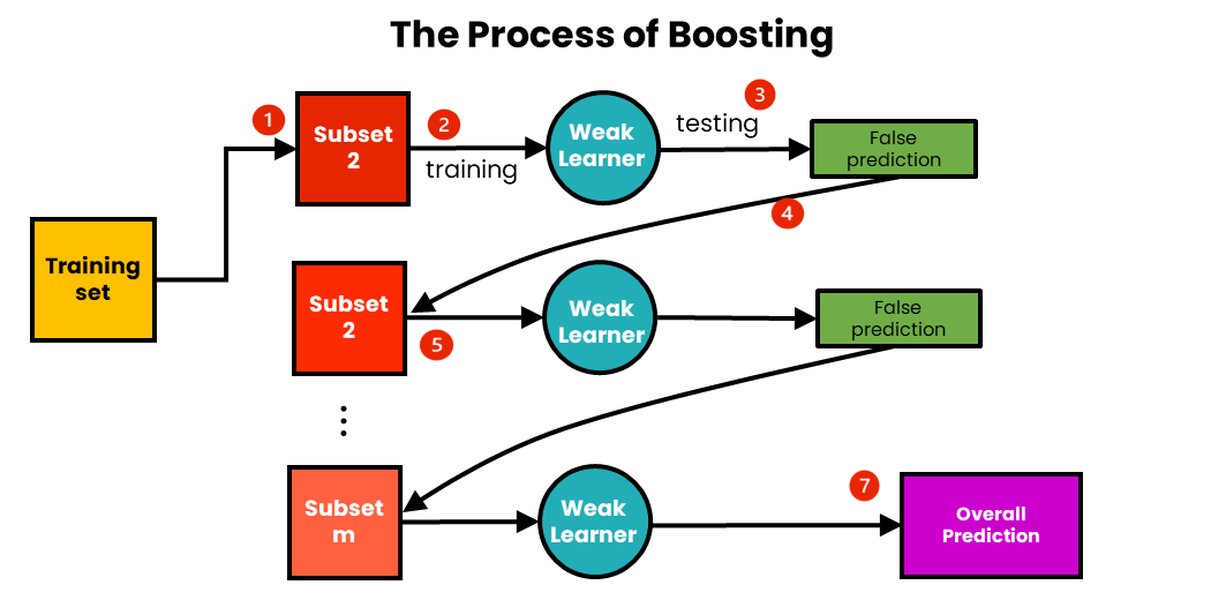
ภาพแสดงความแตกต่างในกระบวนการของ Bagging, Boosting, และ Stacking
4. Voting
หลักการทำงาน
Voting เป็นวิธีที่ง่ายที่สุดในการรวมผลการทำนายจากโมเดลหลายตัว โดยแต่ละโมเดลจะทำการทำนายอย่างอิสระ และผลลัพธ์สุดท้ายจะถูกตัดสินจากการ "โหวต" ของโมเดลเหล่านั้น เหมาะสำหรับปัญหาการจำแนกประเภท (Classification)
ประเภทของ Voting
- Hard Voting (Majority Voting): เลือกคลาสที่ได้รับการโหวตจากโมเดลส่วนใหญ่เป็นผลลัพธ์สุดท้าย ตัวอย่างเช่น หากมี 3 โมเดลทำนายคลาส A, B, A ตามลำดับ ผลลัพธ์สุดท้ายคือคลาส A
- Soft Voting (Weighted Voting): พิจารณาความน่าจะเป็น (probability) ที่แต่ละโมเดลทำนายสำหรับแต่ละคลาส จากนั้นนำความน่าจะเป็นมาเฉลี่ย (หรือถ่วงน้ำหนักตามความน่าเชื่อถือของแต่ละโมเดล) แล้วเลือกคลาสที่มีความน่าจะเป็นเฉลี่ยสูงสุด Soft Voting มักให้ผลลัพธ์ที่ดีกว่า Hard Voting หากโมเดลสามารถให้ค่าความน่าจะเป็นที่สอบเทียบ (calibrated) ได้ดี
ตัวอย่างการใช้งาน
Voting Classifier ในไลบรารี scikit-learn เป็นตัวอย่างหนึ่งที่สามารถรวมโมเดลต่างๆ เข้าด้วยกันโดยใช้วิธี Voting
5. Blending
หลักการทำงาน
Blending มีความคล้ายคลึงกับ Stacking แต่มีกระบวนการที่ง่ายกว่าเล็กน้อย โดยทั่วไป Blending จะแบ่งชุดข้อมูลฝึกสอนออกเป็นชุดฝึก (training set) และชุดตรวจสอบความถูกต้อง (validation set หรือ hold-out set) โมเดลพื้นฐาน (level-0 models) จะถูกฝึกบนชุดฝึก จากนั้นนำไปทำนายผลบนชุดตรวจสอบความถูกต้อง ผลการทำนายเหล่านี้จะถูกใช้เป็น features สำหรับฝึก meta-model (level-1 model) ซึ่ง meta-model นี้จะเรียนรู้ที่จะรวมผลการทำนายจากโมเดลพื้นฐานเพื่อสร้างผลลัพธ์สุดท้าย
ความแตกต่างหลักจาก Stacking คือ Blending มักจะไม่ใช้ cross-validation ในการสร้าง meta-features ซึ่งอาจทำให้เสี่ยงต่อการ Overfitting กับ validation set หาก validation set มีขนาดเล็กเกินไป แต่ก็มีข้อดีคือการสร้างโมเดลเร็วกว่า
การเปรียบเทียบคุณลักษณะของเทคนิค Ensemble หลัก
เพื่อให้เห็นภาพรวมและเข้าใจความแตกต่างของเทคนิค Ensemble หลักๆ ได้ชัดเจนยิ่งขึ้น ลองพิจารณาการเปรียบเทียบคุณลักษณะต่างๆ ผ่าน Radar Chart ด้านล่างนี้ โดยค่าที่สูงกว่า (ใกล้ขอบนอก) หมายถึงมีคุณสมบัตินั้นๆ มากกว่า (เช่น ลด Bias ได้ดีกว่า หรือมีความซับซ้อนมากกว่า)
หมายเหตุ: ค่าใน Radar Chart เป็นการประเมินเชิงคุณภาพเพื่อแสดงแนวโน้มทั่วไป และอาจแตกต่างกันไปขึ้นอยู่กับการตั้งค่า hyperparameters และลักษณะของชุดข้อมูล
วิธีการเลือกผลลัพธ์สุดท้าย (Combining Predictions)
เมื่อโมเดลพื้นฐานใน Ensemble ได้ทำการทำนายแล้ว ขั้นตอนต่อไปคือการรวมผลการทำนายเหล่านั้นเพื่อให้ได้ผลลัพธ์สุดท้าย วิธีการรวมผลจะขึ้นอยู่กับประเภทของปัญหา (การจำแนกประเภทหรือการถดถอย) และเทคนิค Ensemble ที่ใช้
สำหรับปัญหาการจำแนกประเภท (Classification)
- Majority Voting (Hard Voting): เป็นวิธีที่ง่ายและตรงไปตรงมาที่สุด โดยเลือกคลาสที่ได้รับการทำนายจากโมเดลส่วนใหญ่เป็นผลลัพธ์สุดท้าย เหมาะสำหรับ Bagging และ Voting Classifiers ทั่วไป
- Weighted Majority Vote / Soft Voting: ใน Soft Voting จะใช้ความน่าจะเป็นที่โมเดลแต่ละตัวทำนายสำหรับแต่ละคลาส จากนั้นนำมาเฉลี่ย (อาจมีการถ่วงน้ำหนักตามประสิทธิภาพของแต่ละโมเดล) แล้วเลือกคลาสที่มีความน่าจะเป็นเฉลี่ยสูงสุด วิธีนี้มักให้ผลลัพธ์ที่ดีกว่า Hard Voting โดยเฉพาะเมื่อโมเดลสามารถให้ค่าความน่าจะเป็นที่แม่นยำ มักใช้ใน Bagging, Boosting และ Voting Classifiers
สำหรับปัญหาการถดถอย (Regression)
- Averaging: ค่าทำนายจากโมเดลทั้งหมดจะถูกนำมาหาค่าเฉลี่ยเพื่อเป็นผลลัพธ์สุดท้าย เป็นวิธีที่ใช้กันทั่วไปใน Bagging สำหรับงาน Regression
- Weighted Averaging: คล้ายกับ Averaging แต่การทำนายของแต่ละโมเดลจะมีน้ำหนักที่แตกต่างกัน โดยโมเดลที่มีประสิทธิภาพดีกว่าอาจได้รับน้ำหนักมากกว่าในการคำนวณค่าเฉลี่ย มักพบในเทคนิค Boosting บางประเภท
สำหรับ Stacking และ Blending
ในเทคนิค Stacking และ Blending ผลการทำนายสุดท้ายจะมาจาก meta-model ซึ่งได้เรียนรู้วิธีการรวมผลลัพธ์จากโมเดลพื้นฐานอย่างเหมาะสมที่สุด Meta-model นี้อาจเป็นอัลกอริทึมง่ายๆ เช่น Logistic Regression, Linear Regression หรือแม้แต่ Random Forest ขนาดเล็กก็ได้
ข้อควรพิจารณาในการเลือกผลลัพธ์สุดท้าย
- ความหลากหลายของโมเดลพื้นฐาน (Diversity of Base Learners): Ensemble จะทำงานได้ดีที่สุดเมื่อโมเดลพื้นฐานมีความหลากหลาย คือทำข้อผิดพลาดในรูปแบบที่แตกต่างกัน
- การประเมินผลด้วย Validation Set หรือ Cross-Validation: ควรใช้ชุดข้อมูลตรวจสอบความถูกต้องหรือเทคนิค Cross-Validation เพื่อประเมินประสิทธิภาพของ Ensemble และ meta-model (ในกรณี Stacking/Blending) เพื่อหลีกเลี่ยง Overfitting
- ความซับซ้อนและเวลาในการฝึก: เทคนิคที่ซับซ้อนกว่า เช่น Stacking อาจให้ผลลัพธ์ที่ดีกว่า แต่ก็ต้องใช้เวลาในการฝึกและปรับแต่งมากกว่า
ภาพรวมโครงสร้าง Ensemble Learning ผ่าน Mindmap
Mindmap ด้านล่างนี้จะช่วยให้คุณเห็นภาพรวมของโครงสร้างและความสัมพันธ์ของเทคนิค Ensemble Learning ต่างๆ รวมถึงวิธีการรวมผลลัพธ์ที่เกี่ยวข้อง
(สร้างโมเดลพร้อมกัน)"] id1_1_1["Bagging"] id1_1_1_1["- สุ่มตัวอย่าง Bootstrap"] id1_1_1_2["- ลด Variance"] id1_1_1_3["- ตัวอย่าง: Random Forest"] id1_1_2["Voting (พื้นฐาน)"] id1_2["Sequential Ensembles
(สร้างโมเดลตามลำดับ)"] id1_2_1["Boosting"] id1_2_1_1["- เรียนรู้จากข้อผิดพลาด"] id1_2_1_2["- ลด Bias"] id1_2_1_3["- ตัวอย่าง: AdaBoost, Gradient Boosting, XGBoost"] id1_3["Advanced Ensembles"] id1_3_1["Stacking (Stacked Generalization)"] id1_3_1_1["- ใช้ Base Models และ Meta-Model"] id1_3_1_2["- เรียนรู้วิธีรวมผลที่ดีที่สุด"] id1_3_2["Blending"] id1_3_2_1["- คล้าย Stacking แต่ใช้ Hold-out set"] id2["วิธีการรวมผลลัพธ์สุดท้าย"] id2_1["สำหรับ Classification"] id2_1_1["Majority Voting (Hard Voting)"] id2_1_2["Weighted Voting (Soft Voting)"] id2_2["สำหรับ Regression"] id2_2_1["Averaging"] id2_2_2["Weighted Averaging"] id2_3["สำหรับ Stacking/Blending"] id2_3_1["ผ่าน Meta-Model"] id3["ประโยชน์หลัก"] id3_1["เพิ่มความแม่นยำ"] id3_2["ลด Overfitting"] id3_3["เพิ่มความเสถียรของโมเดล"]
Mindmap นี้แสดงให้เห็นว่า Ensemble Learning แบ่งออกเป็นประเภทหลักๆ อย่างไร และแต่ละประเภทมีลักษณะเฉพาะหรือตัวอย่างอัลกอริทึมใดบ้าง รวมถึงวิธีการรวมผลลัพธ์ที่ใช้กันทั่วไปสำหรับปัญหาประเภทต่างๆ
ตารางสรุปเทคนิค Ensemble Learning
ตารางด้านล่างนี้สรุปข้อมูลสำคัญของเทคนิค Ensemble Learning หลักๆ เพื่อให้ง่ายต่อการเปรียบเทียบและทำความเข้าใจ:
| เทคนิค Ensemble | ประเภท | หลักการสำคัญ | ตัวอย่างอัลกอริทึม | การรวมผลลัพธ์ (Classification) | การรวมผลลัพธ์ (Regression) | จุดเด่นหลัก |
|---|---|---|---|---|---|---|
| Bagging | Parallel | สร้างโมเดลบน Bootstrap samples | Random Forest | Majority Voting, Soft Voting | Averaging | ลด Variance, ป้องกัน Overfitting |
| Boosting | Sequential | โมเดลใหม่เรียนรู้จากข้อผิดพลาดของโมเดลเก่า | AdaBoost, Gradient Boosting, XGBoost | Weighted Voting (มักจะซับซ้อนกว่า) | Weighted Averaging (มักจะซับซ้อนกว่า) | ลด Bias, ให้ความแม่นยำสูง |
| Stacking | Advanced (Hierarchical) | ใช้ meta-model เรียนรู้วิธีรวมผลจาก base models | - (เป็นการผสมผสานหลายอัลกอริทึม) | ผลจาก Meta-model | ผลจาก Meta-model | สามารถให้ประสิทธิภาพสูงมาก, ยืดหยุ่น |
| Voting | Parallel (พื้นฐาน) | รวมผลจากหลายโมเดลด้วยการโหวต | Voting Classifier | Hard Voting, Soft Voting | (ไม่นิยมใช้โดยตรง แต่หลักการคล้าย Averaging) | ง่ายต่อการนำไปใช้ |
| Blending | Advanced (Hierarchical) | คล้าย Stacking แต่ใช้ hold-out set สำหรับ meta-model | - (เป็นการผสมผสานหลายอัลกอริทึม) | ผลจาก Meta-model | ผลจาก Meta-model | เร็วกว่า Stacking บางกรณี, ลด Overfitting กับ Validation set |
ตารางนี้ช่วยให้เห็นภาพรวมของแต่ละเทคนิคได้อย่างรวดเร็ว ทำให้สามารถเลือกใช้เทคนิคที่เหมาะสมกับปัญหาและข้อมูลที่มีอยู่ได้ดียิ่งขึ้น
เรียนรู้เพิ่มเติมจากวิดีโอ: Ensemble Learning (Boosting, Bagging, and Stacking)
วิดีโอนี้จะอธิบายแนวคิดของ Ensemble Learning โดยเน้นไปที่เทคนิคหลักๆ อย่าง Bagging, Boosting, และ Stacking พร้อมตัวอย่างประกอบเพื่อให้เข้าใจได้ง่ายยิ่งขึ้น การดูวิดีโอจะช่วยเสริมความเข้าใจในเนื้อหาที่ได้อ่านมา และเห็นภาพการประยุกต์ใช้เทคนิคเหล่านี้ในสถานการณ์จริง
วิดีโอนี้ให้ภาพรวมที่ดีเกี่ยวกับวิธีการทำงานของแต่ละเทคนิค และความแตกต่างที่สำคัญระหว่าง Bagging ที่เน้นการลดความแปรปรวนผ่านการสร้างโมเดลอิสระหลายตัวบนข้อมูลย่อย, Boosting ที่เน้นการลดความลำเอียงโดยการเรียนรู้ตามลำดับและแก้ไขข้อผิดพลาด, และ Stacking ที่รวมเอาความสามารถของโมเดลหลากหลายประเภทมาสร้างโมเดลที่แข็งแกร่งยิ่งขึ้น การทำความเข้าใจผ่านสื่อวิดีโอจะช่วยให้เห็นภาพการทำงานของอัลกอริทึมเหล่านี้ได้ชัดเจนขึ้น
คำถามที่พบบ่อย (FAQ)
Ensemble Learning เหมาะกับปัญหาประเภทใดบ้าง?
Ensemble Learning สามารถนำไปใช้ได้กับปัญหา Machine Learning หลากหลายประเภท ทั้งปัญหาการจำแนกประเภท (Classification) เช่น การตรวจจับสแปมอีเมล การวินิจฉัยโรค การจดจำใบหน้า และปัญหาการถดถอย (Regression) เช่น การพยากรณ์ราคาหุ้น การคาดการณ์ยอดขาย หรือการประเมินมูลค่าอสังหาริมทรัพย์ โดยเฉพาะอย่างยิ่งในงานที่ต้องการความแม่นยำสูงหรือข้อมูลมีความซับซ้อน Ensemble Learning มักจะให้ผลลัพธ์ที่ดีกว่าการใช้โมเดลเดี่ยว
ข้อเสียของ Ensemble Learning คืออะไร?
แม้ว่า Ensemble Learning จะมีข้อดีหลายประการ แต่ก็มีข้อเสียบางประการเช่นกัน ได้แก่:
- ความซับซ้อนที่เพิ่มขึ้น: การสร้างและจัดการโมเดลหลายตัวย่อมมีความซับซ้อนกว่าการใช้โมเดลเดี่ยว
- เวลาในการคำนวณและทรัพยากรที่มากขึ้น: การฝึกโมเดลหลายตัวต้องใช้เวลาและพลังการประมวลผลมากกว่า
- การตีความโมเดลที่ยากขึ้น: การทำความเข้าใจว่าทำไม Ensemble model จึงตัดสินใจแบบนั้นอาจยากกว่าโมเดลเดี่ยวบางประเภท (เช่น Decision Tree เดี่ยวๆ) โดยเฉพาะกับเทคนิคที่ซับซ้อนอย่าง Stacking หรือ Boosting ที่มีโมเดลจำนวนมาก
- โอกาสในการเกิด Overfitting หากไม่ระมัดระวัง: แม้ Ensemble จะช่วยลด Overfitting ได้ แต่หากตั้งค่าไม่เหมาะสม หรือโมเดลพื้นฐานมีความหลากหลายไม่เพียงพอ ก็ยังสามารถเกิด Overfitting ได้ โดยเฉพาะกับ Boosting ที่อาจเรียนรู้ noise ในข้อมูลมากเกินไป
ควรเลือกใช้เทคนิค Ensemble แบบใดดี?
การเลือกเทคนิค Ensemble ที่เหมาะสมขึ้นอยู่กับหลายปัจจัย เช่น ลักษณะของข้อมูล ปัญหาที่ต้องการแก้ไข ทรัพยากรที่มี และข้อจำกัดด้านเวลา
- Bagging (เช่น Random Forest): เหมาะสำหรับลดความแปรปรวนและป้องกัน Overfitting โดยเฉพาะเมื่อโมเดลพื้นฐานมีความซับซ้อนสูง ทำงานได้ดีกับข้อมูลจำนวนมากและมี features หลากหลาย
- Boosting (เช่น XGBoost, LightGBM): เหมาะสำหรับงานที่ต้องการความแม่นยำสูงมาก มักจะให้ผลลัพธ์ที่ดีที่สุด แต่ต้องระมัดระวังเรื่อง Overfitting และใช้เวลาในการปรับจูน hyperparameters มากกว่า
- Stacking: เหมาะสำหรับงานที่ต้องการประสิทธิภาพสูงสุด และมีเวลา/ทรัพยากรในการทดลองและสร้างโมเดลที่ซับซ้อน มักใช้ในการแข่งขัน Machine Learning
- Voting: เป็นวิธีที่ง่ายและรวดเร็วในการเริ่มต้น หากต้องการรวมผลจากโมเดลที่มีอยู่แล้ว
โดยทั่วไป แนะนำให้ทดลองกับเทคนิคหลายๆ แบบและประเมินผลด้วย Cross-Validation เพื่อหาเทคนิคที่ให้ผลลัพธ์ดีที่สุดสำหรับปัญหาเฉพาะของคุณ
จำเป็นต้องใช้โมเดลพื้นฐาน (base learners) ประเภทเดียวกันใน Ensemble หรือไม่?
ไม่จำเป็นเสมอไป Ensemble สามารถแบ่งได้เป็น 2 ประเภทตามลักษณะของโมเดลพื้นฐาน:
- Homogeneous Ensembles: ใช้โมเดลพื้นฐานประเภทเดียวกันทั้งหมด เช่น Random Forest ที่ใช้ Decision Trees ทั้งหมด หรือ AdaBoost ที่มักใช้ Decision Stumps ทั้งหมด
- Heterogeneous Ensembles: ใช้โมเดลพื้นฐานจากอัลกอริทึมที่แตกต่างกัน เช่น Stacking ที่อาจรวมผลจาก Support Vector Machine, K-Nearest Neighbors, และ Neural Network เข้าด้วยกัน
การใช้ Heterogeneous Ensembles ในเทคนิคอย่าง Stacking หรือ Voting สามารถช่วยเพิ่มความหลากหลาย (diversity) ให้กับ Ensemble ได้มากยิ่งขึ้น ซึ่งมักจะนำไปสู่ประสิทธิภาพที่ดีขึ้น เนื่องจากโมเดลต่างประเภทกันมักจะเรียนรู้รูปแบบที่แตกต่างกันในข้อมูลและทำข้อผิดพลาดในลักษณะที่ไม่เหมือนกัน
คำแนะนำสำหรับการค้นคว้าเพิ่มเติม
หากคุณสนใจที่จะเรียนรู้เพิ่มเติมเกี่ยวกับ Ensemble Learning และเทคนิคที่เกี่ยวข้อง ลองค้นหาข้อมูลด้วยคำค้นหาเหล่านี้:
- การเปรียบเทียบประสิทธิภาพระหว่าง Bagging Boosting และ Stacking ในสถานการณ์ต่างๆ เป็นอย่างไร?
- วิธีการปรับ Hyperparameters ใน Random Forest และ XGBoost เพื่อให้ได้ประสิทธิภาพสูงสุดคืออะไร?
- มีตัวอย่างการประยุกต์ใช้ Ensemble Learning ในการวิเคราะห์ข้อมูลทางการแพทย์อย่างไรบ้าง?
- เทคนิคใดบ้างที่ใช้ในการสร้างความหลากหลาย (Diversity) ให้กับ Base Learners ใน Ensemble เพื่อปรับปรุงผลลัพธ์?
แหล่งอ้างอิง
Last updated May 9, 2025