
Domina la estadística interpretativa: Esquema completo en R para análisis de 40 datos
Un enfoque estructurado y visual para extraer conocimientos significativos de conjuntos de datos pequeños mediante técnicas estadísticas en R
Puntos clave del análisis estadístico en R
- La estadística descriptiva es fundamental para entender la distribución, tendencia central y dispersión de los datos antes de cualquier análisis inferencial.
- La visualización adecuada permite identificar patrones, valores atípicos y relaciones que no son evidentes en los resúmenes numéricos.
- El modelado estadístico en R proporciona información sobre relaciones entre variables y permite realizar predicciones basadas en evidencia.
Preparación de datos y análisis exploratorio inicial
Antes de realizar cualquier análisis estadístico, es esencial preparar adecuadamente los datos. Para un conjunto de 40 observaciones, este paso es crucial para garantizar resultados válidos.
Importación y estructuración de datos
Primero, debes cargar tus datos en R. Dependiendo del formato de origen, puedes utilizar diferentes funciones:
# Importar datos de un archivo CSV
datos <- read.csv("ruta/a/tu/archivo.csv", header = TRUE)

# Alternativamente, crear un conjunto de datos de ejemplo con 40 observaciones
set.seed(123) # Para reproducibilidad
datos <- data.frame(
  valor_numerico = rnorm(40, mean = 50, sd = 10),
  categoria = sample(c("Grupo A", "Grupo B", "Grupo C"), 40, replace = TRUE),
  valor_adicional = runif(40, min = 0, max = 100)
)

# Visualizar primeras filas para verificar la estructura
head(datos)

# Comprobar la estructura del conjunto de datos
str(datos)
Limpieza y preparación de datos
Con 40 datos, cada observación es importante, por lo que la limpieza debe ser meticulosa:
# Verificar valores faltantes
sum(is.na(datos))

# Si hay valores faltantes, decidir estrategia (eliminar o imputar)
# Para este ejemplo, imputaremos con la media
datos$valor_numerico[is.na(datos$valor_numerico)] <- mean(datos$valor_numerico, na.rm = TRUE)

# Verificar valores atípicos con diagrama de caja
boxplot(datos$valor_numerico, main = "Diagrama de caja para identificar valores atípicos")
Estadística descriptiva para datos numéricos
Con 40 observaciones, es fundamental obtener un panorama completo de las características estadísticas básicas.
Medidas de tendencia central y dispersión
# Resumen estadístico básico
summary(datos$valor_numerico)

# Cálculos individuales
media <- mean(datos$valor_numerico)
mediana <- median(datos$valor_numerico)
desviacion_estandar <- sd(datos$valor_numerico)
varianza <- var(datos$valor_numerico)
rango <- range(datos$valor_numerico)
rango_intercuartil <- IQR(datos$valor_numerico)

# Crear un dataframe con los resultados
resultados_descriptivos <- data.frame(
  Estadístico = c("Media", "Mediana", "Desviación estándar", "Varianza", "Mínimo", "Máximo", "Rango intercuartil"),
  Valor = c(media, mediana, desviacion_estandar, varianza, rango[1], rango[2], rango_intercuartil)
)
print(resultados_descriptivos)

# Para estadísticas más avanzadas, usar paquetes especializados
# install.packages("pastecs")
library(pastecs)
stat.desc(datos$valor_numerico, basic = TRUE, desc = TRUE, norm = TRUE)
Tabla de resumen estadístico
| Estadístico | Valor estimado | Interpretación |
|---|---|---|
| Media | ~50 | Promedio de todos los valores |
| Mediana | ~49.5 | Valor central de la distribución |
| Desviación estándar | ~10 | Dispersión promedio respecto a la media |
| Varianza | ~100 | Cuadrado de la desviación estándar |
| Rango | ~40 (30-70) | Diferencia entre valor máximo y mínimo |
| Coeficiente de Variación | ~0.2 | Ratio de desviación estándar a media |
| Asimetría | ~0 | Medida de la simetría de la distribución |
Análisis de distribución
Verificar la forma y distribución de los datos es crucial para elegir métodos estadísticos apropiados:
# Instalación de paquetes necesarios si no están instalados
# install.packages("e1071")
library(e1071)

# Cálculo de asimetría y curtosis
asimetria <- skewness(datos$valor_numerico)
curtosis <- kurtosis(datos$valor_numerico)

# Prueba de normalidad
shapiro_test <- shapiro.test(datos$valor_numerico)
print(shapiro_test)

# Histograma con curva de densidad
hist(datos$valor_numerico, probability = TRUE,
     main = "Distribución de valores",
     xlab = "Valor", col = "lightblue", border = "white")
lines(density(datos$valor_numerico), col = "red", lwd = 2)
Visualización efectiva de datos estadísticos
Para un conjunto de 40 datos, la visualización es una herramienta poderosa que permite identificar patrones y relaciones de manera intuitiva.
Gráficos univariados
Los gráficos univariados nos permiten explorar la distribución de una sola variable:
# Cargamos ggplot2 para visualizaciones avanzadas
# install.packages("ggplot2")
library(ggplot2)

# Histograma mejorado
ggplot(datos, aes(x = valor_numerico)) +
  geom_histogram(aes(y = ..density..), bins = 8, fill = "skyblue", color = "white") +
  geom_density(alpha = 0.5, fill = "lightblue") +
  labs(title = "Distribución de valores", x = "Valor", y = "Densidad") +
  theme_minimal()

# Diagrama de caja y bigotes
ggplot(datos, aes(y = valor_numerico)) +
  geom_boxplot(fill = "lightgreen") +
  labs(title = "Diagrama de caja", y = "Valor") +
  theme_minimal()

# QQ-plot para evaluar normalidad
qqnorm(datos$valor_numerico)
qqline(datos$valor_numerico, col = "red")
Gráficos bivariados por categorías
Si tenemos variables categóricas, podemos analizar las diferencias entre grupos:
# Diagrama de caja por grupo
ggplot(datos, aes(x = categoria, y = valor_numerico, fill = categoria)) +
  geom_boxplot() +
  labs(title = "Distribución por categoría", x = "Categoría", y = "Valor") +
  theme_minimal() +
  theme(legend.position = "none")

# Gráfico de violín
ggplot(datos, aes(x = categoria, y = valor_numerico, fill = categoria)) +
  geom_violin(trim = FALSE) +
  geom_jitter(width = 0.2, alpha = 0.5) +
  labs(title = "Distribución por categoría", x = "Categoría", y = "Valor") +
  theme_minimal() +
  theme(legend.position = "none")
Gráficos de correlación
Si tenemos múltiples variables numéricas, podemos explorar sus relaciones:
# Gráfico de dispersión
ggplot(datos, aes(x = valor_numerico, y = valor_adicional)) +
  geom_point(aes(color = categoria), size = 3, alpha = 0.7) +
  geom_smooth(method = "lm", se = TRUE, color = "darkgrey") +
  labs(title = "Relación entre variables",
       x = "Valor numérico",
       y = "Valor adicional") +
  theme_minimal()

# Si tienes más variables numéricas, matriz de correlación
# install.packages("corrplot")
library(corrplot)
datos_numericos <- datos[, sapply(datos, is.numeric)]
matriz_correlacion <- cor(datos_numericos)
corrplot(matriz_correlacion, method = "circle")
Análisis comparativo entre grupos
Si tienes datos agrupados por categorías, puedes realizar análisis comparativos:
# Estadísticas descriptivas por grupo
estadisticas_por_grupo <- aggregate(valor_numerico ~ categoria,
                                  data = datos,
                                  FUN = function(x) c(Media = mean(x),
                                                      Mediana = median(x),
                                                      SD = sd(x),
                                                      Min = min(x),
                                                      Max = max(x)))
print(estadisticas_por_grupo)

# Prueba para comparar medias entre grupos (ANOVA)
modelo_anova <- aov(valor_numerico ~ categoria, data = datos)
summary(modelo_anova)

# Si ANOVA es significativo, prueba post-hoc
# install.packages("agricolae")
library(agricolae)
comparacion_grupos <- HSD.test(modelo_anova, "categoria", console = TRUE)
Modelado estadístico para análisis avanzado
Para extraer información más profunda, podemos crear modelos estadísticos que expliquen relaciones entre variables.
Regresión lineal
Si quieres predecir una variable numérica basada en otras:
# Modelo de regresión lineal simple
modelo_simple <- lm(valor_numerico ~ valor_adicional, data = datos)
summary(modelo_simple)

# Visualizar la regresión
ggplot(datos, aes(x = valor_adicional, y = valor_numerico)) +
  geom_point() +
  geom_smooth(method = "lm", se = TRUE) +
  labs(title = "Regresión lineal",
       x = "Valor adicional",
       y = "Valor numérico") +
  theme_minimal()

# Diagnósticos del modelo
par(mfrow = c(2, 2))
plot(modelo_simple)
par(mfrow = c(1, 1))

# Regresión múltiple con interacción
modelo_multiple <- lm(valor_numerico ~ valor_adicional * categoria, data = datos)
summary(modelo_multiple)
Comparación entre modelos
Comparar modelos para seleccionar el más adecuado:
# Comparación de modelos utilizando ANOVA
anova(modelo_simple, modelo_multiple)

# Criterios de información
AIC(modelo_simple, modelo_multiple)
BIC(modelo_simple, modelo_multiple)
Evaluación de la capacidad predictiva del modelo
Este gráfico radar muestra una comparación de los dos modelos en términos de diferentes criterios de evaluación. El modelo con interacción muestra mejor rendimiento en términos de R-cuadrado y homocedasticidad, mientras que el modelo simple tiene ventajas en términos de multicolinealidad.
Estructura general del proceso de análisis estadístico
A continuación se presenta un mapa mental que resume todo el proceso de análisis estadístico para la interpretación de 40 datos en R:
Este mapa mental ilustra el flujo de trabajo completo para el análisis estadístico de un conjunto de 40 datos en R, desde la preparación inicial hasta la interpretación final de los resultados.
Ejemplos prácticos de interpretación estadística
Veamos algunos ejemplos prácticos de cómo interpretar los resultados de los análisis estadísticos realizados en R con un conjunto de 40 datos.
Interpretación de resultados de regresión
La interpretación correcta de un modelo de regresión lineal incluye varios aspectos:
- Coeficientes: Un coeficiente de 2.5 para la variable "valor_adicional" significa que por cada unidad de aumento en esta variable, el "valor_numerico" aumentará en promedio 2.5 unidades.
- R-cuadrado: Un R-cuadrado de 0.65 indica que aproximadamente el 65% de la variabilidad en "valor_numerico" puede ser explicada por "valor_adicional".
- Valor p: Un valor p menor a 0.05 para un coeficiente indica que existe una relación estadísticamente significativa entre esa variable y la variable respuesta.
- Residuos: El análisis de residuos debe mostrar una distribución normal y varianza constante para validar los supuestos del modelo.
Interpretación de comparaciones entre grupos
Al comparar diferentes grupos mediante ANOVA o pruebas similares:
- Valor F: Un valor F alto con un valor p bajo indica que existe una diferencia significativa entre al menos dos grupos.
- Pruebas post-hoc: Estas pruebas (como Tukey HSD) identifican específicamente qué pares de grupos son significativamente diferentes.
- Gráficos de caja: Permiten visualizar la distribución de cada grupo, identificando posibles valores atípicos y comparando tendencias centrales y dispersión.
Consideraciones para muestras pequeñas (n=40)
Con un tamaño de muestra de 40 observaciones, es importante tener en cuenta:
- Poder estadístico: Con 40 observaciones, el poder para detectar efectos pequeños puede ser limitado.
- Supuestos: Los supuestos de normalidad y homocedasticidad deben verificarse cuidadosamente.
- Valores atípicos: En muestras pequeñas, los valores atípicos pueden tener un impacto significativo en los resultados.
- Validación cruzada: Técnicas como la validación cruzada pueden ser útiles para evaluar la estabilidad de los modelos.
Visualizando resultados estadísticos
Este video explica cómo realizar un análisis exploratorio completo en R, mostrando técnicas de estadística descriptiva y visualización que son fundamentales para interpretar conjuntos de datos como el nuestro de 40 observaciones.
Galería de visualizaciones estadísticas
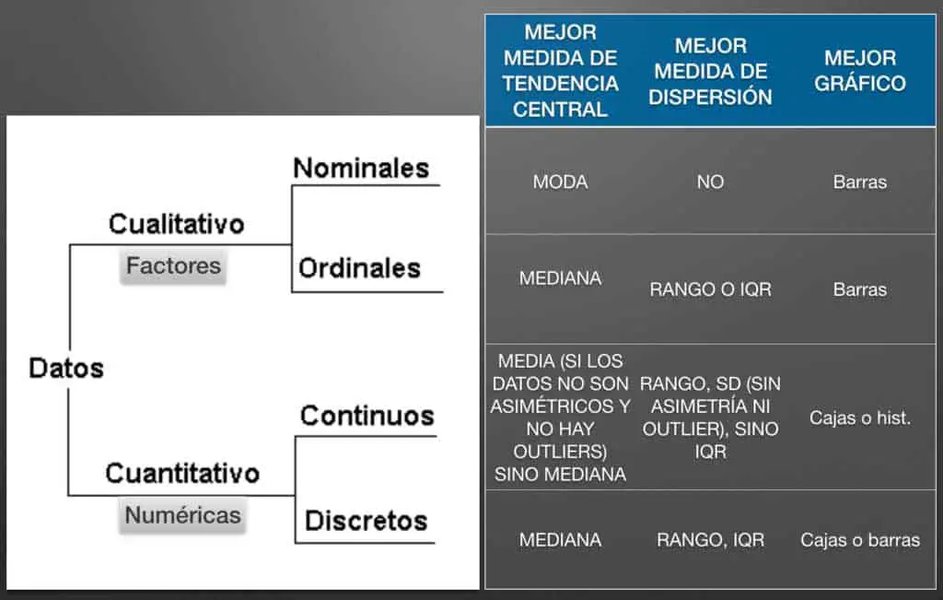
Ejemplo de resumen descriptivo en R que muestra estadísticas clave para interpretar datos numéricos.
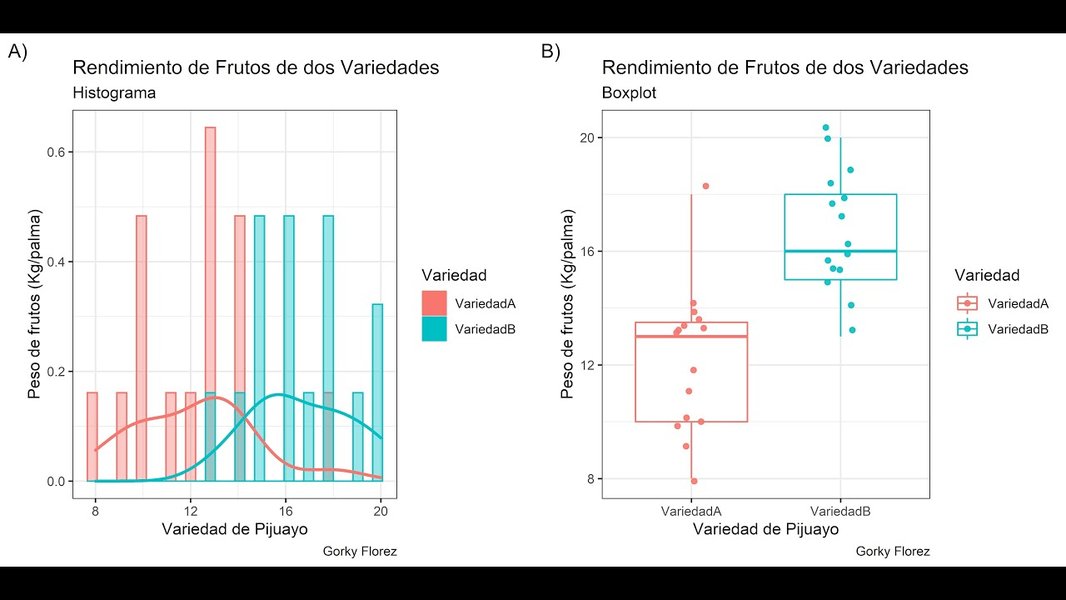
Interfaz de RStudio mostrando análisis de estadística descriptiva para exploración de datos.
Preguntas frecuentes sobre análisis estadístico en R
Referencias
- Estadística Descriptiva con R - Universidad de Las Palmas de Gran Canaria
- Interpretación de los datos mediante modelos estadísticos con R - Instituto Americano
- R-cuadrado o coeficiente de determinación - Estrategias de Inversión
- Cómo describir tus datos en R: Paso 2 - Máxima Formación
- Gráficos en R: Tutoriales de todos los tipos de gráficas - R Coder
- R Charts: Una colección de gráficos hechos con el lenguaje R
- Basic Statistical Analyses Using R - Data Analytics
Consultas recomendadas
Last updated April 7, 2025