
Ranqueamento de Features em Datasets Temporais Com Alta Dimensionalidade
Estratégias Eficazes para Avaliar a Importância das Features em Dados Dependentes no Tempo
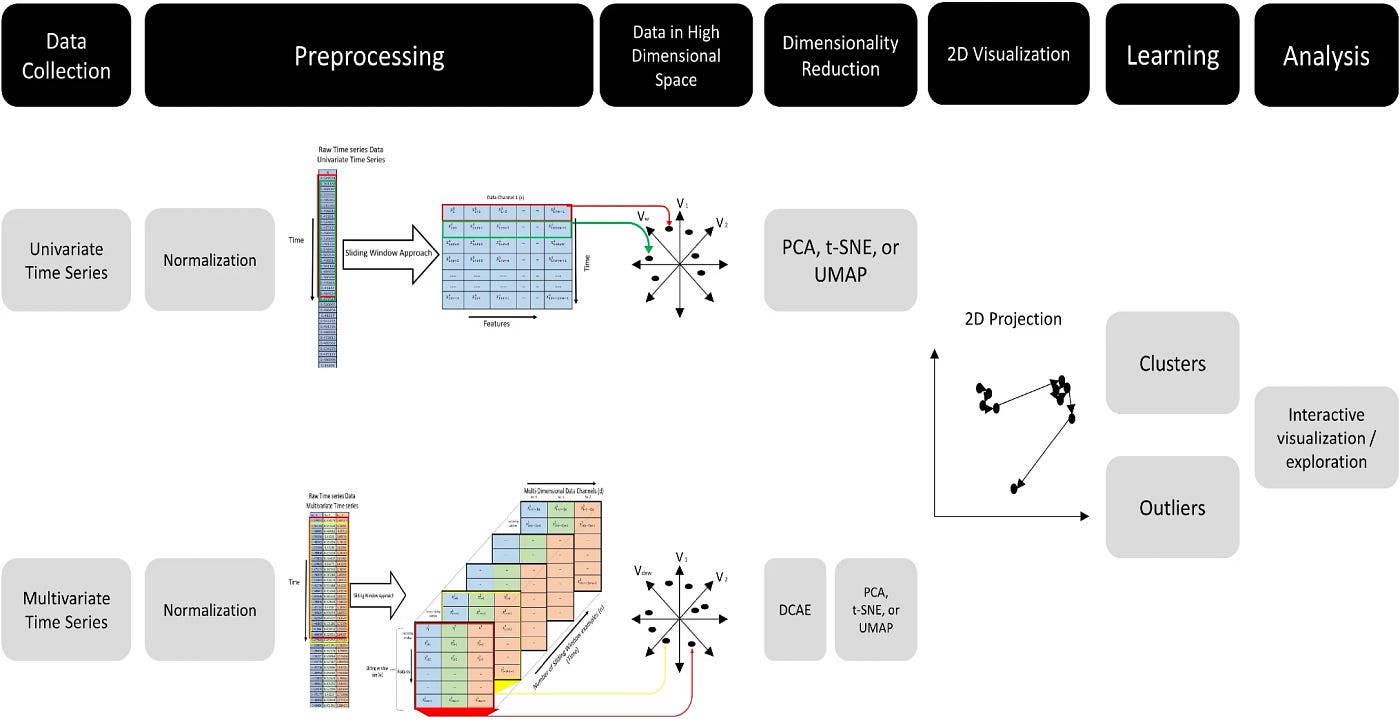
Principais Aspectos a Considerar
- Uso de Modelos de Machine Learning Robustas: Métodos como Random Forest e Gradient Boosting são apropriados para dados com dependência temporal e alta dimensionalidade.
- Consideração da Estrutura Temporal: Técnicas específicas para séries temporais, como LSTM ou análise de componentes independentes, melhoram a precisão na avaliação das features.
- Validação e Redução de Dimensionalidade: Implementar validação temporal e métodos de redução de dimensionalidade como PCA garante resultados mais confiáveis e interpretáveis.
1. Entendimento da Dependência Temporal
Em datasets onde as amostras possuem dependência temporal, é crucial utilizar métodos que considerem essa estrutura. A dependência temporal implica que as amostras não são independentes, o que pode afetar a eficácia de técnicas tradicionais como ANOVA. Para lidar com essa característica, é recomendável modelar a dependência temporal antes de proceder com o ranqueamento das features.
1.1. Modelagem da Dependência Temporal
Técnicas como embeddings temporais, utilizando janelas deslizantes, ou transformar os dados em séries temporais estacionárias, facilitam a análise. Também é possível aplicar métodos de bloqueio, como "block bootstrapping" ou "block permutation", para ajustar a dependência temporal nos dados.
1.2. Ferramentas e Bibliotecas Recomendadas
- Python: Bibliotecas como
statsmodelspara modelagem de séries temporais etsfreshpara extração de features temporais. - R: Pacotes como
careterandomForestadaptados para dados temporais.
2. Métodos de Ranqueamento de Features
Para ranquear as features de forma eficaz em um contexto de alta dimensionalidade e dependência temporal, diversas abordagens podem ser adotadas. A seguir, são detalhadas as principais técnicas recomendadas:
2.1. Modelos Baseados em Machine Learning
2.1.1. Random Forest
- O Random Forest é robusto em relação à dependência temporal e fornece métricas automáticas de importância das features com base na redução de impureza ao longo das árvores.
- É adequado para classificação multiclasse, como no seu caso com 8 classes diferentes.
- Implementação básica em Python:
import pandas as pd
from sklearn.ensemble import RandomForestClassifier
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score

# Carregar o dataset
df = pd.read_csv('seu_dataset.csv')

# Separar features e alvo
X = df.drop('classe', axis=1)
y = df['classe']

# Dividir em treino e teste
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)

# Treinar o modelo
rf = RandomForestClassifier(n_estimators=100, random_state=42)
rf.fit(X_train, y_train)

# Avaliar o modelo
y_pred = rf.predict(X_test)
print(f"Acurácia: {accuracy_score(y_test, y_pred)}")

# Importância das features
feature_importances = rf.feature_importances_
for feature, importance in zip(X.columns, feature_importances):
    print(f"{feature}: {importance:.3f}")
2.1.2. Gradient Boosting Machines (XGBoost, LightGBM)
- Modelos de boosting incremental oferecem alta precisão e também fornecem métricas de importância das features.
- São particularmente eficazes em datasets de alta dimensionalidade.
2.1.3. Redes Neurais Recorrentes (LSTM, GRU)
- Modelos como LSTM (Long Short-Term Memory) e GRU (Gated Recurrent Unit) são adequados para capturar dependências temporais complexas.
- Permitem a extração da relevância das features através da análise dos pesos das camadas correspondentes.
2.2. Métodos Estatísticos Adaptados
2.2.1. Informação Mútua (Mutual Information)
- Mede a quantidade de informação que uma feature oferece sobre as classes de saída, sendo eficaz em datasets não-lineares.
- Mais robusto em relação à independência entre as amostras.
2.2.2. F-Score Estatístico por Grupo
- Variantes multivariadas que consideram correlações entre features, adaptadas para dados temporais.
2.3. Métodos Wrapper
- Recursive Feature Elimination (RFE): Elimina iterativamente features menos relevantes, baseando-se no desempenho do modelo.
- Combina eficientemente com modelos como SVM ou Random Forest para avaliar a importância das features.
2.4. Métodos de Redução de Dimensionalidade
- Análise de Componentes Principais (PCA): Reduz a dimensionalidade mantendo a maior variação dos dados, facilitando a visualização e interpretação.
- PCA Esparso ou Variantes Supervisionadas: Consideram a relação das features com as classes, melhorando a interpretabilidade.
3. Implementação Prática
Para aplicar as técnicas de ranqueamento de features de forma eficiente no seu dataset, siga os passos abaixo:
3.1. Pré-Processamento dos Dados
- Normalize ou padronize as features utilizando métodos como z-score scaling para garantir que todas as features estejam na mesma escala.
- Trate valores faltantes, seja removendo-os ou imputando com técnicas adequadas.
3.2. Divisão dos Dados
- Considere a estrutura temporal ao dividir o dataset em conjuntos de treino e teste. Utilize métodos como Time Series Cross Validation para preservar a sequência temporal.
3.3. Modelagem e Ranqueamento das Features
- Selecione um modelo robusto, como Random Forest ou Gradient Boosting, e treine-o com o conjunto de treino.
- Extraia a importância das features utilizando métricas internas do modelo ou técnicas como SHAP para interpretação pós-modelagem.
- Utilize métodos estatísticos, como Informação Mútua, para complementar a avaliação de importância das features.
- Valide os resultados utilizando técnicas de validação temporal para assegurar a consistência dos rankings gerados.
3.4. Validação e Interpretação
Após ranquear as features, é essencial validar a relevância das mesmas através de métodos como cross-validation que respeitem a ordem temporal dos dados. Ferramentas como SHAP podem ser utilizadas para interpretar o impacto individual de cada feature no modelo de classificação.
4. Ferramentas e Bibliotecas Recomendadas
Para implementar as técnicas mencionadas, as seguintes ferramentas e bibliotecas são altamente recomendadas:
- Python:
scikit-learn: Para modelos de Random Forest, PCA, e métodos de seleção de features.xgboost,lightgbm: Para implementar Gradient Boosting.shap,lime: Para interpretação de modelos e análise de importância das features.tsfresh: Para extração e seleção de features específicas de séries temporais.
- R:
-
caret,randomForest,e1071: Para modelos de classificação e seleção de features. -
statsmodels: Para modelagem de séries temporais e análise de modelos mistos.
-
5. Considerações Finais
O ranqueamento de features em datasets temporais complexos demanda uma abordagem multifacetada que considere tanto a alta dimensionalidade quanto a dependência temporal das amostras. Utilizar modelos de machine learning robustos, complementados por métodos estatísticos adaptados para dados temporais, garante uma avaliação precisa da importância das features. Além disso, a implementação de validações temporais e técnicas de redução de dimensionalidade aumenta a confiabilidade e interpretabilidade dos resultados obtidos.
Referências
Last updated January 27, 2025