
วิวัฒนาการไม่สิ้นสุด: เจาะลึกอนาคตโมเดลภาษาขนาดใหญ่ (LLMs) หลังยุค GPT-4.1
ค้นพบทิศทางการพัฒนา LLMs ที่จะเปลี่ยนโลกเทคโนโลยีและการใช้ชีวิตของเราอย่างที่ไม่เคยเป็นมาก่อน
ประเด็นสำคัญที่คุณจะได้ค้นพบ:
- ความสามารถรอบด้านยิ่งขึ้น: การพัฒนาสู่โมเดลที่ประมวลผลข้อมูลได้หลากหลายรูปแบบ (Multimodal) ทั้งข้อความ ภาพ เสียง และวิดีโอ พร้อมความเข้าใจบริบทที่ลึกซึ้งกว่าเดิม
- สมองกลอัจฉริยะ: ก้าวสู่โมเดลการให้เหตุผลขนาดใหญ่ (Large Reasoning Models - LRMs) ที่สามารถคิดวิเคราะห์และแก้ปัญหาซับซ้อนได้ใกล้เคียงมนุษย์มากขึ้น และการปรับแต่งโมเดลให้เชี่ยวชาญเฉพาะทาง
- ประสิทธิภาพและการเข้าถึง: แนวโน้มการสร้างโมเดลที่ทรงพลังแต่ใช้ทรัพยากรน้อยลง การขยายหน้าต่างบริบท (Context Window) ควบคู่ไปกับการเติบโตของโมเดลโอเพนซอร์ส และการให้ความสำคัญกับจริยธรรมและความปลอดภัย
การมาถึงของ GPT-4.1 ได้จุดประกายการพัฒนาโมเดลภาษาขนาดใหญ่ (Large Language Models - LLMs) ให้ก้าวหน้าไปอีกขั้นอย่างรวดเร็ว โดย GPT-4.1 เองได้แสดงให้เห็นถึงการปรับปรุงที่สำคัญในด้านการเขียนโค้ด การปฏิบัติตามคำสั่งที่ซับซ้อน และการจัดการกับบริบทข้อมูลที่ยาวนานขึ้น สิ่งเหล่านี้ล้วนเป็นรากฐานสำคัญที่ส่งผลต่อทิศทางการพัฒนา LLMs ในอนาคตอย่างมีนัยสำคัญ บทความนี้จะพาคุณเจาะลึกถึงแนวโน้มที่น่าจับตามอง ซึ่งจะกำหนดภูมิทัศน์ของเทคโนโลยีปัญญาประดิษฐ์ในอีกไม่กี่ปีข้างหน้า โดยอ้างอิงข้อมูลล่าสุด ณ วันที่ 18 พฤษภาคม 2025
หัวใจแห่งการเปลี่ยนแปลง: GPT-4.1 และหมุดหมายสู่อนาคต
GPT-4.1 ไม่เพียงแต่เป็นโมเดลที่ทรงพลังมากขึ้นเท่านั้น แต่ยังเป็นตัวเร่งให้เกิดนวัตกรรมใหม่ๆ ในวงการ LLMs โดยเฉพาะอย่างยิ่งความสามารถที่เพิ่มขึ้นในการทำความเข้าใจและสร้างสรรค์เนื้อหาที่เกี่ยวข้องกับการเขียนโปรแกรม การวิเคราะห์ข้อมูล และการให้เหตุผลเชิงตรรกะ การพัฒนานี้ชี้ให้เห็นว่า LLMs ในอนาคตจะมุ่งเน้นไปที่การเพิ่มความแม่นยำ ความสามารถในการจัดการกับความซับซ้อน และการประยุกต์ใช้ในโลกแห่งความเป็นจริงที่หลากหลายยิ่งขึ้น
แกะรอยอนาคต: 10 แนวโน้มสำคัญในการพัฒนา LLMs
จากความก้าวหน้าของ GPT-4.1 และการวิจัยพัฒนาอย่างต่อเนื่อง เราสามารถสรุปแนวโน้มสำคัญที่จะขับเคลื่อนอนาคตของ LLMs ได้ดังนี้:
1. การทะยานสู่ความสามารถแบบพหุประสาทสัมผัส (Enhanced Multimodal Capabilities)
การหลอมรวมข้อมูลหลากมิติ
LLMs จะไม่ได้จำกัดอยู่แค่การประมวลผลข้อความอีกต่อไป แต่จะพัฒนาสู่การเป็นโมเดลแบบมัลติโมดัล (Multimodal LLMs) ที่สามารถทำความเข้าใจ สร้าง และโต้ตอบกับข้อมูลหลากหลายรูปแบบพร้อมกัน ไม่ว่าจะเป็น ข้อความ รูปภาพ เสียง หรือแม้แต่วิดีโอ ตัวอย่างเช่น โมเดลอย่าง GPT-4V และ Gemini ได้แสดงให้เห็นถึงศักยภาพในการวิเคราะห์ภาพและตอบคำถามจากภาพนั้นๆ ได้แล้ว ในอนาคต ความสามารถนี้จะถูกยกระดับให้ซับซ้อนและบูรณาการอย่างไร้รอยต่อยิ่งขึ้น เปิดประตูสู่การใช้งานในรูปแบบใหม่ๆ เช่น การวิเคราะห์ข้อมูลทางการแพทย์ที่รวมทั้งภาพสแกนและประวัติผู้ป่วย การสร้างสรรค์เนื้อหาสื่อผสมที่สมจริง หรือระบบผู้ช่วยอัจฉริยะที่สามารถมองเห็นและได้ยินสภาพแวดล้อมได้
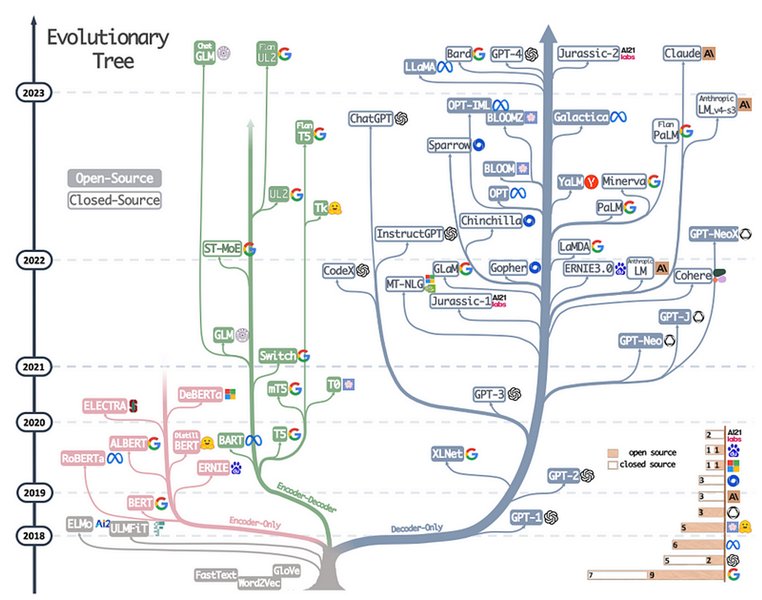
ภาพแสดงโครงสร้างพื้นฐานของโมเดลภาษาขนาดใหญ่ ซึ่งเป็นรากฐานของการพัฒนาสู่ความสามารถแบบมัลติโมดัล
2. กำเนิด "นักคิด": การพัฒนาสู่โมเดลการให้เหตุผลขนาดใหญ่ (Large Reasoning Models - LRMs)
จาก "โทเค็น" สู่ "แนวคิด"
ก้าวต่อไปที่สำคัญของ LLMs คือการพัฒนาไปสู่ "โมเดลการให้เหตุผลขนาดใหญ่" (Large Reasoning Models - LRMs) แนวคิดนี้มุ่งเน้นให้ AI สามารถทำงานบน "แนวคิด" (ideas) ซึ่งเป็นหน่วยพื้นฐานของการคิดและสามัญสำนึกของมนุษย์ แทนที่จะเป็นเพียง "โทเค็น" (tokens) หรือคำศัพท์แบบเดิมๆ เป้าหมายคือเพื่อให้ LRMs สามารถเลียนแบบกระบวนการให้เหตุผลของมนุษย์ได้อย่างมีประสิทธิภาพมากขึ้น สามารถทำการอนุมานที่ซับซ้อน การวางแผนหลายขั้นตอน การแก้ปัญหาที่ต้องการความเข้าใจเชิงลึก และการหักล้างอย่างมีตรรกะ เทคนิคอย่าง "ความสนใจตามแนวคิด" (Idea-Based Attention) และการบูรณาการสามัญสำนึก (Common Sense Integration) จะเป็นหัวใจสำคัญในการพัฒนา LRMs ให้สามารถให้เหตุผลได้อย่างละเอียดอ่อนและแม่นยำยิ่งขึ้น
3. ความเชี่ยวชาญเฉพาะทาง: LLMs ที่ออกแบบมาเพื่องานเฉพาะด้าน (Specialized Domain LLMs)
โมเดลที่ตอบโจทย์อย่างตรงจุด
นอกเหนือจากการพัฒนา LLMs ที่มีความสามารถทั่วไป (General-purpose) แล้ว แนวโน้มที่ชัดเจนคือการสร้างโมเดลที่ได้รับการปรับแต่งและฝึกฝนให้มีความเชี่ยวชาญในโดเมนเฉพาะทางมากขึ้น เช่น C2S-Scale ซึ่งเป็นโมเดลภาษาชีววิทยาขนาดใหญ่ที่สามารถตอบคำถามเกี่ยวกับการวิเคราะห์เซลล์เดี่ยวและการให้เหตุผลทางชีววิทยา หรือโมเดลที่ออกแบบมาสำหรับงานด้านการแพทย์ กฎหมาย วิศวกรรม การเงิน หรือการผลิตโดยเฉพาะ การมีความเชี่ยวชาญเฉพาะทางจะช่วยเพิ่มความแม่นยำ ลดความเสี่ยงจากข้อมูลที่ไม่เกี่ยวข้อง และสร้างคุณค่าที่สูงขึ้นในการประยุกต์ใช้งานจริงในแต่ละอุตสาหกรรม
4. ขยายขอบเขตความจำ: หน้าต่างบริบทที่กว้างขึ้น (Context Window Expansion)
ความต่อเนื่องและความเข้าใจที่ยาวนาน
หนึ่งในข้อจำกัดของ LLMs รุ่นก่อนคือขนาดของ "หน้าต่างบริบท" (Context Window) หรือปริมาณข้อมูลที่โมเดลสามารถจดจำและนำมาใช้ในการประมวลผลในแต่ละครั้งได้ แนวโน้มในอนาคตคือการขยายหน้าต่างบริบทนี้ให้ใหญ่ขึ้นอย่างมาก ตัวอย่างเช่น มีการพัฒนาโมเดลที่สามารถจดจำข้อมูลในอดีตได้ถึงระดับหลายล้านโทเค็น (เช่น Llama 4 Scout ที่ถูกกล่าวถึงว่าอาจมี context window ถึง 10 ล้านโทเค็น) ซึ่งจะช่วยให้ LLMs สามารถจัดการกับบทสนทนาที่ยาวนาน เอกสารขนาดใหญ่ หรือชุดข้อมูลที่ซับซ้อนได้อย่างมีประสิทธิภาพมากขึ้น สามารถรักษาความต่อเนื่องของเนื้อหาและเข้าใจความเชื่อมโยงของข้อมูลในระยะยาวได้ดีขึ้น เทคโนโลยีอย่าง CacheGen ก็มีส่วนช่วยในการจัดการบริบทที่ยาวนานและรวมแหล่งความรู้หลายแห่งเข้าด้วยกัน
5. ประสิทธิภาพที่เหนือกว่า: การเพิ่มสมรรถนะและลดการใช้ทรัพยากร (Improved Performance & Efficiency)
ฉลาดขึ้น เร็วขึ้น และเข้าถึงง่ายขึ้น
การพัฒนา LLMs จะมุ่งเน้นไปที่การเพิ่มประสิทธิภาพการประมวลผลให้รวดเร็วยิ่งขึ้น ลดความหน่วง (latency) และลดการใช้ทรัพยากรในการฝึกฝนและการอนุมาน (inference) ซึ่งรวมถึงการพัฒนาโมเดลที่มีขนาดเล็กลงแต่ยังคงประสิทธิภาพสูง (Smaller, Efficient Models) เพื่อให้สามารถนำไปใช้งานบนอุปกรณ์ที่มีข้อจำกัดด้านทรัพยากร เช่น สมาร์ทโฟน หรืออุปกรณ์ IoT ได้ เทคนิคการเรียนรู้แบบ Few-shot และ Zero-shot Learning ที่พัฒนาขึ้นจะช่วยลดความต้องการชุดข้อมูลขนาดใหญ่และการคำนวณที่สูงในการฝึกโมเดล ทำให้การปรับใช้โมเดลสำหรับงานเฉพาะทางทำได้ง่ายและรวดเร็วขึ้น นอกจากนี้ การใช้ข้อมูลสังเคราะห์ (Synthetic Data) ในการฝึกฝนก็เป็นอีกแนวทางหนึ่งที่ช่วยเพิ่มประสิทธิภาพและลดต้นทุน
6. พลังแห่งความร่วมมือ: ระบบหลายเอเจนต์อัจฉริยะ (Multi-Agent Systems)
การทำงานร่วมกันเพื่อเป้าหมายที่ซับซ้อน
แนวคิดเรื่องการใช้ AI หลายตัว (agents) ที่ทำงานร่วมกันกำลังได้รับความสนใจอย่างมาก เฟรมเวิร์กเช่น AutoGen ของ Microsoft เป็นตัวอย่างของการสร้างแอปพลิเคชันที่ใช้ LLMs หลายตัวทำงานร่วมกัน แต่ละเอเจนต์อาจมีความเชี่ยวชาญที่แตกต่างกัน และสามารถสื่อสาร โต้แย้ง แบ่งปันข้อมูล และร่วมกันตัดสินใจเพื่อแก้ไขปัญหาที่ซับซ้อน หรือสร้างสรรค์นวัตกรรมใหม่ๆ ที่เกินความสามารถของเอเจนต์เดียว ระบบหลายเอเจนต์นี้จะช่วยเพิ่มความยืดหยุ่น ความทนทาน และความสามารถในการแก้ปัญหาของระบบ AI โดยรวม
7. ประชาธิปไตยทางปัญญา: การเติบโตของโมเดลโอเพนซอร์สและการเข้าถึง (Open-Source Movement and Accessibility)
นวัตกรรมที่ขับเคลื่อนโดยชุมชน
แนวโน้มของโมเดลภาษาขนาดใหญ่ที่จะเป็นโอเพนซอร์สมากขึ้นกำลังเติบโตอย่างต่อเนื่อง โมเดลเช่น Llama และ Gemma จาก Google เป็นตัวอย่างที่สำคัญ การเปิดกว้างนี้ช่วยส่งเสริมการเข้าถึงเทคโนโลยี LLM ให้นักพัฒนาและนักวิจัยทั่วโลกสามารถนำไปศึกษา ทดลอง และต่อยอดได้ง่ายขึ้น สร้างชุมชนแห่งความร่วมมือที่แข็งแกร่ง ซึ่งจะช่วยเร่งการพัฒนาเทคโนโลยี ลดการผูกขาดโดยบริษัทขนาดใหญ่ และส่งเสริมนวัตกรรมที่หลากหลายมากขึ้น
8. รากฐานที่มั่นคง: ความแม่นยำ การตรวจสอบข้อเท็จจริง และฐานความรู้ที่ทันสมัย (Accuracy, Fact-Checking, and Updatable Knowledge)
ความน่าเชื่อถือคือหัวใจสำคัญ
หนึ่งในความท้าทายหลักของ LLMs คือปัญหาเรื่องความแม่นยำของข้อมูล การสร้างข้อมูลที่ไม่ถูกต้อง (hallucinations) และฐานความรู้ที่อาจล้าสมัย แนวโน้มในอนาคตจึงมุ่งเน้นการพัฒนากลไกในการเพิ่มความแม่นยำ การตรวจสอบข้อเท็จจริง (fact-checking) โดยอาจมีการบูรณาการข้อมูลแบบเรียลไทม์จากแหล่งที่น่าเชื่อถือ และการทำให้ฐานความรู้ของ LLMs สามารถอัปเดตได้อย่างต่อเนื่องและมีประสิทธิภาพ เพื่อให้แน่ใจว่าข้อมูลที่ LLMs สร้างขึ้นมีความถูกต้อง ทันสมัย และน่าเชื่อถือ
9. ก้าวข้ามขีดจำกัด: การสำรวจสถาปัตยกรรมโมเดลใหม่ (Exploring New Architectures Beyond Transformers)
นวัตกรรมที่ไม่หยุดนิ่ง
แม้ว่าสถาปัตยกรรม Transformer จะเป็นรากฐานของ LLMs ส่วนใหญ่ในปัจจุบัน แต่การวิจัยและพัฒนาก็ไม่ได้หยุดนิ่งอยู่เพียงเท่านี้ เริ่มมีการสำรวจและพัฒนาโมเดลประเภทอื่นๆ ที่อาจมีประสิทธิภาพสูงในบางด้าน เช่น โมเดลแบบ Recurrent Neural Networks (RNNs) ที่ปรับปรุงใหม่โดยใช้ Local Attention เพื่อเพิ่มประสิทธิภาพด้านหน่วยความจำและความสามารถในการจัดการกับลำดับข้อมูลที่ยาวมากๆ การแสวงหาสถาปัตยกรรมใหม่ๆ เหล่านี้บ่งชี้ถึงความหลากหลายของแนวทางการพัฒนาในอนาคต ซึ่งอาจนำไปสู่การค้นพบโมเดลที่มีประสิทธิภาพเหนือกว่า Transformer ในบางมิติ
10. การบูรณาการเชิงลึกในธุรกิจและการสร้างคุณค่าใหม่ (Deeper Business Integration and Value Creation)
พลิกโฉมอุตสาหกรรมด้วย AI
LLMs รุ่นใหม่จะถูกนำไปประยุกต์ใช้ในภาคธุรกิจและอุตสาหกรรมต่างๆ อย่างลึกซึ้งและกว้างขวางยิ่งขึ้น ตั้งแต่การทำงานอัตโนมัติในสำนักงาน การสนับสนุนลูกค้าอัจฉริยะ การวิเคราะห์ข้อมูลธุรกิจขั้นสูง การสร้างเนื้อหาทางการตลาดเฉพาะบุคคล ไปจนถึงการสร้างสรรค์ผลิตภัณฑ์และบริการใหม่ๆ ที่ไม่เคยมีมาก่อน การบูรณาการระบบ multi-modal AI, AI Agent และ LLMs จะสร้างโซลูชันที่ครบวงจรและมีประสิทธิภาพ ตอบโจทย์งานหลากหลายรูปแบบ และขยายไปสู่การสร้างคุณค่าใหม่ในหลายอุตสาหกรรม
ภาพรวมการพัฒนา LLMs: ปัจจุบันและอนาคต
เพื่อให้เห็นภาพรวมของการเปลี่ยนแปลงและจุดเน้นในการพัฒนา LLMs ที่ชัดเจนยิ่งขึ้น ลองพิจารณาแผนภูมิเรดาร์ต่อไปนี้ ซึ่งเปรียบเทียบการให้ความสำคัญในด้านต่างๆ ของการพัฒนา LLMs ในยุคปัจจุบัน (ประมาณช่วง GPT-4) กับการคาดการณ์จุดเน้นในอนาคต (หลังยุค GPT-4.1) ข้อมูลในแผนภูมินี้เป็นการวิเคราะห์เชิงคุณภาพเพื่อแสดงแนวโน้ม ไม่ได้อ้างอิงจากข้อมูลสถิติเชิงปริมาณโดยตรง
จากแผนภูมิ จะเห็นได้ว่าแนวโน้มในอนาคตจะมีการให้ความสำคัญเพิ่มขึ้นในทุกๆ ด้าน โดยเฉพาะอย่างยิ่งในเรื่อง ความสามารถแบบมัลติโมดัล, การให้เหตุผลขั้นสูง, และ จริยธรรมและความปลอดภัย ซึ่งสะท้อนถึงความมุ่งมั่นในการสร้าง LLMs ที่ไม่เพียงแต่ฉลาดขึ้น แต่ยังรอบด้าน เข้าใจโลกได้ลึกซึ้งขึ้น และมีความรับผิดชอบมากขึ้นด้วย
แผนผังความคิด: โครงข่ายการพัฒนา LLMs ในอนาคต
เพื่อทำความเข้าใจความเชื่อมโยงของแนวโน้มต่างๆ ในการพัฒนา LLMs หลังยุค GPT-4.1 ได้อย่างเป็นระบบ แผนผังความคิด (Mindmap) ด้านล่างนี้จะช่วยให้เห็นภาพรวมของทิศทางและองค์ประกอบสำคัญต่างๆ ที่จะขับเคลื่อนนวัตกรรม LLM ในอนาคต:
การคิดเชิงแนวคิด"] id1c["ความเข้าใจบริบทลึกซึ้ง
หน้าต่างบริบทขยายใหญ่ขึ้น (Longer Context)"] id1d["การเรียนรู้แบบ Few-shot / Zero-shot ที่ดีขึ้น"] id2["ประสิทธิภาพและการปรับแต่ง"] id2a["โมเดลขนาดเล็กลงแต่ทรงพลัง"] id2b["ความเร็วในการประมวลผลสูงขึ้น"] id2c["ลดต้นทุนการฝึกฝนและการใช้งาน"] id2d["ความเชี่ยวชาญเฉพาะทาง (Domain Specificity)
- การแพทย์
- ชีววิทยา (C2S-Scale)
- การผลิต"] id3["สถาปัตยกรรมและนวัตกรรม"] id3a["การพัฒนาสถาปัตยกรรมใหม่ (Beyond Transformers)"] id3b["ระบบหลายเอเจนต์ (Multi-Agent Systems)"] id3c["การใช้ข้อมูลสังเคราะห์ (Synthetic Data)"] id3d["การบูรณาการข้อมูลเรียลไทม์"] id4["การเข้าถึงและระบบนิเวศ"] id4a["โมเดลโอเพนซอร์ส (Open Source Models)
- Gemma, Llama"] id4b["เฟรมเวิร์กสำหรับพัฒนาแอปพลิเคชัน LLM (AutoGen)"] id4c["การบูรณาการกับเทคโนโลยีเครือข่ายใหม่"] id5["จริยธรรมและความรับผิดชอบ"] id5a["ความแม่นยำและการตรวจสอบข้อเท็จจริง (Fact-Checking)"] id5b["การลดอคติ (Bias Reduction)"] id5c["ความปลอดภัยและความเป็นส่วนตัว"] id5d["ฐานความรู้ที่อัปเดตได้"] id6["การประยุกต์ใช้และผลกระทบ"] id6a["การบูรณาการในธุรกิจและอุตสาหกรรม"] id6b["สร้างคุณค่าใหม่ทางเศรษฐกิจ"] id6c["การเปลี่ยนแปลงรูปแบบการทำงาน"]
แผนผังความคิดนี้แสดงให้เห็นว่าการพัฒนา LLMs ในอนาคตเป็นกระบวนการที่ซับซ้อนและเชื่อมโยงกันในหลายมิติ ตั้งแต่การเพิ่มขีดความสามารถหลักของโมเดล การปรับปรุงประสิทธิภาพ ไปจนถึงการสร้างระบบนิเวศที่ส่งเสริมการเข้าถึงและนวัตกรรม โดยมีประเด็นด้านจริยธรรมและความรับผิดชอบเป็นกรอบสำคัญที่กำกับทิศทางการพัฒนา
GPT-4.1 กับอนาคตการแข่งขันในสมรภูมิ AI Benchmark
การเปิดตัว GPT-4.1 ได้สร้างความคาดหวังอย่างสูงในวงการ AI โดยเฉพาะอย่างยิ่งในแง่ของประสิทธิภาพเมื่อเทียบกับโมเดลคู่แข่ง วิดีโอด้านล่างนี้จะพาไปสำรวจศักยภาพของ GPT-4.1 ในการท้าทายเกณฑ์มาตรฐาน (Benchmarks) ต่างๆ ในปี 2025 ซึ่งจะช่วยให้เข้าใจถึงจุดแข็งและความสามารถที่พัฒนาขึ้นของโมเดลนี้ รวมถึงผลกระทบต่อการแข่งขันและการพัฒนา LLMs ในภาพรวม การทำความเข้าใจประสิทธิภาพของ GPT-4.1 ผ่านการทดสอบ benchmark ต่างๆ มีความสำคัญอย่างยิ่ง เพราะมันไม่เพียงแต่แสดงให้เห็นถึงความก้าวหน้าทางเทคโนโลยี แต่ยังเป็นตัวบ่งชี้ถึงทิศทางที่การวิจัยและพัฒนา LLM กำลังมุ่งหน้าไป Benchmark เหล่านี้มักครอบคลุมความสามารถหลากหลายด้าน เช่น การเข้าใจภาษา การให้เหตุผล การเขียนโค้ด และความรู้ทั่วไป การที่ GPT-4.1 สามารถทำคะแนนได้ดีใน benchmark เหล่านี้ (ตามที่กล่าวอ้างในวิดีโอ) ย่อมหมายถึงการยกระดับมาตรฐานของ LLM ทั้งวงการ และกระตุ้นให้เกิดการแข่งขันเพื่อพัฒนาโมเดลที่ดียิ่งขึ้นไปอีก
วิดีโอวิเคราะห์ศักยภาพของ GPT-4.1 ในการแข่งขันด้าน AI benchmarks ในปี 2025
ตารางสรุปแนวโน้มสำคัญและผลกระทบที่คาดการณ์
เพื่อให้เห็นภาพรวมที่ชัดเจนยิ่งขึ้น ตารางด้านล่างนี้สรุปแนวโน้มสำคัญในการพัฒนา LLMs หลังยุค GPT-4.1 พร้อมทั้งอธิบายรายละเอียดและผลกระทบหรือการประยุกต์ใช้ที่คาดว่าจะเกิดขึ้น ซึ่งจะช่วยให้เข้าใจถึงการเปลี่ยนแปลงที่กำลังจะมาถึงได้ง่ายขึ้น
| แนวโน้ม (Trend) | คำอธิบาย (Description) | ผลกระทบและการประยุกต์ใช้ที่คาดการณ์ (Potential Impact/Applications) |
|---|---|---|
| การพัฒนาสู่ Multimodal | โมเดลสามารถประมวลผลและสร้างเนื้อหาจากข้อมูลหลายรูปแบบ (ข้อความ, ภาพ, เสียง, วิดีโอ) ได้พร้อมกัน | การวิเคราะห์ทางการแพทย์ที่ครอบคลุม, ระบบผู้ช่วยเสมือนจริงที่สมจริง, การสร้างสรรค์สื่อผสม, การศึกษาแบบโต้ตอบ |
| การให้เหตุผลขั้นสูง (LRMs) | โมเดลมีความสามารถในการคิดวิเคราะห์, แก้ปัญหาซับซ้อน, และให้เหตุผลเชิงตรรกะได้ดีขึ้น โดยทำงานบน "แนวคิด" แทน "โทเค็น" | การค้นคว้าทางวิทยาศาสตร์, การวางแผนกลยุทธ์ทางธุรกิจ, การพัฒนาระบบกฎหมายอัจฉริยะ, การสอนที่ซับซ้อน |
| ความเชี่ยวชาญเฉพาะทาง | การพัฒนาโมเดลที่ปรับแต่งมาสำหรับอุตสาหกรรมหรือสาขาวิชาเฉพาะ (เช่น การแพทย์, วิศวกรรม, การเงิน) | เพิ่มความแม่นยำและประสิทธิภาพในงานเฉพาะทาง, ลดข้อผิดพลาด, สร้างโซลูชันที่ตรงจุดสำหรับแต่ละอุตสาหกรรม |
| การขยายหน้าต่างบริบท | โมเดลสามารถจดจำและประมวลผลข้อมูลในปริมาณที่มากขึ้นและยาวนานขึ้น | การสรุปเอกสารขนาดยาว, การสนทนาที่ต่อเนื่องและเป็นธรรมชาติ, การวิเคราะห์โปรเจกต์ขนาดใหญ่, การเขียนโค้ดที่ซับซ้อน |
| ประสิทธิภาพและโมเดลขนาดเล็ก | โมเดลทำงานเร็วขึ้น, ใช้ทรัพยากรน้อยลง, และมีโมเดลขนาดเล็กที่มีประสิทธิภาพสูงสำหรับการใช้งานบนอุปกรณ์พกพา | แอปพลิเคชัน AI บนสมาร์ทโฟน, ระบบ Edge AI, การตอบสนองที่รวดเร็ว, ลดต้นทุนการใช้งาน |
| ระบบหลายเอเจนต์ (Multi-Agent) | AI หลายตัวทำงานร่วมกันเพื่อแก้ปัญหาที่ซับซ้อน | การจัดการโครงการอัตโนมัติ, การจำลองสถานการณ์ที่ซับซ้อน, การพัฒนาระบบอัตโนมัติในโรงงาน |
| โมเดลโอเพนซอร์ส | การเพิ่มขึ้นของโมเดลที่เปิดเผยซอร์สโค้ดให้สาธารณะเข้าถึงและพัฒนาต่อได้ | เร่งนวัตกรรม, ลดการผูกขาด, ส่งเสริมการเรียนรู้และการมีส่วนร่วมของชุมชนนักพัฒนา |
| จริยธรรมและความปลอดภัย | การให้ความสำคัญกับการลดอคติ, เพิ่มความโปร่งใส, ความเป็นส่วนตัว, และการตรวจสอบความถูกต้องของข้อมูล | สร้างความน่าเชื่อถือใน AI, ลดความเสี่ยงจากการใช้งานในทางที่ผิด, ส่งเสริมการพัฒนา AI ที่มีความรับผิดชอบ |
โครงสร้างพื้นฐานแห่งอนาคต: พลังประมวลผลและกฎการขยายตัว
รองรับความทะเยอทะยานของ AI
การพัฒนา LLMs ที่มีขนาดใหญ่ขึ้นและซับซ้อนมากขึ้น ย่อมต้องการพลังการประมวลผลมหาศาล แนวโน้มหนึ่งคือการลงทุนในโครงสร้างพื้นฐานซูเปอร์คอมพิวเตอร์ที่ออกแบบมาเพื่อรองรับการฝึกฝนโมเดล AI ขนาดใหญ่โดยเฉพาะ บริษัทเทคโนโลยียักษ์ใหญ่ต่างกำลังทุ่มงบประมาณมหาศาลเพื่อสร้างศูนย์ข้อมูล AI แห่งอนาคต นอกจากนี้ "กฎการขยายตัว" (Scaling Laws) ซึ่งชี้ให้เห็นว่าประสิทธิภาพของ LLMs มักจะเพิ่มขึ้นตามขนาดของโมเดล จำนวนข้อมูลที่ใช้ฝึก และพลังการประมวลผลที่ใช้ ก็ยังคงเป็นแนวทางสำคัญในการพัฒนา แม้ว่าจะเริ่มมีการสำรวจแนวทางที่เน้นประสิทธิภาพมากกว่าขนาดเพียงอย่างเดียวแล้วก็ตาม นวัตกรรมด้านฮาร์ดแวร์ เช่น ชิปประมวลผล AI โดยเฉพาะ หรือแม้แต่การวิจัยด้านควอนตัมคอมพิวติ้ง ก็อาจมีบทบาทในการปลดล็อกขีดความสามารถใหม่ๆ ของ LLMs ในระยะยาว
ภาพแนวคิดของศูนย์ข้อมูลซูเปอร์คอมพิวเตอร์ที่ออกแบบมาเพื่อรองรับการพัฒนา AI ในอนาคต
ความท้าทายที่ต้องเผชิญ: จริยธรรม ความปลอดภัย และอคติ
แม้ว่าอนาคตของ LLMs จะเต็มไปด้วยศักยภาพอันน่าทึ่ง แต่ก็มาพร้อมกับความท้าทายที่สำคัญ โดยเฉพาะอย่างยิ่งในประเด็นด้านจริยธรรม ความปลอดภัย และอคติที่อาจแฝงอยู่ในข้อมูลที่ใช้ฝึกสอนโมเดล การสร้างข้อมูลเท็จหรือข้อมูลที่บิดเบือน (hallucinations) การแพร่กระจายข้อมูลที่ไม่ถูกต้อง การละเมิดความเป็นส่วนตัว และการเสริมสร้างอคติทางสังคมที่มีอยู่เดิม เป็นความเสี่ยงที่ผู้พัฒนาและสังคมต้องให้ความสำคัญอย่างจริงจัง
ดังนั้น การพัฒนา LLMs ในอนาคตจึงต้องควบคู่ไปกับการวิจัยและพัฒนากลไกในการกำกับดูแล การตรวจสอบความโปร่งใสของโมเดล (explainability) การสร้างระบบที่สามารถตรวจสอบและแก้ไขอคติได้ รวมถึงการสร้างกรอบจริยธรรมและกฎหมายที่เหมาะสม เพื่อให้มั่นใจว่าเทคโนโลยี LLM จะถูกนำไปใช้อย่างมีความรับผิดชอบและสร้างประโยชน์สูงสุดต่อมวลมนุษยชาติ
คำถามที่พบบ่อย (FAQ)
โมเดลภาษาแบบมัลติโมดัล (Multimodal LLMs) คืออะไร และจะพัฒนาไปอย่างไร? ▼
โมเดลภาษาแบบมัลติโมดัลคือ LLMs ที่สามารถประมวลผล ทำความเข้าใจ และสร้างเนื้อหาจากข้อมูลหลายประเภทพร้อมกันได้ เช่น ข้อความ รูปภาพ เสียง และวิดีโอ ในอนาคต คาดว่าจะมีการบูรณาการข้อมูลเหล่านี้อย่างลึกซึ้งและไร้รอยต่อยิ่งขึ้น ทำให้โมเดลสามารถเข้าใจโลกได้ใกล้เคียงกับมนุษย์มากขึ้น สามารถตอบคำถามที่ซับซ้อนซึ่งต้องใช้ข้อมูลจากหลายแหล่ง หรือสร้างสรรค์ประสบการณ์แบบอินเทอร์แอคทีฟที่สมจริงยิ่งขึ้น
Large Reasoning Models (LRMs) แตกต่างจาก LLMs ปัจจุบันอย่างไร? ▼
LRMs (Large Reasoning Models) เป็นแนวคิดที่ต่อยอดจาก LLMs โดยมุ่งเน้นที่การพัฒนาความสามารถในการ "ให้เหตุผล" (reasoning) ที่ซับซ้อน แทนที่จะเน้นการจดจำรูปแบบทางภาษาและการสร้างข้อความตามสถิติเป็นหลัก LRMs จะพยายามทำงานกับ "แนวคิด" (ideas) หรือหน่วยของความหมาย มากกว่าแค่ "โทเค็น" (tokens) หรือคำศัพท์ เป้าหมายคือเพื่อให้ AI สามารถทำการอนุมาน วางแผน แก้ปัญหา และเข้าใจสามัญสำนึกได้ดีขึ้น คล้ายกับกระบวนการคิดของมนุษย์
LLMs จะมีความเชี่ยวชาญเฉพาะทางมากขึ้นได้อย่างไร? ▼
LLMs สามารถมีความเชี่ยวชาญเฉพาะทางได้โดยการฝึกฝนเพิ่มเติม (fine-tuning) ด้วยชุดข้อมูลขนาดใหญ่ที่เกี่ยวข้องกับโดเมนนั้นๆ โดยเฉพาะ เช่น ชุดข้อมูลทางการแพทย์สำหรับ LLM ทางการแพทย์ หรือชุดข้อมูลโค้ดโปรแกรมสำหรับ LLM ด้านการเขียนโค้ด นอกจากนี้ การออกแบบสถาปัตยกรรมโมเดลให้เหมาะสมกับลักษณะงานเฉพาะ และการบูรณาการความรู้เฉพาะทาง (domain knowledge) เข้าไปในกระบวนการเรียนรู้ ก็เป็นปัจจัยสำคัญที่ช่วยเพิ่มความเชี่ยวชาญได้
ความท้าทายด้านจริยธรรมและความปลอดภัยของ LLMs ในอนาคตมีอะไรบ้าง? ▼
ความท้าทายสำคัญ ได้แก่ ปัญหาอคติ (bias) ที่อาจแฝงอยู่ในข้อมูลฝึกสอนและส่งผลให้เกิดการตัดสินใจที่ไม่เป็นธรรม, การสร้างข้อมูลเท็จหรือข้อมูลที่ทำให้เข้าใจผิด (misinformation/disinformation), การละเมิดความเป็นส่วนตัวของข้อมูล, ความโปร่งใสในการทำงานของโมเดล (explainability), และความรับผิดชอบเมื่อเกิดข้อผิดพลาด นอกจากนี้ยังมีประเด็นเรื่องผลกระทบต่อการจ้างงานและการใช้ LLMs ในทางที่ผิด เช่น การสร้างเนื้อหาที่เป็นอันตรายหรือการหลอกลวง
คำแนะนำสำหรับการค้นคว้าเพิ่มเติม
หากคุณสนใจที่จะศึกษาเพิ่มเติมเกี่ยวกับอนาคตของโมเดลภาษาขนาดใหญ่ ลองค้นหาข้อมูลด้วยคำค้นหาเหล่านี้:
- การประยุกต์ใช้ LLMs แบบมัลติโมดัลในอุตสาหกรรมต่างๆ มีอะไรบ้าง?
- Large Reasoning Models (LRMs) จะเปลี่ยนแปลงวิธีที่ AI แก้ปัญหาอย่างไร?
- ความสำคัญของโมเดル LLM แบบโอเพนซอร์สต่อการพัฒนา AI คืออะไร?
- มาตรการใดบ้างที่สามารถนำมาใช้เพื่อลดอคติและความเสี่ยงใน LLMs?
แหล่งอ้างอิง
Last updated May 18, 2025