
چگونه ژنها را دستهبندی کنیم تا ساختارهای پنهان شبکه ژنی را آشکار سازیم؟
راهنمای جامع دستهبندی ژنها برای تأیید یا رد الگوهای عملکردی و تنظیمی در شبکههای بیولوژیکی
درک چگونگی تعامل ژنها و پروتئینها برای ایجاد فرآیندهای بیولوژیکی پیچیده، یکی از چالشهای اصلی زیستشناسی مدرن است. شبکههای ژنی، مدلی قدرتمند برای نمایش این تعاملات هستند. این شبکهها از گرهها (ژنها یا پروتئینها) و یالها (روابط یا تعاملات بین آنها) تشکیل شدهاند. شناسایی و تأیید "ساختارها" در این شبکهها - مانند گروههایی از ژنها که با هم کار میکنند (ماژولها)، ژنهای مرکزی با نقش کلیدی (هابها)، یا مسیرهای سیگنالدهی - برای فهم عملکرد سلولی، مکانیسم بیماریها و کشف اهداف دارویی جدید حیاتی است. دستهبندی هوشمندانه ژنها بر اساس ویژگیهای مختلف، ابزاری کلیدی برای بررسی فرضیهها در مورد وجود یا عدم وجود این ساختارها فراهم میکند.
نکات کلیدی: روشهای اصلی برای آشکارسازی ساختار شبکه
- شبکههای همبیانی و تنظیمی: از الگوهای بیان مشابه (همبیانی) و روابط تنظیمی (مانند تاثیر فاکتورهای رونویسی بر ژنهای هدف) برای شناسایی ماژولهای عملکردی و ژنهای کلیدی (هاب) که نقشی محوری در شبکه دارند، استفاده کنید.
- دستهبندی عملکردی (Gene Ontology): ژنها را بر اساس دانش موجود در مورد عملکرد بیولوژیکی، موقعیت سلولی یا فعالیت مولکولی آنها گروهبندی کنید. سپس، با تحلیل غنیسازی آماری، بررسی کنید که آیا ژنهای یک ساختار فرضی بهطور معناداری در دستههای عملکردی خاصی تجمع یافتهاند یا خیر.
- تحلیل توپولوژیکی و آماری: ویژگیهای ساختاری شبکه مانند تعداد اتصالات یک ژن (درجه)، نقش آن در کوتاهترین مسیرها (بینابینی)، یا تعلق آن به گروههای متراکم (خوشهها) را تحلیل کنید. از روشهای آماری برای ارزیابی معناداری و پایداری ساختارهای مشاهدهشده بهره ببرید.
رویکردهای اصلی دستهبندی ژنها برای تحلیل ساختار شبکه
روشهای مختلفی برای دستهبندی ژنها وجود دارد که هر کدام بر اساس نوع دادهها و هدف تحلیل، بینشهای متفاوتی در مورد ساختار شبکه ارائه میدهند. انتخاب روش مناسب به سوال بیولوژیکی مورد نظر بستگی دارد.
۱. تحلیل شبکههای همبیانی (Co-expression Network Analysis)
شناسایی ماژولهای عملکردی
این روش بر این اصل استوار است که ژنهایی که با هم در فرآیندهای بیولوژیکی مشابهی نقش دارند، اغلب الگوهای بیان مشابهی را در شرایط مختلف (مانند بافتهای متفاوت، مراحل تکوینی یا پاسخ به تیمارها) نشان میدهند. با اندازهگیری همبستگی بین پروفایلهای بیان ژنها، میتوان شبکهای ساخت که در آن یالها نشاندهنده قدرت همبیانی هستند.
- ساخت شبکه: الگوریتمهایی مانند WGCNA (Weighted Gene Co-expression Network Analysis) یا نسخههای بهبودیافته آن (مانند GWENA) برای ساخت این شبکهها استفاده میشوند. در این شبکهها، وزن یالها نشاندهنده میزان همبستگی بیان ژنها است.
- شناسایی ماژولها: با استفاده از الگوریتمهای خوشهبندی، ژنها به گروههایی به نام "ماژول" تقسیم میشوند. ژنهای درون یک ماژول تمایل زیادی به همبیانی با یکدیگر دارند و اغلب در یک مسیر یا عملکرد بیولوژیکی مشترک دخیل هستند.
- تأیید ساختار: وجود ماژولهای پایدار و معنادار از نظر بیولوژیکی (که با تحلیل غنیسازی عملکردی تأیید میشود) میتواند وجود ساختارهای عملکردی خوشهای در شبکه را تأیید کند. همچنین، شناسایی "ژنهای هاب" (ژنهایی با اتصالات زیاد درون ماژول) میتواند ژنهای کلیدی در این ساختارها را مشخص کند.
۲. تحلیل شبکههای تنظیمی (Regulatory Network Analysis)
مدلسازی روابط علت و معلولی
شبکههای تنظیمی ژن (GRNs) روابط کنترلی بین ژنها را مدل میکنند، مانند اینکه چگونه فاکتورهای رونویسی (TFs) بیان ژنهای هدف خود را تنظیم میکنند یا چگونه microRNAها بیان ژنها را مهار میکنند. این شبکهها اغلب جهتدار هستند و میتوانند ساختارهای سلسلهمراتبی یا مدارهای بازخوردی را نشان دهند.
- استنتاج شبکه: روشهای مهندسی معکوس (Reverse Engineering) با استفاده از دادههای بیان ژن و گاهی اطلاعات دیگر (مانند دادههای اتصال TF) برای پیشبینی این روابط تنظیمی به کار میروند.
- شناسایی ساختارها: این شبکهها میتوانند ساختارهایی مانند "موتیفهای شبکه" (الگوهای کوچک و تکرارشونده از اتصالات)، "مدارهای تنظیمی" (مانند حلقههای بازخورد مثبت یا منفی) یا "سلسلهمراتب تنظیمی" (جایی که TFهای اصلی، TFهای دیگر و در نهایت ژنهای عملکردی را کنترل میکنند) را آشکار سازند.
- تأیید ساختار: شناسایی TFها به عنوان گرههای با درجه خروجی بالا یا یافتن الگوهای تنظیمی شناختهشده، میتواند وجود ساختارهای کنترلی خاص را تأیید کند. ابزارهایی مانند GeNeCK به ساخت و بصریسازی این شبکهها کمک میکنند.
۳. دستهبندی عملکردی با Gene Ontology (GO)
گروهبندی بر اساس دانش بیولوژیکی
Gene Ontology (GO) یک استاندارد جهانی برای توصیف عملکرد ژنها و پروتئینها است. این پایگاه داده، ژنها را بر اساس سه جنبه اصلی دستهبندی میکند: فرآیند بیولوژیکی (Biological Process)، عملکرد مولکولی (Molecular Function) و مکان سلولی (Cellular Component). دستهبندی ژنها با استفاده از GO به ما امکان میدهد تا ببینیم آیا ژنهای متعلق به یک ساختار فرضی در شبکه، در عملکردهای خاصی غنی شدهاند یا خیر.
- تحلیل غنیسازی (Enrichment Analysis): پس از شناسایی یک گروه از ژنها (مثلاً یک ماژول همبیانی یا ژنهای هدف یک TF)، میتوان با استفاده از ابزارهای تحلیل غنیسازی GO بررسی کرد که آیا اصطلاحات GO خاصی بهطور آماری معناداری بیش از حد انتظار در آن گروه یافت میشوند یا خیر.
- ابزارهای تخصصی: ابزارهایی مانند Categorizer وجود دارند که از ساختار سلسلهمراتبی GO و شباهتهای معنایی بین اصطلاحات برای دستهبندی دقیقتر ژنها استفاده میکنند و میتوانند غنیسازی را برای دستههای تعریفشده توسط کاربر محاسبه کنند.
- تأیید/رد ساختار: اگر تحلیل غنیسازی نشان دهد که ژنهای یک ساختار فرضی بهطور قابل توجهی در یک یا چند دسته عملکردی مرتبط تجمع یافتهاند، این امر میتواند وجود آن ساختار عملکردی را تأیید کند. برعکس، عدم غنیسازی معنادار میتواند فرضیه مربوط به عملکرد آن ساختار را تضعیف کند.
۴. تحلیل ویژگیهای توپولوژیک شبکه
استفاده از معیارهای ساختاری
توپولوژی شبکه به نحوه اتصال گرهها به یکدیگر اشاره دارد. معیارهای توپولوژیکی مختلفی وجود دارند که میتوانند برای دستهبندی ژنها و شناسایی ساختارهای مهم استفاده شوند.
- مرکزیت (Centrality): معیارهایی مانند درجه (تعداد اتصالات)، بینابینی (نقش گره در کوتاهترین مسیرها) و نزدیکی (فاصله متوسط از سایر گرهها) میتوانند ژنهای مهم یا مرکزی (هابها) را در شبکه شناسایی کنند. وجود هابها میتواند نشاندهنده ساختارهای مرکز-پیرامون (hub-and-spoke) باشد.
- خوشهبندی (Clustering): ضریب خوشهبندی میزان تمایل همسایههای یک گره به اتصال به یکدیگر را اندازهگیری میکند. مقادیر بالای خوشهبندی در شبکه میتواند نشاندهنده وجود ساختارهای ماژولار باشد. الگوریتمهای تشخیص جامعه (Community Detection) مانند MCODE یا ClusterONE مستقیماً برای شناسایی این زیرشبکههای متراکم (ماژولها) استفاده میشوند.
- تأیید ساختار: شناسایی ژنها با مقادیر بالای مرکزیت یا یافتن ماژولهای متراکم و پایدار میتواند به تأیید وجود ساختارهای غیرتصادفی و مهم در شبکه کمک کند.
۵. دستهبندی با یادگیری ماشین و روشهای آماری
الگوهای پیچیده و پیشبینی
روشهای یادگیری ماشین (نظارتشده و بدون نظارت) و مدلهای آماری پیشرفته میتوانند الگوهای پیچیدهتری را در دادههای ژنومی شناسایی کنند و برای دستهبندی ژنها یا استنتاج ساختار شبکه به کار روند.
- خوشهبندی بدون نظارت: الگوریتمهایی مانند K-means یا خوشهبندی سلسلهمراتبی میتوانند ژنها را بر اساس الگوهای بیان یا سایر ویژگیها بدون دانش قبلی گروهبندی کنند.
- طبقهبندی نظارتشده: اگر دستههایی از ژنها از پیش تعریف شده باشند (مثلاً ژنهای مرتبط با یک بیماری خاص)، میتوان از الگوریتمهایی مانند ماشین بردار پشتیبان (SVM) یا جنگل تصادفی (Random Forest) برای آموزش مدلی استفاده کرد که ژنهای جدید را به این دستهها تخصیص دهد یا ژنهای مهم برای تمایز بین دستهها را شناسایی کند (انتخاب ویژگی).
- مدلهای گرافیکی: روشهایی مانند graphical lasso میتوانند ساختار شبکه (روابط شرطی بین ژنها) را مستقیماً از دادههای بیان ژن تخمین بزنند.
- تأیید ساختار: این روشها میتوانند به شناسایی گروههای جدیدی از ژنها یا تأیید ساختارهای فرضی با استفاده از قدرت پیشبینی مدل کمک کنند. ارزیابی عملکرد مدل با روشهایی مانند اعتبارسنجی متقابل (Cross-Validation) برای تأیید استحکام ساختار ضروری است.
۶. تحلیل شبکههای افتراقی (Differential Network Analysis)
مقایسه ساختارها بین شرایط مختلف
این رویکرد به جای تحلیل یک شبکه واحد، بر مقایسه ساختار شبکههای ژنی بین دو یا چند شرایط مختلف (مثلاً سلولهای سالم در مقابل سلولهای سرطانی، یا قبل و بعد از یک تیمار) تمرکز دارد. هدف، شناسایی تغییرات در اتصالات یا ماژولهای شبکه است که ممکن است با تفاوتهای فنوتیپی مرتبط باشد.
- شناسایی تغییرات: این تحلیل میتواند ژنها یا یالهایی را که الگوهای اتصال متفاوتی در شرایط مختلف نشان میدهند، یا ماژولهایی که در یک شرایط وجود دارند ولی در شرایط دیگر وجود ندارند (یا ساختار داخلی آنها تغییر کرده است)، شناسایی کند.
- تأیید ساختار مرتبط با شرایط: یافتن تغییرات معنادار در ساختار شبکه که با وضعیت بیولوژیکی (مثلاً بیماری) همبستگی دارد، میتواند وجود ساختارهای شبکهای پویا و مرتبط با آن وضعیت را تأیید کند.
مقایسه رویکردهای دستهبندی ژنها
هر یک از روشهای دستهبندی نقاط قوت و ضعف خود را دارند و بسته به هدف تحقیق، دادههای موجود و نوع ساختار مورد بررسی، ممکن است یک یا ترکیبی از چند روش مناسبتر باشد. نمودار راداری زیر یک مقایسه کیفی بین رویکردهای اصلی بر اساس چند معیار کلیدی ارائه میدهد:
- شناسایی ماژول: توانایی روش در شناسایی گروههای متراکم از ژنهای مرتبط.
- شناسایی تنظیمکنندهها: توانایی روش در یافتن ژنهای کلیدی کنترلکننده (مانند TFها یا هابها).
- بینش عملکردی: میزان اطلاعاتی که روش مستقیماً در مورد عملکرد بیولوژیکی ژنها یا ساختارها ارائه میدهد.
- نیاز داده: نوع و حجم دادههای مورد نیاز (مانند بیان ژن، اطلاعات GO، دادههای تعاملی).
- هزینه محاسباتی: میزان منابع محاسباتی مورد نیاز برای اجرای تحلیل.
همانطور که مشاهده میشود، روشهای همبیانی و توپولوژیکی در شناسایی ماژولها قوی هستند، در حالی که تحلیل شبکههای تنظیمی برای یافتن ژنهای کنترلکننده مناسبتر است. دستهبندی عملکردی با GO بیشترین بینش مستقیم در مورد عملکرد بیولوژیکی را ارائه میدهد، اما ممکن است به تنهایی برای کشف ساختارهای جدید کافی نباشد. روشهای یادگیری ماشین انعطافپذیری بالایی دارند اما اغلب به دادههای بیشتر و توان محاسباتی بالاتری نیاز دارند.
نقشه ذهنی روشهای دستهبندی و اعتبارسنجی
برای درک بهتر ارتباط بین روشهای مختلف دستهبندی و فرآیند اعتبارسنجی ساختارها در شبکه ژنی، نقشه ذهنی زیر ارائه شده است. این نقشه نشان میدهد که چگونه میتوان از ترکیب روشهای گوناگون برای رسیدن به هدف نهایی، یعنی تأیید یا رد یک ساختار خاص در شبکه، استفاده کرد.
این نقشه ذهنی نشان میدهد که فرآیند تحلیل ساختار شبکه ژنی شامل دو بخش اصلی است: ۱) بهکارگیری روشهای مختلف برای دستهبندی ژنها و شناسایی ساختارهای بالقوه، و ۲) استفاده از مجموعهای از رویکردهای اعتبارسنجی برای ارزیابی استحکام و معناداری بیولوژیکی آن ساختارها.
جدول خلاصه روشهای دستهبندی و اعتبارسنجی ساختارها
جدول زیر خلاصهای از روشهای اصلی دستهبندی ژنها، اساس کار آنها، نوع ساختارهایی که معمولاً شناسایی میکنند و نمونههایی از ابزارها یا الگوریتمهای مرتبط را ارائه میدهد. این جدول به انتخاب روش مناسب بر اساس هدف تحقیق کمک میکند.
| روش دستهبندی | اساس دستهبندی | ساختار قابل شناسایی | ابزار/الگوریتم نمونه |
|---|---|---|---|
| همبیانی | الگوهای بیان مشابه | ماژولهای عملکردی، ژنهای هاب | WGCNA, GWENA |
| تنظیمی | روابط کنترلی (TF-هدف, miRNA-هدف) | سلسلهمراتب تنظیمی، مدارهای بازخورد، موتیفها | GeNeCK, الگوریتمهای مهندسی معکوس |
| عملکردی (GO) | عملکرد بیولوژیکی، مولکولی یا مکانی مشترک | گروههای ژنی غنیشده در مسیرها یا فرآیندهای خاص | GO Enrichment Tools, Categorizer |
| توپولوژیکی | ویژگیهای ساختاری شبکه (اتصالات، مسیرها) | ژنهای مرکزی (هاب)، ماژولهای متراکم (خوشهها) | NetworkX (برای محاسبه معیارها), MCODE, ClusterONE |
| یادگیری ماشین | الگوهای پیچیده در دادهها (بیان، توالی، ...) | دستههای جدید ژنی، ژنهای پیشبینیکننده، ساختارهای استنتاجی | SVM, Random Forest, PCA, Graphical Lasso |
| افتراقی شبکه | تغییرات در اتصالات/ماژولها بین شرایط | ساختارهای مرتبط با فنوتیپ یا شرایط خاص | DiffCoEx, DGCA |
فرآیند تأیید یا رد ساختارها (Validation)
شناسایی یک ساختار بالقوه در شبکه ژنی تنها قدم اول است. برای تأیید یا رد قطعی وجود آن ساختار، انجام مراحل اعتبارسنجی ضروری است:
- ارزیابی آماری:
- معناداری: محاسبه مقدار p-value برای ارزیابی اینکه آیا مشاهده ساختار مورد نظر (مثلاً غنیسازی یک ماژول در یک مسیر خاص) از نظر آماری معنادار است و صرفاً ناشی از شانس نیست (مثلاً با استفاده از آزمون دقیق فیشر یا آزمون هایپرژئومتریک برای غنیسازی GO).
- پایداری: بررسی اینکه آیا ساختار شناساییشده (مانند ماژولها) با تغییرات کوچک در دادهها یا پارامترهای الگوریتم همچنان پایدار باقی میماند. روشهایی مانند بوتاسترپینگ یا اعتبارسنجی متقابل میتوانند استفاده شوند.
- مقایسه با مدل صفر: مقایسه ویژگیهای ساختار مشاهدهشده با آنچه در شبکههای تصادفی (مدلهای صفر) انتظار میرود تا اطمینان حاصل شود که ساختار غیرتصادفی است.
- اعتبارسنجی بیولوژیکی:
- مقایسه با دانش موجود: بررسی اینکه آیا ساختار شناساییشده با دانش بیولوژیکی موجود در پایگاههای داده معتبر مانند KEGG (برای مسیرهای متابولیکی و سیگنالدهی) یا STRING (برای تعاملات پروتئین-پروتئین) مطابقت دارد.
- استفاده از دادههای مستقل: تأیید ساختار با استفاده از یک مجموعه داده مستقل که در فرآیند اولیه شناسایی استفاده نشده است.
- اعتبارسنجی تجربی: در نهایت، قویترین اعتبارسنجی از طریق آزمایشهای بیولوژیکی هدفمند (مانند آزمایشهای ناکاوت ژن یا بررسی تعاملات پروتئینی) به دست میآید، اگرچه این مرحله همیشه امکانپذیر نیست.
تنها پس از طی کردن این مراحل و کسب شواهد کافی از جنبههای آماری و بیولوژیکی، میتوان با اطمینان بیشتری وجود یا عدم وجود یک ساختار خاص در شبکه ژنی را تأیید یا رد کرد.
نقش Gene Ontology در تحلیل و تفسیر شبکههای ژنی
Gene Ontology (GO) یکی از ابزارهای بنیادی در بیوانفورماتیک برای درک عملکرد ژنها در مقیاس بزرگ است. در زمینه تحلیل شبکههای ژنی، GO نقش حیاتی در تفسیر بیولوژیکی ساختارهای شناساییشده ایفا میکند. ویدیوی زیر مقدمهای بر تحلیل GO در محیط R ارائه میدهد که یکی از رایجترین پلتفرمها برای تحلیل دادههای ژنومی است.
ویدیوی آموزشی تحلیل Gene Ontology (GO) در R برای تفسیر نتایج ترانسکریپتومیکس.
همانطور که در ویدیو و بحثهای قبلی اشاره شد، پس از شناسایی یک گروه از ژنها از طریق روشهای دستهبندی (مانند یک ماژول همبیانی یا خوشه توپولوژیک)، اولین قدم برای فهم نقش بیولوژیکی آن گروه، انجام تحلیل غنیسازی GO است. این تحلیل مشخص میکند که آیا ژنهای این گروه بهطور معناداری در فرآیندهای بیولوژیکی، عملکردهای مولکولی یا مکانهای سلولی خاصی نقش دارند یا خیر. نتیجه این تحلیل میتواند فرضیه مربوط به عملکرد آن ساختار شبکه را تأیید یا تضعیف کند و بینش مهمی در مورد نقش آن در سیستم بیولوژیکی فراهم آورد.
تصویری از یک شبکه تعاملات ژنی
شبکههای ژنی میتوانند بسیار پیچیده باشند و نمایش بصری آنها به درک بهتر ساختارها کمک میکند. تصویر زیر نمونهای از یک شبکه تعاملات ژنی را نشان میدهد که در آن گرهها نمایانگر ژنها و یالها نشاندهنده انواع مختلف تعاملات بین آنها هستند. ساختارهایی مانند هابها (گرههای با اتصالات زیاد) و ماژولها (گروههای متراکم از گرهها) ممکن است در چنین شبکههایی قابل مشاهده باشند.
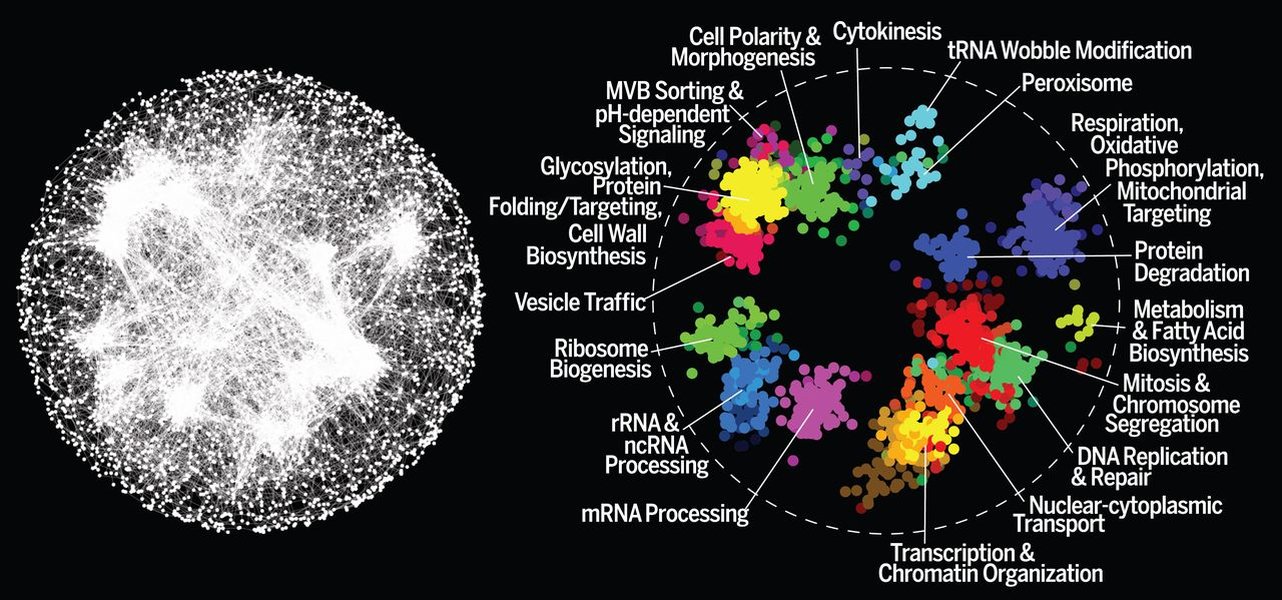
نمایش گرافیکی یک شبکه تعاملات ژنی. گرهها (دایرهها) ژنها و یالها (خطوط) تعاملات بین آنها را نشان میدهند.
سوالات متداول (FAQ)
ساختار شبکه ژنی به چه معناست؟
ساختار شبکه ژنی به الگوهای غیرتصادفی اتصالات و روابط بین ژنها در یک شبکه بیولوژیکی اشاره دارد. این ساختارها میتوانند شامل موارد زیر باشند:
- ماژولها یا خوشهها: گروههایی از ژنها که بهطور متراکم به یکدیگر متصل هستند و اغلب در یک عملکرد بیولوژیکی مشترک نقش دارند.
- ژنهای هاب (Hub Genes): ژنهایی که دارای تعداد اتصالات بسیار بالایی هستند و نقش مرکزی در اتصال بخشهای مختلف شبکه یا کنترل فرآیندهای کلیدی دارند.
- مسیرها (Pathways): دنبالهای خطی یا شاخهای از ژنها که در یک فرآیند بیوشیمیایی یا سیگنالدهی خاص به ترتیب عمل میکنند.
- موتیفهای شبکه (Network Motifs): الگوهای کوچک و تکرارشونده از اتصالات (مثلاً حلقههای بازخورد) که بلوکهای سازنده شبکههای بزرگتر هستند.
- سلسلهمراتب تنظیمی: ساختارهایی که در آن ژنهای تنظیمکننده اصلی، ژنهای تنظیمکننده دیگر و در نهایت ژنهای هدف را کنترل میکنند.
شناسایی این ساختارها به درک سازماندهی و عملکرد سیستمهای بیولوژیکی کمک میکند.
چرا تأیید یا رد ساختارهای شبکه ژنی اهمیت دارد؟
تأیید یا رد ساختارهای شبکه ژنی به دلایل متعددی مهم است:
- درک عملکرد بیولوژیکی: شناسایی ساختارهای واقعی مانند ماژولها و مسیرها به ما کمک میکند بفهمیم چگونه ژنها برای انجام وظایف سلولی با هم همکاری میکنند.
- شناسایی ژنهای کلیدی: تأیید وجود هابها یا ژنهای مرکزی در یک ساختار میتواند ژنهایی را مشخص کند که نقش حیاتی در یک فرآیند دارند و ممکن است اهداف خوبی برای مداخلات درمانی باشند.
- فهم مکانیسم بیماریها: بسیاری از بیماریها ناشی از اختلال در تعاملات ژنی هستند. تحلیل تغییرات در ساختار شبکه (مثلاً در تحلیل شبکه افتراقی) میتواند به شناسایی مکانیسمهای مولکولی بیماریها کمک کند.
- کشف دارو: ساختارهای تأیید شده در شبکه میتوانند اهداف جدیدی برای طراحی دارو یا نشانگرهای زیستی (biomarkers) برای تشخیص یا پیشآگهی بیماریها فراهم کنند.
- جلوگیری از نتایج نادرست: فرآیند اعتبارسنجی دقیق از نتیجهگیری بر اساس ساختارهای تصادفی یا آرتیفکتهای ناشی از دادهها یا روشهای تحلیلی جلوگیری میکند و اطمینان به یافتههای علمی را افزایش میدهد.
برای این تحلیلها به چه نوع دادههایی نیاز است؟
نوع دادههای مورد نیاز بستگی به روش دستهبندی و تحلیل شبکه دارد. دادههای رایج عبارتند از:
- دادههای بیان ژن (Gene Expression Data): این دادهها که معمولاً از تکنیکهایی مانند Microarray یا RNA-seq به دست میآیند، سطح فعالیت (بیان) هزاران ژن را بهطور همزمان در شرایط مختلف اندازهگیری میکنند. این دادهها اساس اصلی برای ساخت شبکههای همبیانی و بسیاری از روشهای استنتاج شبکه تنظیمی هستند.
- دادههای تعامل پروتئین-پروتئین (PPI Data): پایگاههای دادهای مانند STRING یا BioGRID اطلاعاتی در مورد تعاملات فیزیکی یا عملکردی بین پروتئینها (محصولات ژنها) ارائه میدهند که میتواند برای ساخت یا اعتبارسنجی شبکهها استفاده شود.
- دادههای اتصال فاکتور رونویسی (TF Binding Data): دادههایی مانند ChIP-seq نشان میدهند که کدام فاکتورهای رونویسی به نواحی تنظیمی کدام ژنها متصل میشوند و برای ساخت دقیقتر شبکههای تنظیمی مفید هستند.
- اطلاعات عملکردی ژن (Gene Function Annotation): پایگاههای دادهای مانند Gene Ontology (GO) یا KEGG اطلاعاتی در مورد عملکرد شناختهشده ژنها و مسیرهایی که در آن نقش دارند، فراهم میکنند که برای تفسیر و اعتبارسنجی ساختارهای شناساییشده ضروری است.
- دادههای ژنتیکی و فنوتیپی: اطلاعات مربوط به واریانتهای ژنتیکی، وضعیت بیماری یا سایر ویژگیهای فنوتیپی نمونهها میتواند برای مرتبط کردن ساختارهای شبکه با ویژگیهای بیولوژیکی خاص استفاده شود (مثلاً در تحلیل شبکه افتراقی یا GWAS).
- دادههای ترانسکریپتومیک مکانی (Spatial Transcriptomics): برای بررسی ساختارهای مرتبط با سازمان فضایی بافتها، این نوع دادهها که بیان ژن را همراه با موقعیت مکانی آن در بافت اندازهگیری میکنند، مورد نیاز است.
اغلب، ترکیب چندین نوع داده میتواند به نتایج قویتر و قابل اعتمادتری منجر شود.
میزان اطمینان به نتایج این روشها چقدر است؟
میزان اطمینان به نتایج تحلیل ساختار شبکه ژنی متغیر است و به عوامل متعددی بستگی دارد:
- کیفیت و نوع دادههای ورودی: دادههای با کیفیت پایین، دارای نویز زیاد یا حجم نمونه ناکافی میتوانند منجر به نتایج نادرست شوند. همچنین، نوع داده (مثلاً بیان ژن در مقابل تعاملات فیزیکی) بر نوع ساختارهایی که میتوان با اطمینان شناسایی کرد، تأثیر میگذارد.
- روش تحلیل انتخابشده: هر روش فرضیات و محدودیتهای خاص خود را دارد. برخی روشها ممکن است به پارامترهای خاصی حساس باشند یا برای انواع خاصی از ساختارها مناسبتر باشند.
- دقت فرآیند اعتبارسنجی: اطمینان به نتایج بهشدت به rigorous بودن فرآیند اعتبارسنجی بستگی دارد. استفاده ترکیبی از اعتبارسنجی آماری، مقایسه با دانش بیولوژیکی موجود و در صورت امکان، اعتبارسنجی با دادههای مستقل یا تجربی، سطح اطمینان را بهطور قابل توجهی افزایش میدهد.
- پیچیدگی ذاتی سیستمهای بیولوژیکی: شبکههای ژنی پویا هستند و میتوانند بین شرایط مختلف، بافتها یا حتی افراد متفاوت باشند. نتایج بهدستآمده نمایانگر یک تصویر لحظهای از شبکه در شرایط مورد مطالعه هستند.
بهطور کلی، نتایج حاصل از این تحلیلها باید بهعنوان فرضیههایی در نظر گرفته شوند که نیاز به بررسی و تأیید بیشتر دارند. هیچ روش واحدی کامل نیست و ترکیب شواهد از منابع و روشهای مختلف بهترین راه برای افزایش اطمینان به یافتهها است. شفافیت در مورد روشها، پارامترها و نتایج اعتبارسنجی برای ارزیابی قابلیت اطمینان نتایج توسط جامعه علمی ضروری است.
جستجوهای پیشنهادی برای کاوش بیشتر
- بهترین ابزارها برای ساخت شبکههای همبیانی ژنی کدامند؟
- چگونه میتوان از Gene Ontology برای تفسیر نتایج RNA-seq استفاده کرد؟
- کاربردهای تحلیل شبکه ژنی در کشف دارو چیست؟
- تفاوت بین شبکههای همبیانی و شبکههای تنظیمی ژن چیست؟
منابع
Last updated April 30, 2025