
Анализ и Назначение Кода: nonExistentUserRule.Rule = regexp.Compile(...)
Глубокое Погружение в Обработку Правил Пользователей в Go
Ключевые Моменты
- Функция
regexp.Compile(): Эта функция компилирует предоставленное регулярное выражение в объектRegexp, который затем может быть эффективно использован для сопоставления шаблонов. Компиляция важна для производительности, особенно когда одно и то же регулярное выражение используется многократно. - Функция
strings.TrimPrefix(): Используется для удаления указанного префикса из строки. В данном коде она удаляет символ!изtokens[0], подготавливая его для использования в регулярном выражении. Это указывает на инверсию или исключение. - Форматирование Регулярного Выражения (
fmt.Sprintf("^%s$"): Строка^%s$создает регулярное выражение, которое точно соответствует всей строке.^обозначает начало строки, а$— конец, гарантируя, что шаблон совпадает только с полными строками, а не с подстроками.
Предоставленный фрагмент кода на Go играет ключевую роль в динамической обработке правил, связанных с несуществующими пользователями, используя регулярные выражения. Он демонстрирует эффективное сочетание строковых манипуляций и мощных возможностей пакета regexp для создания гибких и надежных механизмов сопоставления. Этот код, вероятно, является частью системы, которая определяет, следует ли применять определенное правило к пользователю, основываясь на его имени, возможно, исключая определенных пользователей из общего правила или применяя специальные условия для них.
Разбор Фрагмента Кода
Давайте подробно рассмотрим каждую часть этого кода, чтобы понять его функциональность и назначение.
Назначение nonExistentUserRule.Rule
Переменная nonExistentUserRule (вероятно, структура или объект) содержит поле Rule, которое предназначено для хранения скомпилированного регулярного выражения. Это позволяет многократно использовать одно и то же правило без необходимости повторной компиляции, что значительно повышает производительность. В Go, объекты *regexp.Regexp потокобезопасны для сопоставления, что делает их идеальными для использования в многопоточных приложениях.
Использование regexp.Compile()
Функция regexp.Compile(pattern string) (*Regexp, error) является центральной частью этого фрагмента. Она принимает строковое представление регулярного выражения и возвращает скомпилированный объект *regexp.Regexp и ошибку, если компиляция не удалась. Компиляция регулярного выражения перед его использованием является рекомендуемой практикой в Go, особенно если регулярное выражение будет применяться многократно. Это позволяет движку регулярных выражений оптимизировать шаблон, что приводит к более быстрому сопоставлению.
Пример компиляции и использования регулярного выражения:
package main

import (
    "fmt"
    "regexp"
)

func main() {
    // Компилируем регулярное выражение
    re, err := regexp.Compile("a.b")
    if err != nil {
        fmt.Println("Ошибка компиляции:", err)
        return
    }

    // Используем скомпилированное выражение для сопоставления строк
    fmt.Println(re.MatchString("axb")) // true
    fmt.Println(re.MatchString("acb")) // true
    fmt.Println(re.MatchString("ab"))  // false
}
В контексте предоставленного кода, regexp.Compile() пытается скомпилировать шаблон, который будет использоваться для проверки имени пользователя. Если шаблон некорректен, возвращается ошибка, и функция, в которой находится этот код, также возвращает ошибку, сигнализируя о невозможности создания правила.
Роль fmt.Sprintf("^%s$", strings.TrimPrefix(tokens[0], "!"))
Эта часть кода отвечает за формирование строкового шаблона регулярного выражения.
Манипуляции со Строкой: strings.TrimPrefix(tokens[0], "!")
Функция strings.TrimPrefix(s, prefix string) string из пакета strings возвращает строку s без указанного ведущего префикса. Если строка s не начинается с prefix, возвращается исходная строка без изменений. В данном случае, tokens[0] — это первый элемент в некотором массиве или слайсе строк (предположительно, полученный из парсинга конфигурации или входных данных). Код удаляет символ ! из начала этой строки. Это очень важный аспект, поскольку префикс ! часто используется для инверсии или исключения в правилах. Например, если tokens[0] содержит "!admin", то strings.TrimPrefix() превратит его в "admin". Это подразумевает, что исходное правило могло быть "не применять для администратора", а затем скомпилированное регулярное выражение будет проверять на "администратора".
Пример работы strings.TrimPrefix:
package main

import (
    "fmt"
    "strings"
)

func main() {
    s1 := "!admin"
    trimmed1 := strings.TrimPrefix(s1, "!")
    fmt.Println(trimmed1) // Вывод: admin

    s2 := "user123"
    trimmed2 := strings.TrimPrefix(s2, "!")
    fmt.Println(trimmed2) // Вывод: user123 (строка не изменилась, так как префикс не найден)
}
Форматирование с fmt.Sprintf("^%s$")
Функция `fmt.Sprintf()` используется для форматирования строки по заданному шаблону. Шаблон `"^%s$"` является ключевым для создания точного соответствия регулярного выражения:
- `^` (карет): Этот якорь регулярного выражения соответствует началу строки.
- `%s`: Это заполнитель для строки, куда будет вставлен результат `strings.TrimPrefix(tokens[0], "!")`.
- `$` (знак доллара): Этот якорь регулярного выражения соответствует концу строки.
Таким образом, если `strings.TrimPrefix(tokens[0], "!")` возвращает `"admin"`, то полное регулярное выражение будет `^admin$`. Это регулярное выражение будет соответствовать только строке, которая ТОЧНО является `"admin"`, и ничему другому (например, не "admin_user" или "myadmin"). Это гарантирует, что правило применяется только к полным, определенным именам пользователей.
Обработка Ошибок
Блок `if err != nil { return nil, nonExistentUserRule, nil }` является стандартным для Go способом обработки ошибок. Если `regexp.Compile()` возвращает ошибку (например, из-за некорректного синтаксиса регулярного выражения), функция прерывает выполнение и возвращает соответствующие значения, указывающие на сбой операции. В данном случае, возвращается `nil` для первого возвращаемого значения, `nonExistentUserRule` (возможно, для частичного состояния или чтобы сообщить о конкретном правиле, которое вызвало ошибку), и `nil` для третьего возвращаемого значения (если есть). Это указывает на то, что операция компиляции правила не удалась.
Контекст и Применение
Этот фрагмент кода, вероятно, является частью более крупной системы, которая управляет доступом, идентификацией пользователей или правилами безопасности. Его использование подразумевает, что система может динамически определять критерии для "несуществующих" или "исключенных" пользователей на основе предопределенных шаблонов.
Сценарии Использования
Представьте систему управления доступом, где администратор хочет исключить определенные имена пользователей из стандартных проверок или применить к ним особые правила. Например:
- Исключение системных пользователей: Если `tokens[0]` это `"!root"`, `"!guest"`, то регулярное выражение будет `^root$` или `^guest$`. Это правило затем может использоваться для проверки, если текущий пользователь не является 'root' или 'guest', чтобы применить к нему стандартные правила.
- Специальные правила для определенных пользователей: Если префикс `!` отсутствует, например `tokens[0]` это `"test_user"`, то регулярное выражение `^test_user$` может использоваться для применения специфических правил только к этому пользователю.
- Валидация пользовательского ввода: В некоторых случаях, необходимо проверить, соответствует ли введенное имя пользователя определенным строгим критериям (например, отсутствию специальных символов или совпадению с разрешенным списком).
Влияние на Производительность
Компиляция регулярных выражений – это относительно дорогая операция. Если этот код выполняется в цикле для каждого правила или для каждого запроса, это может привести к значительным накладным расходам. Однако, если `nonExistentUserRule.Rule` является полем структуры, которая инициализируется один раз (например, при запуске приложения или загрузке конфигурации), то накладные расходы на компиляцию будут минимальными, и преимущества многократного использования скомпилированного `Regexp` будут очевидны. Это соответствует лучшим практикам в Go для работы с регулярными выражениями.
Принимая во внимание этот аспект, рассмотрим следующую сравнительную таблицу, демонстрирующую различия в производительности при компиляции регулярных выражений в Go:
| Метод Компиляции | Преимущества | Недостатки | Сценарии Применения |
|---|---|---|---|
| Модульный уровень (глобальная переменная / `init` функция) |
|
|
Статические, часто используемые шаблоны (например, валидация email, URL). |
| Уровень функции (компиляция при каждом вызове) |
|
|
Динамические или одноразовые шаблоны, которые не могут быть скомпилированы заранее. |
Данный фрагмент кода явно склоняется к компиляции на уровне модуля или при инициализации правила, поскольку скомпилированное регулярное выражение сохраняется в поле `nonExistentUserRule.Rule`, что позволяет его переиспользование.
Графический Анализ Возможностей Regexp в Go
Для лучшего понимания того, как пакет `regexp` в Go справляется с различными задачами, включая компиляцию, сопоставление и управление ошибками, я представляю радарную диаграмму. Она отражает относительные "силы" или "слабости" пакета в различных аспектах его использования.
Анализ ключевых характеристик пакета Go `regexp`
Как видно из диаграммы, пакет `regexp` в Go обладает высокой производительностью сопоставления и хорошей потокобезопасностью, что делает его отличным выбором для высоконагруженных приложений. Гибкость паттернов и поддержка Unicode также находятся на высоком уровне. Производительность компиляции ниже скорости сопоставления, что подчеркивает важность однократной компиляции.
Визуализация Процесса Компиляции Регулярных Выражений
Чтобы еще лучше представить процесс, который происходит при компиляции регулярного выражения, рассмотрим следующее видео. Оно наглядно демонстрирует, как регулярные выражения работают и почему их компиляция важна для оптимизации.
Видео: "Regular Expression Basics for Go Programmers" от AppliedGo
Это видео объясняет основы регулярных выражений и их применение в Go, что поможет вам глубже понять концепции, лежащие в основе компиляции и использования `regexp` в данном коде.
Дополнительные Примеры и Расширения
Рассмотренный фрагмент кода является частью более широкого подхода к обработке правил. Помимо `TrimPrefix`, пакет `strings` предлагает множество других функций для манипуляции строками, таких как `TrimSuffix`, `TrimSpace`, `ReplaceAll`, которые могут быть полезны в различных сценариях. Пакет `regexp` также предоставляет методы для поиска подстрок (`FindString`, `FindAllString`), замены (`ReplaceAllString`) и разделения строк (`Split`).
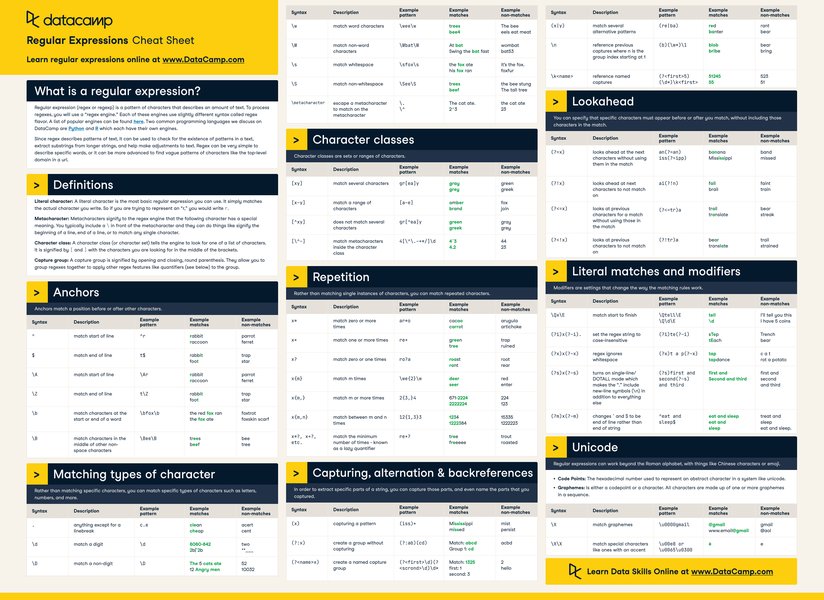
Шпаргалка по регулярным выражениям
Проверка на Существование Пользователя
Идея "несуществующего пользователя" может быть реализована различными способами. В контексте безопасности или правил доступа, проверка на несуществующего пользователя может означать:
- Пользователь не найден в базе данных или системе аутентификации.
- Пользователь исключен из действия правила (например, по имени).
- Использование заглушек или специальных зарезервированных имен.
В данном случае, регулярное выражение `^%s$` (где `%s` - это имя пользователя без префикса `!`) используется для точного сопоставления с именем пользователя. Если `tokens[0]` было `"!guest"`, то `nonExistentUserRule.Rule` скомпилируется как `^guest$`. Это правило затем может использоваться для проверки, является ли текущий пользователь "guest". Если это так, то дальнейшая логика может решить, что к этому "несуществующему" (или исключенному из обычных правил) пользователю применяются специальные условия.
Часто Задаваемые Вопросы (FAQ)
Для чего используется `regexp.Compile`?
Что делает `strings.TrimPrefix`?
Зачем нужны символы `^` и `$` в регулярном выражении?
Почему важна обработка ошибок после `regexp.Compile`?
Можно ли избежать повторной компиляции регулярного выражения?
Рекомендуемые Запросы
- Как обрабатывать ошибки в Go с помощью пакета errors
- Пакет strings в Go: все функции для работы со строками
- Примеры использования регулярных выражений в Go для валидации данных
- Лучшие практики Go для работы с регулярными выражениями и производительность
Источники
Last updated May 21, 2025