
Descenso de Gradiente: El Motor del Aprendizaje Automático
Explorando en detalle cómo y por qué se utiliza este algoritmo de optimización
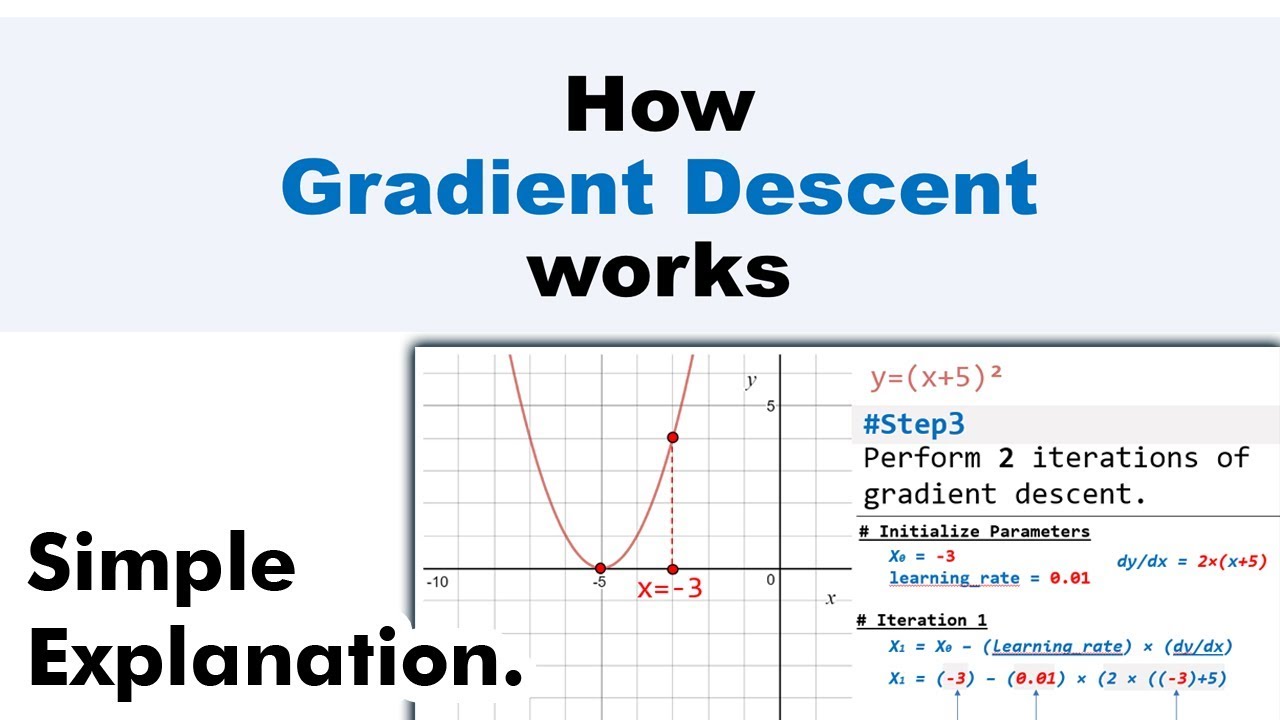
Aspectos Clave del Descenso de Gradiente
- Optimización Iterativa: Se ajustan parámetros repetidamente para minimizar funciones de coste.
- Uso Generalizado: Es fundamental para el aprendizaje automático, especialmente en redes neuronales y regresión.
- Mecanismo Basado en Gradientes: Utiliza el gradiente de la función para decidir la dirección del ajuste.
Introducción al Descenso de Gradiente
El descenso de gradiente es un algoritmo de optimización iterativo empleado para encontrar el mínimo local de funciones diferenciables. Su versión más básica se basa en ajustar parámetros iniciales mediante pasos dirigidos a la reducción del error y, por lo tanto, a la minimización de la función de coste. Esta técnica es particularmente valiosa en el aprendizaje automático, pues permite que los modelos, como redes neuronales o modelos de regresión, aprendan de los datos, ajustando sus pesos y sesgos para lograr predicciones más precisas.
En esencia, el algoritmo partiendo de una conjetura inicial, calcula el gradiente (el vector de derivadas parciales) de la función de coste para indicar la dirección en la cual la función crece de forma más rápida. Al moverse en sentido contrario a dicho gradiente, el algoritmo se aproxima al mínimo de la función.
Fundamentos Matemáticos y Conceptuales
El Papel del Gradiente
El gradiente es un vector compuesto por las derivadas parciales de la función respecto a cada uno de sus parámetros. Matemáticamente, se puede representar para una función \(\textbf{f}(\theta)\) con parámetros \(\theta = (\theta_1, \theta_2, \ldots, \theta_n)\) como:
\[ \nabla f(\theta) = \left( \frac{\partial f}{\partial \theta_1}, \frac{\partial f}{\partial \theta_2}, \ldots, \frac{\partial f}{\partial \theta_n} \right) \]
La dirección de este vector señala el camino de mayor aumento, por lo que moverse en la dirección opuesta acelera la búsqueda del mínimo local, correspondientemente reduciendo el error.
Tasa de Aprendizaje
Un componente crucial es la tasa de aprendizaje, un hiperparámetro que define el tamaño del paso en cada iteración. Una tasa de aprendizaje demasiado alta puede resultar en divergencia, haciendo que los cambios en la función sean excesivos y se pase por alto el mínimo; mientras que una tasa baja puede llevar a una convergencia lenta y prolongar el tiempo de entrenamiento.
Iteraciones y Convergencia
El algoritmo realiza iteraciones sucesivas, recalculando el gradiente y actualizando los parámetros. Este proceso se repite hasta que se satisface una condición de convergencia: ya sea alcanzar un número máximo de iteraciones o notar que la variación en la función de coste se hace insignificante.
Variantes del Descenso de Gradiente
Existen varias variantes que se adaptan a diferentes tipos de datos y necesidades computacionales, cada una con sus propias ventajas y desafíos.
Descenso de Gradiente Batch
Este método utiliza todo el conjunto de datos para calcular el gradiente en cada iteración. Aunque garantiza una actualización estable, puede resultar computacionalmente costoso en términos de tiempo y memoria, especialmente cuando se trabaja con grandes volúmenes de datos.
Descenso del Gradiente Estocástico (SGD)
El SGD realiza actualizaciones de los parámetros utilizando una sola muestra a la vez. Esto proporciona un proceso de optimización más rápido y una mayor frecuencia de actualizaciones, lo que resulta en una convergencia acelerada. Sin embargo, puede presentar variaciones en los resultados y no siempre converger de manera estable.
Descenso del Gradiente con Mini-Batches
Una solución intermedia entre Batch y Stochastic, el algoritmo de Mini-Batch divide el conjunto de datos en pequeños lotes, combinando la estabilidad del método Batch y la eficiencia del SGD. Esto permite un equilibrio óptimo entre la estabilidad de la actualización y la velocidad de convergencia.
| Tipo de Descenso de Gradiente | Descripción | Ventajas | Desventajas |
|---|---|---|---|
| Batch | Utiliza todo el conjunto de datos para calcular el gradiente. | Actualizaciones estables y consistentes. | Computacionalmente costoso; lenta en grandes datasets. |
| Estocástico (SGD) | Actualiza los parámetros con cada muestra individual. | Rápida en actualizaciones, buena para datasets muy grandes. | Actualizaciones ruidosas, puede oscilar alrededor del mínimo. |
| Mini-Batch | Divide el dataset en pequeños lotes para cada actualización. | Equilibrio entre eficiencia y estabilidad. | Requiere ajuste del tamaño del lote para optimización óptima. |
Aplicaciones y Casos de Uso
El descenso de gradiente se ha convertido en el pilar fundamental del aprendizaje automático y se aplica en diversas áreas. A continuación, se exploran algunas aplicaciones y casos de uso que ilustran la versatilidad de este algoritmo.
Entrenamiento de Redes Neuronales
En el ámbito del deep learning, el descenso de gradiente es crucial para entrenar modelos de redes neuronales. Durante este proceso, se ajustan los pesos de cada neurona para minimizar la función de coste, lo que a su vez mejora la precisión de las predicciones. Utilizando variantes como el descenso de gradiente con mini-batches o el método Adam (una extensión que adapta la tasa de aprendizaje), se logra un entrenamiento más equilibrado y eficiente.
Optimización de Modelos de Regresión
En problemas de regresión lineal o polinómica, el descenso de gradiente se emplea para minimizar la diferencia entre las predicciones del modelo y los datos reales. Aquí, el algoritmo ajusta los coeficientes del modelo para lograr la mejor aproximación a la relación subyacente en los datos.
Procesamiento de Datos y Feature Engineering
Más allá del modelado predictivo, el descenso de gradiente se utiliza para optimizar diversas funciones relacionadas con el procesamiento de datos. Esto incluye desde la selección de características relevantes hasta la optimización de parámetros en técnicas de reducción dimensional, donde el objetivo es preservar la información esencial mientras se reducen las dimensiones de los datos.
Diagnóstico Médico y Visión por Computadora
El descenso de gradiente ha encontrado aplicaciones en áreas tan críticas como la medicina, donde modelos basados en deep learning ayudan en el diagnóstico y en la detección temprana de enfermedades a partir de imágenes médicas. También se utiliza en la visión por computadora para tareas como la detección de objetos y reconocimiento facial, donde la capacidad de minimizar errores es imperativa para el desempeño del sistema.
Desafíos y Consideraciones Durante la Implementación
Aunque es un algoritmo robusto y popular, existen desafíos clave durante su implementación que deben ser tenidos en cuenta para conseguir resultados óptimos:
Selección de la Tasa de Aprendizaje
La determinación de una tasa de aprendizaje apropiada es vital para alcanzar la convergencia de forma eficiente. Un parámetro inadecuado puede llevar a problemas de divergencia o a una lenta convergencia, comprometiendo la calidad del ajuste del modelo.
Problemas de Convergencia
Durante el entrenamiento de modelos complejos, puede suceder que el descenso de gradiente se estanque en mínimos locales en lugar del óptimo global. Estratégias avanzada, como la inicialización adecuada de parámetros, el uso de técnicas de momentum o el empleo de algoritmos como Adam, pueden contribuir a superar estos problemas.
Problemas de Gradiente Explosivo y Desvanecido
Especialmente en redes neuronales profundas, los problemas de gradiente explosivo o desvanecido pueden afectar el proceso de aprendizaje. En el primero, los gradientes se vuelven extremadamente grandes, mientras que en el segundo pierden su valor a lo largo de las capas. Técnicas de normalización y estructuras de red específicas, como las redes residuales, han sido desarrolladas para mitigar estos inconvenientes.
Implementación Práctica y Ejemplos
La implementación del descenso de gradiente en proyectos de aprendizaje automático es ampliamente documentada, y existen numerosas bibliotecas en lenguajes de programación como Python que facilitan su uso. A continuación se muestra un ejemplo en pseudocódigo que ilustra la lógica básica:
  # Inicialización de parámetros
  theta = valores_iniciales
  learning_rate = alfa
  num_iterations = 1000

  # Bucle de optimización
  for i in range(num_iterations):
      # Calcular gradiente de la función de coste (derivadas parciales)
      grad = calcular_gradiente(theta)
      # Actualizar parámetros moviéndose en la dirección contraria al gradiente
      theta = theta - learning_rate * grad
      # Evaluar la función de coste para verificar la convergencia
      if convergencia(theta):
          break

  # Los parámetros ajustados se utilizarán para predicciones
En entornos de desarrollo profesional, frameworks como TensorFlow, PyTorch y Scikit-Learn implementan optimizadores basados en el descenso de gradiente, cada uno ofreciendo funciones predefinidas para simplificar el proceso de entrenamiento y ajuste fino de modelos complejos.
Comparativa de Algoritmos de Optimización
Además del descenso de gradiente básico, hay variantes y algoritmos derivados que buscan superar algunas de sus limitaciones. Se pueden mencionar:
| Algoritmo | Características | Ventajas | Uso Común |
|---|---|---|---|
| Momentum | Acumula actualizaciones pasadas para suavizar la dirección del descenso. | Convergencia más rápida y evita oscilaciones. | Redes neuronales profundas. |
| Adam | Combina ideas de Momentum y escalado de la tasa de aprendizaje. | Menos dependencia en la sintonización manual de hiperparámetros. | Aprendizaje profundo con grandes datasets. |
| RMSprop | Ajusta la tasa de aprendizaje de manera individual para cada parámetro. | Manejo eficiente de gradientes en funciones no estacionarias. | Redes neuronales recurrentes y modelos secuenciales. |
La selección del optimizador adecuado depende de la complejidad del modelo, la naturaleza de los datos y la infraestructura computacional disponible. La experimentación y validación cruzada son fundamentales para determinar la configuración óptima.
Resumen Detallado y Perspectivas Futuras
Impacto en el Aprendizaje Automático
El descenso de gradiente es de vital importancia, ya que permite que los modelos se ajusten de manera eficiente a los datos de entrenamiento, reduciendo el error y mejorando la capacidad predictiva. En varios campos, desde la visión artificial hasta el procesamiento del lenguaje natural, su rol es central para permitir la evolución y desempeño de algoritmos de IA.
Futuras Innovaciones
A medida que los desafíos computacionales se vuelven más complejos y los datasets continúan expandiéndose, la investigación en algoritmos de optimización sigue avanzando. Surgen nuevas variantes y mejoras sobre el descenso de gradiente básico, integrando técnicas de inteligencia adaptativa, automatización en la sintonización de hiperparámetros y metodologías híbridas que combinan lo mejor del aprendizaje supervisado y no supervisado. Dichas innovaciones prometen hacer el proceso de aprendizaje más robusto y eficiente, adaptándose a entornos en constante evolución y a necesidades específicas de distintas aplicaciones.
Importantes áreas de investigación incluyen el perfeccionamiento de técnicas para evitar caer en mínimos locales, mejorar la estabilidad en redes muy profundas y desarrollar métodos que permitan un escalado más efectivo en entornos distribuidos. Estas áreas requieren esfuerzos colaborativos multidisciplinarios, combinando ideas de matemáticas, computación y estadística, y permitirán que el descenso de gradiente siga siendo una herramienta fundamental en la revolución de la inteligencia artificial.
Referencias y Recursos adicionales
- Descenso del gradiente - Wikipedia
- ¿Qué es el descenso del gradiente? - IBM
- Descenso del gradiente - Google Developers
- Ejemplo de descenso del gradiente - FreeCodeCamp
- La brújula del Machine Learning - Verne Group
Consultas Relacionadas para Ampliar Conocimientos
Last updated March 25, 2025