
Магия Regex и Grep: Как Мгновенно Извлечь Доменное Имя Одной Командой?
Откройте для себя мощь grep -Eo и регулярных выражений для точного выделения доменов из любого текста.
Извлечение доменных имен из текстовых строк, URL-адресов или лог-файлов — частая задача в анализе данных, веб-разработке и системном администрировании. Команда grep в сочетании с опциями -E (расширенные регулярные выражения) и -o (вывод только совпавшей части) предоставляет элегантное и мощное решение для этой задачи с помощью всего одной строки в терминале. В этом руководстве мы подробно рассмотрим, как составить эффективное регулярное выражение для различных сценариев извлечения доменных имен.
Ключевые Моменты для Быстрого Старта
- Универсальная команда: Используйте
grep -Eo 'РЕГУЛЯРНОЕ_ВЫРАЖЕНИЕ'для извлечения доменов. Опция-Eактивирует расширенный синтаксис регулярных выражений, а-oгарантирует, что будет выведена только та часть строки, которая соответствует шаблону. - Гибкость Regex: Регулярные выражения можно адаптировать для извлечения доменов с субдоменами, только основных доменов или доменов из полных URL-адресов.
- Сложность и точность: Более сложные регулярные выражения могут потребоваться для обработки специфических случаев, таких как многокомпонентные домены верхнего уровня (например,
.co.uk) или для исключения нежелательных совпадений. Опция-P(Perl-совместимые регулярные выражения) может предоставить дополнительные возможности, такие как позиционный просмотр (lookarounds).
Основы: Команда grep -Eo и Структура Домена
Прежде чем погружаться в регулярные выражения, давайте кратко разберем команду. grep (Global Regular Expression Print) — это утилита командной строки для поиска текста по шаблону. Опции, которые нас интересуют:
-E: Интерпретирует шаблон как расширенное регулярное выражение (ERE). Это дает нам больше гибкости по сравнению с базовыми регулярными выражениями.-o: Печатает только совпавшие (непустые) части строки, причем каждая такая часть выводится на отдельной строке.
Доменное имя состоит из одной или нескольких частей, называемых "метками", разделенных точками. Например, в www.example.com, метками являются www, example, и com. Последняя метка (com) называется доменом верхнего уровня (TLD).
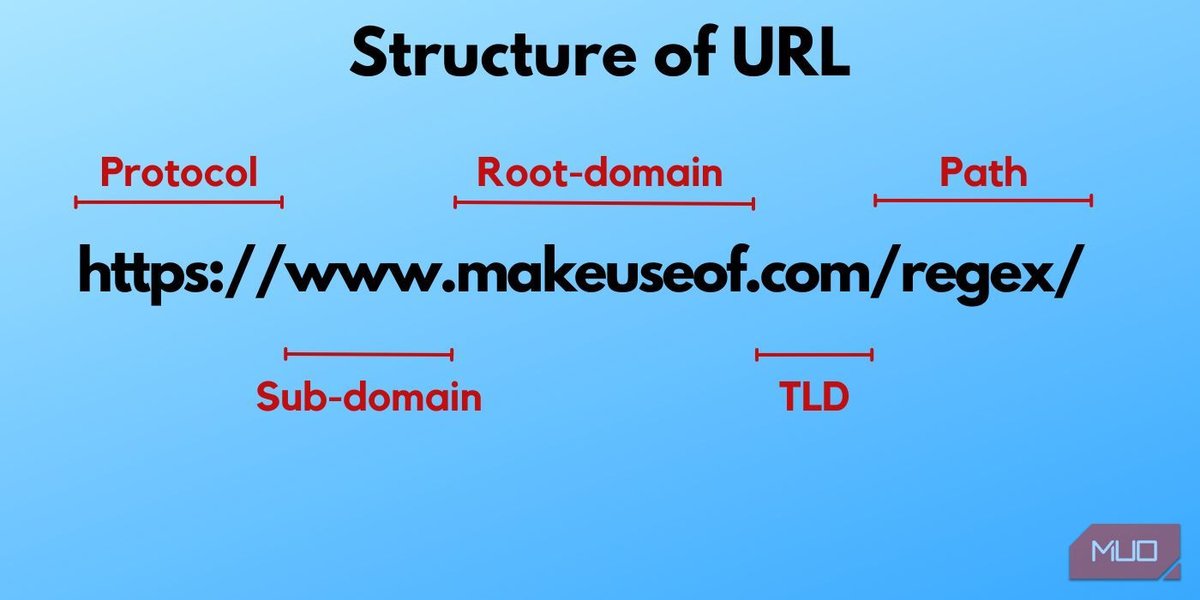
Визуализация компонентов URL-адреса, включая доменное имя.
Универсальное Регулярное Выражение для Извлечения Доменов (включая Субдомены)
Одно из наиболее полных и точных регулярных выражений для извлечения доменных имен, включая субдомены, выглядит следующим образом:
grep -Eo '([a-zA-Z0-9]([a-zA-Z0-9-]{0,61}[a-zA-Z0-9])?\.)+[a-zA-Z]{2,}'Разберем его компоненты:
[a-zA-Z0-9]: Соответствует одной букве (в любом регистре) или цифре. Это начало метки домена.[a-zA-Z0-9-]{0,61}: Соответствует последовательности из букв, цифр или дефисов длиной от 0 до 61 символа. Дефис не может быть первым или последним символом метки.([a-zA-Z0-9-]{0,61}[a-zA-Z0-9])?: Эта часть обеспечивает, что если метка содержит дефисы, она все равно заканчивается буквой или цифрой. Знак вопроса?делает эту группу необязательной, позволяя обрабатывать односимвольные метки.\.: Соответствует символу точки буквально.(...)+: Вся конструкция([a-zA-Z0-9]([a-zA-Z0-9-]{0,61}[a-zA-Z0-9])?\.)повторяется один или более раз (+), что позволяет захватывать субдомены (например,sub.илиanother.sub.).[a-zA-Z]{2,}: Соответствует домену верхнего уровня (TLD), состоящему как минимум из двух букв (например,.com,.org,.ru,.technology).
Пример использования:
echo "Посетите наш сайт http://www.example.co.uk/path или напишите на info@my-domain.com." | grep -Eo '([a-zA-Z0-9]([a-zA-Z0-9-]{0,61}[a-zA-Z0-9])?\.)+[a-zA-Z]{2,}'Результат выполнения команды:
www.example.co.uk
my-domain.com
Более простой, но менее строгий вариант, часто встречающийся в примерах:
grep -Eo '([a-zA-Z0-9-]+\.)+[a-zA-Z]{2,24}'Здесь [a-zA-Z0-9-]+ означает одну или более букв, цифр или дефисов, а [a-zA-Z]{2,24} ограничивает длину TLD от 2 до 24 символов.
Продвинутые Сценарии и Вариации Regex
В зависимости от конкретной задачи, вам могут потребоваться другие варианты регулярных выражений.
Извлечение Домена из Полного URL (без Протокола)
Если ваши данные содержат полные URL-адреса (например, http://example.com или https://sub.example.org), и вы хотите извлечь только доменное имя (example.com или sub.example.org), можно использовать регулярное выражение с позиционным просмотром вперед (positive lookbehind). Для этого потребуется опция -P (Perl-совместимые регулярные выражения), которая доступна не во всех версиях grep.
echo "URL для анализа: https://sub.very-long-domain.com/some/path?query=1" | grep -Po '(?<=:\/\/)[^/]+'Разбор regex:
(?<=:\/\/): Это позитивный просмотр назад (positive lookbehind). Он ищет последовательность://(например, вhttp://илиftp://), но не включает ее в результат.[^/]+: Соответствует одному или более символам, которые не являются слешем (/). Это захватывает все до первого слеша, который обычно отделяет домен от пути в URL.
Результат:
sub.very-long-domain.comИзвлечение Только Основного Домена (без Субдоменов)
Эта задача сложнее, особенно если нужно корректно обрабатывать многокомпонентные TLD, такие как .co.uk или .com.au. Простое регулярное выражение для grep -Eo может дать приблизительные результаты. Для точного решения часто требуются более сложные инструменты или скрипты, которые могут учитывать список известных публичных суффиксов (Public Suffix List).
Простой подход, который может сработать для TLD типа .com, .net (но может ошибаться на .co.uk, захватив co.uk вместо example.co.uk):
echo "www.sub.example.com" | grep -Eo '[^.]+\.[a-zA-Z]{2,6}$'Результат:
example.comДля более точного (но все еще не идеального) подхода, который пытается учесть двухкомпонентные TLD типа name.co.uk:
echo "my.site.co.uk other.domain.com" | grep -Eo '[a-zA-Z0-9-]+\.([a-zA-Z]{2,6}|[a-zA-Z]{2}\.[a-zA-Z]{2})$'Этот шаблон пытается захватить либо имя.tld, либо имя.двухбуквенный_tld.двухбуквенный_cc_tld.
Извлечение Домена из Контекста (например, после определенной фразы)
Иногда доменное имя следует за определенным маркером в тексте. Например, если у вас есть строки вида "From Domain test.co.uk Inbound":
echo "Log entry: 17541 From Domain test.co.uk Inbound" | grep -Po '(?<=From Domain )[^[:space:]]+'Разбор regex:
(?<=From Domain ): Позитивный просмотр назад, ищет текст "From Domain " (с пробелом в конце).[^[:space:]]+: Соответствует одному или более символам, не являющимся пробельными.
Результат:
test.co.ukСравнительный Анализ Regex Паттернов
Различные регулярные выражения предлагают компромисс между простотой, точностью и гибкостью. Представленный ниже радарный график иллюстрирует относительные сильные стороны нескольких подходов к извлечению доменных имен. Оценки являются экспертным мнением и предназначены для сравнительной иллюстрации.
Этот график помогает визуализировать, что более простые Regex могут быть менее точны в сложных случаях (например, при обработке поддоменов или специфичных TLD), тогда как более сложные выражения, использующие, например, lookarounds, могут предложить большую точность для конкретных задач, таких как извлечение из URL, но при этом быть сложнее в написании и поддержке.
Таблица Регулярных Выражений для grep -Eo
Ниже приведена таблица с различными регулярными выражениями и их предназначением для извлечения доменных имен:
| Сценарий | Регулярное выражение | Опции grep |
Примечания |
|---|---|---|---|
| Общее извлечение (с поддоменами, строгий вариант) | ([a-zA-Z0-9]([a-zA-Z0-9-]{0,61}[a-zA-Z0-9])?\.)+[a-zA-Z]{2,} |
-Eo |
Захватывает полные доменные имена, включая субдомены. Соответствует стандартам длины меток. |
| Общее извлечение (с поддоменами, упрощенный вариант) | ([a-zA-Z0-9-]+\.)+[a-zA-Z]{2,24} |
-Eo |
Более простой шаблон, захватывает домены с TLD длиной 2-24 символа. |
Извлечение из URL (после ://) |
(?<=:\/\/)[^/]+ |
-Po |
Использует lookbehind (Perl-совместимое). Требуется grep с поддержкой -P. |
| Только основной домен (простой, для TLD типа .com) | [^.]+\.[a-zA-Z]{2,6}$ |
-Eo |
Пытается извлечь домен второго уровня и TLD. Может некорректно работать с TLD типа co.uk. $ указывает на конец строки или строки перед переводом строки. |
Основной домен с учетом TLD типа co.uk (приблизительно) |
[a-zA-Z0-9-]+\.([a-zA-Z]{2,6}|[a-zA-Z]{2}\.[a-zA-Z]{2})$ |
-Eo |
Более сложный шаблон для попытки учесть двухкомпонентные TLD. Требует тщательного тестирования. |
| Извлечение из определенного текста (например, после "From Domain ") | (?<=From Domain )[^[:space:]]+ |
-Po |
Извлекает домен, следующий за указанным текстом "From Domain ". |
Визуализация Процесса: Карта Мыслей для Извлечения Доменов
Для лучшего понимания того, как grep и регулярные выражения работают вместе для извлечения доменных имен, рассмотрим следующую карту мыслей. Она иллюстрирует ключевые компоненты команды, структуру доменного имени и основные элементы регулярных выражений, используемых в процессе.
с grep -Eo"] id1["Команда grep"] id1a["-E (Расширенные Regex)"] id1b["-o (Только совпадение)"] id1c["-P (Perl Regex,
опционально для lookarounds)"] id2["Компоненты
доменного имени"] id2a["Метки (subdomain, domain)"] id2aa["Символы: a-z, A-Z, 0-9, -"] id2ab["Разделитель: . (точка)"] id2ac["Ограничения длины
(до 63 символов на метку)"] id2b["TLD (Top-Level Domain)"] id2ba["Общие: .com, .org, .net"] id2bb["Страновые: .ru, .uk, .de"] id2bc["Новые (gTLDs): .онлайн, .сайт, .tech"] id2bd["Многокомпонентные:
.co.uk, .com.au"] id3["Типы регулярных выражений"] id3a["Захват с поддоменами"] id3b["Захват только
основного домена"] id3c["Извлечение из URL
(с учетом протокола)"] id3d["Извлечение по контексту
(после ключевых слов)"] id4["Ключевые элементы Regex"] id4a["Символьные классы: [a-zA-Z0-9-]"] id4b["Квантификаторы: +, *, ?, {n,m}"] id4c["Группировка: (...)"] id4d["Альтернатива: |"] id4e["Экранирование спецсимволов: \., \?, \+"] id4f["Якоря: ^ (начало строки), $ (конец строки)"] id4g["Lookarounds (с -P): (?<=...), (?=...), (?!...), (?<!...)"]
Эта карта мыслей подчеркивает, что успешное извлечение доменов зависит от правильного использования опций grep и тщательного построения регулярного выражения, которое точно описывает структуру искомых доменных имен в вашем конкретном наборе данных.
Видеоурок по Регулярным Выражениям
Для более глубокого понимания концепций регулярных выражений, которые являются основой для работы с grep при извлечении доменных имен, рекомендуем ознакомиться со следующим видео. Оно объясняет основы синтаксиса и логики Regex, что поможет вам не только использовать готовые шаблоны, но и создавать свои собственные для различных задач обработки текста.
Это видео ("Regular Expressions (Regex) Tutorial: How to Match Any...") предоставляет отличное введение в мир регулярных выражений, объясняя, как они работают и как их можно использовать для поиска и манипулирования текстом. Понимание этих основ критически важно для эффективного использования grep.
Важные Соображения
- Определение "валидного" домена: Стандарты доменных имен (RFC 1035, RFC 1123, RFC 2181, RFC 5890-5895 для IDN) довольно сложны. Простые регулярные выражения могут не покрывать все крайние случаи или, наоборот, захватывать невалидные строки. Например, метки домена не должны начинаться или заканчиваться дефисом, а общая длина доменного имени ограничена.
- Интернационализированные доменные имена (IDN): Стандартные регулярные выражения, использующие
[a-zA-Z0-9-], не будут корректно обрабатывать IDN (например,пример.рф), если они не представлены в Punycode (например,xn--e1afmkfd.xn--p1ai). Для работы с IDN в их нативном виде могут потребоваться специализированные инструменты или библиотеки, поддерживающие Unicode. - Локаль и символьные классы: Для предсказуемой работы символьных классов (например,
[:alnum:],[:space:]) с ASCII символами, особенно в скриптах, иногда полезно установить локальLC_ALL=Cперед вызовомgrep. Например:LC_ALL=C grep -Eo .... - Тестирование: Всегда тщательно тестируйте ваши регулярные выражения на репрезентативном наборе данных. Существуют онлайн-инструменты (например, regex101.com, regextester.com), которые позволяют в интерактивном режиме создавать и отлаживать регулярные выражения.
- Производительность: Очень сложные регулярные выражения, особенно с большим количеством вложенных групп и обратных ссылок, могут быть медленными на больших объемах данных.
Часто Задаваемые Вопросы (FAQ)
Что означают опции -E и -o в команде grep?
Опция -E указывает grep использовать расширенный синтаксис регулярных выражений (ERE). Это позволяет использовать более удобные и мощные метасимволы, такие как +, ?, |, и группировку () без необходимости их экранирования обратным слешем (как в базовых регулярных выражениях).
Опция -o (от "only-matching") заставляет grep выводить только ту часть строки, которая совпала с регулярным выражением, а не всю строку целиком. Каждое совпадение выводится на новой строке, что очень удобно для извлечения конкретных данных.
Как обрабатывать интернационализированные доменные имена (IDN) с помощью `grep`?
Стандартные регулярные выражения в `grep`, основанные на ASCII символах (например, [a-zA-Z0-9-]), не распознают символы Unicode, используемые в IDN (например, кириллические или китайские домены) в их естественном представлении. `grep` будет корректно работать с IDN, если они представлены в формате Punycode (например, xn--e1afmkfd.xn--p1ai для пример.рф), так как Punycode использует только ASCII символы.
Для прямой работы с IDN в Unicode могут потребоваться версии `grep` с поддержкой Unicode (например, через опцию -P для PCRE, если библиотека PCRE скомпилирована с поддержкой Unicode и UTF-8) или использование других инструментов, таких как `perl`, `python`, или специализированные утилиты, которые лучше справляются с обработкой Unicode.
Может ли `grep -Eo` проверить, существует ли домен на самом деле?
Нет, `grep -Eo` только извлекает строки, которые соответствуют заданному регулярному выражению. Он не выполняет никаких DNS-запросов или других проверок для определения, является ли извлеченное доменное имя зарегистрированным, активным или доступным в сети Интернет. Для проверки существования домена необходимо использовать другие утилиты, такие как `dig`, `host`, `nslookup`, или скрипты, взаимодействующие с DNS-серверами.
Что если я хочу извлечь только домен верхнего уровня (TLD)?
Если у вас уже есть извлеченное полное доменное имя (например, www.example.com), и вы хотите получить только TLD (com), вы можете использовать другой `grep` или инструменты вроде `awk`, `sed`, или `cut`. Например, если домен уже извлечен:
echo "www.example.com" | grep -Eo '[a-zA-Z]{2,}$'Эта команда попытается извлечь последнюю часть, состоящую из букв. Однако, для более сложного извлечения TLD из полного доменного имени (особенно для многокомпонентных TLD типа co.uk), лучше использовать специализированные инструменты или более сложные скрипты. Если же вы хотите извлечь TLD напрямую из исходной строки, вам потребуется регулярное выражение, которое сначала находит полное доменное имя, а затем захватывает только его последнюю часть. Это может быть сложнее реализовать одной командой `grep -Eo` без промежуточных шагов.
Например, чтобы извлечь TLD из строки, можно попробовать так:
echo "http://example.co.uk" | grep -Eo '([a-zA-Z0-9-]+\.)*([a-zA-Z]{2,})(\.[a-zA-Z]{2})?$' | grep -Eo '[a-zA-Z]+$'Это двухэтапный `grep` или требует более сложного regex, возможно с `awk` или `sed` для лучшего результата: echo "http://example.co.uk" | grep -Eo '([a-zA-Z0-9]([a-zA-Z0-9-]{0,61}[a-zA-Z0-9])?\.)+[a-zA-Z]{2,}' | awk -F. '{print $NF}' (для простых TLD) или awk -F. '{if (NF>2 && length($(NF-1))==2 && length($NF)==2) print $(NF-1)"."$NF; else print $NF}' (для попытки учесть co.uk).
Как я могу протестировать свои регулярные выражения?
Существует множество онлайн-инструментов для тестирования и отладки регулярных выражений. Некоторые популярные из них:
- regex101.com: Очень популярный инструмент с поддержкой различных "движков" regex (PCRE, Python, JavaScript и др.), подсветкой синтаксиса, объяснением каждого компонента вашего выражения и возможностью тестирования на примерах строк.
- regextester.com: Еще один удобный онлайн-тестер.
- debuggex.com: Визуализирует ваше регулярное выражение в виде диаграммы, что может помочь понять его структуру.
При тестировании важно использовать разнообразные примеры входных данных, включая те, которые должны совпасть, и те, которые не должны, а также различные крайние случаи, чтобы убедиться, что ваше регулярное выражение работает корректно.
Рекомендуемые Запросы для Дальнейшего Изучения
- Как использовать sed для извлечения и замены доменных имен в файлах?
- Продвинутые техники grep для анализа лог-файлов веб-сервера.
- Сравнение производительности grep, awk и sed для обработки больших текстовых файлов.
- Написание скриптов на bash для автоматизации извлечения данных с использованием регулярных выражений.
Источники и Полезные Ссылки
Last updated May 12, 2025