
Svelare i Segreti del Calcolo Parallelo: Come Far Lavorare Insieme i Processori per Te!
Scopri come trasformare compiti complessi in operazioni fulminee sfruttando la potenza di più unità di calcolo.
Il calcolo parallelo è una tecnica rivoluzionaria che permette di accelerare significativamente l'elaborazione di compiti complessi. Invece di affrontare un problema un passo alla volta, il calcolo parallelo lo scompone in parti più piccole che vengono risolte contemporaneamente da più processori o core. Immagina una squadra di operai che costruisce una casa: invece di un solo operaio che fa tutto, ogni membro della squadra lavora su una parte diversa contemporaneamente, completando il progetto molto più rapidamente. Questo è, in essenza, il principio del calcolo parallelo.
Punti Chiave del Calcolo Parallelo
- Esecuzione Simultanea: Il cuore del calcolo parallelo è l'esecuzione di molteplici calcoli o processi nello stesso istante, utilizzando più unità di elaborazione.
- Suddivisione del Lavoro: I problemi complessi vengono scomposti in sotto-compiti più piccoli e gestibili, distribuiti tra le risorse di calcolo disponibili.
- Aumento delle Prestazioni: L'obiettivo primario è ridurre drasticamente i tempi di elaborazione, risolvere problemi più grandi e migliorare l'efficienza generale.
Le Fasi Fondamentali per Implementare il Calcolo Parallelo
Realizzare un calcolo parallelo efficace richiede un approccio strutturato. Ecco i passaggi cruciali coinvolti:
1. Decomposizione del Problema (Partitioning)
Identificare il Parallelismo Intrinseco
Il primo passo, e forse il più critico, è analizzare il problema per identificare le parti che possono essere eseguite in modo indipendente o con minima interdipendenza. Non tutti i problemi si prestano facilmente alla parallelizzazione. Compiti che coinvolgono calcoli numerici intensivi, simulazioni, elaborazione di grandi moli di dati (come immagini o dataset scientifici) sono generalmente buoni candidati. La qualità di questa scomposizione influisce direttamente sull'efficienza del calcolo parallelo.
Esistono diverse strategie di decomposizione:
- Decomposizione dei dati (Data Parallelism): Lo stesso calcolo viene applicato a diversi sottoinsiemi di dati. Ad esempio, elaborare diverse porzioni di un'immagine contemporaneamente.
- Decomposizione dei compiti (Task Parallelism): Diverse operazioni o funzioni vengono eseguite in parallelo. Ad esempio, in una simulazione complessa, un processore potrebbe gestire la fisica, un altro la grafica e un altro l'intelligenza artificiale.
2. Distribuzione dei Compiti (Mapping)
Assegnare il Lavoro alle Unità di Calcolo
Una volta che il problema è stato scomposto in sotto-compiti (chiamati anche task o thread), questi devono essere assegnati alle unità di elaborazione disponibili. Queste unità possono essere i core di un processore multi-core, processori distinti in un sistema multi-processore, nodi di un cluster di computer, o le migliaia di core di una GPU (Graphics Processing Unit).
L'obiettivo è bilanciare il carico di lavoro (load balancing) tra le unità, assicurando che nessuna unità rimanga inattiva mentre altre sono sovraccariche. Una distribuzione non uniforme può creare colli di bottiglia, limitando i benefici del parallelismo.
Un supercomputer come l'IBM Blue Gene/P, esempio di architettura hardware avanzata utilizzata per il calcolo parallelo su larga scala.
3. Esecuzione Parallela
Lavorare in Simultanea
In questa fase, ogni unità di elaborazione esegue il compito o i compiti che le sono stati assegnati. L'esecuzione avviene contemporaneamente, portando a una potenziale riduzione significativa del tempo totale di calcolo rispetto a un'esecuzione sequenziale tradizionale, dove ogni operazione viene eseguita una dopo l'altra su un singolo processore.
4. Comunicazione e Sincronizzazione
Coordinare gli Sforzi
Raramente i sotto-compiti sono completamente indipendenti. Spesso, le unità di elaborazione necessitano di scambiare dati intermedi o di coordinare le loro azioni. Questa fase è cruciale per garantire la correttezza dei risultati e per ottimizzare le prestazioni.
- Comunicazione: Meccanismi per lo scambio di dati tra processi o thread. Questo può avvenire tramite memoria condivisa (dove più processori accedono alla stessa area di memoria) o passaggio di messaggi (message passing, dove i dati vengono inviati esplicitamente da un processo all'altro, tipico dei sistemi a memoria distribuita).
- Sincronizzazione: Meccanismi per ordinare gli eventi e gestire l'accesso a risorse condivise, evitando condizioni di errore come le "race conditions" (dove il risultato dipende dall'ordine imprevedibile di accesso ai dati) o i "deadlock" (dove due o più processi si bloccano a vicenda aspettando risorse). Esempi di primitive di sincronizzazione includono semafori, mutex e barriere.
L'overhead introdotto dalla comunicazione e dalla sincronizzazione può limitare il guadagno di velocità (speedup) ottenibile. Algoritmi paralleli efficienti cercano di minimizzare questa comunicazione.
5. Aggregazione dei Risultati
Ricostruire la Soluzione Finale
Una volta che tutte le unità di elaborazione hanno completato i loro compiti, i risultati parziali devono essere combinati o aggregati per produrre la soluzione finale del problema originale. Questa fase può richiedere ulteriori calcoli o semplice raccolta di dati.
Architetture Hardware per il Calcolo Parallelo
Il calcolo parallelo si basa su hardware con capacità di elaborazione multipla. Le principali architetture includono:
- Sistemi a Memoria Condivisa (Shared Memory): Tutti i processori (o core) condividono un unico spazio di indirizzamento di memoria. La comunicazione è veloce poiché i dati non devono essere copiati tra spazi di memoria distinti. Esempi comuni sono i moderni PC multi-core.
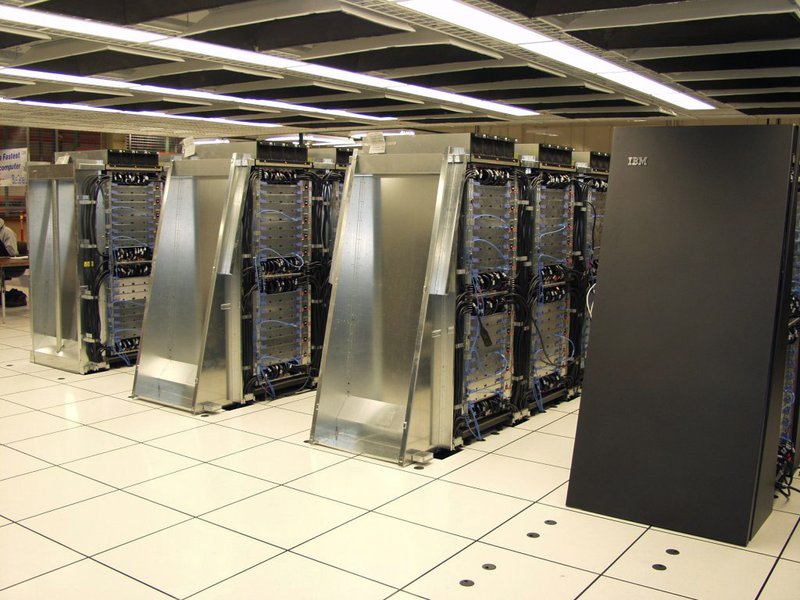
Illustrazione di un'architettura di calcolatore parallelo con memoria condivisa, dove più processori accedono a una memoria comune.
- Sistemi a Memoria Distribuita (Distributed Memory): Ogni processore ha la propria memoria locale privata. La comunicazione avviene esplicitamente tramite una rete di interconnessione, inviando e ricevendo messaggi. I cluster di computer e i supercomputer massivamente paralleli rientrano in questa categoria.
- Sistemi Ibridi: Combinano aspetti delle architetture a memoria condivisa e distribuita. Ad esempio, un cluster può essere composto da nodi, ognuno dei quali è un sistema multi-core a memoria condivisa.
- GPU (Graphics Processing Units): Originariamente progettate per la grafica, le GPU moderne contengono migliaia di core più semplici, ideali per il parallelismo di dati su larga scala (SIMD - Single Instruction, Multiple Data).
Strumenti Software e Modelli di Programmazione
La programmazione parallela richiede strumenti e approcci specifici per sfruttare l'hardware sottostante. Alcuni dei modelli e delle librerie più diffusi includono:
OpenMP (Open Multi-Processing)
È uno standard API per la programmazione parallela su architetture a memoria condivisa. Permette di parallelizzare codice C, C++ e Fortran tramite direttive del compilatore (pragma). È relativamente facile da integrare in codice sequenziale esistente, specialmente per parallelizzare cicli (loop).
  // Esempio di ciclo parallelizzato in C con OpenMP
  #pragma omp parallel for
  for (int i = 0; i < N; i++) {
      array[i] = nequalche_calcolo(i); // Questa operazione viene eseguita in parallelo per diverse i
  }
MPI (Message Passing Interface)
È uno standard de facto per la programmazione parallela su architetture a memoria distribuita (ma può essere usato anche su sistemi a memoria condivisa). Definisce una libreria di funzioni per inviare e ricevere messaggi tra processi che possono risiedere su nodi di calcolo diversi. MPI offre un controllo molto fine sulla comunicazione e sulla distribuzione del lavoro, ma è generalmente più complesso da programmare rispetto a OpenMP.
  // Esempio concettuale di invio/ricezione in C con MPI
  #include <mpi.h>

  int main(int argc, char *argv[]) {
      MPI_Init(&argc, &argv);
      int rank, size;
      MPI_Comm_rank(MPI_COMM_WORLD, &rank); // Ottiene l'ID del processo corrente
      MPI_Comm_size(MPI_COMM_WORLD, &size); // Ottiene il numero totale di processi

      if (rank == 0) {
          // Il processo master invia dati al processo worker
          int data_to_send = 42;
          MPI_Send(&data_to_send, 1, MPI_INT, 1, 0, MPI_COMM_WORLD);
      } else if (rank == 1) {
          // Il processo worker riceve dati dal processo master
          int received_data;
          MPI_Recv(&received_data, 1, MPI_INT, 0, 0, MPI_COMM_WORLD, MPI_STATUS_IGNORE);
          // Elabora received_data
      }
      MPI_Finalize();
      return 0;
  }
CUDA (Compute Unified Device Architecture) e OpenCL (Open Computing Language)
CUDA è una piattaforma di calcolo parallelo e un modello di programmazione sviluppato da NVIDIA per le sue GPU. OpenCL è uno standard aperto per la programmazione parallela su piattaforme eterogenee, che include CPU, GPU e altri processori. Entrambi permettono di sfruttare l'enorme parallelismo offerto dalle GPU per calcoli scientifici e di altro tipo (GPGPU - General-Purpose computing on Graphics Processing Units).
Altri Linguaggi e Librerie
Molti linguaggi moderni offrono supporto integrato o librerie per il calcolo parallelo e concorrente. Ad esempio:
- Python: Librerie come `multiprocessing`, `threading`, `asyncio`, e framework come Dask e Ray.
- Java: Thread, Executor Framework, Fork/Join Framework.
- MATLAB: Parallel Computing Toolbox™ permette di parallelizzare applicazioni MATLAB e Simulink su multicore, GPU e cluster.
- Julia: Progettato nativamente per il calcolo ad alte prestazioni, con funzionalità integrate per il calcolo parallelo.
La scelta del modello di programmazione e degli strumenti dipende dall'architettura hardware, dalla natura del problema e dalle competenze dello sviluppatore.
Tabella Comparativa dei Modelli di Programmazione Parallela
La seguente tabella offre un confronto tra alcuni dei principali modelli di programmazione parallela, evidenziando le loro caratteristiche distintive e i casi d'uso tipici.
| Caratteristica | OpenMP | MPI | CUDA/OpenCL |
|---|---|---|---|
| Modello di Memoria Primario | Condivisa | Distribuita | Condivisa (sul dispositivo GPU) / Distribuita (tra host e dispositivo) |
| Unità di Parallelismo | Thread | Processi | Kernel (eseguiti da molti thread sulla GPU) |
| Comunicazione | Variabili condivise, direttive di sincronizzazione | Passaggio di messaggi esplicito (Send/Recv) | Memoria globale/condivisa sulla GPU, trasferimenti DMA tra host e dispositivo |
| Complessità di Programmazione | Relativamente bassa | Alta | Moderata-Alta (specifica per GPU) |
| Scalabilità | Limitata dal numero di core su un singolo nodo | Elevata, su molti nodi di un cluster | Elevatissima su una singola GPU (migliaia di core) |
| Caso d'Uso Tipico | Parallelizzazione di loop e sezioni di codice su sistemi multicore | Applicazioni scientifiche su larga scala su cluster e supercomputer | Calcoli massivamente paralleli, elaborazione di immagini/video, machine learning |
Analisi Comparativa delle Tecniche di Calcolo Parallelo
Per comprendere meglio le sfumature tra i diversi approcci al calcolo parallelo, un grafico radar può illustrare come si posizionano rispetto a vari criteri chiave. Questo grafico rappresenta una valutazione qualitativa basata su considerazioni generali.
Questo grafico illustra come OpenMP sia generalmente più facile da implementare ma meno scalabile su larga scala rispetto a MPI. MPI eccelle in scalabilità ma comporta un maggiore overhead di comunicazione e complessità. Le soluzioni basate su GPU (CUDA/OpenCL) offrono un'enorme potenza di calcolo per tipi specifici di problemi, ma con una maggiore dipendenza dall'hardware. Le librerie Python come Multiprocessing offrono un buon equilibrio per molti casi d'uso, specialmente per lo sviluppo rapido.
Mappa Concettuale del Calcolo Parallelo
Per una visione d'insieme delle interconnessioni tra i vari aspetti del calcolo parallelo, una mappa mentale può essere molto utile. Questa mappa illustra i concetti chiave e le loro relazioni.
Esecuzione simultanea di compiti"] id2["Fasi Fondamentali"] id2_1["Decomposizione
(Partitioning)"] id2_2["Distribuzione
(Mapping)"] id2_3["Esecuzione Parallela"] id2_4["Comunicazione e Sincronizzazione"] id2_5["Aggregazione Risultati"] id3["Architetture Hardware"] id3_1["Memoria Condivisa
(es. PC multicore)"] id3_2["Memoria Distribuita
(es. Cluster, Supercomputer)"] id3_3["GPU"] id3_4["Sistemi Ibridi"] id4["Strumenti e Modelli"] id4_1["OpenMP
(Memoria Condivisa)"] id4_2["MPI
(Message Passing)"] id4_3["CUDA / OpenCL
(GPU Computing)"] id4_4["Librerie Linguaggi
(Python, Java, Julia)"] id5["Vantaggi"] id5_1["Riduzione Tempi Esecuzione (Speedup)"] id5_2["Scalabilità
(Risolvere problemi più grandi)"] id5_3["Migliore Utilizzo Risorse"] id5_4["Tolleranza ai Guasti (in alcuni sistemi)"] id6["Sfide"] id6_1["Complessità di Programmazione"] id6_2["Overhead di Comunicazione"] id6_3["Sincronizzazione e Deadlock"] id6_4["Bilanciamento del Carico (Load Balancing)"] id6_5["Scalabilità Limitata (Legge di Amdahl)"] id7["Applicazioni"] id7_1["Simulazioni Scientifiche
(Clima, Fisica)"] id7_2["Analisi Big Data e Machine Learning"] id7_3["Rendering Grafico e Video"] id7_4["Crittoanalisi"] id7_5["Previsioni Finanziarie"] id7_6["Bioinformatica
(Analisi DNA)"]
Questa mappa mentale evidenzia come il calcolo parallelo sia un campo multidisciplinare che coinvolge la comprensione dell'hardware, lo sviluppo di software specifico, e la gestione attenta delle risorse e delle comunicazioni per ottenere i benefici desiderati in una vasta gamma di applicazioni.
Vantaggi e Sfide del Calcolo Parallelo
Vantaggi Principali
- Velocità di Esecuzione (Speedup): Il vantaggio più evidente è la riduzione del tempo necessario per completare un calcolo. Lo speedup ideale sarebbe proporzionale al numero di processori utilizzati, anche se fattori come l'overhead di comunicazione e la porzione seriale del codice (Legge di Amdahl) limitano questo guadagno.
- Capacità di Risolvere Problemi Più Grandi (Scalability): Il calcolo parallelo permette di affrontare problemi che sarebbero intrattabili su un singolo processore a causa dei limiti di memoria o del tempo di calcolo.
- Migliore Utilizzo delle Risorse Hardware: Sfrutta appieno la potenza dei moderni processori multicore e dei cluster.
- Efficienza Energetica (in alcuni casi): Utilizzare più core a frequenze più basse può essere più efficiente dal punto di vista energetico rispetto a un singolo core ad altissima frequenza per lo stesso carico di lavoro.
- Tolleranza ai Guasti: In alcuni sistemi distribuiti, se un nodo fallisce, gli altri possono continuare a operare, aumentando l'affidabilità.
Sfide da Considerare
- Complessità della Programmazione: Scrivere, debuggare e mantenere codice parallelo è significativamente più complesso del codice sequenziale. È necessario gestire la concorrenza, la sincronizzazione e la comunicazione.
- Overhead di Comunicazione: Il tempo speso dai processori per scambiarsi dati può diventare un collo di bottiglia significativo.
- Sincronizzazione: Garantire che i processi accedano ai dati condivisi in modo corretto e si coordinino efficacemente richiede meccanismi di sincronizzazione che possono introdurre attese e ridurre il parallelismo effettivo.
- Bilanciamento del Carico (Load Balancing): Distribuire il lavoro equamente tra i processori è cruciale per massimizzare l'efficienza. Un carico sbilanciato porta a processori inattivi.
- Scalabilità Algoritmica: Non tutti gli algoritmi scalano bene con l'aumento del numero di processori. La Legge di Amdahl afferma che lo speedup massimo è limitato dalla frazione del programma che deve essere eseguita sequenzialmente.
- Costi Hardware: Sebbene i processori multicore siano standard, la costruzione e la manutenzione di grandi cluster o supercomputer possono essere costosi.
È importante notare la differenza tra calcolo parallelo e calcolo concorrente. Il calcolo parallelo implica l'esecuzione fisica simultanea di più compiti su diverse unità di elaborazione. Il calcolo concorrente, invece, si riferisce alla gestione di più compiti che progrediscono in periodi di tempo sovrapposti, ma non necessariamente eseguiti nello stesso istante (ad esempio, su un singolo processore tramite time-slicing).
Calcolo Parallelo e Distribuito in Python: Un'Introduzione Pratica
Per chi è interessato a vedere alcuni concetti di calcolo parallelo e distribuito messi in pratica, il seguente video offre un'introduzione all'uso di Python con librerie come `threading`, `multiprocessing` e `joblib`. Questo può essere un ottimo punto di partenza per esplorare l'implementazione di queste tecniche in uno dei linguaggi di programmazione più popolari.
Il video esplora come diverse librerie Python consentano di eseguire codice in parallelo, sfruttando i core multipli di un processore. Vengono discussi i concetti di thread (per parallelismo I/O-bound) e processi (per parallelismo CPU-bound), mostrando esempi pratici di come suddividere i compiti e gestire l'esecuzione parallela per migliorare le prestazioni delle applicazioni Python.
Domande Frequenti (FAQ) sul Calcolo Parallelo
Qual è la differenza principale tra calcolo parallelo e calcolo concorrente?
Il calcolo parallelo implica l'esecuzione simultanea di più compiti su diverse unità di elaborazione hardware (es. più core o processori). L'obiettivo è velocizzare il completamento di un singolo compito computazionalmente intensivo. Il calcolo concorrente si riferisce alla capacità di un sistema di gestire più compiti che sembrano progredire contemporaneamente, anche se potrebbero essere eseguiti su un singolo processore attraverso tecniche come il time-sharing (interleaving). L'obiettivo del calcolo concorrente è migliorare la reattività e la gestione di molteplici attività indipendenti.
Tutti i problemi possono beneficiare del calcolo parallelo?
No, non tutti i problemi sono adatti al calcolo parallelo. I problemi che sono intrinsecamente sequenziali, dove ogni passo dipende strettamente dal risultato del precedente, offrono poche opportunità di parallelizzazione. La Legge di Amdahl descrive matematicamente come la porzione seriale di un programma limiti il massimo speedup ottenibile. I problemi "imbarazzantemente paralleli" (embarrassingly parallel), dove i compiti sono quasi completamente indipendenti, sono quelli che beneficiano maggiormente.
Cosa si intende per "speedup" e "scalabilità" nel calcolo parallelo?
Lo speedup è una misura di quanto un programma parallelo sia più veloce della sua controparte sequenziale. È calcolato come il rapporto tra il tempo di esecuzione sequenziale e il tempo di esecuzione parallelo \( S_p = T_1 / T_p \). La scalabilità si riferisce alla capacità di un programma parallelo di mantenere o migliorare il suo speedup all'aumentare del numero di processori. Una buona scalabilità implica che raddoppiando i processori si ottiene un dimezzamento (o quasi) del tempo di esecuzione.
Quali sono le principali sfide nella programmazione parallela?
Le principali sfide includono: la corretta scomposizione del problema, la gestione della comunicazione e della sincronizzazione tra processi/thread (che può introdurre overhead e bug come race condition e deadlock), il bilanciamento del carico per evitare che alcuni processori siano inattivi, e il debugging di programmi paralleli, che è notoriamente più complesso a causa della non-deterministica natura dell'esecuzione.
Letture Consigliate e Approfondimenti
Per chi desidera esplorare ulteriormente il mondo del calcolo parallelo, ecco alcune direzioni di ricerca suggerite:
- Quali sono le applicazioni pratiche del calcolo parallelo nell'intelligenza artificiale?
- Come funziona la Legge di Amdahl e come influenza lo speedup nel calcolo parallelo?
- Approfondimenti sulla programmazione con MPI per cluster di calcolo.
- Quali sono le ultime innovazioni hardware per il calcolo parallelo ad alte prestazioni?
Riferimenti
Last updated May 8, 2025