
揭秘:AI 如何“倾听”并理解您的音频?
探索大模型处理声音信息、提取核心内容的两大核心路径。
您是否好奇,当您向大模型(例如先进的AI助手)提供一段录音、语音备忘或会议音频时,它是如何理解这些声音信息并准确捕捉重点的?这个过程比简单地“听”要复杂得多。实际上,大模型结合了多种先进技术来解析音频数据。
主要见解:音频处理的奥秘
- 主流方法:先转录,后理解: 目前最常用且成熟的技术路径是先利用自动语音识别(ASR)技术将音频精准转换为文本,然后运用大语言模型(LLM)强大的自然语言处理能力来分析文本、提取关键信息。
- 新兴趋势:直接音频处理与多模态融合: 更前沿的方法涉及多模态大模型或大型音频模型(LAMs),它们能够直接处理音频信号的特征,或者将音频信息与其他类型数据(如文本)融合处理,从而捕捉更丰富的声音细节(如语调、情感)。
- 技术核心:深度学习与Transformer: 无论是哪种路径,核心技术都依赖于深度学习,特别是Transformer架构,通过其注意力机制有效处理序列数据(无论是转换后的文本序列还是原始音频特征序列)。
路径一:语音转文本 (ASR) + 文本理解 (LLM) - 成熟可靠的选择
将声音转化为文字,再深度解读
这是当前工业界和研究领域最广泛采用的处理流程。当您希望大模型理解一段以语音为主的音频(如对话、演讲、会议录音)并提取重点时,系统通常会按以下步骤操作:
- 音频预处理: 首先,原始音频会经过一些初步处理,例如调整采样率以统一标准(常见的有16kHz或48kHz)、降噪以减少背景干扰,有时还会进行语音活动检测(VAD)来分割出包含语音的片段。
- 自动语音识别 (ASR): 核心步骤是使用一个专门的ASR模型,如 OpenAI 的 Whisper、新一代的 GPT-4o-Transcribe 系列模型、Google Speech-to-Text 或 AssemblyAI 等。这些模型经过海量语音数据训练,能够将音频波形转换成相应的文本文字。
ASR模型如何工作?
它们通常提取音频的声学特征(如梅尔频谱倒谱系数 MFCCs 或梅尔频谱图),然后输入到一个深度神经网络(常用的是基于 Transformer 或循环神经网络 RNN 的序列到序列模型)中,该网络学习将这些声学特征映射到对应的音素、词语或句子。
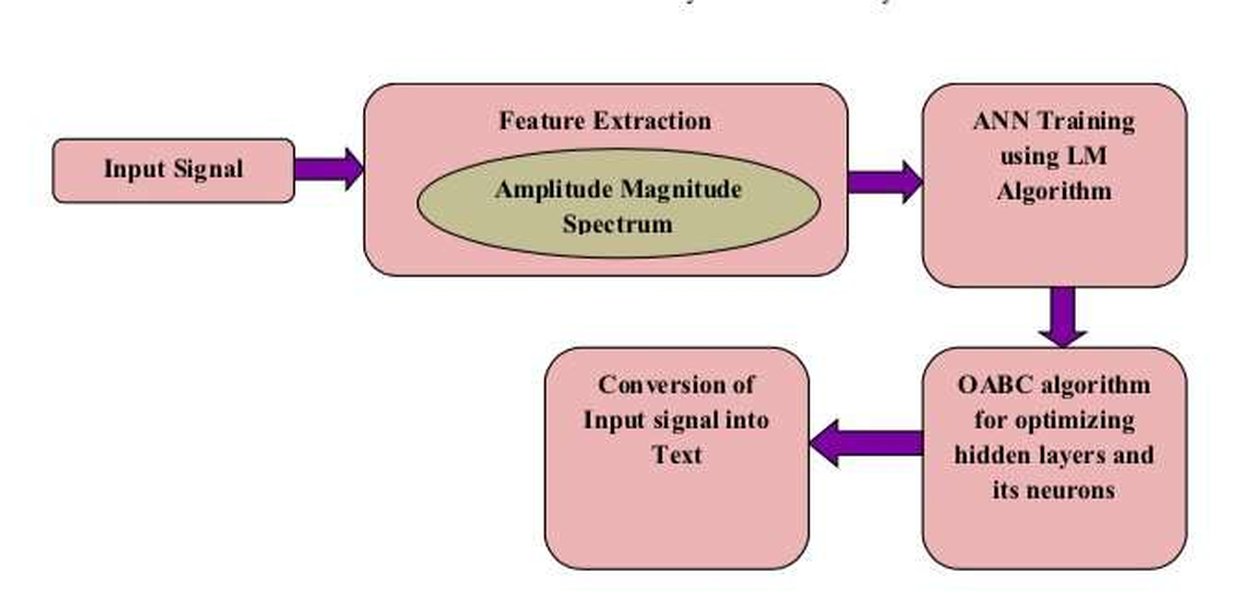
神经网络在语音识别中的应用示意
现代ASR系统在准确率(常用词错误率 WER 衡量)、多语言支持(许多模型支持超过百种语言和方言)以及对口音、噪声的鲁棒性方面都取得了显著进步。
- 文本处理与理解: 一旦获得高质量的文本转录稿,它就会被传递给一个大型语言模型(LLM),例如 GPT-4、LLaMA 或类似模型。LLM 运用其强大的自然语言理解 (NLU) 和生成 (NLG) 能力来执行后续任务:
- 重点提取: 识别文本中的关键短语、命名实体(人名、地名、组织名)、核心观点、议题或结论。
- 内容摘要: 生成一个浓缩版的摘要,保留原文的核心信息。
- 信息抽取: 提取特定的信息,如会议中的行动项、决策点、日期时间等。
- 问答: 基于转录的文本内容回答用户提出的具体问题。
- 情感分析: 判断文本所表达的情绪倾向。
此路径的优势
- 技术成熟度高: ASR 和 LLM 技术都相对成熟,有大量高质量的开源和商业解决方案可用。
- 准确性高(针对语言内容): 对于提取音频中的口语内容信息非常有效,准确率有保障。
- 灵活性强: 可以利用现有 LLM 生态中丰富的文本处理能力。
此路径的局限
- 信息损失: 在转换为文本的过程中,语音中的非语言信息,如说话人的语速、语调、情绪、重音、背景声音等,大部分会丢失。
- 依赖 ASR 质量: 如果 ASR 转录出错,后续的 LLM 理解也会受到影响。
路径二:直接音频处理与多模态模型 - 探索更深层的声音理解
超越文字,直接感知声音信号
随着多模态学习和大型音频模型(LAMs / LALMs - Large Audio(-Language) Models)的发展,另一种处理音频的方式也日益受到关注。这种方法试图直接从音频信号中学习表示,或者将音频特征与文本等其他模态的信息融合处理,而不仅仅依赖于中间的文本转录。
核心理念
这类模型的目标是构建一个能够理解更广泛声音现象的系统,而不仅仅是语音。它们可能通过以下方式运作:
- 直接音频特征编码: 模型直接处理音频的原始波形或其时频表示(如频谱图)。通过自监督学习(如 Wav2Vec 2.0, HuBERT)或有监督学习,模型学习将这些音频片段映射到一个丰富的、包含声学和潜在语义信息的向量表示(embedding)。
- 音频-语言联合建模: 大型音频语言模型 (LALMs) 尝试在一个统一的框架内同时处理音频和文本。它们可能将音频特征和文本特征投影到同一个共享的表示空间,或者使用交叉注意力机制来融合来自不同模态的信息。例如,模型可以直接接收音频输入,并生成文本摘要、回答关于音频内容的问题,或者识别音频中的特定声音事件(如掌声、音乐、警报声)。
- 模态无关的处理: 一些研究(如 MIT 的研究发现)表明,先进的大模型可能在其内部层中将不同类型的数据(包括音频)转换为一种与模态无关 (modality-agnostic) 的表示,然后在中央处理单元进行统一的推理和整合。
下面的思维导图清晰地展示了这两种主要的音频处理路径:
(降噪、分段)"] step1_2["ASR 模型
(Whisper, GPT-4o-Transcribe)"] substep1_2_1["声学特征提取
(MFCC, 频谱图)"] substep1_2_2["序列到序列模型
(Transformer)"] substep1_2_3["输出文本转录"] step1_3["大型语言模型 (LLM)
(GPT-4, LLaMA)"] substep1_3_1["文本理解 (NLU)"] substep1_3_2["重点提取"] substep1_3_3["摘要生成"] substep1_3_4["问答/信息抽取"] path2["路径二:直接/多模态处理"] step2_1["音频预处理"] step2_2["音频特征编码"] substep2_2_1["直接处理波形/频谱"] substep2_2_2["自监督学习
(Wav2Vec 2.0)"] substep2_2_3["生成音频嵌入 (Embedding)"] step2_3["多模态融合/LALM"] substep2_3_1["音频-语言联合建模"] substep2_3_2["跨模态注意力"] substep2_3_3["模态无关表示"] step2_4["下游任务"] substep2_4_1["声音事件检测"] substep2_4_2["语音情感识别"] substep2_4_3["直接音频问答/摘要"]
此路径的优势
- 捕捉更丰富信息: 有潜力理解音频中的非语言线索,如情感、语调、说话人身份、背景噪音、音乐元素等。
- 处理非语音音频: 更适用于处理音乐、环境声音或其他非语言音频信号的任务。
- 端到端处理: 部分模型可以实现从原始音频到最终任务输出(如分类标签、摘要)的端到端训练,可能更简洁高效。
此路径的挑战
- 技术仍在发展中: 相较于 ASR+LLM 路径,直接音频处理和 LALMs 仍处于快速发展阶段,通用性、鲁棒性和性能可能仍在追赶。
- 计算资源需求高: 处理原始音频特征通常需要更多的计算资源。
- “幻觉”问题: 有时模型可能会错误地“听”到或生成不存在的声音或信息。
- 对语言内容的理解深度: 在纯粹依赖音频特征时,对复杂语言结构和语义的理解深度可能不如经过专门文本训练的 LLM。
如何提取重点:两种路径的对比
方法的差异决定了提取信息的侧重点
当目标是“提取音频中的重点”时,这两种路径的实现方式和侧重点有所不同:
- 基于 ASR+LLM 的路径: 重点提取主要发生在文本层面。LLM 分析转录后的文字内容,运用其学到的语言知识和模式来识别重要的句子、关键词、主题、论点或行动项。这本质上是一个自然语言处理任务。
- 基于直接/多模态处理的路径: 重点提取可能结合声学特征和语言信息。模型不仅分析识别出的词语,还可能利用注意力机制关注音频信号中能量较高、音调变化剧烈或具有特定声学模式的片段。例如,在会议录音中,模型可能会注意到某个发言人语速加快、音量提高的部分,并结合内容判断其重要性。对于识别“关键声音事件”(如警报声),则完全依赖于对声学特征的分析。
下表总结了这两种主要处理路径的关键区别:
| 特征 | 音频转文本 (ASR) + LLM 路径 | 直接音频处理 / 多模态路径 |
|---|---|---|
| 主要处理单元 | ASR 模型 + 大型语言模型 (LLM) | 大型音频模型 (LAM) / 大型音频语言模型 (LALM) / 多模态模型 |
| 输入数据 | 音频 -> ASR -> 文本 -> LLM | 音频特征 (波形/频谱) (可能结合文本或其他模态) |
| 捕获信息类型 | 主要为语言内容(说了什么) | 语言内容 + 非语言信息(语调、情感、背景声、说话人特征等) |
| 重点提取方式 | 基于文本语义分析(关键词、主题、摘要算法) | 结合声学特征分析(能量、音高变化)和(可能的)语义分析 |
| 优势 | 技术成熟,对语言内容理解准确,生态丰富 | 能捕捉更全面的音频信息,适用于非语音任务,潜力巨大 |
| 劣势 | 丢失非语言信息,依赖ASR准确性 | 技术仍在发展,计算密集,可能存在幻觉,语言理解深度可能受限 |
| 当前成熟度 | 非常成熟,广泛应用 | 快速发展中,部分领域成熟(如声音分类),通用理解仍在进步 |
| 适用场景(提取重点) | 会议纪要、讲座总结、采访转录分析等以语言内容为核心的场景 | 需要结合情感/语气的分析、识别关键声音事件、多模态交互场景 |
模型能力评估:多维度考量
不同处理方式的性能权衡
选择哪种方法取决于具体的应用需求和对不同性能维度的侧重。下面的雷达图提供了一个概念性的比较,展示了这两种主要路径在不同方面的相对强弱(评分基于普遍认知,非精确数据):
图表解读:
- ASR+LLM 路径 在语音识别准确率和模型成熟度上得分较高,表明其在处理口语内容方面可靠且技术稳定。但在非语言信息捕捉方面得分较低。
- 直接/多模态处理路径 在非语言信息捕捉方面更有潜力,但在模型成熟度和可能略低的语音识别准确率(相较于顶级专用ASR)以及较高的计算成本方面显示出当前的挑战。
- 两者在噪声鲁棒性、实时处理能力和通用性方面各有侧重,具体表现取决于所使用的具体模型和优化。
观看:音频处理与机器学习
了解基础知识
要深入理解大模型如何处理音频,了解音频信号处理的基础知识非常有帮助。下面的视频(英文)介绍了机器学习中音频数据的处理和特征提取,这构成了许多现代音频理解模型的基础。
视频:面向机器学习的音频信号处理入门
这个视频系列探讨了如何处理音频数据并提取相关特征(如音高、节奏、音色等),这些特征是机器学习模型(包括大型模型)理解和分类音频内容的基础。虽然它不直接讲解大型模型架构,但它解释了模型“看到”的输入是什么样的,有助于理解后续处理。
常见问题解答 (FAQ)
关于大模型处理音频的更多疑问
问:所以,如果我只想知道会议说了什么重点,哪种方法更好?
问:大模型能理解音频中的情感或语气吗?
问:背景噪音会影响大模型对音频的理解吗?
问:未来音频处理会完全放弃文本转换吗?
推荐探索
深入了解相关主题
参考文献
了解更多信息的来源
Last updated April 27, 2025