
画像認識AIの核心を探る:最も使われている技術とその応用
2025年現在、AIがどのように「見る」ことを学んでいるのか、主要なアルゴリズム、ツール、トレンドを徹底解説します。
画像認識AIは、コンピュータが画像や動画の内容を人間のように理解し、解釈するための技術です。深層学習(ディープラーニング)の進展により、その精度と応用範囲は飛躍的に拡大しました。現在(2025年5月6日時点)では、私たちの日常生活から最先端の産業分野に至るまで、様々な場面で活用されています。この記事では、画像認識AIで特に多用されているアルゴリズム、ツール、そして最新のトレンドについて詳しく解説します。
重要なポイント
- 畳み込みニューラルネットワーク(CNN)が主流: 画像認識のアルゴリズムとして最も広く採用されており、その派生モデル(ResNet, R-CNN, YOLOなど)が特定のタスクで高い性能を発揮しています。
- クラウドAPIが開発を加速: Google Cloud Vision API、Amazon Rekognition、Microsoft Azure Computer Visionなどのプラットフォームが、高精度な画像認識機能を手軽に利用可能にしています。
- 応用範囲の拡大と市場成長: ヘルスケア、小売、自動運転、セキュリティなど多岐にわたる分野で活用が進み、AI画像認識市場は2030年までに98億ドル規模に達すると予測されています。
画像認識AIを支える主要アルゴリズム
画像認識AIの性能は、その基盤となるアルゴリズムによって大きく左右されます。現在、最も影響力があり、広く採用されているのは深層学習に基づくモデル、特に畳み込みニューラルネットワーク(CNN)とその派生形です。
畳み込みニューラルネットワーク (CNN: Convolutional Neural Networks)
CNNは、現代の画像認識におけるデファクトスタンダードと言えるアルゴリズムです。人間の視覚野の仕組みにヒントを得ており、画像内のピクセルデータから階層的に特徴を抽出する能力に優れています。
特徴抽出の階層性
CNNは複数の層(畳み込み層、プーリング層など)で構成されます。初期の層ではエッジや色といった単純な特徴を検出し、層が深くなるにつれて、目や鼻、車輪のようなより複雑なパーツ、最終的には顔や物体全体といった高レベルな特徴を認識できるようになります。この階層的な特徴抽出能力が、多様な画像認識タスクで高い精度を実現する鍵となっています。
代表的なCNN派生モデル
- ResNet (Residual Networks): 非常に深いネットワーク構造でも学習を可能にする「残差接続」を導入し、ImageNetなどのベンチマークで高い精度を達成しました。過学習を防ぎつつ性能を向上させるため、多くの応用で使用されています。
- VGGNet: 比較的シンプルな構造ながら高い汎用性を持ち、転移学習のベースモデルとしてもよく利用されます。
- Inception (GoogLeNet): 計算効率を高めつつ、異なるサイズの畳み込みフィルターを並行して適用することで、多様な特徴を捉える工夫がされています。
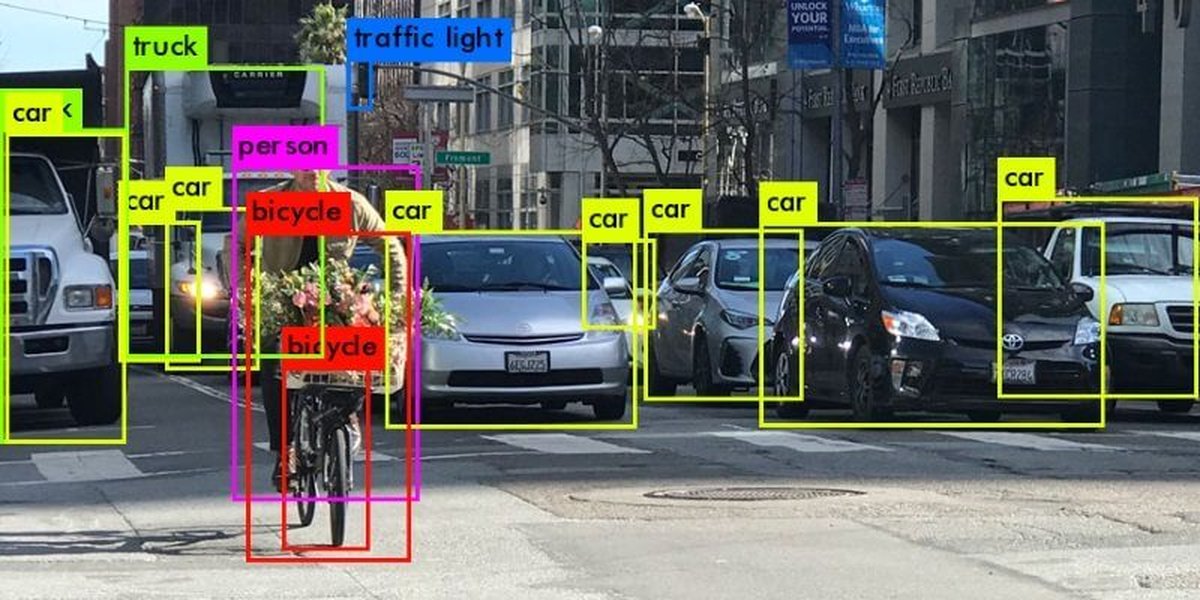
AIが画像から情報を抽出し、認識するプロセスを示した概念図
物体検出に特化したアルゴリズム
単に画像に何が写っているかを分類するだけでなく、画像内のどこに物体が存在するか(位置の特定)を検出するタスクも重要です。この分野では以下のアルゴリズムが多用されています。
R-CNN (Region-based CNN) ファミリー
R-CNNとその改良版であるFast R-CNN、Faster R-CNNは、物体が存在しそうな領域(Region Proposal)をまず特定し、その領域に対してCNNを適用して物体のクラス分類と位置の精密化を行います。Faster R-CNNは領域提案のプロセスもニューラルネットワークに組み込むことで、処理速度を大幅に向上させ、リアルタイムに近い物体検出を可能にしました。交通監視やセキュリティシステムなどで広く利用されています。
YOLO (You Only Look Once) シリーズ
YOLOは、画像をグリッドに分割し、各グリッドセルで物体の検出とクラス分類を一度に行うというアプローチを取ります。R-CNN系に比べて高速な処理が可能であり、特にリアルタイム性が求められる自動運転や監視カメラなどのアプリケーションで人気があります。YOLOv7などの新しいバージョンでは、速度を維持しつつ精度も向上しています。
その他の重要なアルゴリズム
サポートベクターマシン (SVM: Support Vector Machine)
深層学習が主流になる以前から用いられてきた機械学習アルゴリズムです。特徴空間上でクラス間の境界(超平面)を最適化することで分類を行います。特にデータ量が少ない場合や、特徴量が事前に明確な場合に有効ですが、大規模な画像データセットではCNN系に比べて性能面で見劣りすることが多くなっています。
顔認識特化アルゴリズム
顔認識は特定の応用分野であり、ArcFaceやFaceNetといった専用のアルゴリズムが開発されています。これらは顔画像から個人を識別するための特徴量(埋め込みベクトル)を効率的に学習し、非常に高い精度での認証を可能にします。スマートフォンのロック解除やセキュリティゲートなどで広く実用化されています。
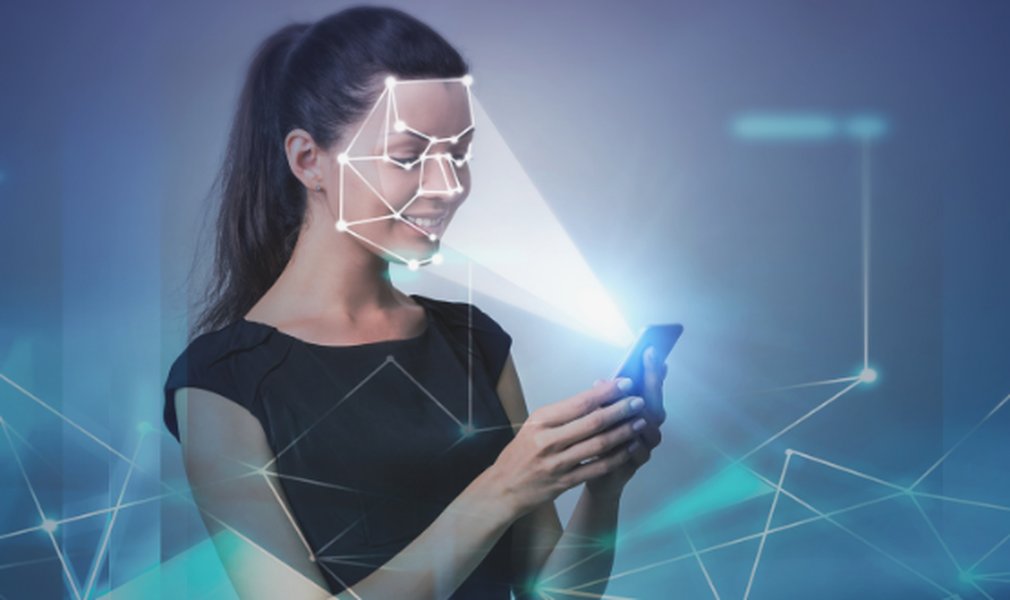
AIを活用した顔認識技術はセキュリティ分野などで広く利用されている
主要アルゴリズムの概要と用途
画像認識AIで多用される主要なアルゴリズムとその特徴、主な用途を以下の表にまとめました。これにより、各技術がどのようなタスクに適しているかを理解することができます。
| アルゴリズム | 概要 | 主な用途 |
|---|---|---|
| CNN (畳み込みニューラルネットワーク) | 画像の特徴を階層的に抽出し、分類する深層学習の基本モデル。多くの派生モデルが存在する。 | 画像分類、医療画像診断、基本的な物体認識など広範。 |
| ResNet | CNNの派生。残差接続により非常に深いネットワークの学習を可能にし、高精度を実現。 | 高精度な画像分類、転移学習のベースモデル。 |
| R-CNN ファミリー (Faster R-CNNなど) | 物体が存在しそうな領域を提案し、CNNで詳細を解析する物体検出手法。精度が高い。 | 精密な物体検出、交通監視、セキュリティシステム。 |
| YOLO (You Only Look Once) | 画像をグリッド分割し、一度の処理で高速に物体検出を行う。リアルタイム性に優れる。 | リアルタイム物体検出、自動運転、監視カメラ。 |
| SVM (サポートベクターマシン) | 特徴空間でクラスを分離する超平面を見つける古典的な機械学習手法。 | 小規模データセットでの分類、特定の特徴抽出後の分類。 |
| ArcFace / FaceNet | 顔画像から個人を識別するための特徴量を学習する顔認識特化アルゴリズム。 | 顔認証、セキュリティ、スマートフォンのロック解除。 |
| OCR / ICR (文字認識) | 画像中の印刷文字(OCR)や手書き文字(ICR)をテキストデータに変換する技術。 | 書類のデジタル化、郵便番号読み取り、自動入力システム。 |
人気の画像認識AIツール・プラットフォーム
アルゴリズム自体を理解することも重要ですが、実際の開発では既存のツールやクラウドプラットフォームを利用することが一般的です。これらは事前学習済みの高精度なモデルや、開発を容易にするAPIを提供しています。
主要なクラウドサービス
- Google Cloud Vision API: 業界標準とも言えるサービスで、ラベル検出、顔検出、ランドマーク検出、ロゴ検出、テキスト検出(OCR)など、非常に多機能です。高い精度とGoogleの持つ膨大なデータに基づく学習済みモデルが強みです。
- Amazon Rekognition: AWSが提供するサービスで、画像および動画分析に特化しています。物体・シーン・顔の検出、不適切コンテンツの検出、テキスト認識などが可能です。スケーラビリティに優れ、他のAWSサービスとの連携も容易です。
- Microsoft Azure Computer Vision: 画像の内容分析、テキスト抽出、物体検出などの機能を提供します。特にビジネス向けのソリューションや、カスタムモデルのトレーニング機能が充実しています。
- IBM Watson Visual Recognition: 画像内の物体、顔、色、食品などを認識し、カスタムモデルの作成も可能です。特定の業界向けソリューションも提供しています。
これらのクラウドサービスは、APIを通じて手軽に高度な画像認識機能を利用できるため、多くの企業や開発者に採用されています。
その他のツール・ライブラリ
- OpenCV (Open Source Computer Vision Library): コンピュータビジョン向けのオープンソースライブラリで、画像処理や機械学習の基本的な機能が豊富に含まれています。研究開発やカスタム実装で広く使われています。
- V7 Labs, Labellerr など: データラベリングやモデル管理に特化したプラットフォームも登場しており、AI開発のパイプライン全体を支援します。
主要画像認識プラットフォームの比較
代表的なクラウドベースの画像認識プラットフォームについて、いくつかの側面からその特性を比較してみましょう。以下のレーダーチャートは、精度、速度、使いやすさ、コスト、機能の豊富さ、スケーラビリティの6つの観点から、主要なプラットフォーム(Google Cloud Vision API, Amazon Rekognition, Microsoft Azure Computer Vision)の一般的な評価を示したものです。ただし、これらの評価はタスクや使用状況によって変動する可能性があります。
このチャートから、各プラットフォームがそれぞれ異なる強みを持っていることがわかります。例えば、Google Cloud Visionは機能の豊富さや精度で評価される傾向があり、Amazon Rekognitionはスケーラビリティや速度、Azure Computer Visionは使いやすさや他のAzureサービスとの統合性で評価されることがあります。最適なツールは、プロジェクトの要件(必要な精度、予算、処理速度、特定の機能など)に応じて選択する必要があります。
画像認識AIの多岐にわたる応用分野
画像認識AIは、その能力を活かして様々な分野で実用化されています。以下に代表的な応用例をいくつか紹介します。
日常生活とエンターテイメント
- スマートフォンの写真管理: 写真アプリが自動的に人物や場所、イベントごとに写真を分類・整理します。
- SNSのコンテンツモデレーション: 不適切な画像や動画を自動的に検出し、フィルタリングします。
- 顔認識フィルタ: カメラアプリで顔の特徴を捉え、リアルタイムでエフェクトを追加します。
産業・ビジネス応用
- 自動運転: 車両の周囲の歩行者、他の車両、交通標識、信号機などをリアルタイムで認識し、安全な運転を支援します。交通標識認識は特に重要な技術です。
- 医療画像診断: レントゲン写真、CT、MRI画像などから、がん細胞や病変の兆候を検出する補助診断システムとして利用されています。
- 小売・eコマース: 店舗内の顧客行動分析、在庫管理の自動化、類似商品の検索(画像検索)などに活用されています。無人店舗の実現にも貢献しています。
- セキュリティ・監視: 監視カメラ映像から不審な行動や侵入者を検知したり、顔認証による入退室管理を行ったりします。
- 農業 (スマート農業): ドローンなどで撮影した画像から作物の生育状況を把握したり、病害虫を早期に発見したりします。
- 製造業 (品質管理): 製品の外観検査を自動化し、傷や欠陥を検出します。
- ロボット工学: ロボットが周囲の環境を認識し、物体のピッキングやナビゲーションを行うために利用されます。
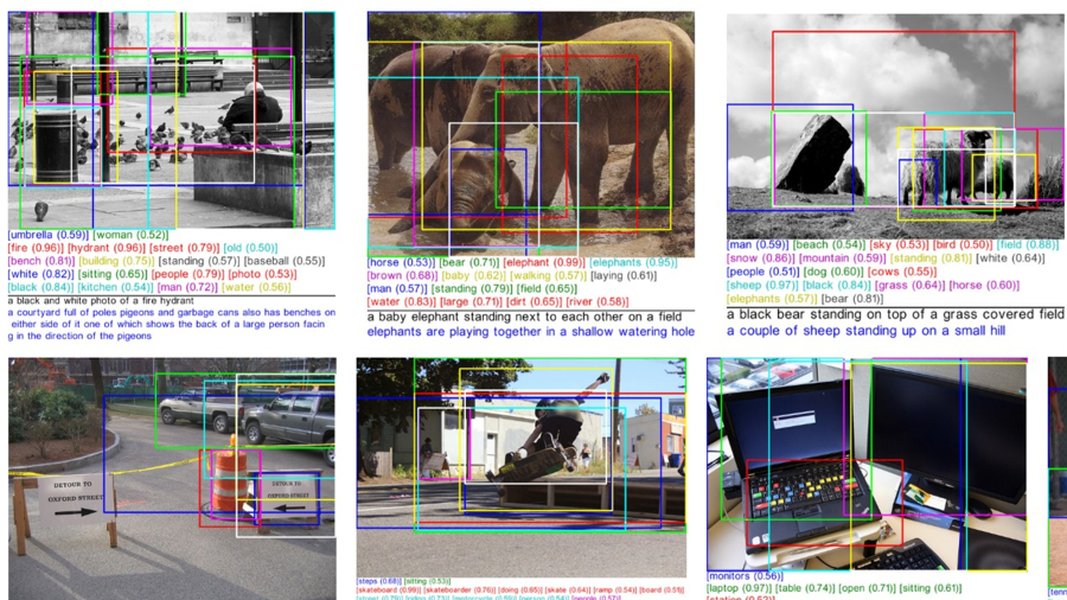
機械学習と画像認識は、検索エンジンのような情報アクセス方法にも変革をもたらす可能性があります。
画像認識AIの構造:主要要素の関連性
画像認識AIの世界は、アルゴリズム、ツール、応用、そして未来のトレンドが相互に関連し合って進化しています。以下のマインドマップは、これらの主要な構成要素とその関係性を視覚的に示しています。
(Key Algorithms)"] id1_1["CNN (畳み込みニューラルネットワーク)
- ResNet
- VGGNet
- Inception"] id1_2["物体検出 (Object Detection)
- R-CNN ファミリー (Faster R-CNN)
- YOLO"] id1_3["顔認識 (Face Recognition)
- ArcFace
- FaceNet"] id1_4["SVM (サポートベクターマシン)"] id1_5["OCR/ICR (文字認識)"] id2["主要ツール/プラットフォーム
(Tools/Platforms)"] id2_1["クラウド API
- Google Cloud Vision
- Amazon Rekognition
- Microsoft Azure CV
- IBM Watson VR"] id2_2["ライブラリ/フレームワーク
- OpenCV
- TensorFlow
- PyTorch"] id2_3["データ関連ツール
- V7 Labs
- Labellerr"] id3["応用分野
(Applications)"] id3_1["自動運転 (Autonomous Driving)"] id3_2["医療 (Healthcare)
- 画像診断支援"] id3_3["小売/eコマース (Retail/E-commerce)
- 行動分析
- 在庫管理
- 無人店舗"] id3_4["セキュリティ/監視 (Security)"] id3_5["農業 (Agriculture)"] id3_6["製造業 (Manufacturing)
- 品質管理"] id3_7["日常生活 (Daily Life)
- 写真管理
- SNS"] id4["市場とトレンド
(Market & Trends)"] id4_1["市場成長 (Market Growth)
- 2030年予測: 98億ドル"] id4_2["エッジAI (Edge AI)
- リアルタイム処理
- 低遅延"] id4_3["マルチモーダル学習 (Multimodal Learning)
- 画像 + テキスト"] id4_4["高精度化とカスタマイズ"] id4_5["データセット
- ImageNet, COCO, CIFAR"]
このマインドマップは、CNNのような基礎アルゴリズムが、Google Cloud Visionのようなツールを通じて、自動運転や医療といった多様な分野で応用されていることを示しています。また、エッジAIのような新しいトレンドが、今後の技術の方向性を示唆しています。
市場動向と未来のトレンド (2025年)
AI画像認識の市場は急速に成長しています。Global Strategic Business Reportによると、2024年の市場規模は33億ドルと評価され、2030年までには年平均成長率(CAGR)19.7%で成長し、98億ドルに達すると予測されています。この成長は、ヘルスケア、小売、セキュリティ分野における自動化と効率化への強い需要、高解像度カメラを搭載したスマートデバイスの普及、そしてAI開発を支援する政府の取り組みなどによって後押しされています。
注目される技術トレンド
- エッジAIへのシフト: クラウドへの依存を減らし、デバイス上で直接リアルタイムの画像認識処理を行う「エッジAI」が重要性を増しています。これにより、遅延が少なくなり、プライバシー保護にも繋がります。自動運転、スマートホームデバイス、ウェアラブル技術などで不可欠な技術となりつつあります。
- リアルタイム分析とビデオストリーム処理: 静止画だけでなく、動画ストリームをリアルタイムで解析する能力への要求が高まっています。
- マルチモーダル学習: 画像だけでなく、テキストや音声など複数の種類の情報を組み合わせて認識・判断を行うAIモデルの開発が進んでいます。これにより、より文脈に沿った、人間のような理解が可能になると期待されています。
- カスタマイズと特定業界向けソリューション: 汎用的なツールに加え、特定の業界(医療、農業など)のニーズに特化した認識ツールや、独自のデータセットに合わせてモデルをカスタマイズする動きが活発になっています。
- 限定データからの学習: より少ないデータでも高精度な学習を可能にする技術(Few-shot learningなど)の研究が進んでおり、データ収集のコストや手間を削減することが期待されます。
将来的には、AIは単に画像を認識するだけでなく、その内容についてより深く、文脈を理解し、人間のように推論する能力を獲得していくと考えられています。
AI画像認識の進化を見る
AIによる画像認識技術がどれほど進化しているか、以下の動画は、AIが画像をどのように認識し、時には人間が見落とすような詳細まで捉えることができるかを示しています。技術の驚くべき進歩の一端を垣間見ることができます。
この動画で示されるように、現代のAIは、単に物体を識別するだけでなく、画像全体の文脈や、時には微妙なニュアンスまで読み取ろうとします。このような能力は、前述したCNNなどの深層学習アルゴリズムの高度化によって実現されています。しかし同時に、AIが人間とは異なる「見方」をすることや、特定の状況下では誤認識を起こす可能性(敵対的攻撃など)も示唆しており、技術の限界と今後の課題についても考えさせられます。
よくある質問 (FAQ)
Q: 画像認識AIは具体的にどのように機能するのですか?
A: 基本的には、大量のラベル付けされた画像データ(例:「これは猫」「これは犬」)をAIモデル(特にCNN)に学習させます。モデルは画像内のピクセルパターンから特徴(線の形状、色の分布、テクスチャなど)を抽出し、それらの特徴の組み合わせから物体やシーンを識別するためのルールを自動的に学習します。学習が完了したモデルは、未知の画像が入力された際に、学習した知識に基づいてその内容を予測・分類します。
Q: 画像認識AIの精度はどのくらいですか?
A: タスクや使用するデータセット、モデルによって異なりますが、特定のベンチマーク(例: ImageNet)では、最高レベルのモデルは人間を超える精度を達成することもあります(90%台後半以上)。ただし、現実世界の多様な条件下(照明の変化、遮蔽、予期せぬ物体など)では精度が低下する可能性もあります。顔認識や特定の物体検出など、確立されたタスクでは非常に高い精度が実用化されています。
Q: 画像認識AIの開発にはどのようなデータセットが使われますか?
A: モデルの学習や性能評価のために、大規模な標準データセットが広く利用されています。代表的なものには以下のようなものがあります。
- ImageNet: 1000クラス以上の物体カテゴリを含む、非常に大規模な画像分類・物体検出用データセット。
- COCO (Common Objects in Context): より複雑なシーンにおける物体検出、セグメンテーション、キャプション生成のためのデータセット。
- CIFAR-10 / CIFAR-100: 比較的小さな画像(32x32ピクセル)で構成される、基本的な画像分類タスク用のデータセット。
- Open Images: Googleが公開している、非常に大規模で多様なアノテーションが付与されたデータセット。
特定のタスク(顔認識、医療画像など)には、専用のデータセットも利用されます。
Q: 画像認識AIの主な課題は何ですか?
A: いくつかの課題が存在します。
- データの偏り (Bias): 学習データに偏りがあると、特定のグループや条件下での認識精度が低くなる可能性があります。
- 頑健性 (Robustness): 照明の変化、回転、遮蔽、ノイズなど、予期せぬ変化に対して認識性能が低下することがあります。
- 説明可能性 (Explainability): 深層学習モデルは「ブラックボックス」化しやすく、なぜ特定の判断を下したのかを人間が理解するのが難しい場合があります。
- 敵対的攻撃 (Adversarial Attacks): 人間には見分けがつかないような微小なノイズを画像に加えることで、AIを誤認識させる攻撃手法が存在します。
- データプライバシー: 顔認識など、個人情報を含む画像を扱う際のプライバシー保護が重要な課題です。
- 計算コスト: 高度なモデルの学習や推論には、依然として多くの計算資源が必要です。
推奨される関連クエリ
- CNNの仕組みと画像認識への応用について教えてください
- 物体検出アルゴリズムYOLOとFaster R-CNNの違いは何ですか
- エッジAIとは何ですか、画像認識における利点は何ですか
- 画像認識AIをビジネスに活用する際の注意点はありますか
参考文献
Last updated May 6, 2025