
画像認識AI:デジタルな「眼」が世界を捉える仕組みとその未来
コンピューターが画像を「理解」する驚異の技術、その核心と多岐にわたる活用事例を徹底解説します。
画像認識AIの注目ポイント
- 核心技術はディープラーニング: 特に畳み込みニューラルネットワーク(CNN)が画像の特徴を自動で学習し、高精度な認識を実現します。
- 多様なタスク実行能力: 物体の識別・検出から顔認証、文字認識まで、幅広い分野で人間の視覚機能の役割を担います。
- 社会実装の拡大: 自動運転、医療診断支援、スマートシティ構想など、私たちの生活や産業に革新をもたらすキーテクノロジーです。
画像認識AIとは何か?:基本概念の理解
画像認識AIとは、コンピューターがデジタル画像や映像データを分析し、その中に含まれる特定の物体、人物、文字、パターン、あるいはその他の情報を自動的に識別・理解する技術です。人間の視覚システムが外界を認識するプロセスに似た方法で、AIが画像の内容を解釈することを目指しています。この技術は、より広範な研究分野であるコンピュータビジョンの一部であり、特に機械学習、とりわけディープラーニング(深層学習)の進展によって飛躍的な進化を遂げています。
AIは、大量の画像データからパターンや特徴を学習することで、未知の画像に対しても高い精度で何が写っているかを判断できるようになります。例えば、2012年のImageNetコンペティションにおけるGoogleの研究成果は、AIが大量の画像から教師データなしで猫などの物体を識別する能力を示し、画像認識技術の大きなブレークスルーとなりました。この技術は、単に画像を解析するだけでなく、その結果を基にさまざまな判断やアクションを自動で行うシステムの構築を可能にしています。
AIが現実世界の情報をどのように認識し、活用していくかを示す概念図。
画像認識AIはどのように機能するのか?:その仕組みを解き明かす
画像認識AIの動作原理は、いくつかの連続したステップと、それを支える基盤技術によって構成されています。
画像処理と画像認識の違い
まず理解すべきは、「画像処理」と「画像認識」の違いです。画像処理は、画像認識の前処理段階にあたります。この段階では、元の画像データに対してノイズ除去、コントラスト調整、エッジ強調などを行い、認識に適した形にデータを整えます。これにより、後続の認識プロセスの精度が向上します。一方、画像認識は、この画像処理によって質が改善されたり特徴が抽出されたりしたデータを用いて、実際に画像内に何が存在するのかを識別・理解するステップです。つまり、画像処理は画像認識のパフォーマンスを支える重要な土台となります。
ディープラーニングの pivotal な役割
現代の画像認識AIにおいて、ディープラーニングは不可欠な技術です。ディープラーニングは、人間の脳の神経回路網を模した多層のニューラルネットワークを用いて、画像データから自動的に複雑な特徴を学習します。特に畳み込みニューラルネットワーク(CNN:Convolutional Neural Network)は、画像分析に特化した代表的なディープラーニングのアルゴリズムです。CNNは、画像の局所的な特徴(エッジ、テクスチャなど)を捉える畳み込み層と、位置のずれに頑健な特徴を抽出するプーリング層などを組み合わせることで、画像の階層的な特徴を効率的に学習します。これにより、従来は専門家が手作業で行っていた特徴量の設計(特徴エンジニアリング)が自動化され、認識システムの性能と開発効率が大幅に向上しました。近年では、自然言語処理分野で成功を収めたTransformerモデルを画像認識に応用したVision Transformer (ViT)なども登場し、さらなる精度向上が期待されています。
画像認識AIの学習に使用される多様な画像データセットのイメージ。
学習プロセス:AIはいかにして「見る」ことを学ぶか
画像認識AIの多くは、教師あり学習(Supervised Learning)という手法を用いて訓練されます。このプロセスでは、まず「教師データ」と呼ばれる大量のラベル付き画像データ(例:「猫」というラベルが付いた猫の画像、「車」というラベルが付いた車の画像など)をAIに与えます。AIはこれらのデータから、対象物の形状、大きさ、色の構成、テクスチャといった視覚的特徴と、それに対応するラベル(正解)の関係性を学習します。学習が進むにつれて、AIは入力された画像データから自動的に特徴を抽出し、予測モデルを構築・調整していきます。このモデルは、未知の画像が入力された際に、学習した特徴パターンと照らし合わせることで、その画像が何であるかを高い精度で判別できるようになります。
特徴抽出からパターン認識へ
具体的な処理の流れは以下のようになります:
- 入力画像の受け取り: デジタルカメラやセンサーから画像データが入力されます。
- 前処理(画像処理): 必要に応じてノイズ除去、正規化などが行われます。
- 特徴抽出: CNNなどのディープラーニングモデルが、画像から重要な特徴量(エッジ、コーナー、テクスチャ、形状など)を自動的に抽出します。低次の層では単純な特徴が、高次の層に進むにつれてより複雑で抽象的な特徴が捉えられます。
- パターン認識・分類: 抽出された特徴量を基に、学習済みモデルが画像全体または画像内の特定領域が何であるかを識別・分類します。
主要な画像認識技術
画像認識の分野では、特定のタスクに特化した様々なアルゴリズムやモデルが開発されています。
- 畳み込みニューラルネットワーク(CNN): 画像認識における最も標準的で強力なディープラーニングモデルです。画像の空間的情報を保持しながら効率的に特徴を学習できます。
- YOLO(You Only Look Once): 画像内の複数の物体をリアルタイムで検出し、同時に分類まで行うことができる高速な物体検出アルゴリズムです。自動運転や監視カメラなど、速度が要求されるアプリケーションで広く利用されています。
- Vision Transformer (ViT): 画像をパッチに分割し、Transformerエンコーダーに入力することで、大域的な特徴を捉える能力に優れています。大規模なデータセットで学習させることで、CNNを凌駕する性能を示すこともあります。
画像認識AIで何ができるのか?:主要なタスクと機能
画像認識AIは、学習した知識を基に、以下のような多様なタスクを実行できます。これらのタスクは、単独で利用されることもあれば、組み合わせてより高度な機能を実現するために用いられることもあります。
- 画像分類(Image Classification): 画像全体が何を表しているか(例:「風景」「動物」「食べ物」)を一つのカテゴリに分類します。画像に写っている主要な被写体を特定するタスクです。
- 物体検出(Object Detection): 画像の中から特定の種類の物体(例:「車」「歩行者」「信号機」)を識別し、さらにその物体が画像のどこに存在するかを矩形(バウンディングボックス)で示します。
- セグメンテーション(Segmentation): 画像をピクセル単位で意味のある領域に分割する技術です。
- 意味的セグメンテーション(Semantic Segmentation): 画像内の各ピクセルがどのカテゴリに属するか(例:「空」「道路」「建物」)を識別します。
- インスタンスセグメンテーション(Instance Segmentation): 同じカテゴリの物体であっても、個々のインスタンスを区別して(例:「車1」「車2」)、それぞれの輪郭を正確に抽出します。
- 顔認識(Facial Recognition): 画像や動画から人間の顔を検出し、その特徴を分析して個人を識別したり、年齢や性別、表情などを推定したりします。
- 文字認識(Optical Character Recognition, OCR): 画像やスキャンされた文書に含まれる印刷された文字や手書き文字を読み取り、編集可能なデジタルテキストデータに変換します。
- 画像キャプション生成(Image Captioning): 画像の内容を理解し、それを説明する自然言語の文章(キャプション)を自動生成する技術です。コンピュータビジョンと自然言語処理の融合分野です。
AI技術の進歩により、これらの処理はますます高い精度と速度で、場合によってはリアルタイムに実行できるようになっています。
画像認識AIの性能比較:タスク別評価レーダーチャート
画像認識AIが実行できるタスクは多岐にわたりますが、それぞれのタスクにおいて求められる性能や特性は異なります。以下のレーダーチャートは、主要な画像認識タスク(物体分類、物体検出、領域分割、顔認識、文字認識)について、いくつかの重要な性能指標(認識精度、リアルタイム性、応用範囲の広さ、導入の容易さ)を相対的に示したものです。このチャートは一般的な傾向を示すものであり、具体的なアルゴリズムや使用環境によって性能は変動します。
このチャートから、例えば顔認識はリアルタイム性や精度が高い傾向にある一方、領域分割(セグメンテーション)はより複雑で導入の難易度が相対的に高い場合があることなどが読み取れます。「導入の容易さ」は、必要なデータ量、計算リソース、専門知識などを総合的に考慮した相対的な指標です。
画像認識AIの応用世界:広がる活用事例
画像認識AIは、その高度な分析能力を活かして、私たちの生活やビジネスのあらゆる場面で活用され、革新をもたらしています。以下に主要な活用事例を分野別に紹介します。
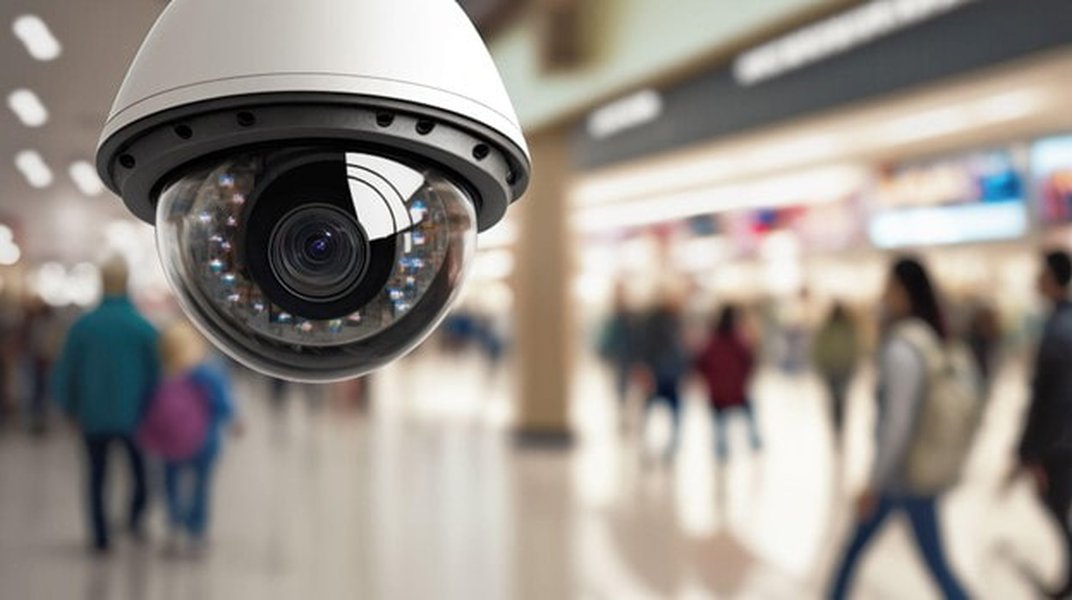
小売店舗におけるAIカメラの活用例。顧客行動分析や万引き防止などに貢献します。
| 分野 | 具体的な活用例 | 主な利点 |
|---|---|---|
| 自動運転 | 車両、歩行者、自転車、交通標識、車線のリアルタイム認識(例:テスラの「Tesla Vision」) | 運転支援による安全性向上、交通渋滞の緩和、将来的には完全自動運転の実現 |
| セキュリティ・防犯 | 監視カメラ映像からの不審行動検知、顔認証システムによる入退室管理・決済(例:「顔パス」、ユーカリPASS)、空港での不審者スクリーニング | 犯罪抑止、迅速なインシデント対応、利便性の高い認証手段の提供 |
| 医療 | X線、CT、MRIなどの医療画像解析による病変(がん細胞など)の早期発見支援、手術支援ロボットの視覚システム(例:大阪大学の研究) | 診断の精度と速度の向上、医師の負担軽減、個別化医療の推進 |
| 製造・工業 | 製品の外観検査による不良品検出・品質管理(例:輸入ワイン中味自動検査機)、製造ラインの異常検知、作業員の安全行動監視(例:JFEスチールの墜落制止用器具フック不使用者検知サービス)、部品の自動カウント | 生産効率向上、品質安定化、コスト削減、労働災害の防止 |
| 小売・流通 | 無人店舗・スマートストアでの商品認識と自動決済(例:Amazon Go、ローソンの一部店舗、BakeryScan)、ECサイトでの画像検索機能(例:AlibabaのImage Search)、在庫管理の自動化、顧客の行動分析とマーケティングへの活用 | 省人化・省力化、顧客体験の向上、業務効率化、新たな販売機会の創出 |
| 農業 | ドローンや定点カメラによる作物の生育状況監視、病害虫の早期発見、収穫時期の予測、果物や野菜の自動選別 | 生産性の向上、農薬使用量の削減、品質管理の効率化、持続可能な農業の支援 |
| インフラ管理 | 橋梁、トンネル、道路などの社会インフラの劣化状況診断(ひび割れ検知など)、ガス管工事の自動検知、災害状況の把握 | メンテナンス業務の効率化、点検コストの削減、インフラの長寿命化、安全性の確保 |
| その他サービス | スマートフォンのカメラ機能(ポートレートモード、シーン認識)、AR(拡張現実)・VR(仮想現実)・XR(クロスリアリティ)アプリケーション、食事記録アプリでの料理自動認識、建設現場での資材カウント、パーソナライズされたスキンケア提案(例:資生堂の「Optune」) | 日常生活の利便性向上、エンターテインメント体験の向上、新たなサービスの創出 |
これらの事例を通じて、画像認識AIは業務効率化、コスト削減、安全性向上、そしてこれまでにない新しいサービスの提供を実現しています。
画像認識AIの概念マップ:主要要素とその関連性
画像認識AIは多くの要素技術や概念から成り立っています。以下のマインドマップは、画像認識AIを中心として、その仕組み、主要なタスク、応用分野、そして関連する技術や考慮事項を視覚的に整理したものです。これにより、各要素がどのように連携し、画像認識AIという大きな枠組みを形成しているかを俯瞰的に理解することができます。
ノイズ除去、コントラスト調整など"] id1_3["特徴抽出
エッジ、テクスチャ、形状など"] id1_4["パターン認識・分類"] id2["主要タスク"] id2_1["物体分類"] id2_2["物体検出
(YOLO, SSDなど)"] id2_3["セグメンテーション
(意味的・インスタンス)"] id2_4["顔認識・認証"] id2_5["文字認識 (OCR)"] id2_6["画像キャプション生成"] id3["応用分野"] id3_1["自動運転技術"] id3_2["医療診断支援 (画像解析)"] id3_3["セキュリティ・防犯 (監視、認証)"] id3_4["製造業 (品質管理、安全確保)"] id3_5["小売・流通 (無人店舗、在庫管理)"] id3_6["農業 (生育監視、病害虫検知)"] id3_7["インフラ管理 (劣化診断)"] id4["関連技術・考慮事項"] id4_1["教師データ (量と質)"] id4_2["プライバシー保護"] id4_3["倫理的課題 (バイアス、誤認識)"] id4_4["生成AIとの連携"] id4_5["エッジAI (デバイス上での処理)"]
このマップは、画像認識AIが単一の技術ではなく、多くの要素が相互作用する複合的なシステムであることを示しています。例えば、「仕組み」セクションのディープラーニング技術は、「主要タスク」を実行するための基盤となり、それが「応用分野」での様々なイノベーションを可能にしています。同時に、「関連技術・考慮事項」で示されるようなデータの質や倫理的な側面も、技術の健全な発展には不可欠です。
画像認識AIを動画で学ぶ
画像認識AIの基本的な概念や、それがどのように社会で活用されているかについて、より視覚的に理解を深めるために、以下の解説動画をご覧ください。この動画では、AI技術としての画像認識が持つ可能性や、私たちの生活にどのような変化をもたらすのかが分かりやすく説明されています。
この動画(【AI#4】画像認識AIはすごい技術⁉【簡単・わかりやすく解説】)では、画像認識AIの仕組みの概要から、具体的な応用例、そして将来性について触れられています。専門的な知識がない方でも、画像認識AIが「すごい技術」である理由とそのインパクトを掴むことができるでしょう。映像を通じて、文字だけでは伝わりにくい技術の側面や、実際の活用シーンのイメージを補完することができます。
画像認識AIの利点と課題、そして未来
もたらされる恩恵:画像認識AIのメリット
画像認識AIの導入は、多くの分野で顕著なメリットをもたらしています。
- 高精度化と迅速化: 人間の目による判断と比較して、AIは疲れ知らずで大量のデータを高速かつ高い精度で処理できます。これにより、従来は見逃されていた微細な異常の発見や、瞬時の判断が求められる作業でのパフォーマンス向上が期待できます。
- コスト削減と作業効率化: これまで人手に頼っていた目視検査や監視業務などを自動化することで、人件費の削減や人的ミスの低減に繋がります。また、作業員の負担を軽減し、より創造的な業務へリソースを集中させることが可能になります。
- 新たなサービス創出と生活の質の向上: 顔認証によるキャッシュレス決済やスムーズな入退場、医療分野での診断支援による早期治療の実現、エンターテイメント分野での新しい体験の提供など、画像認識AIはこれまでにない便利なサービスを生み出し、私たちの生活を豊かにします。
- 安全性の向上: 自動運転車における障害物検知、製造現場での危険予知、災害現場での状況把握など、危険を伴う環境や状況での人間の安全確保に貢献します。
乗り越えるべき壁:課題と今後の展望
画像認識AIは目覚ましい発展を遂げていますが、さらなる普及と社会への貢献のためには、いくつかの課題に取り組む必要があります。
- プライバシーと倫理的問題: 顔認識技術などの広範な利用は、個人のプライバシー侵害や監視社会化への懸念を生じさせます。データの収集・利用に関する透明性の確保、悪用防止のための法的・倫理的枠組みの整備が重要です。
- 学習データの偏りとバイアス: AIの性能は学習データの質と量に大きく依存します。特定の属性(人種、性別など)や環境に偏ったデータで学習すると、AIの判断にバイアスが生じ、公平性や信頼性を損なう可能性があります。多様でバランスの取れたデータセットの構築が求められます。
- 誤認識のリスクと説明可能性: 高度なAIであっても100%の精度を保証することは難しく、誤認識が重大な結果を引き起こす可能性もあります(例:自動運転での事故)。また、AIがなぜそのような判断を下したのか(説明可能性・解釈可能性)を理解することが難しい場合があり、これが信頼性確保の障壁となることもあります。
- 環境変化への適応性: 学習時と異なる照明条件、天候、カメラアングルなどの環境変化に対して、認識精度が低下することがあります(ドメインシフト問題)。より頑健(ロバスト)なシステムの開発が必要です。
- 生成AIとの連携と悪用リスク: 画像認識技術は、ディープフェイクなどの偽画像を生成するAI技術と組み合わせることで、より高度な画像分析や編集が可能になる一方で、偽情報の拡散といった悪用のリスクも高まります。これらの技術の健全な発展と利用のためのガイドライン策定が急務です。
今後の展望としては、これらの課題を克服しつつ、エッジコンピューティング(デバイス側でのAI処理)によるリアルタイム性の向上、より少ないデータでの高精度な学習(Few-shot learning, Zero-shot learning)、他のAI技術(自然言語処理、音声認識など)との融合によるマルチモーダルAIの発展などが期待されています。画像認識AIは、今後も技術革新と社会実装が進み、私たちの社会にますます大きな影響を与えていくでしょう。
よくある質問 (FAQ)
画像認識AIと画像処理の違いは何ですか?
画像処理は、画像の品質改善(ノイズ除去、コントラスト調整など)や特徴抽出を行う「前処理」の段階です。一方、画像認識AIは、画像処理されたデータを用いて、画像内の物体やパターンを「識別・理解」する技術です。画像処理は、画像認識の精度を高めるための重要なステップと言えます。
画像認識AIの学習にはどのようなデータが必要ですか?
多くの場合、「教師データ」と呼ばれるラベル付けされた大量の画像データが必要です。例えば、猫を認識させたい場合は、様々な種類の猫の画像に「猫」というラベルを付けて学習させます。データの量と質(多様性、正確なラベリング)がAIの性能に大きく影響します。最近では、ラベルなしデータを用いる教師なし学習や、少量のデータで学習する技術も研究されています。
画像認識AIを導入する際の主な課題は何ですか?
主な課題としては、質の高い学習データの収集と整備、プライバシー保護や倫理的配慮、誤認識のリスク管理、導入・運用コスト、そして専門知識を持つ人材の確保などが挙げられます。また、特定の環境や条件下でのみ高い性能を発揮し、異なる状況では精度が低下する汎化性能の問題も課題となることがあります。
画像認識AIの精度はどのくらいですか?
画像認識AIの精度は、タスクの種類、使用するアルゴリズム、学習データの質と量、そして評価環境によって大きく異なります。特定の条件下では人間を超える精度を達成することもありますが、常に100%正確であるとは限りません。例えば、ImageNetのような大規模な画像認識コンペティションでは、トップクラスのモデルは90%以上の精度を達成しています。しかし、実世界の複雑な環境では、予期せぬ要因により精度が低下することもあります。
さらに探求するために
画像認識AIについてさらに深く知りたい場合は、以下の関連クエリで検索してみてください。
- ディープラーニングは画像認識AIの精度をどのように向上させましたか?
- 画像認識AIの倫理的な課題と、それに対する対策は何ですか?
- 将来、画像認識AIは私たちの生活をどのように変える可能性がありますか?
- 医療分野における画像認識AIの最新の進展について教えてください。
参考文献
Last updated May 10, 2025