
掌握 Isaac Lab:Unitree Go2 PPO 强化学习训练与网络定制权威指南
一步步教你使用 Isaac Lab 为 Go2 机器人实现 PPO 训练,并深入定制神经网络。
欢迎来到本教程,我们将深入探讨如何利用 NVIDIA Isaac Lab 这一强大的机器人学习框架,为先进的 Unitree Go2 四足机器人实施强化学习训练。本指南将重点介绍 Proximal Policy Optimization (PPO) 算法,这是一种在机器人控制领域广泛应用且效果显著的方法。我们将一步步指导您完成环境设置、Go2 仿真配置、PPO 训练流程,并特别关注如何定制训练神经网络以优化机器人性能。请注意,您查询中的 "MOB PPO" 可能是 PPO 的误写或特定变体,本教程将聚焦于标准的 PPO 算法及其在 Isaac Lab 中的应用。
核心要点速览
快速掌握本教程的关键信息
- Isaac Lab 环境搭建: 了解运行 Go2 训练所需的系统要求、软件依赖,并完成 Isaac Lab 的安装与配置。
- Go2 的 PPO 训练: 掌握使用 PPO 算法在 Isaac Lab 仿真环境中训练 Unitree Go2 机器人(例如学习行走或平衡)的核心流程。
- 神经网络定制: 学习如何修改 PPO 算法中 Actor(策略)和 Critic(价值)网络的结构,以适应 Go2 的特定任务需求和提升学习效率。
第一步:准备就绪 - 环境设置与安装
配置您的开发环境以运行 Isaac Lab 和 Go2 仿真
在开始训练之前,确保您的系统满足 Isaac Lab 的要求并正确安装所有必要的软件。这是一个关键的基础步骤。
系统硬件与软件要求
- 操作系统: 推荐使用 Linux (Ubuntu 20.04 或 22.04)。
- GPU: 需要一块 NVIDIA GPU(推荐 RTX 系列或更高级别),并安装相应的驱动程序。
- CUDA: 安装 CUDA Toolkit(推荐版本 11.8 或更高),这是 GPU 加速计算的基础。
- Python: 需要 Python 3.7 或更高版本。建议使用 Anaconda 或 Miniconda 创建独立的虚拟环境以管理依赖。
安装 Isaac Lab
请遵循 Isaac Lab 官方文档的最新指南进行安装。通常包括以下步骤:
- 克隆仓库: 从 GitHub 获取 Isaac Lab 的源代码。
git clone https://github.com/isaac-sim/IsaacLab.git cd IsaacLab - 创建并激活 Conda 环境:
# 建议使用官方提供的设置脚本或根据文档手动创建 conda create -n isaaclab python=3.8 # 或推荐版本 conda activate isaaclab - 安装依赖: Isaac Lab 通常会提供安装脚本或 `requirements.txt` 文件。关键依赖包括 PyTorch(用于 PPO 算法)和 Isaac Sim 相关库。
# 示例:安装 PyTorch (请根据您的 CUDA 版本选择) pip install torch torchvision torchaudio --extra-index-url https://download.pytorch.org/whl/cu118 # 安装其他依赖 (可能通过脚本完成) ./setup_conda_env.sh # (如果提供) 或 pip install -r requirements.txt - 验证安装: 运行一个简单的 Isaac Lab 测试脚本,确保环境配置成功。例如,创建一个空场景:
如果成功启动模拟器并显示空场景,则表示环境基本就绪。python source/standalone/tutorials/00_sim/create_empty.py
获取 Unitree Go2 模型
您需要 Unitree Go2 的 USD (Universal Scene Description) 格式 3D 模型文件。这可能需要从 Unitree 官方、社区资源或 Isaac Lab 的示例资源中获取。确保模型文件包含了机器人的物理属性(质量、惯性、关节限制等)以进行准确仿真。将下载的 USD 文件放置在 Isaac Lab 项目的资源目录中(例如 `source/extensions/omni.isaac.lab_assets/resources/robots/unitree_go2`)。
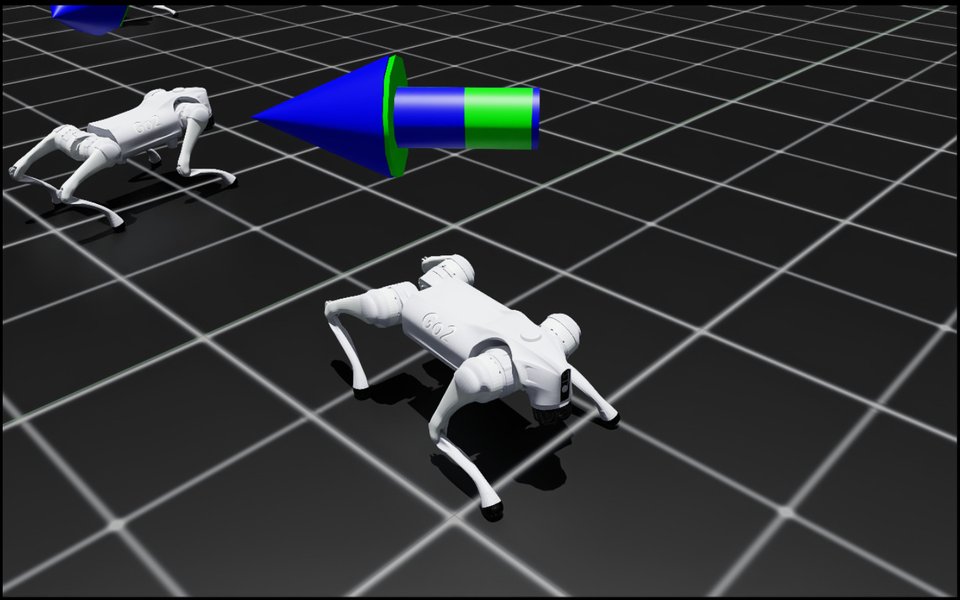
上图展示了 Unitree Go2 机器人在 Isaac Lab 仿真环境中的一个示例。
第二步:理解核心 - PPO 算法在 Isaac Lab 中的应用
掌握 PPO 强化学习算法的基础及其与 Go2 训练的相关性
Proximal Policy Optimization (PPO) 是 Isaac Lab 中进行强化学习训练(尤其是运动控制任务)的首选算法之一。它是一种基于策略梯度的 Actor-Critic 方法,以其稳定性和数据效率而闻名。
PPO 关键概念
- Actor-Critic 架构: PPO 同时学习一个策略网络(Actor,决定采取什么动作)和一个价值网络(Critic,评估状态或状态-动作对的价值)。
- 策略更新: PPO 使用一种特殊的目标函数,通过裁剪(clipping)概率比率来限制每次迭代中策略的更新幅度,从而避免过大的、破坏性的更新,提高训练稳定性。
- 优势函数 (Advantage Function): 用于衡量在特定状态下采取某个动作相对于平均动作的好坏程度,指导策略向更高奖励的方向更新。
- Isaac Lab 实现: Isaac Lab 通常集成 RSL-RL (Robotics Systems Lab - Reinforcement Learning) 库或其他类似库来实现 PPO。这些库经过优化,能够利用 GPU 进行大规模并行环境仿真和训练,极大地加速了学习过程。
PPO 与 Go2 运动控制
对于 Unitree Go2 这样的四足机器人,PPO 非常适合训练复杂的运动技能,例如:
- 平衡维持: 学习在静态或动态干扰下保持稳定。
- 步态生成: 学习行走、小跑、跳跃等不同步态。
- 导航与避障: 在复杂环境中移动并避开障碍物。
训练目标通常通过精心设计的奖励函数来定义,奖励机器人期望的行为(如前进速度、身体姿态稳定、能量效率)并惩罚不期望的行为(如摔倒、关节力矩过大)。
第三步:构建舞台 - 设置 Go2 仿真环境
在 Isaac Lab 中创建并配置 Go2 机器人的仿真场景
现在,我们将利用 Isaac Lab 创建一个包含 Go2 机器人的仿真环境,为接下来的 PPO 训练做准备。
创建仿真场景
Isaac Lab 提供了用于构建和管理仿真场景的工具和 API。您通常需要编写一个 Python 脚本来定义场景。
- 导入必要的库: 导入 Isaac Lab 场景管理和机器人相关的类。
- 实例化场景: 创建一个场景对象。
- 添加地面: 添加一个平面或地形作为机器人行走的基础。
- 添加 Go2 机器人: 使用之前准备好的 Go2 USD 文件将机器人添加到场景中,并设置其初始位置和姿态。
from omni.isaac.lab.app import AppLauncher # Launch the simulator app_launcher = AppLauncher(headless=False) # Set headless=True for training without GUI simulation_app = app_launcher.app from omni.isaac.lab.assets import AssetBaseCfg, AssetStorage, Robot from omni.isaac.lab.envs import ManagerBasedRLEnv from omni.isaac.lab.scene import InteractiveScene, InteractiveSceneCfg from omni.isaac.lab.sim import SimulationContext from omni.isaac.lab.utils import configclass # Example of adding Go2 (specific configuration might vary based on Isaac Lab version and setup) @configclass class Go2RobotCfg(AssetBaseCfg): # Define robot configuration, e.g., USD path, sensors, controllers pass # Setup simulation context sim_cfg = SimulationContext.SimulationCfg(device="cuda:0") # Use GPU sim = SimulationContext(sim_cfg) # Setup scene scene_cfg = InteractiveSceneCfg(num_envs=64, env_spacing=2.0) # Example for parallel envs scene = InteractiveScene(scene_cfg) # Add Go2 robot to the scene go2_robot = Robot(cfg=Go2RobotCfg(prim_path="{ENV_REGEX_NS}/Robot")) scene.add_asset("go2", go2_robot) # ... further scene and environment setup ... # Important: This is a conceptual example. Refer to Isaac Lab tutorials # (e.g., 'add_robot_to_scene.py' or environment setup examples) for exact implementation. - 配置物理参数: 设置仿真环境的物理属性,如重力、物理步长、碰撞属性等。
- 配置传感器: 定义机器人需要使用的传感器,如 IMU、关节编码器、足底接触传感器等。观测数据将作为 PPO 网络的输入。
请参考 Isaac Lab 官方提供的教程(例如 `source/standalone/tutorials/01_assets/add_robot_to_scene.py` 或特定环境的配置文件)来获取具体的实现代码和配置细节。
第四步:量身定制 - 定制 PPO 训练网络
修改 Actor 和 Critic 神经网络结构以优化 Go2 性能
标准的 PPO 实现通常使用简单的多层感知器 (MLP) 作为 Actor 和 Critic 网络。Isaac Lab 允许您轻松地定制这些网络的结构,以更好地适应 Go2 机器人的复杂性和特定任务的需求。
上图示意了强化学习中常用的神经网络结构,PPO 的 Actor 和 Critic 网络通常采用类似的多层结构。
为什么要定制网络?
- 处理高维观测: Go2 机器人的状态信息(关节角度、速度、IMU 数据等)可能是高维的,更深或更宽的网络可能有助于提取有效特征。
- 任务复杂度: 复杂的运动任务可能需要更强大的函数逼近能力,调整网络层数、神经元数量或激活函数可能带来性能提升。
- 先验知识融入: 如果对任务有特定理解,可以通过网络结构设计(如卷积层处理视觉输入,虽然本例主要关注本体感知)来利用这些知识。
如何定制网络?
定制过程通常涉及修改 Isaac Lab 中 PPO 训练流程所使用的配置文件或代码。
- 定位配置文件: 找到负责定义 PPO 算法和网络结构的文件。这通常在 Isaac Lab 的工作流目录中,例如 `source/standalone/workflows/rsl_rl/` 下的 `train.py` 或相关的配置文件 (`config.py`, 或特定环境的配置类)。
- 修改网络定义:
- 在配置文件中指定: 许多 Isaac Lab 示例允许通过配置文件直接指定 Actor 和 Critic 网络的隐藏层大小和激活函数。例如,在 YAML 或 Python 配置类中设置类似 `actor_mlp: { units: [512, 256, 128], activation: 'elu' }` 的参数。
- 通过代码修改: 如果需要更复杂的定制(如添加不同类型的层),您可能需要直接修改 RSL-RL 库中定义网络模型的部分,或者在您的训练脚本中定义一个自定义的 PyTorch `nn.Module` 类,并将其传递给 PPO 算法。
import torch
import torch.nn as nn

# Example of a custom Actor network using PyTorch
class CustomGaitActor(nn.Module):
    def __init__(self, obs_dim, action_dim, hidden_dims=[512, 256, 128]):
        super().__init__()

        layers = []
        input_dim = obs_dim
        for hidden_dim in hidden_dims:
            layers.append(nn.Linear(input_dim, hidden_dim))
            layers.append(nn.ELU()) # Example activation function
            input_dim = hidden_dim

        layers.append(nn.Linear(input_dim, action_dim))
        # Potentially add Tanh for bounded actions, or handle action distribution later

        self.network = nn.Sequential(*layers)

    def forward(self, observations):
        # Process observations if needed (e.g., normalization)
        return self.network(observations)

# In your training script or config, you would then instantiate this custom network
# and pass it to the PPO agent configuration.
# agent_cfg.policy.actor_network = CustomGaitActor(...)
# (Syntax depends on specific Isaac Lab/RSL-RL version)
- 调整超参数: 定制网络结构后,可能需要重新调整相关的超参数,如学习率、批次大小等,以获得最佳性能。
务必参考您所使用的 Isaac Lab 版本和 RSL-RL 库的文档,了解定制网络结构的具体方法和配置选项。
第五步:开始训练 - 实现 Go2 的 PPO 训练
运行 PPO 算法,让 Go2 在仿真中学习运动技能
配置好环境、场景和网络后,就可以开始实际的训练过程了。
配置训练任务
- 选择或创建环境: Isaac Lab 提供了许多预定义的环境(如 `Isaac-Velocity-Flat-Unitree-Go2-v0`)。您可以选择一个适合您目标的环境,或者基于现有环境创建自定义环境,特别是如果您修改了奖励函数或任务目标。
- 定义奖励函数: 这是强化学习的关键。您需要在环境代码中定义一个函数,根据机器人的状态和动作计算奖励信号。好的奖励函数应该清晰地引导机器人学习期望的行为。例如,奖励前进速度、身体高度维持、直立姿态,同时惩罚能量消耗、关节极限、身体与地面碰撞等。
# Example reward function logic (within the environment class) def compute_rewards(self): # Base velocity reward base_vel_xy = self.robot.data.root_lin_vel_w[:, 0:2] reward_fwd_vel = torch.norm(base_vel_xy, dim=1) * self.reward_scales["forward_velocity"] # Penalty for high joint torques (energy efficiency) torque_penalty = torch.sum(torch.square(self.robot.data.applied_torques), dim=1) * self.reward_scales["torque_penalty"] # Penalty for deviation from desired height base_height = self.robot.data.root_pos_w[:, 2] height_error = torch.square(base_height - self.desired_height) height_penalty = height_error * self.reward_scales["height_penalty"] # Penalty for falling (e.g., base contact or orientation threshold) fall_penalty = (self.robot.data.base_contact | (self.robot.data.projected_gravity_b[:, 2] < 0.5)).float() \ * self.reward_scales["fall_penalty"] # Combine rewards and penalties total_reward = reward_fwd_vel - torque_penalty - height_penalty - fall_penalty # Apply termination penalties if needed # ... self.rewards[:] = total_reward - 设置训练参数: 在训练脚本或配置文件中设置 PPO 的超参数,如学习率 (`learning_rate`)、折扣因子 (`gamma`)、PPO 裁剪参数 (`clip_param`)、并行环境数量 (`num_envs`)、训练总步数 (`max_iterations` 或 `total_timesteps`) 等。
运行训练脚本
使用 Isaac Lab 提供的命令行工具或直接运行 Python 脚本来启动训练。通常会有一个类似 `train.py` 的主训练脚本。
# Example command using isaaclab.sh wrapper (adjust paths and task name)
./isaaclab.sh -p source/standalone/workflows/rsl_rl/train.py --task Isaac-Velocity-Flat-Unitree-Go2-v0 --num_envs 4096 --headless

# Or directly using python (ensure environment is activated)
# cd <path_to_isaac_lab>
# python source/standalone/workflows/rsl_rl/train.py --task Isaac-Velocity-Flat-Unitree-Go2-v0 --num_envs 4096 --headless- `--task`: 指定要训练的环境名称。
- `--num_envs`: 指定并行运行的环境实例数量。利用 GPU 加速,通常设置较高(如几百到几千)。
- `--headless`: 在无图形用户界面模式下运行,通常用于服务器或加速训练。
- 您可能还需要传递其他参数来指定日志记录路径、加载检查点或覆盖默认配置。
训练过程可能需要数小时甚至数天,具体取决于任务复杂度、硬件性能和训练设置。训练过程中会定期保存模型检查点和 TensorBoard 日志,方便您监控学习进度(如奖励曲线、策略损失等)。
超参数调优的重要性
PPO 算法的性能很大程度上取决于超参数的选择。没有一组通用的最佳参数,通常需要根据具体任务进行调整。下方的图表和表格展示了一些关键超参数及其可能的影响,帮助您理解调优过程中的权衡。
上图展示了不同 PPO 超参数配置组合可能对训练结果产生的多维度影响(评分为示意性,非精确数据)。例如,“高学习率/大批次”可能收敛更快但牺牲稳定性,而“低学习率/小批次”可能更稳定但收敛较慢。调优的目标是在这些因素之间找到最佳平衡。
关键 PPO 超参数及其影响
| 超参数 | 典型范围/值 (四足运动) | 影响 | 调优建议 |
|---|---|---|---|
| 学习率 (Learning Rate) | 1e-4 到 1e-3 | 控制模型参数更新的步长。过高可能导致不稳定,过低则收敛缓慢。 | 通常从 5e-4 或 1e-3 开始,配合学习率衰减策略。 |
| 折扣因子 (Gamma, γ) | 0.95 到 0.995 | 衡量未来奖励的重要性。值越高,越看重长期回报。 | 对于需要远见的任务(如长距离行走),设置较高值(如 0.99)。 |
| GAE 参数 (Lambda, λ) | 0.9 到 0.98 | 用于 Generalized Advantage Estimation,平衡偏差和方差。 | 常用值 0.95。 |
| PPO 裁剪系数 (Clip Range, ε) | 0.1 到 0.3 | 限制策略更新幅度,提高稳定性。 | 常用值 0.2。 |
| 批次大小 (Minibatch Size) | 几千 到 几万 (总步数/更新次数) | 每次更新使用的数据量。影响梯度估计的准确性和计算效率。 | 根据 GPU 显存和并行环境数量调整。 |
| 训练轮数 (Epochs per Update) | 5 到 15 | 每次收集数据后,对数据重复使用的次数。 | 增加可提高样本效率,但可能导致过拟合当前批次数据。 |
| 熵系数 (Entropy Coefficient) | 0 到 0.01 | 鼓励策略探索(增加动作随机性)。 | 开始时设置较高值,随训练逐渐减小,或保持一个较小的值。 |
| 并行环境数 (Num Envs) | 几百 到 几千 | 同时运行的仿真实例数量。 | 尽可能利用 GPU 并行能力,显著加速数据收集。 |
上表总结了 PPO 中一些重要的超参数,它们在训练四足机器人运动时的典型取值范围、主要影响以及一些调优建议。
第六步:检验成果 - 评估与 Sim-to-Real
测试训练好的策略并在仿真与现实世界间架起桥梁
在仿真中测试策略
训练完成后,需要评估学习到的策略的效果。Isaac Lab 通常提供一个 `play.py` 或类似的脚本,用于加载训练好的模型检查点并在仿真环境中运行。
# Example command to play a trained policy
./isaaclab.sh -p source/standalone/workflows/rsl_rl/play.py --task Isaac-Velocity-Flat-Unitree-Go2-v0 --checkpoint /path/to/your/checkpoint.pt --num_envs 64
这将启动仿真环境(通常带有图形界面),加载指定的模型检查点,并让 Go2 机器人按照学习到的策略执行动作。您可以观察机器人的行为,评估其稳定性、速度和任务完成情况。
观看这段视频,了解 Unitree Go2 在 Isaac Sim/Lab 仿真环境中结合 ROS2 进行模拟和控制的示例。这展示了仿真测试和与机器人操作系统集成的可能性,是 Sim-to-Real 过程中的重要环节。
Sim-to-Real 转移
强化学习的最终目标往往是将仿真环境中学习到的策略成功部署到真实的物理机器人上。这就是所谓的“模拟到现实”(Sim-to-Real)转移。
- 挑战: 现实世界与仿真环境之间总是存在差异(“reality gap”),包括物理参数的不准确性、传感器噪声、执行器延迟等。直接转移仿真策略可能效果不佳。
- 策略:
- 域随机化 (Domain Randomization): 在仿真中故意引入物理参数、传感器读数、外力等的随机变化,使策略对这些变化更具鲁棒性,从而更好地适应现实世界。
- 系统辨识 (System Identification): 更精确地测量真实机器人的物理参数,并在仿真中使用这些参数。
- 自适应策略 (Adaptive Policies): 设计能够在线调整以适应现实环境的策略。
- 少量真实世界数据微调: 在仿真中预训练后,使用少量真实机器人收集的数据对策略进行微调。
- 部署: 将训练好的模型参数(通常是神经网络权重)加载到运行在真实 Go2 机器人上的控制程序中。这通常需要通过 ROS (Robot Operating System) 或其他机器人中间件进行通信和控制。
成功实现 Sim-to-Real 是机器人强化学习领域的一个重要研究方向,需要仔细考虑仿真环境的保真度和策略的鲁棒性。
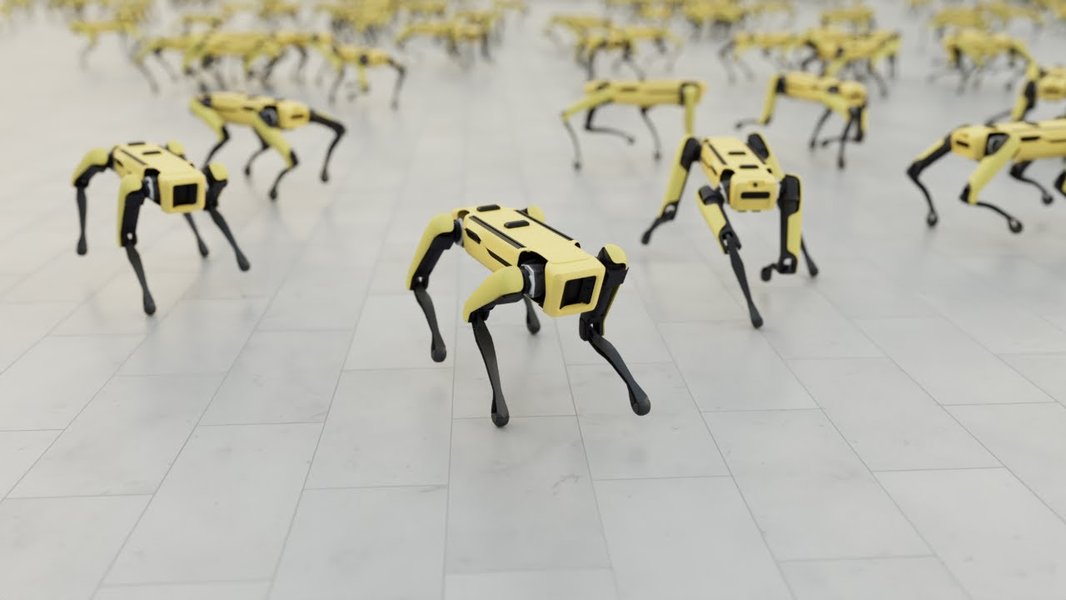
上图展示了 Sim-to-Real 的概念,即将在仿真中训练的策略部署到物理机器人上,是机器人学习的重要目标。
工作流程概览:Mindmap
可视化 Go2 PPO 训练的完整步骤
下面的思维导图总结了使用 Isaac Lab 为 Unitree Go2 进行 PPO 训练并定制网络的整个流程,帮助您建立清晰的整体认识。
常见问题解答 (FAQ)
关于 Isaac Lab、PPO 和 Go2 训练的常见疑问
什么是 Isaac Lab?
Isaac Lab 是 NVIDIA 开发的一个统一且模块化的机器人学习框架。它建立在 NVIDIA Isaac Sim 仿真平台之上,利用其先进的物理仿真(PhysX)和逼真的渲染能力,为强化学习(RL)、模仿学习和运动规划等机器人研究领域提供高效的开发和测试环境。它特别适合需要大规模并行仿真的任务,如训练复杂的机器人运动策略。
什么是 PPO 算法?为什么用它训练 Go2?
PPO (Proximal Policy Optimization) 是一种强化学习算法,属于策略梯度方法。它通过引入一个裁剪的目标函数来限制策略更新的幅度,从而在保证学习效率的同时提高了训练的稳定性。PPO 在连续控制任务(如机器人运动)中表现出色,因为它相对容易实现和调整,并且对超参数不敏感。对于 Go2 这样的四足机器人,其运动控制涉及高维度的状态和动作空间,PPO 能够有效地学习复杂的步态和平衡策略。
为什么需要定制训练网络?默认的不行吗?
默认的网络结构(通常是几层 MLP)在许多任务中都能工作,但并非最优。定制网络结构允许您:
- 匹配任务复杂度: 更复杂的任务可能需要更深或更宽的网络来捕捉状态和动作之间的复杂关系。
- 优化特征提取: 调整网络结构可能有助于从高维传感器数据中提取更有用的特征。
- 提高学习效率或性能: 合适的网络结构可能加快收敛速度或达到更高的最终性能。
- 尝试不同架构: 可以试验不同的激活函数、层类型(尽管 MLP 最常用)或连接方式。
虽然不是必须的,但定制网络是提升 PPO 训练效果的一种常用手段。
什么是 Sim-to-Real?它有多难?
Sim-to-Real (模拟到现实) 是指将在计算机仿真环境中训练好的机器人策略(如 PPO 训练的神经网络)部署到真实的物理机器人上,并使其能够成功运行的过程。这是一个重要的挑战,因为仿真环境无法完全精确地复制现实世界的所有物理细节、传感器噪声和执行器行为,这种差异被称为“Reality Gap”。
克服 Sim-to-Real 差距通常需要结合使用多种技术,如域随机化(在仿真中增加变化性)、系统辨识(精确测量机器人参数)和鲁棒控制策略。Sim-to-Real 的难度取决于任务的复杂性、仿真环境的保真度以及所使用技术的有效性,是当前机器人学习领域的研究热点。
参考资料
深入学习的相关链接
- Isaac Lab Documentation - Isaac Lab
-
弥合仿真与现实差距:借助 NVIDIA Isaac Lab 训练 Spot 四足机器人运动 - NVIDIA 博客
-
用 Isaac Sim/Lab 对宇树机器狗 Go2 做仿真训练 - 知乎专栏
-
Isaac Lab GitHub Repository - GitHub
-
解剖 Isaac Lab 对宇树机器狗 Go2 的仿真训练 - 知乎专栏
- go2_omniverse: Unitree Go2 Integration with Nvidia Isaac Sim (Orbit) - GitHub
推荐探索
扩展您的知识边界
Last updated April 15, 2025