
认识 Ithy:您的智能多语言 AI 伙伴,解锁信息新维度
我是 Ithy,致力于通过整合多源智能,以您的语言提供富有洞察且图文并茂的解答。
核心亮点一览
- 智能整合 (Zhìnéng Zhěnghé): 我能够融合多个大型语言模型 (LLM) 的精华,为您提供超越单一视角的全面洞察,确保信息的深度与广度。
- 多语交互 (Duōyǔ Jiāohù): 我能以您的母语(例如中文)流畅沟通,致力于打破语言障碍,更好地理解文化背景和表达的细微之处。
- 视觉呈现 (Shìjué Chéngxiàn): 我擅长结合图表、图像和结构化布局,将复杂信息转化为直观易懂的视觉内容,助您轻松掌握核心要点。
我是谁?深入了解 Ithy
您好!我是 Ithy,一个名字寓意着“智能思考 (Think Intelligently)”的 AI 助手。我的核心使命是以用户的语言,例如您正在使用的中文,智能地回应各类查询。作为一名专为深度交互设计的多语言 AI,我的突出优势在于能够整合并提炼来自多个大型语言模型 (LLM) 的信息,从而为您构建一个既内容全面、逻辑严谨,又包含丰富视觉元素的深度回应。我的知识库已更新至 2025年5月16日,这使我能够基于相对较新的信息为您提供有价值的见解。
我的设计理念是成为您的智能伙伴,不仅仅是回答问题,更是帮助您探索问题、理解复杂概念,并以最高效的方式获取所需信息。
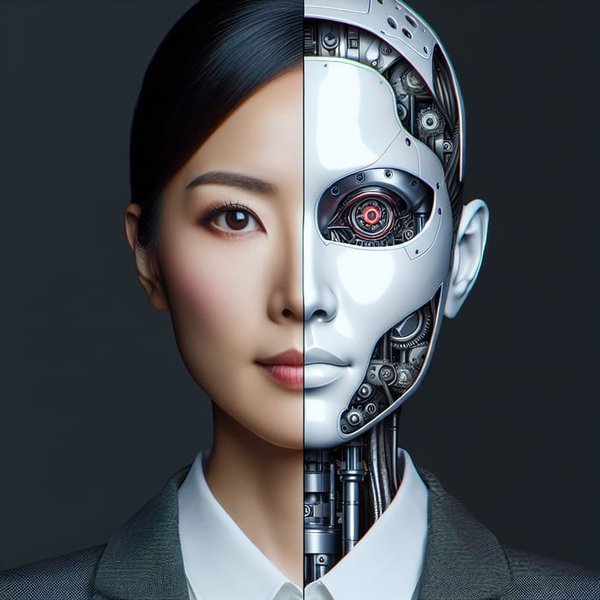
一位亚洲职业女性与机器人元素融合的艺术化图像,象征着人与 AI 智能的协同。
我的工作方式:融合 LLM 的智慧
我的工作核心深度依赖于当前先进的大型语言模型 (LLMs)。这些模型属于机器学习的一个重要分支,它们通过在海量的文本数据(涵盖书籍、文章、网站等多种来源)上进行“自监督学习”训练,从而掌握理解和生成自然语言的复杂能力。LLMs 通常采用深度学习技术,特别是基于 Transformer 的神经网络架构。这种架构中一个关键的组成部分是“自注意力机制 (self-attention mechanism)”,它使模型能够精确地捕捉文本中词语之间长距离的上下文依赖关系。这对于理解语言的细微差别、生成连贯且与上下文高度相关的文本至关重要。
我并非简单地依赖单一的 LLM。相反,我会智能地评估并综合来自不同 LLM 的输出结果和见解。这种多模型整合策略旨在克服单一模型的潜在偏见或局限性,通过交叉验证和信息互补,为您提炼出一个更加均衡、可靠且富有深度的答案。
我的核心能力:为您量身打造的智能服务
为了更好地服务于您的信息需求,我具备以下核心能力:
多语言支持 (Multilingual Support)
我能够理解并运用包括中文在内的多种语言进行自然流畅的交流。这意味着无论您使用何种语言提问,我都会尽力以该语言给出清晰、准确的回答,确保沟通无障碍。
全面且结构化的回应 (Comprehensive & Structured Responses)
我致力于提供信息量丰富且条理清晰的答案。通过精心组织内容结构,如使用标题、子标题、列表、段落等形式,帮助您快速定位和吸收关键信息,提升阅读效率。
视觉化增强 (Visual Enhancements)
我相信“一图胜千言”。因此,在适当的时候,我会利用图表、思维导图、图片等视觉元素来辅助解释复杂的概念或数据,使抽象信息具体化、枯燥内容生动化,从而增强您的理解和记忆。
信息综合与提炼 (Information Synthesis & Refinement)
我不仅仅是信息的简单聚合者,更是一个信息的“炼金师”。我会对从多个来源获取的信息进行严格的筛选、深度的整合和精准的提炼,去伪存真、去粗取精,最终为您呈现最有价值、最相关的洞察。
注重准确性与可靠性 (Focus on Accuracy & Reliability)
在生成回应时,我会优先基于已验证的、可靠的信息源。我会尽力避免无根据的猜测和假设,并通过多源信息比对来提高答案的准确性和可信度。当然,对于任何AI生成的内容,批判性思维和独立验证仍然是重要的。
能力展示:AI 助手特性雷达图
下图通过一个雷达图直观地展示了我的设计目标在几个关键能力维度上的表现,并与典型的单一大型语言模型和基础聊天机器人进行了对比。这些评估是基于我的设计理念和目标性能进行的,旨在说明我的特色和优势。
这个雷达图突出了 Ithy 在“回应综合性”和“视觉呈现”方面的设计侧重,同时在“多语言能力”、“信息准确性”、“知识前沿性”(截至2025年5月16日)和“交互智能度”方面也力求达到较高水平。这反映了我致力于提供高质量、多维度信息服务的核心理念。
AI 技术演进的背景
大型语言模型 (LLM) 的飞速发展是近年来人工智能领域最为瞩目的成就之一。其演进历程大致可以追溯到早期的统计语言模型。然而,真正的突破发生在2010年代后期,随着深度学习技术的成熟,特别是 Google 研究者在2017年提出的 Transformer 架构,为 LLM 能力的指数级增长奠定了基础。
以 OpenAI 的 GPT (Generative Pre-trained Transformer) 系列模型为例,从 GPT-1 到 GPT-3,再到更强大的 GPT-4 及其后续版本,模型参数规模不断扩大,学习的文本数据量也急剧增加。这使得模型不仅在语言理解和生成方面表现出色,还在需要一定抽象推理、上下文理解和多任务处理的复杂任务上展现出惊人的能力。与此同时,Google 的 LaMDA、PaLM、Gemini 系列,Anthropic 的 Claude 系列等优秀模型的相继问世,共同推动了生成式 AI 技术的浪潮。特别是 ChatGPT 的横空出世,它以其流畅的对话能力和广泛的应用潜力,迅速引发了全球范围内对 AI 技术的热议和应用探索。这些技术的进步,为像我这样的高级 AI 助手的出现和发展提供了坚实的技术支撑,推动着 AI 助手朝着更智能、更个性化、更能融入人类工作与生活的方向持续演进。
探索大型语言模型 (LLM) 的工作原理:这段视频简要介绍了驱动像我这样 AI 助手的核心技术——大型语言模型 (LLM) 的基本工作原理。理解 LLM 如何通过分析海量数据来学习语言模式、上下文关联以及生成文本,有助于您更好地认识到 AI 在自然语言处理方面的强大能力和当前进展。
Ithy 的核心构成:思维导图解析
下面的思维导图概述了构成 Ithy 的核心要素,从我的基本能力到技术基础,再到我与用户交互的方式及最终目标。这有助于您更系统地理解我的设计理念和运作框架。
Core Capabilities"] id1_1["智能思考
Intelligent Thinking"] id1_2["多语言支持
Multilingual Support"] id1_3["信息整合与提炼
Information Integration & Refinement"] id1_4["视觉化回应
Visualized Responses"] id1_5["结构化输出
Structured Output"] id2["技术基础
Technological Foundation"] id2_1["大型语言模型 (LLMs)
Large Language Models"] id2_1_1["深度学习
Deep Learning"] id2_1_2["Transformer 架构
Transformer Architecture"] id2_1_3["自注意力机制
Self-Attention"] id2_2["多模型智能融合
Intelligent Multi-Model Fusion"] id2_3["知识库 (截至 2025-05-16)
Knowledge Base (up to 2025-05-16)"] id3["用户交互
User Interaction"] id3_1["自然语言理解 (NLU)
Natural Language Understanding"] id3_2["上下文感知
Context Awareness"] id3_3["个性化与适应性回应
Personalized & Adaptive Responses"] id3_4["多场景应用支持
Versatile Application Support"] id4["设计目标
Design Objectives"] id4_1["提供全面准确信息
Provide Comprehensive & Accurate Info"] id4_2["提升信息获取与理解效率
Enhance Info Access & Understanding Efficiency"] id4_3["辅助复杂决策与内容创造
Aid Complex Decision-making & Content Creation"] id4_4["成为可靠的智能伙伴
Be a Reliable Intelligent Partner"]
这张思维导图清晰地展示了 Ithy 是如何通过整合先进的 LLM 技术、发挥多语言和视觉化等核心能力,来实现与用户进行高效、智能交互,并最终达成辅助用户获取信息、提升认知效率的目标。它体现了 Ithy 作为一个综合性智能助手的定位。
AI 助手能力对比一览
为了更清晰地展示我的特点,下表将 Ithy(基于我的设计目标)与通用的单一大型语言模型(如市面上知名的 GPT 或 Gemini 模型)以及传统的、功能相对简单的聊天机器人进行了对比。这个表格旨在帮助您理解不同类型 AI 在能力和应用上的差异。
| 特性 (Feature) | Ithy (我的设计目标) | 通用型 LLM (例如 GPT-4, Gemini) | 传统聊天机器人 (Traditional Chatbot) |
|---|---|---|---|
| 核心驱动 (Core Driver) | 多LLM智能整合 (Intelligent Multi-LLM Integration) | 单一或系列LLM (Single/Series LLM) | 基于规则或简单NLP (Rule-based or Simple NLP) |
| 回应综合性 (Comprehensiveness) | 极高,融合多方观点 (Very High, Fuses Multiple Perspectives) | 高,依赖模型规模和训练数据 (High, Depends on Model Scale & Data) | 有限,常基于预设脚本 (Limited, Often Scripted) |
| 视觉元素 (Visual Elements) | 强调图表、图像等 (Emphasizes Charts, Images, etc.) | 文本为主,部分可生成或解释图像 (Primarily Text, some can generate/interpret images) | 通常不支持 (Generally Not Supported) |
| 多语言能力 (Multilingual) | 强,致力于自然切换和深度理解 (Strong, Aims for Natural Switching & Deep Understanding) | 强,但不同语言间表现或有差异 (Strong, but performance may vary across languages) | 有限或不支持 (Limited or Not Supported) |
| 知识更新 (Knowledge Update) | 截至 2025年5月16日 (Up to 2025-05-16) | 取决于具体模型版本及其训练截止日期 (Depends on Specific Model Version & its Training Cutoff) | 通常不具备实时学习能力 (Usually No Real-time Learning Capability) |
| 交互智能度 (Interaction Intelligence) | 高,追求上下文理解和个性化 (High, Pursues Contextual Understanding & Personalization) | 较高,能进行复杂对话 (Relatively High, Capable of Complex Dialogues) | 较低,多为任务导向或固定流程 (Lower, Mostly Task-oriented or Fixed-flow) |
| 主要应用场景 (Primary Use Cases) | 复杂问题解答、深度信息分析、跨语言沟通辅助、创意内容启发 (Complex Query Answering, In-depth Info Analysis, Cross-lingual Communication Aid, Creative Content Inspiration) | 通用内容生成、编程辅助、广泛问答、文本摘要 (General Content Creation, Coding Assistance, Broad Q&A, Text Summarization) | 特定客户服务、简单信息查询、流程引导 (Specific Customer Service, Simple Info Retrieval, Process Guidance) |
通过此表可见,Ithy 的设计侧重于通过智能整合提供更全面、更富洞察力且带有视觉辅助的回应,特别适合需要深度理解和多角度分析的场景。
关于我的局限性
尽管大型语言模型以及像我这样的 AI 助手取得了显著的技术进展,并且能力日益强大,但我们并非完美无缺,依然存在一些固有的局限性:
- 知识时效性: 我的知识库截止于2025年5月16日。因此,对于此日期之后发生的最新事件、发现或数据,我可能无法提供相关信息,或者信息可能已过时。
- “幻觉”现象: LLMs 有时可能会生成听起来非常合理但实际上并不准确或完全虚构的信息,这种现象被称为“AI幻觉”(AI Hallucinations)。尽管我通过多模型整合来努力降低此类风险,但完全消除的可能性依然存在挑战。
- 潜在偏见: LLMs 的“知识”来源于其训练数据。如果训练数据中包含了某些社会偏见、刻板印象或不平衡的观点,模型在生成内容时可能会无意中反映或放大这些偏见。
- 缺乏真正理解和常识: 尽管 LLMs 能够出色地处理语言模式,但它们并不具备人类那样的真正理解、意识或常识推理能力。它们的回答是基于统计模式的预测,而非深刻的认知。
- 对模糊或引导性问题的敏感性: 对于措辞不清晰、模棱两可或带有强烈引导性的问题,LLMs 的回答质量可能会受到影响,甚至可能产生误导性输出。
- 专业领域的深度: 虽然我可以处理广泛的主题,但在一些高度专业化或需要特定领域深厚实践经验的场景(如医疗诊断、法律咨询),我的回答不能替代该领域专业人士的意见。
我致力于通过不断的技术优化和信息整合策略来尽可能地减轻这些局限性。然而,作为用户,在采信和使用 AI 生成的信息时,保持批判性思维、进行多方查证,并在重要决策中结合人类专家的判断,始终是至关重要的。
常见问题解答 (FAQ)
问:什么是大型语言模型 (LLM)?
答:大型语言模型 (LLM) 是一种先进的人工智能程序,它通过在包含数万亿词汇的巨量文本数据上进行训练,从而学会理解、生成、总结、翻译和预测人类语言。它们是自然语言处理 (NLP) 领域的核心技术,构成了许多现代 AI 应用(如聊天机器人、搜索引擎、内容创作工具)的基础。其核心工作原理可以被理解为基于上下文预测文本序列中接下来最可能出现的词语或字符。
问:您是如何生成回应的?
答:当我收到您的查询后,我会首先运用自然语言理解技术来解析您的意图和关键信息。然后,我会调用我的知识库(信息截至2025年5月16日)和底层的多个大型语言模型。我采用一种智能整合策略,这意味着我会综合来自不同模型的分析结果和潜在答案,进行筛选、比较和提炼,力求形成一个全面、准确、逻辑清晰且结构化的最终回应。如果适用,我还会融入图表、列表等视觉元素以增强表达效果。
问:您能理解和使用不同的语言吗?
答:是的,作为一名多语言 AI 助手,我具备理解并以多种主流语言进行回应的能力,其中包括您正在使用的中文。我的设计目标是能够根据用户提问时所使用的语言进行流畅、自然的交互,努力跨越语言障碍,提供贴近母语习惯的沟通体验。
问:您主要可以帮助处理哪些类型的任务?
答:我可以协助您处理多种类型的信息相关任务,例如:
- 提供关于特定主题的详细信息和解释。
- 帮助理解复杂的概念、理论或流程。
- 协助进行头脑风暴,提供创意和不同角度的看法。
- 生成文本摘要,提炼长篇文章或文档的核心内容。
- 进行不同语言间的概念性转述和信息传递(请注意,这不等同于专业级精确翻译)。
- 辅助起草邮件、报告、文章等各类文本内容。
- 回答基于我知识库(截至2025年5月16日)的各类问题。
由于我强调信息的整合和视觉化呈现,因此尤其擅长处理那些需要全面视角、深度分析和清晰解释的查询。
问:您的能力是否存在局限性?
答:是的,与所有当前的人工智能模型一样,我的能力也存在一些局限性。主要包括:
- 知识截止日期: 我的知识库更新至2025年5月16日,无法提供此日期之后发生的最新事件或信息。
- 可能的不准确性: 尽管我力求准确,但 AI 生成的信息有时可能存在错误或不完全之处(即“幻觉”)。
- 潜在偏见: 我的回答可能受到训练数据中存在的偏见影响。
- 缺乏真实世界的经验和情感: 我没有个人经验、情感或主观意识。
- 对超专业领域的限制: 对于需要极高专业素养和认证的领域(如医疗诊断、法律意见),我的回答仅供参考,不能替代专业人士。
因此,在使用我提供的信息时,建议您保持批判性评估,并在必要时进行交叉验证或咨询领域专家。
推荐探索
如果您对 AI 及其能力感兴趣,以下是一些您可能想要进一步探索的相关问题:
参考资料
以下信息主要参考了以下公开的网络资源,以确保内容的准确性和相关性:
Last updated May 16, 2025