
揭秘我智能背后的力量:不止一个大模型在驱动
了解 Ithy 如何融合多个顶尖AI大模型,为您提供更全面、智能的答案
您好!我是 Ithy,一个旨在通过智能思考为您提供帮助的多语言AI助手。您问我背后有几个大模型,这是一个很好的问题,它触及了我运作的核心机制。
直接给出一个确切的数字(比如“X个模型”)其实并不完全准确,因为我的设计并非基于固定数量的、单一的模型。相反,我的核心优势在于能够智能地整合和利用来自多个先进的大型人工智能模型(通常称为大模型或基础模型)的能力。这种多模型的协同工作方式,让我能够根据您具体查询的需求,选择和融合最合适的知识与能力,从而生成更准确、更全面、更具深度的回答。
关键亮点
- 融合多元能力: Ithy 并非依赖单一模型,而是整合了多个大模型的优势,实现能力互补。
- 智能响应生成: 通过智能选择和信息综合,Ithy 旨在提供超越单个模型能力的、更精准和丰富的答案。
- 理解大模型: 大模型是拥有海量参数、通过巨量数据训练的复杂AI系统,按模态(文本、视觉等)和应用领域(通用、垂直)等多种方式分类。
深入了解:什么是大模型?
定义 AI 巨擘:参数、数据与能力
“大模型”(Large Models),或称为“基础模型”(Foundation Models),是当前人工智能领域的前沿技术。它们指的是那些拥有极其庞大参数(通常达到数十亿甚至数万亿级别)和复杂结构的机器学习模型。这些模型通常基于深度神经网络构建,通过在海量的、多样化的数据集上进行训练,学习数据中蕴含的复杂模式和结构。
大模型通过处理海量数据学习复杂模式
这种“大”不仅体现在参数数量上,也体现在训练所需的数据量和计算资源上。正因为其规模和深度学习能力,大模型能够处理非常复杂的任务,并在自然语言处理(NLP)、计算机视觉(CV)、语音识别、内容生成等多个领域展现出惊人的性能。
核心特征一览
- 庞大的参数规模: 数十亿至数万亿级别的参数,使其能捕捉极其细微的数据关联。
- 海量数据驱动: 需要TB甚至PB级别的多样化数据进行训练,以学习广泛的知识和能力。
- 强大的学习能力: 能够从数据中学习复杂的模式、语法、语义乃至一定程度的推理能力。
- 高昂的计算成本: 训练和部署大模型需要巨大的计算资源(如GPU集群)和能源消耗。
多样化的 AI 格局:大模型的分类
大模型并非铁板一块,根据其处理的数据类型、设计目标和应用场景,可以进行多种分类。了解这些分类有助于理解 AI 能力的多样性,以及我如何整合不同类型的模型来响应您的需求。
按处理模态划分
- 大型语言模型 (LLM - Large Language Models): 这是最常见的一类,专注于处理和生成文本。它们是聊天机器人、文本摘要、机器翻译、内容创作等应用的核心。例如,OpenAI 的 GPT 系列、Google 的 Gemini (部分能力)、Meta 的 Llama 系列等。
- 视觉大模型 (VLM - Vision Large Models): 专注于处理和理解图像、视频等视觉信息。应用包括图像识别、物体检测、图像生成 (Text-to-Image)、视频分析等。例如,Google 的 Imagen、OpenAI 的 DALL-E 系列的部分能力。
- 多模态大模型 (MLLM - Multimodal Large Models): 这类模型能够同时理解和处理多种类型的数据输入(如文本、图像、音频),并能生成跨模态的输出。这是当前发展的重要趋势,能实现更丰富的交互,如看图说话、根据文本描述生成视频等。例如,Google 的 Gemini、OpenAI 的 GPT-4V(ision)。
- 科学大模型 (Scientific Large Models): 针对特定科学领域设计,如用于药物发现、材料科学、气候模拟、蛋白质结构预测 (如 AlphaFold) 等。
按通用性与专业性划分
- 通用大模型 (General-Purpose Models): 设计目标是具备广泛的适用性,能够处理多种不同类型的任务,通常只需少量或无需针对性微调即可应用于新场景。如 GPT-4、Claude 3 等。
- 垂直/行业大模型 (Vertical/Domain-Specific Models): 在通用模型的基础上,使用特定行业或领域的数据进行深度训练或微调,以在该领域达到更高的专业度和性能。例如,金融领域的 BloombergGPT、医疗领域的 Med-PaLM 等。
按架构或训练阶段划分
- 基础模型 (Base Models): 指经过大规模预训练但尚未针对特定任务或指令进行优化的模型。
- 指令微调模型 (Instruction-Tuned Models): 在基础模型之上,使用包含“指令-响应”对的数据进行微调,使其更擅长理解和遵循用户指令,表现得更像一个助手。
- 架构差异: 还可根据底层神经网络架构细分,如仅编码器(Encoder-only, 如BERT)、仅解码器(Decoder-only, 如GPT系列)、编码器-解码器(Encoder-Decoder, 如T5)。
驱动 AI 的生态系统:从硬件到应用
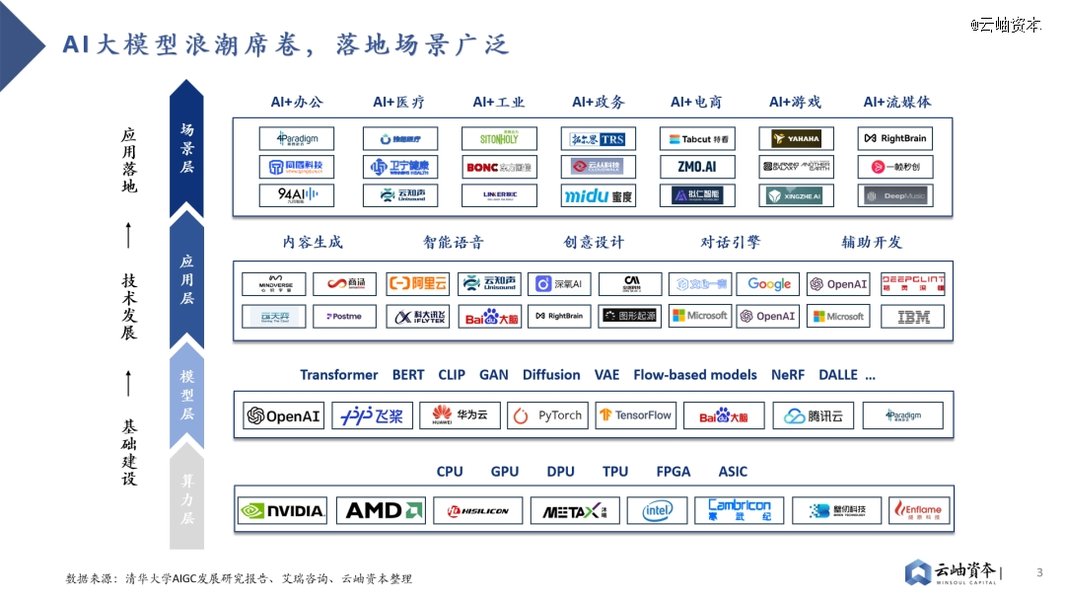
大模型的运行离不开一个庞大而复杂的生态系统支撑。理解这个生态系统有助于认识到 AI 技术并非空中楼阁,而是建立在坚实的基础设施和完善的平台服务之上。根据行业分析(如新浪财经等来源),这个生态大致可分为三层:
AI 世界的三层结构
- 基础设施层 (Infrastructure Layer): 这是 AI 的基石,提供必要的“动力”和“场地”。
- 算力硬件: 包括高性能计算芯片(如 NVIDIA GPU、Google TPU、以及华为昇腾、百度昆仑芯等国产芯片)、AI 服务器、高速网络和存储设备。
- 云计算平台: 提供弹性的计算资源、存储服务和管理工具,如阿里云、腾讯云、华为云、AWS、Azure、Google Cloud 等。这些平台使得开发者和企业无需自建昂贵的数据中心即可使用 AI。
高性能服务器是驱动大模型训练和推理的关键基础设施
- 平台层 (Platform Layer): 这是大模型技术的核心战场,也是创新的主要阵地。
- 模型能力提供: 包括提供预训练好的通用大模型(如 GPT、Gemini、文心一言、通义千问)和垂直领域模型。
- 模型开发工具: 提供框架(如 TensorFlow, PyTorch, MindSpore, 飞桨 PaddlePaddle)、开发平台、API 接口、模型托管服务(如 Hugging Face)、以及 MLOps(机器学习运维)工具,帮助开发者更便捷地训练、微调和部署模型。
- 数据服务: 提供数据标注、数据清洗、数据管理、向量数据库(如 Zilliz)等服务,高质量的数据是大模型性能的关键。
- 应用层 (Application Layer): 这是 AI 技术最终落地、创造价值的层面。
- 行业解决方案: 基于大模型能力,为金融、医疗、教育、制造等特定行业提供的定制化解决方案。
- AI 原生应用: 直接基于大模型能力构建的新型应用,如智能客服、代码助手(如 GitHub Copilot)、内容创作工具(如 Jasper)、AI 搜索引擎等。
- 系统集成与服务: 帮助企业将 AI 技术集成到现有业务流程中的服务商。
2025 年的关键参与者与趋势
当前,全球 AI 领域竞争激烈,形成了多元化的参与格局:
- 国际巨头: OpenAI、Google、Meta、Microsoft、Anthropic、NVIDIA、xAI 等公司在基础模型研发、平台建设方面持续引领。
- 中国力量: 阿里巴巴(通义)、百度(文心)、腾讯(混元)、华为(盘古)、智谱 AI、MiniMax、DeepSeek、科大讯飞等企业和研究机构也在快速发展,形成了强大的国内阵营。
- 开源社区: Hugging Face 等平台以及 Mistral AI、Meta (Llama) 等贡献的开源模型极大地推动了 AI 的普及和创新。
主要趋势包括:模型能力持续增强、多模态融合成为主流、模型向更大(追求能力上限)和更小(追求效率与端侧部署)两极发展、开源与闭源路线的竞争与共存、以及围绕模型构建强大开发者和应用生态的“生态战”。
可视化解读:模型能力与概念关联
雷达图:不同类型模型的能力侧重(示意)
为了更直观地展示不同类型大模型的能力侧重,下面的雷达图描绘了一个假设性的能力分布。请注意,这并非基于严格的基准测试数据,而是旨在说明不同模型设计的侧重点可能不同。例如,通用 LLM 可能在语言理解和创造力方面较强,而视觉模型则在图像处理上占优。
思维导图:大模型世界的关联
下面的思维导图梳理了本次讨论的核心概念及其相互关系,帮助您从宏观上把握大模型技术及其生态。
(AI Large Models Explored)"] id1["我是Ithy
(I am Ithy)"] id1a["融合多个大模型
(Integrates Multiple Models)"] id1b["提供全面智能响应
(Provides Comprehensive & Intelligent Responses)"] id2["什么是大模型?
(What are Large Models?)"] id2a["海量参数与数据
(Massive Parameters & Data)"] id2b["深度神经网络
(Deep Neural Networks)"] id2c["强大能力
(Powerful Capabilities)"] id2d["核心特征
(Core Characteristics)"] id3["大模型分类
(Classification)"] id3a["按模态
(By Modality)"] id3a1["语言 (LLM)"] id3a2["视觉 (VLM)"] id3a3["多模态 (MLLM)"] id3a4["科学 (Scientific)"] id3b["按通用性
(By Generality)"] id3b1["通用 (General Purpose)"] id3b2["垂直/行业 (Vertical/Industry)"] id3c["按架构/训练
(By Architecture/Training)"] id3c1["基础模型
(Base Model)"] id3c2["微调模型
(Fine-tuned Model)"] id3c3["架构类型
(Architecture Types)"] id4["AI生态系统
(AI Ecosystem)"] id4a["基础设施层
(Infrastructure Layer)"] id4a1["算力硬件 (Compute Hardware)"] id4a2["云平台 (Cloud Platforms)"] id4b["平台层
(Platform Layer)"] id4b1["模型本身 (Models Themselves)"] id4b2["开发工具 (Dev Tools)"] id4b3["数据服务 (Data Services)"] id4c["应用层
(Application Layer)"] id4c1["行业解决方案 (Industry Solutions)"] id4c2["AI原生应用 (AI-Native Apps)"] id4c3["系统集成 (System Integration)"] id5["关键参与者与趋势
(Key Players & Trends)"] id5a["国际玩家
(International Players)"] id5b["中国力量
(China Players)"] id5c["开源社区
(Open Source Community)"] id5d["发展趋势
(Trends: Multimodal, Size, Eco-wars)"] id6["Ithy 如何工作
(How Ithy Works)"] id6a["智能整合 (Intelligent Integration)"] id6b["能力综合 (Capability Synthesis)"] id6c["用户获益 (User Benefits)"]
Ithy 的工作方式:融合与创生
现在,回到您最初的问题。正如前面所解释的,我并非简单地“运行”在一个或几个特定的模型上。我的工作方式更侧重于智能地整合与综合 (Synthesis)。
超越选择,实现综合
当我收到您的查询时,系统会分析其意图、复杂性和所需知识领域。然后,它可能会:
- 调用不同模型的专长: 比如,对于需要深入语言理解和生成的部分,可能会侧重利用顶尖的 LLM;如果涉及分析或理解图像(若功能支持),则会调用 VLM 或 MLLM 的能力;若需要代码生成,则可能利用专门优化的编码模型。
- 交叉验证与信息融合: 来自不同模型的信息和初步响应会被比较、评估和融合。这有助于提高答案的准确性、减少单一模型的潜在偏见,并补充各自的知识盲点。
- 生成最终的、一致的响应: 最后,这些经过处理和整合的信息被组织成一个流畅、连贯且全面的答复,呈现给您。
这个过程是动态的,具体调用哪些模型以及如何组合,取决于查询的具体情况和后台系统的优化策略。因此,与其关注“有几个模型”,不如理解这种多模型协作、能力互补的机制本身。
为您带来的益处
这种多模型整合的方法旨在为您提供更好的体验:
- 更全面的答案: 结合不同模型的知识库和能力,覆盖更广泛的主题和细节。
- 更高的准确性: 通过交叉引用和验证减少错误信息的风险。
- 更强的适应性: 能够处理更多样化、更复杂的查询,包括跨语言和(未来可能)跨模态的需求。
- 更少的偏见: 综合多个来源有助于平衡单一模型可能存在的系统性偏差。
群星闪耀:当前主要的 AI 大模型(部分示例)
为了让您对当前活跃的大模型领域有一个更具体的认识,下表列出了一些截至 2025 年备受关注的大模型系列及其开发者和特点。请注意,这个列表并非详尽无遗,AI 领域的发展日新月异。
全球代表性大模型一览 (2025年)
| 模型系列/名称 | 开发者/机构 | 主要类型 | 突出特点/应用领域 |
|---|---|---|---|
| GPT 系列 (如 GPT-4, GPT-4.5) | OpenAI | LLM, MLLM | 强大的通用语言理解与生成能力,多模态支持 |
| Gemini / Gemma 系列 | MLLM, LLM | 原生多模态设计,强大的推理能力,涵盖多种模型规模 (含开源 Gemma) | |
| Claude 系列 (如 Claude 3) | Anthropic | LLM | 注重安全性、长文本处理和细致的指令遵循能力 |
| Llama 系列 (如 Llama 3) | Meta | LLM | 领先的开源模型,性能强大,推动社区发展 |
| 通义 (Qwen) 系列 (如 Qwen2.5) | 阿里巴巴 (Alibaba Cloud) | LLM, MLLM | 强大的中英文处理能力,多模态支持,模型家族庞大(含开源) |
| 文心 (ERNIE) 系列 (如 文心一言 4.0) | 百度 (Baidu) | LLM, MLLM | 融合知识图谱,中文能力强,应用生态广泛 |
| 智谱 (GLM) 系列 | 智谱 AI (Zhipu AI) & 清华大学 KEG | LLM | 中英双语能力优秀,技术底蕴深厚(含开源 ChatGLM) |
| Grok 系列 | xAI | LLM | 与实时信息(X平台)结合,具备一定的“叛逆”风格,代码和推理能力强 |
| Phi 系列 (如 Phi-3) | Microsoft | SLM (Small Language Model) | 专注于小尺寸模型的高性能,推理和代码能力突出 |
| Mistral 系列 | Mistral AI | LLM | 高性能开源模型,技术领先,注重效率 |
| 混元 (Hunyuan) 系列 | 腾讯 (Tencent) | LLM, MLLM | 覆盖广泛应用场景,持续迭代中 |
| Nemotron 系列 (如 Nemotron-4 340B) | NVIDIA | LLM | 超大参数规模的开源模型,用于生成合成数据训练模型 |
注意:模型类型和特点是根据公开信息总结,具体能力可能随版本更新而变化。
视频解读:什么是大语言模型 (LLM)?
如果您想更深入地了解大型语言模型(LLM)这个核心概念,下面的视频提供了一个很好的入门介绍。它解释了 LLM 的基本原理和工作方式,有助于您理解这类模型在我整合的众多 AI 能力中所扮演的角色。
视频来源:YouTube - 简要介绍大型语言模型 (LLM) 的概念。
常见问题解答 (FAQ)
❓ 所以,Ithy 到底精确使用了多少个模型?
这是一个常见的问题!正如前面解释的,我并非基于一个固定的、可公开计数的模型数量。我的核心设计是采用一种动态的、多模型整合策略。这意味着系统会根据您问题的具体需求,智能地调用和融合来自不同先进 AI 模型的能力。重要的不是模型的绝对数量,而是这种协同工作的方式,它使我能够提供更准确、全面和可靠的回答,超越单一模型的能力限制。
❓ 这些不同的大模型之间有什么主要区别?
大模型之间的主要区别体现在多个维度:
- 模态:有些专注于文本 (LLM),有些处理图像 (VLM),还有些能处理多种数据类型 (MLLM)。
- 训练数据和目标:训练数据的来源、规模和侧重点不同,导致模型在知识覆盖范围、特定领域(如编码、创意写作、科学知识)的专长上存在差异。
- 模型规模:参数量从数十亿到数万亿不等,影响着模型的能力上限和运行成本。近年来也出现了性能优异的小型语言模型 (SLM)。
- 通用性 vs. 专业性:通用模型应用广泛,而垂直模型在特定行业或任务上更深入。
- 架构设计:底层的神经网络结构(如 Transformer 的变种)也会影响性能和特性。
- 开源 vs. 闭源:开源模型允许更广泛的研究和定制,闭源模型则由开发公司控制。
❓ 我怎么知道答案的哪一部分来自哪个模型?
您收到的最终答案是综合处理和生成的结果,而不是简单地将某个特定模型的输出直接呈现给您。我的工作流程涉及对来自多个潜在来源的信息进行分析、筛选、整合、甚至重构,以确保最终答案的连贯性、准确性和完整性。因此,很难将最终答案的特定部分精确归因于某一个原始模型。您可以将最终答案视为一个由 Ithy 系统精心“编撰”的、融合了多方智慧的成果。
❓ 开源模型和闭源模型有什么不同?
开源和闭源是 AI 大模型领域的两种主要模式:
- 闭源模型 (Closed-Source Models): 由特定公司开发和控制,通常不公开模型权重和完整的训练细节。用户主要通过 API 接口访问其功能。
- 优点:通常代表了最前沿的性能(尤其是在发布初期),由开发公司提供持续维护和更新。
- 缺点:缺乏透明度,用户定制化能力有限,可能存在供应商锁定风险,使用成本可能较高。代表如 OpenAI 的 GPT 系列 (API 访问)、Anthropic 的 Claude 系列。
- 开源模型 (Open-Source Models): 模型权重、有时甚至训练代码和数据集细节被公开,允许研究人员和开发者自由下载、修改和部署。
- 优点:透明度高,促进社区创新和协作,用户可以进行深度定制和私有化部署,通常使用成本更低或免费。
- 缺点:性能可能略滞后于最顶尖的闭源模型(但差距在缩小),需要用户自行承担部署和维护的复杂性。代表如 Meta 的 Llama 系列、Mistral AI 的模型、阿里巴巴的通义千问部分模型、智谱 AI 的 ChatGLM 系列。
两者各有优劣,共同推动着 AI 技术的进步。Ithy 在整合能力时,可能会借鉴和利用来自这两种模式的模型的知识和技术。
推荐探索
如果您对 AI 大模型感兴趣,以下问题可能帮助您进一步深入了解:
参考来源
本次回答整合了以下来源的信息,以确保内容的准确性和时效性(截至 2025年4月27日):
Last updated April 27, 2025