
Konsep "Scale" di R dan Tujuannya
Memahami Pentingnya Standardisasi Data dalam Analisis Statistik dan Machine Learning
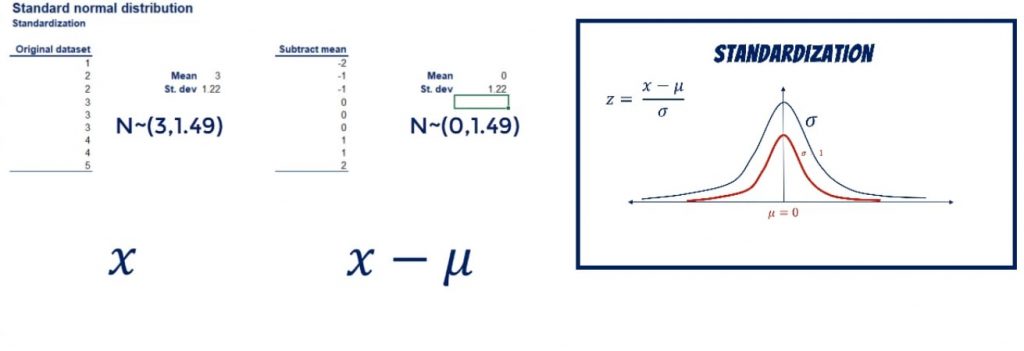
3 Poin Penting tentang Fungsi scale() di R
- Standardisasi dan Normalisasi Data: Mengubah skala data agar memiliki rata-rata 0 dan standar deviasi 1.
- Peningkatan Kinerja Algoritma: Membantu algoritma statistik dan machine learning bekerja lebih efektif dan akurat.
- Mudahnya Interpretasi Data: Memfasilitasi perbandingan antar variabel dengan satuan yang berbeda.
Pendahuluan
Dalam dunia analisis data dan machine learning, kualitas data sangat mempengaruhi hasil yang diperoleh. Salah satu langkah penting dalam pra-pemrosesan data adalah standardisasi atau normalisasi. Di R, fungsi yang digunakan untuk tujuan ini adalah scale(). Artikel ini akan membahas secara mendalam konsep "scale" di R, bagaimana cara kerjanya, tujuan penggunaannya, serta manfaat yang diperoleh dalam berbagai aplikasi analisis data.
Apa Itu Fungsi scale() di R?
Fungsi scale() di R adalah alat yang sangat berguna untuk centering dan scaling data numerik. Fungsi ini memungkinkan peneliti dan praktisi data untuk menyesuaikan skala data agar konsisten dan sesuai dengan kebutuhan analisis. Berikut adalah rincian lebih lanjut:
Centering (Penyesuaian Pusat)
Centering adalah proses mengurangi nilai rata-rata (mean) dari setiap nilai dalam data. Dengan melakukan ini, rata-rata setiap kolom data akan menjadi nol. Centering penting untuk memastikan bahwa data tidak mendominasi analisis hanya karena offset atau posisi awalnya.
Scaling (Penyamaan Skala)
Scaling melibatkan pembagian data dengan simpangan baku (standard deviation) dari masing-masing kolom. Proses ini menyesuaikan data sehingga setiap kolom memiliki variansi sebesar 1. Dengan demikian, data menjadi homogen dalam hal skala, yang sangat penting untuk algoritma yang sensitif terhadap perbedaan skala antar fitur.
Sintaks Dasar Fungsi scale()
scaled_data <- scale(x, center = TRUE, scale = TRUE)
Dimana:
x: Data yang akan dinormalisasi, bisa berupa vektor, matriks, atau data frame numerik.center: Parameter logika atau vektor numerik yang menentukan apakah nilai rata-rata harus dikurangkan dari data. Defaultnya adalahTRUE.scale: Parameter logika atau vektor numerik yang menentukan apakah pembagian dengan simpangan baku akan dilakukan. Defaultnya adalahTRUE.
Tujuan Penggunaan Fungsi scale()
Fungsi scale() digunakan dalam berbagai konteks analisis data untuk mencapai beberapa tujuan penting:
1. Standardisasi Data
Standardisasi adalah proses mengubah data sehingga semua fitur memiliki skala yang sama. Hal ini sangat penting ketika fitur-fitur dalam dataset memiliki unit pengukuran yang berbeda atau rentang nilai yang bervariasi. Dengan standardisasi, tidak ada fitur yang mendominasi proses analisis hanya karena memiliki rentang nilai yang lebih besar.
2. Peningkatan Kinerja Algoritma Statistik dan Machine Learning
Banyak algoritma statistik dan machine learning, seperti Principal Component Analysis (PCA), k-means clustering, dan Support Vector Machines (SVM), bergantung pada jarak atau hubungan antar data. Data yang tidak distandarkan dapat menyebabkan hasil yang bias atau kurang akurat karena fitur dengan skala lebih besar akan mendominasi perhitungan.
3. Mempercepat Proses Konvergensi
Dalam algoritma optimisasi seperti Gradient Descent, standardisasi data dapat membantu mempercepat konvergensi menuju solusi optimal. Data yang distandarkan memungkinkan algoritma untuk bergerak secara lebih efisien menuju minimum global tanpa terjebak pada fluktuasi yang disebabkan oleh skala data yang tidak seragam.
4. Menghindari Masalah Numerik
Data dengan skala yang sangat besar atau sangat kecil dapat menyebabkan masalah numerik dalam perhitungan komputasi, seperti overflow atau underflow. Dengan melakukan scaling, data ditekan ke rentang yang lebih stabil, mengurangi risiko masalah ini terjadi.
5. Kemudahan Interpretasi
Setelah data distandarkan, interpretasi koefisien dalam model statistik menjadi lebih mudah karena setiap fitur berada pada skala yang sama. Ini memudahkan dalam memahami dampak relatif dari masing-masing fitur terhadap variabel target.
Cara Kerja Fungsi scale()
Fungsi scale() bekerja dengan dua langkah utama: centering dan scaling. Berikut adalah penjelasan lebih rinci tentang bagaimana fungsi ini bekerja:
Langkah 1: Centering
Fungsi ini menghitung rata-rata dari setiap kolom data dan kemudian mengurangkan rata-rata tersebut dari setiap nilai dalam kolom tersebut. Rumus matematis untuk centering adalah:
\[ x_{\text{centered}} = x - \mu \]
Dimana μ adalah rata-rata dari kolom tersebut.
Langkah 2: Scaling
Setelah centering, fungsi scale() membagi setiap nilai yang telah di-center dengan simpangan baku dari kolom tersebut. Rumus matematis untuk scaling adalah:
\[ x_{\text{scaled}} = \frac{x_{\text{centered}}}{\sigma} \]
Dimana σ adalah simpangan baku dari kolom tersebut.
Hasil akhirnya adalah dataset yang memiliki rata-rata 0 dan standar deviasi 1 untuk setiap kolom numerik.
Opsi Penggunaan
Fungsi scale() menyediakan fleksibilitas dalam proses scaling dengan dua parameter utama:
-
center: Menentukan apakah data harus di-center. JikaTRUE, rata-rata setiap kolom akan dikurangkan dari data. JikaFALSE, proses centering diabaikan. -
scale: Menentukan apakah data harus discale. JikaTRUE, setiap nilai akan dibagi dengan simpangan baku kolom tersebut. JikaFALSE, proses scaling diabaikan.
Contoh penggunaan dengan parameter yang berbeda:
# Standardisasi penuh (center dan scale)
scaled_full <- scale(data, center = TRUE, scale = TRUE)

# Hanya centering
scaled_center <- scale(data, center = TRUE, scale = FALSE)

# Hanya scaling
scaled_scale <- scale(data, center = FALSE, scale = TRUE)
Contoh Penggunaan Fungsi scale() di R
Untuk lebih memahami bagaimana fungsi scale() bekerja, mari kita lihat beberapa contoh praktis:
Contoh 1: Standardisasi Data Sederhana
Misalkan Anda memiliki dataset sederhana berikut:
# Membuat dataset
data <- data.frame(tinggi = c(150, 160, 170), berat = c(50, 65, 80))

# Menstandardisasi data
scaled_data <- scale(data)

# Menampilkan hasil
print(scaled_data)
Hasilnya akan menunjukkan bahwa setiap nilai dalam kolom tinggi dan berat telah di-center dan discale sehingga rata-rata menjadi 0 dan standar deviasi menjadi 1.
Contoh 2: Menggunakan Dataset mtcars
Dataset mtcars adalah salah satu dataset bawaan di R yang sering digunakan dalam analisis statistik dan machine learning. Berikut adalah cara menggunakan fungsi scale() pada dataset tersebut:
# Memuat dataset mtcars
data <- mtcars

# Melihat beberapa baris pertama sebelum scaling
head(data)

# Melakukan scaling pada data
data_scaled <- scale(data)

# Melihat beberapa baris pertama setelah scaling
head(data_scaled)

# Mengakses atribut mean dan standar deviasi yang digunakan untuk scaling
attr(data_scaled, "scaled:center")
attr(data_scaled, "scaled:scale")
Pada contoh ini, setiap fitur numerik dalam dataset mtcars telah dinormalisasi sehingga memiliki rata-rata 0 dan standar deviasi 1. Selain itu, atribut scaled:center dan scaled:scale menyimpan nilai rata-rata dan simpangan baku yang digunakan dalam proses scaling.
Contoh 3: Scaling dengan Parameter Kustom
Anda dapat menyesuaikan proses scaling dengan nilai rata-rata dan simpangan baku yang berbeda. Berikut adalah contoh bagaimana menskalakan data dengan mean 100 dan standar deviasi 15:
# Menskalakan data dengan mean 100 dan standar deviasi 15
data_scaled_custom <- scale(data, center = apply(data, 2, mean) + 100, scale = apply(data, 2, sd) * 15)

# Menampilkan hasil
print(data_scaled_custom)
Pada contoh ini, nilai rata-rata dan simpangan baku yang digunakan untuk scaling telah diubah sesuai kebutuhan spesifik analisis.
Manfaat dan Keuntungan dari Menggunakan Fungsi scale()
Menggunakan fungsi scale() dalam analisis data menawarkan berbagai manfaat yang signifikan:
1. Konsistensi Skala Data
Dengan menjadikan setiap fitur memiliki skala yang sama, perbandingan antar variabel menjadi lebih adil dan tidak bias. Ini sangat penting ketika fitur-fitur memiliki unit pengukuran yang berbeda, seperti tinggi badan dalam cm dan berat badan dalam kg.
2. Peningkatan Akurasi Model
Banyak algoritma machine learning yang sensitif terhadap skala data, seperti K-Nearest Neighbors (KNN) dan Support Vector Machines (SVM). Dengan data yang distandarkan, algoritma-algoritma ini dapat bekerja lebih efektif, menghasilkan model yang lebih akurat dan generalisasi yang lebih baik.
3. Percepatan Konvergensi Algoritma Optimisasi
Dalam algoritma optimisasi seperti Gradient Descent, standardisasi data dapat mempercepat proses konvergensi menuju solusi optimal. Data yang distandarkan memungkinkan langkah-langkah optimisasi untuk bergerak dengan lebih efisien.
4. Mengurangi Risiko Masalah Numerik
Data dengan skala yang sangat besar atau sangat kecil dapat menyebabkan masalah numerik dalam perhitungan komputasi. Dengan melakukan scaling, risiko overflow atau underflow dapat diminimalisir, menjaga kestabilan dan akurasi perhitungan.
5. Memfasilitasi Interpretasi Model
Setelah data distandarkan, koefisien dalam model statistik menjadi lebih mudah diinterpretasikan. Karena setiap fitur berada pada skala yang sama, dampak relatif dari setiap fitur terhadap variabel target dapat dilihat dengan lebih jelas.
Keterbatasan dan Pertimbangan Penting
Meskipun fungsi scale() sangat berguna, ada beberapa keterbatasan dan pertimbangan yang perlu diperhatikan:
1. Tidak Selalu Diperlukan
Beberapa algoritma yang tidak sensitif terhadap skala data, seperti Decision Trees atau Naive Bayes, tidak membutuhkan data yang distandarkan. Dalam kasus-kasus ini, penggunaan scale() mungkin tidak memberikan manfaat tambahan dan dapat memperlambat proses analisis.
2. Pengaruh pada Interpretasi Data Asli
Setelah data distandarkan, nilai asli dari data tidak lagi terlihat secara langsung. Jika diperlukan interpretasi langsung terhadap skala asli data, maka data yang distandarkan harus dikembalikan ke skala aslinya, yang dapat menambah kompleksitas dalam analisis.
3. Sensitivitas terhadap Outliers
Fungsi scale() menggunakan rata-rata dan simpangan baku, yang dapat dipengaruhi oleh outliers (nilai yang sangat berbeda dari nilai lainnya). Jika data mengandung banyak outliers, maka metode scaling ini mungkin tidak ideal karena outliers dapat mendistorsi hasil scaling.
4. Harus Konsisten saat Menerapkan ke Data Baru
Ketika model yang dilatih menggunakan data yang distandarkan diterapkan pada data baru, proses scaling harus dilakukan dengan menggunakan parameter (mean dan simpangan baku) yang sama yang digunakan pada data pelatihan. Jika tidak, hasil model dapat menjadi bias atau tidak akurat.
Alternatif dan Metode Scaling Lainnya
Meskipun scale() adalah metode yang umum digunakan untuk standardisasi data, ada beberapa metode scaling lain yang dapat digunakan sesuai dengan kebutuhan spesifik analisis:
1. Min-Max Scaling
Min-Max Scaling mengubah data sehingga semua nilai berada dalam rentang 0 hingga 1. Rumusnya adalah:
\[ x_{\text{scaled}} = \frac{x - x_{\text{min}}}{x_{\text{max}} - x_{\text{min}}} \]
Metode ini cocok ketika data memiliki batasan yang jelas dan ingin dipertahankan dalam rentang tertentu.
2. Robust Scaling
Robust Scaling menggunakan median dan interquartile range (IQR) untuk scaling, yang membuatnya lebih tahan terhadap outliers dibandingkan scale() yang menggunakan mean dan simpangan baku.
Rumusnya adalah:
\[ x_{\text{scaled}} = \frac{x - \text{median}}{\text{IQR}} \]
3. Z-Score Normalization
Z-Score Normalization adalah metode yang mirip dengan scale(), di mana data di-center dan discale menggunakan mean dan simpangan baku. Metode ini sering digunakan secara bergantian dengan scale().
Pemilihan metode scaling yang tepat tergantung pada karakteristik data dan tujuan analisis. Seringkali, eksperimen dengan berbagai metode scaling dapat membantu menentukan pendekatan yang paling efektif untuk dataset tertentu.
Implementasi Praktis dalam Machine Learning
Standardisasi data menggunakan fungsi scale() sering kali merupakan langkah kunci dalam pipeline machine learning. Berikut adalah contoh bagaimana scale() dapat diintegrasikan dalam proses pelatihan model:
Langkah 1: Memisahkan Data menjadi Train dan Test
# Memisahkan data menjadi train dan test
set.seed(123)
train_index <- sample(1:nrow(data), 0.7 * nrow(data))
train_data <- data[train_index, ]
test_data <- data[-train_index, ]
Langkah 2: Menstandardisasi Data Train
# Menstandardisasi data train
train_scaled <- scale(train_data)
train_mean <- attr(train_scaled, "scaled:center")
train_sd <- attr(train_scaled, "scaled:scale")
Langkah 3: Menstandardisasi Data Test menggunakan Parameter dari Train
# Menstandardisasi data test menggunakan mean dan sd dari train
test_scaled <- scale(test_data, center = train_mean, scale = train_sd)
Langkah 4: Melatih Model dengan Data yang Telah Distanandar
# Contoh melatih model regresi dengan data yang distandarkan
model <- lm(target ~ ., data = as.data.frame(train_scaled))
summary(model)
Pada contoh ini, penting untuk menstandardisasi data test menggunakan parameter (mean dan simpangan baku) yang sama dengan data train untuk memastikan konsistensi dalam prediksi model.
Kesimpulan
Fungsi scale() di R adalah alat yang esensial untuk standardisasi dan normalisasi data numerik. Dengan mengubah data agar memiliki rata-rata 0 dan standar deviasi 1, fungsi ini tidak hanya memfasilitasi perbandingan antar variabel dengan skala berbeda tetapi juga meningkatkan kinerja dan akurasi algoritma statistik dan machine learning. Meskipun demikian, pengguna harus mempertimbangkan konteks analisis dan karakteristik data sebelum menerapkan scaling, serta memahami keterbatasan dan alternatif metode scaling yang tersedia. Dengan pemahaman yang mendalam tentang fungsi scale() dan aplikasinya, analisis data dapat dilakukan dengan lebih efektif dan hasil yang lebih akurat dapat dicapai.
Referensi
Berikut adalah sumber-sumber yang relevan dan dapat dijadikan rujukan lebih lanjut mengenai fungsi scale() di R:
Last updated January 30, 2025