
Kubernetes 中大数据组件的亲和性配置指南
实现资源优化与高效调度的全面策略
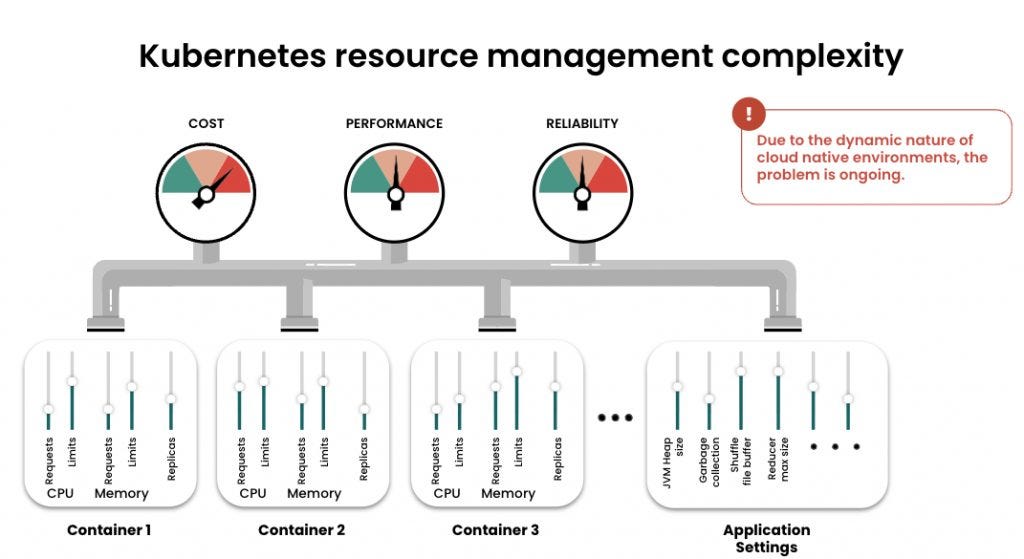
三个关键要点
- 资源标签分类:通过准确的节点标签,区分不同资源特性的节点,为高效调度奠定基础。
- 亲和性与反亲和性配置:合理配置亲和性和反亲和性规则,优化组件部署,避免资源争抢。
- 资源请求与限制设置:精确设置资源请求与限制,确保资源分配合理,提升系统稳定性。
1. 资源标签分类
在 Kubernetes 集群中,为不同资源特性的节点打上相应的标签是设定亲和性规则的第一步。通过明确的标签,调度器能够识别节点的资源能力,从而将合适的 Pod 部署到合适的节点上。
1.1 定义节点标签
为集群中的每个节点添加标签,标识其在 CPU、内存、磁盘 IO、磁盘大小和网络 IO 等方面的特性。例如:
kubectl label nodes <node-name> cpu-performance=high
kubectl label nodes <node-name> memory-size=large
kubectl label nodes <node-name> disk-io=high
kubectl label nodes <node-name> disk-size=ssd
kubectl label nodes <node-name> network-io=high
1.2 标签说明
| 标签键 | 标签值 | 说明 |
|---|---|---|
| cpu-performance | high | 表示节点具备高性能 CPU 资源,适合部署 CPU 密集型应用。 |
| memory-size | large | 表示节点内存容量大,适合部署内存密集型应用。 |
| disk-io | high | 表示节点具备高磁盘 IO 性能,适合需要频繁读写磁盘的应用。 |
| disk-size | ssd | 表示节点使用 SSD 存储,适合需要快速存取数据的应用。 |
| network-io | high | 表示节点具备高网络带宽,适合对网络性能要求高的应用。 |
2. 亲和性与反亲和性配置
通过配置亲和性(Affinity)和反亲和性(Anti-Affinity)规则,可以精准地控制 Pod 的调度逻辑,确保不同资源需求的组件合理分布,避免资源争夺,提高资源利用率。
2.1 节点亲和性(Node Affinity)
节点亲和性用于指定 Pod 应该或倾向于调度到具备特定标签的节点上。对于 Kafka 和 ClickHouse,分别有不同的资源需求,因此需要为它们配置不同的节点亲和性规则。
2.1.1 Kafka 的节点亲和性配置
Kafka 是内存密集型应用,与高内存节点匹配:
affinity:
  nodeAffinity:
    requiredDuringSchedulingIgnoredDuringExecution:
      nodeSelectorTerms:
      - matchExpressions:
        - key: memory-size
          operator: In
          values:
          - large
    preferredDuringSchedulingIgnoredDuringExecution:
    - weight: 80
      preference:
        matchExpressions:
        - key: network-io
          operator: In
          values:
          - high
    - weight: 50
      preference:
        matchExpressions:
        - key: disk-io
          operator: In
          values:
          - high
2.1.2 ClickHouse 的节点亲和性配置
ClickHouse 是 CPU 密集型应用,与高 CPU 性能节点匹配:
affinity:
  nodeAffinity:
    requiredDuringSchedulingIgnoredDuringExecution:
      nodeSelectorTerms:
      - matchExpressions:
        - key: cpu-performance
          operator: In
          values:
          - high
    preferredDuringSchedulingIgnoredDuringExecution:
    - weight: 70
      preference:
        matchExpressions:
        - key: disk-io
          operator: In
          values:
          - high
    - weight: 30
      preference:
        matchExpressions:
        - key: network-io
          operator: In
          values:
          - high
2.2 Pod 反亲和性(Pod Anti-Affinity)
反亲和性用于避免特定类型的 Pod 在同一节点上部署,以防止资源争抢和单点故障。例如,防止 Kafka 和 ClickHouse 部署在同一节点上。
2.2.1 反亲和性配置示例
以下示例展示了如何配置反亲和性规则,确保 Kafka 和 ClickHouse 不部署在同一节点上:
affinity:
  podAntiAffinity:
    requiredDuringSchedulingIgnoredDuringExecution:
    - labelSelector:
        matchExpressions:
        - key: app
          operator: In
          values:
          - clickhouse
      topologyKey: kubernetes.io/hostname
2.3 综合亲和性配置
结合节点亲和性和 Pod 反亲和性,可以实现更为精准的调度策略:
affinity:
  nodeAffinity:
    requiredDuringSchedulingIgnoredDuringExecution:
      nodeSelectorTerms:
      - matchExpressions:
        - key: memory-size
          operator: In
          values:
          - large
    preferredDuringSchedulingIgnoredDuringExecution:
    - weight: 80
      preference:
        matchExpressions:
        - key: network-io
          operator: In
          values:
          - high
    - weight: 50
      preference:
        matchExpressions:
        - key: disk-io
          operator: In
          values:
          - high
  podAntiAffinity:
    requiredDuringSchedulingIgnoredDuringExecution:
    - labelSelector:
        matchExpressions:
        - key: app
          operator: In
          values:
          - clickhouse
      topologyKey: kubernetes.io/hostname
3. 资源请求与限制设置
为了确保资源分配的合理性,必须为每个 Pod 设置明确的资源请求(requests)和资源限制(limits)。这不仅可以避免资源浪费,还能防止某些 Pod 过度消耗资源,影响整个集群的稳定性。
3.1 资源请求与限制的重要性
资源请求用于告诉调度器 Pod 需要的最小资源量,而资源限制则定义了 Pod 能够使用的最大资源量。合理设置这两个参数,可以确保资源的公平分配和高效利用。
3.2 Kafka 的资源配置示例
针对内存密集型的 Kafka,设置较高的内存请求和限制:
resources:
  requests:
    memory: "16Gi"
    cpu: "4"
  limits:
    memory: "32Gi"
    cpu: "8"
3.3 ClickHouse 的资源配置示例
针对 CPU 密集型的 ClickHouse,设置较高的 CPU 请求和限制:
resources:
  requests:
    memory: "8Gi"
    cpu: "8"
  limits:
    memory: "16Gi"
    cpu: "16"
3.4 综合资源配置
结合亲和性规则,确保资源请求与限制的合理性:
spec:
  containers:
    - name: kafka
      image: confluentinc/cp-kafka:latest
      resources:
        requests:
          memory: "16Gi"
          cpu: "4"
        limits:
          memory: "32Gi"
          cpu: "8"
    - name: clickhouse
      image: clickhouse/clickhouse-server:latest
      resources:
        requests:
          memory: "8Gi"
          cpu: "8"
        limits:
          memory: "16Gi"
          cpu: "16"
4. 示例配置
以下是一个完整的 Kubernetes Deployment 配置示例,结合亲和性、反亲和性和资源限制,实现对 Kafka 和 ClickHouse 的高效部署:
apiVersion: apps/v1
kind: Deployment
metadata:
  name: bigdata-deployment
spec:
  replicas: 3
  selector:
    matchLabels:
      app: bigdata-app
  template:
    metadata:
      labels:
        app: bigdata-app
    spec:
      affinity:
        nodeAffinity:
          requiredDuringSchedulingIgnoredDuringExecution:
            nodeSelectorTerms:
            - matchExpressions:
              - key: memory-size
                operator: In
                values:
                - large
            - matchExpressions:
              - key: cpu-performance
                operator: In
                values:
                - high
          preferredDuringSchedulingIgnoredDuringExecution:
          - weight: 80
            preference:
              matchExpressions:
              - key: network-io
                operator: In
                values:
                - high
          - weight: 50
            preference:
              matchExpressions:
              - key: disk-io
                operator: In
                values:
                - high
        podAntiAffinity:
          requiredDuringSchedulingIgnoredDuringExecution:
          - labelSelector:
              matchExpressions:
              - key: app
                operator: In
                values:
                - clickhouse
            topologyKey: kubernetes.io/hostname
      containers:
        - name: kafka
          image: confluentinc/cp-kafka:latest
          resources:
            requests:
              memory: "16Gi"
              cpu: "4"
            limits:
              memory: "32Gi"
              cpu: "8"
        - name: clickhouse
          image: clickhouse/clickhouse-server:latest
          resources:
            requests:
              memory: "8Gi"
              cpu: "8"
            limits:
              memory: "16Gi"
              cpu: "16"
5. 权重分配与优先级
在软亲和性规则中,可以为不同的条件分配不同的权重,以表示其优先级。这有助于调度器在资源有限时,优先满足高权重的条件,优化资源利用。
5.1 权重分配原则
-
高权重:表示更高的优先级,调度器会优先满足这些条件。
-
低权重:表示次优先级,只有在高权重条件无法满足时才会考虑。
5.2 示例权重分配
以下示例展示了如何为不同的节点资源特性分配权重:
affinity:
  nodeAffinity:
    preferredDuringSchedulingIgnoredDuringExecution:
    - weight: 80
      preference:
        matchExpressions:
        - key: memory-size
          operator: In
          values:
          - large
    - weight: 60
      preference:
        matchExpressions:
        - key: cpu-performance
          operator: In
          values:
          - high
    - weight: 40
      preference:
        matchExpressions:
        - key: network-io
          operator: In
          values:
          - high
在此配置中,节点的内存容量被赋予最高权重,其次是 CPU 性能和网络 IO。
6. 资源均衡与优化策略
除了基本的亲和性配置,为了进一步优化资源利用和系统性能,还可以采用以下策略:
6.1 动态资源分配
利用 Kubernetes 的自动伸缩功能,根据应用负载动态调整 Pod 的副本数量,确保资源的动态平衡与高效利用。
6.2 持续监控与优化
通过监控工具(如 Prometheus 和 Grafana)实时监控节点和 Pod 的资源使用情况,及时调整亲和性规则和资源配置,以适应变化的负载需求。
6.3 利用优先级和抢占机制
配置 Pod 的优先级和抢占策略,确保关键应用在资源紧张时能够获得优先调度,提升系统的可靠性和稳定性。
7. 结论
通过合理配置 Kubernetes 的亲和性和反亲和性规则,结合精确的资源请求与限制设置,可以实现大数据组件(如 Kafka 和 ClickHouse)的高效部署和资源利用优化。这不仅能够防止资源争抢和浪费,还能显著提高系统的运行效率和稳定性。持续的监控与优化是确保配置有效性的关键,需根据实际负载不断调整策略,以适应业务需求的变化。
参考资料
Last updated January 23, 2025