
ไขความลับ LaBSE: โมเดลภาษาอัจฉริยะที่เข้าใจทุกภาษา พร้อมเจาะลึกกระบวนการฝึกฝน
สำรวจ LaBSE โมเดลการฝังประโยคที่ไม่ยึดติดกับภาษา (Language-Agnostic) ที่ปฏิวัติการประมวลผลภาษาธรรมชาติข้ามพรมแดน
ประเด็นสำคัญที่คุณจะได้รับ
- ความสามารถรอบด้าน: LaBSE (Language-Agnostic BERT Sentence Embedding) คือโมเดลที่สร้าง "sentence embeddings" หรือการแทนค่าประโยคด้วยเวกเตอร์ตัวเลข ทำให้คอมพิวเตอร์เข้าใจและเปรียบเทียบความหมายของประโยคจาก 109 ภาษาทั่วโลกได้ โดยใช้โมเดลเพียงตัวเดียว
- เทคนิคการฝึกฝนขั้นสูง: LaBSE ได้รับการฝึกฝนด้วยข้อมูลมหาศาล (กว่า 17 พันล้านประโยคเดี่ยวภาษา และ 6 พันล้านคู่ประโยคแปล) ผสานเทคนิค Masked Language Modeling (MLM) และ Translation Language Modeling (TLM) เพื่อให้เข้าใจทั้งบริบทภายในภาษาและความสัมพันธ์ข้ามภาษา
- ประสิทธิภาพที่เหนือกว่า: โมเดลนี้มีความโดดเด่นในงาน "bi-text retrieval" หรือการค้นหาข้อความคู่ขนาน (เช่น การหาประโยคแปลที่ตรงกัน) และงานประมวลผลภาษาธรรมชาติข้ามภาษาอื่น ๆ อีกมากมาย
ในยุคที่ข้อมูลไร้พรมแดนและความต้องการในการสื่อสารข้ามวัฒนธรรมเพิ่มสูงขึ้น เทคโนโลยีปัญญาประดิษฐ์ (AI) ที่สามารถเข้าใจและประมวลผลได้หลายภาษากลายเป็นสิ่งจำเป็นอย่างยิ่ง LaBSE (Language-Agnostic BERT Sentence Embedding) คือหนึ่งในโมเดลภาษาที่ตอบโจทย์ความท้าทายนี้ได้อย่างน่าทึ่ง บทความนี้จะพาคุณไปทำความเข้าใจว่า LaBSE คืออะไร มีกระบวนการทำงานอย่างไร และผ่านการฝึกฝนด้วยวิธีการใดบ้าง
LaBSE คืออะไร? นิยามและความสามารถอันโดดเด่น
นิยามและความสำคัญของ LaBSE
LaBSE เป็นโมเดลการฝังประโยค (sentence embedding model) แบบหลายภาษา (multilingual) ที่พัฒนาโดยทีมวิจัยของ Google โดยมีพื้นฐานมาจากสถาปัตยกรรม BERT (Bidirectional Encoder Representations from Transformers) อันทรงพลัง จุดเด่นสำคัญของ LaBSE คือความสามารถในการ "ไม่ยึดติดกับภาษา" (language-agnostic) ซึ่งหมายความว่ามันสามารถประมวลผลและทำความเข้าใจประโยคจากภาษาต่าง ๆ มากถึง 109 ภาษา และสร้างการแทนค่า (embedding) ให้อยู่ในพื้นที่เวกเตอร์ร่วมกัน (shared vector space)
ลองจินตนาการว่าประโยค "สวัสดีชาวโลก" ในภาษาไทย และ "Hello, world!" ในภาษาอังกฤษ แม้จะเขียนต่างกัน แต่มีความหมายเหมือนกัน LaBSE จะสร้างเวกเตอร์ตัวเลขที่คล้ายคลึงกันมากสำหรับสองประโยคนี้ ทำให้สามารถเปรียบเทียบความหมายข้ามภาษาได้โดยตรง นี่คือหัวใจสำคัญที่ทำให้ LaBSE มีประโยชน์อย่างยิ่งในงานที่เกี่ยวข้องกับหลายภาษา
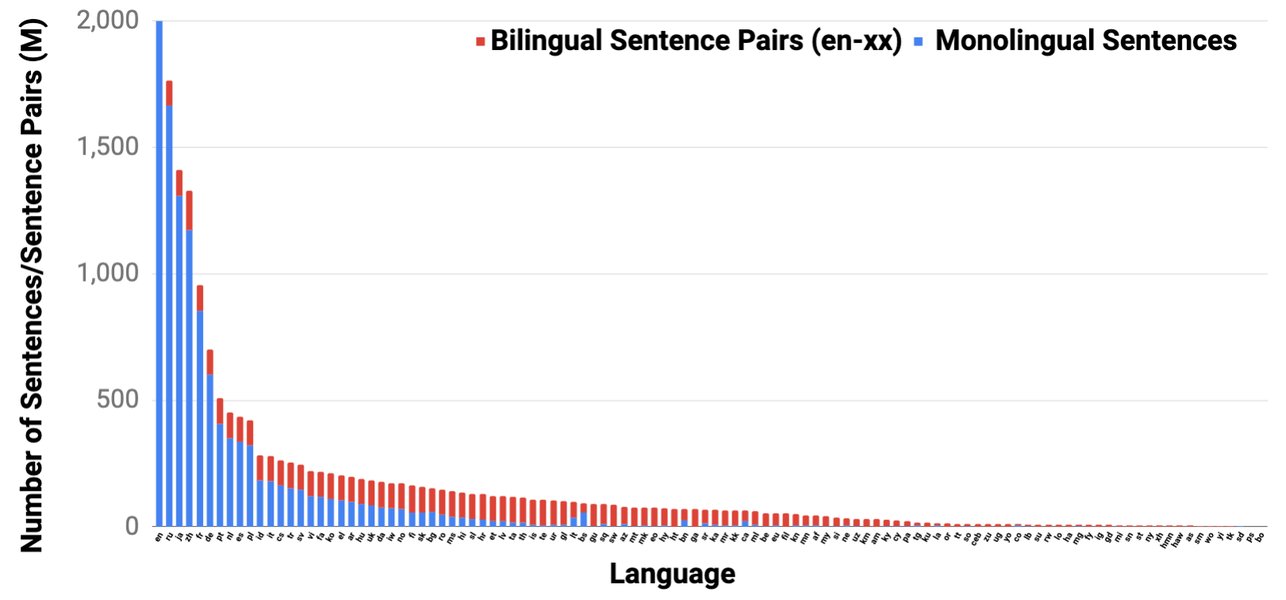
ภาพแสดงแนวคิดของ LaBSE ในการสร้าง sentence embeddings ที่เป็นกลางทางภาษา
สถาปัตยกรรมพื้นฐานและเป้าหมายหลัก
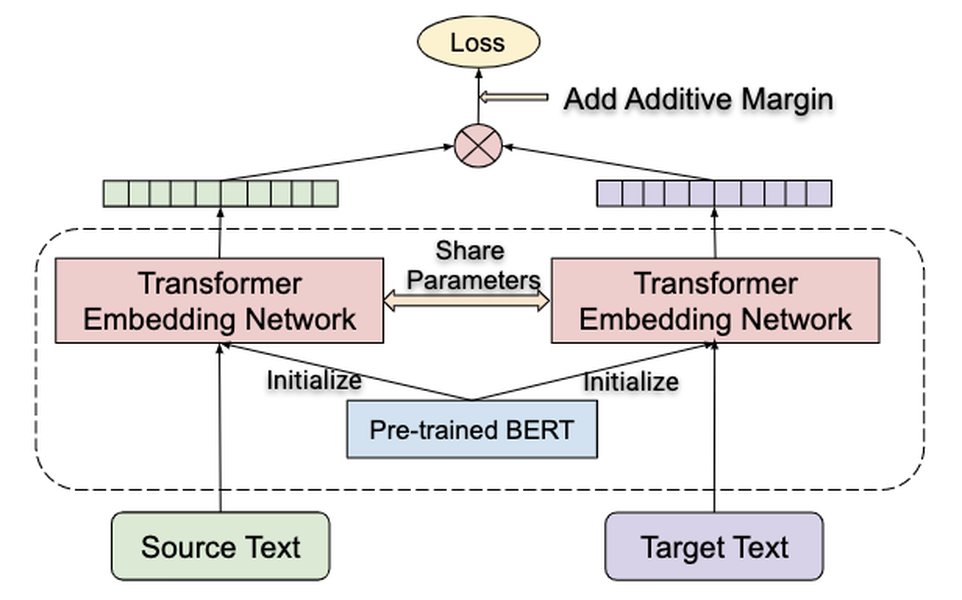
LaBSE ใช้สถาปัตยกรรมแบบ Transformer ซึ่งเป็นหัวใจของโมเดล BERT โดยเฉพาะอย่างยิ่งสถาปัตยกรรมแบบ dual-encoder ซึ่งหมายความว่ามีตัวเข้ารหัส (encoder) สองตัวที่ทำงานร่วมกันเพื่อประมวลผลและเปรียบเทียบข้อมูลจากสองแหล่ง (เช่น ประโยคในสองภาษาที่แตกต่างกัน)
เป้าหมายหลักของ LaBSE คือการสร้าง sentence embeddings ที่มีคุณภาพสูงสำหรับทุกภาษาที่รองรับ โดย embeddings เหล่านี้คือเวกเตอร์ตัวเลข (โดยทั่วไปมี 768 มิติสำหรับ LaBSE) ที่จับสาระสำคัญและความหมายของประโยคไว้ การที่ embeddings จากภาษาต่าง ๆ อยู่ใน "พื้นที่เวกเตอร์ร่วม" เดียวกัน ทำให้สามารถคำนวณความคล้ายคลึง (similarity) ระหว่างประโยคต่างภาษาได้โดยใช้การวัดระยะทางทางคณิตศาสตร์ (เช่น L2-norm หรือ cosine similarity)
โมเดลนี้ใช้ WordPiece tokenizer ในการแบ่งประโยคออกเป็นหน่วยย่อย (tokens) ก่อนป้อนเข้าสู่โมเดล ซึ่งเป็นวิธีที่มีประสิทธิภาพในการจัดการกับคำศัพท์ที่หลากหลายและโครงสร้างคำที่แตกต่างกันในแต่ละภาษา
กระบวนการทำงานของ LaBSE: จากข้อความสู่ความเข้าใจข้ามภาษา
กระบวนการทำงานของ LaBSE สามารถสรุปได้เป็นขั้นตอนหลัก ๆ ดังนี้:
1. การประมวลผลข้อมูลนำเข้า (Input Processing)
เมื่อมีประโยคป้อนเข้ามา ไม่ว่าจะเป็นภาษาใดใน 109 ภาษาที่รองรับ ขั้นตอนแรกคือการ Tokenization ประโยคดังกล่าวจะถูกแบ่งออกเป็นหน่วยย่อย (tokens) โดยใช้ WordPiece tokenizer นอกจากนี้ จะมีการเพิ่ม tokens พิเศษเข้าไป เช่น [CLS] ที่จุดเริ่มต้นของประโยคเพื่อใช้เป็นตัวแทนของทั้งประโยค และ [SEP] เพื่อคั่นระหว่างส่วนต่าง ๆ (หากมี)
2. การสร้าง Embeddings
ลำดับของ tokens ที่ได้จะถูกป้อนเข้าสู่สถาปัตยกรรม Transformer ของ LaBSE ซึ่งประกอบด้วยหลายชั้น (layer) ของ self-attention mechanisms และ feed-forward neural networks ข้อมูลจะไหลผ่านชั้นเหล่านี้ ทำให้โมเดลสามารถเรียนรู้บริบทและความสัมพันธ์ระหว่าง tokens ต่าง ๆ ในประโยค
ผลลัพธ์สุดท้ายที่ได้จากโมเดล (โดยทั่วไปคือสถานะของ token [CLS] จากชั้นสุดท้าย หรือผ่าน pooler output) คือ sentence embedding ซึ่งเป็นเวกเตอร์ตัวเลขขนาด 768 มิติ ที่แทนความหมายของประโยคต้นฉบับ
3. การนำ Embeddings ไปใช้งาน
เมื่อได้ sentence embeddings มาแล้ว ก็สามารถนำไปประยุกต์ใช้ในงานต่าง ๆ ได้หลากหลาย เช่น:
- การค้นหาความคล้ายคลึงของประโยค (Semantic Similarity Search): เปรียบเทียบ embeddings ของประโยคต่าง ๆ เพื่อหาคู่ที่มีความหมายใกล้เคียงกัน แม้จะมาจากคนละภาษาก็ตาม
- การค้นคืนข้อความสองภาษา (Bi-text Retrieval): ค้นหาประโยคแปลที่ตรงกันที่สุดจากชุดข้อมูลขนาดใหญ่
- การจัดกลุ่มข้อความ (Text Clustering): จัดกลุ่มเอกสารหรือประโยคที่มีเนื้อหาคล้ายกัน โดยไม่จำกัดภาษา
- การจำแนกประเภทข้อความ (Text Classification): ฝึกโมเดลเพิ่มเติม (fine-tuning) เพื่อจำแนกข้อความตามหมวดหมู่ที่กำหนด เช่น การวิเคราะห์ความรู้สึก (sentiment analysis) ข้ามภาษา
ความคล้ายคลึงระหว่าง embeddings สองชุดมักคำนวณโดยใช้ L2-norm (Euclidean distance) หรือ Cosine Similarity ยิ่งค่าความคล้ายคลึงสูง (หรือระยะทางน้อย) แสดงว่าประโยคทั้งสองมีความหมายใกล้เคียงกันมาก
เจาะลึกวิธีการฝึกฝน (Training) LaBSE: สร้างความเข้าใจหลายภาษา
เบื้องหลังความสามารถอันน่าทึ่งของ LaBSE คือกระบวนการฝึกฝนที่ซับซ้อนและใช้ข้อมูลจำนวนมหาศาล เพื่อให้โมเดลสามารถเรียนรู้และเข้าใจความแตกต่างและความเชื่อมโยงของภาษาต่าง ๆ ได้อย่างลึกซึ้ง
หัวใจสำคัญ: ข้อมูลที่ใช้ในการฝึก (Training Data)
ปริมาณและประเภทข้อมูล
LaBSE ถูกฝึกฝนบนชุดข้อมูลขนาดมหึมา ซึ่งประกอบด้วย:
- ข้อมูลเดี่ยวภาษา (Monolingual Data): ประมาณ 17 พันล้านประโยค จากภาษาต่าง ๆ ซึ่งส่วนใหญ่มาจากชุดข้อมูล CommonCrawl ข้อมูลส่วนนี้ช่วยให้โมเดลเรียนรู้โครงสร้างและบริบทของแต่ละภาษาได้อย่างกว้างขวาง
- ข้อมูลคู่ภาษา (Bilingual Data) / ข้อมูลแปล (Parallel Data): ประมาณ 6 พันล้านคู่ประโยค ที่เป็นประโยคเดียวกันแต่คนละภาษา (เช่น ประโยคภาษาอังกฤษและคำแปลภาษาญี่ปุ่น) ข้อมูลส่วนนี้มีความสำคัญอย่างยิ่งในการสอนให้โมเดลเชื่อมโยงความหมายข้ามภาษา
เทคนิคการฝึกฝนหลัก (Key Training Techniques)
LaBSE ผสานเทคนิคการฝึกฝนหลักสองประการที่ได้รับการพิสูจน์แล้วว่ามีประสิทธิภาพสูงสำหรับโมเดลภาษา:
1. Masked Language Modeling (MLM)
เทคนิคนี้เป็นมาตรฐานในการฝึกฝนโมเดลตระกูล BERT โดยในระหว่างการฝึก โมเดลจะได้รับประโยคที่คำบางคำถูก "ปิดบัง" (masked) หรือแทนที่ด้วย token พิเศษ (เช่น [MASK]) หน้าที่ของโมเดลคือการทำนายว่าคำที่ถูกปิดบังนั้นคือคำอะไร โดยอาศัยบริบทของคำอื่น ๆ ในประโยค MLM ช่วยให้โมเดลเรียนรู้ความสัมพันธ์ทางไวยากรณ์และความหมายของคำในระดับลึกภายในแต่ละภาษา
2. Translation Language Modeling (TLM)
TLM เป็นเทคนิคที่ออกแบบมาโดยเฉพาะสำหรับการเรียนรู้ข้ามภาษา ในการฝึกแบบ TLM โมเดลจะได้รับคู่ประโยคที่แปลถึงกัน (เช่น ประโยคภาษาอังกฤษคู่กับประโยคภาษาฝรั่งเศสที่มีความหมายเดียวกัน) บางส่วนของ tokens ในทั้งสองประโยคอาจถูกปิดบัง และโมเดลจะต้องทำนาย tokens ที่ถูกปิดบังเหล่านั้นโดยอาศัยบริบทจากทั้งสองภาษาพร้อมกัน เทคนิคนี้บังคับให้โมเดルเรียนรู้การจัดเรียง (align) ความหมายระหว่างภาษาต่าง ๆ และสร้าง embeddings ที่คล้ายกันสำหรับประโยคที่มีความหมายเดียวกันแม้จะอยู่คนละภาษาก็ตาม
3. Translation Ranking Task
นอกเหนือจาก MLM และ TLM แล้ว LaBSE ยังได้รับการฝึกฝนด้วย Translation Ranking Task โดยใช้สถาปัตยกรรม dual-encoder ในงานนี้ โมเดลจะเรียนรู้ที่จะให้คะแนนความคล้ายคลึงระหว่างคู่ประโยคแปล โดยมีเป้าหมายเพื่อให้ embedding ของประโยคที่เป็นคู่แปลกัน (positive pairs) อยู่ใกล้กันในพื้นที่เวกเตอร์ และ embedding ของประโยคที่ไม่เกี่ยวข้อง (negative pairs) อยู่ห่างกัน ซึ่งมักจะใช้ Loss Function เช่น Additive Margin Softmax เพื่อปรับปรุงความแม่นยำในการดึงข้อความคู่ขนาน (bi-text retrieval)
สถาปัตยกรรมและกระบวนการฝึกฝนขั้นสูง
Dual-Encoder Architecture
LaBSE ใช้สถาปัตยกรรมแบบ dual-encoder ซึ่งหมายความว่ามีตัวเข้ารหัส (encoder) สองตัวที่ทำงานขนานกัน แต่แบ่งปันพารามิเตอร์ (weights) ร่วมกัน สถาปัตยกรรมนี้เหมาะอย่างยิ่งสำหรับงานที่ต้องเปรียบเทียบข้อมูลสองชุด เช่น การเปรียบเทียบประโยคจากสองภาษาที่แตกต่างกัน
Progressive Stacking
มีการระบุว่า LaBSE ถูกฝึกฝนโดยใช้เทคนิค Progressive Stacking ซึ่งเป็นกระบวนการฝึกฝนแบบเป็นขั้นตอน โดยโมเดลอาจถูกฝึกในหลายระยะ แต่ละระยะมีการตั้งค่าหรือข้อมูลที่แตกต่างกันเล็กน้อย เพื่อค่อย ๆ เพิ่มความซับซ้อนและความสามารถของโมเดล ตัวอย่างเช่น การฝึก 3 ระยะ โดยเพิ่มจำนวนขั้นตอนการเรียนรู้ในแต่ละระยะ (เช่น 400,000 ขั้นตอน, 800,000 ขั้นตอน, และ 1.8 ล้านขั้นตอน ตามลำดับ)
Optimizer และการตั้งค่า
ในระหว่างการฝึกฝน มีการใช้ Optimizer เช่น AdamW ซึ่งเป็นที่นิยมสำหรับโมเดล Transformer นอกจากนี้ยังมีการตั้งค่าพารามิเตอร์อื่น ๆ เช่น ขนาด batch (batch size) ที่ค่อนข้างใหญ่ (เช่น 2048) เพื่อให้การเรียนรู้มีเสถียรภาพและประสิทธิภาพ และความยาวลำดับสูงสุด (max sequence length) ของประโยค (เช่น 64 tokens) สำหรับทั้งประโยคต้นทางและปลายทาง
วิดีโออธิบายภาพรวมของ LaBSE: Language-agnostic BERT Sentence Embedding จาก Google Research
วิดีโอนี้จาก Google Research ให้ภาพรวมเกี่ยวกับแนวคิดเบื้องหลัง LaBSE และความสามารถในการสร้าง sentence embeddings ที่ไม่ขึ้นกับภาษา ซึ่งช่วยให้เข้าใจถึงความสำคัญและศักยภาพของโมเดลนี้ในการจัดการกับความท้าทายด้านภาษาในระดับโลก
สำรวจศักยภาพของ LaBSE ผ่านภาพและข้อมูล
แผนผังความคิด: องค์ประกอบหลักของ LaBSE
เพื่อให้เห็นภาพรวมของ LaBSE ได้ชัดเจนยิ่งขึ้น แผนผังความคิดด้านล่างนี้สรุปองค์ประกอบหลัก ตั้งแต่คำจำกัดความ สถาปัตยกรรม กระบวนการฝึกฝน ไปจนถึงการนำไปใช้งานและประโยชน์ที่ได้รับ:
แผนผังนี้ช่วยให้เห็นความเชื่อมโยงของส่วนประกอบต่าง ๆ ที่ทำให้ LaBSE เป็นเครื่องมือที่ทรงพลังสำหรับการประมวลผลภาษาธรรมชาติแบบหลายภาษา
ตารางสรุปคุณสมบัติหลักของ LaBSE
ตารางด้านล่างนี้สรุปคุณสมบัติที่สำคัญของโมเดล LaBSE เพื่อให้เห็นภาพรวมอย่างรวดเร็ว:
| คุณสมบัติ | รายละเอียด |
|---|---|
| ชื่อเต็ม | Language-Agnostic BERT Sentence Embedding |
| ผู้พัฒนา | Google Research |
| สถาปัตยกรรมพื้นฐาน | BERT (Bidirectional Encoder Representations from Transformers), Dual-Encoder |
| จำนวนภาษาที่รองรับ | 109 ภาษา |
| เอาต์พุตหลัก | Sentence Embeddings (เวกเตอร์ 768 มิติ) |
| เทคนิคการฝึกฝนหลัก | Masked Language Modeling (MLM), Translation Language Modeling (TLM), Translation Ranking Task |
| ข้อมูลที่ใช้ฝึก | 17 พันล้านประโยคเดี่ยวภาษา, 6 พันล้านคู่ประโยคแปล |
| Tokenizer | WordPiece |
| การใช้งานหลัก | Bi-text retrieval, semantic similarity, cross-lingual NLP tasks |
| ความพร้อมใช้งาน | TensorFlow Hub, Hugging Face (Sentence Transformers) |
ตารางนี้เน้นย้ำถึงความซับซ้อนและขนาดของโครงการ LaBSE รวมถึงความสามารถที่หลากหลายของมัน
การประเมินศักยภาพของ LaBSE ในมิติต่างๆ
แผนภูมิเรดาร์ด้านล่างแสดงการประเมินเชิงคุณภาพเกี่ยวกับจุดแข็งของ LaBSE ในมิติต่างๆ เมื่อเทียบกับแนวคิดของ "โมเดลทั่วไป" (ซึ่งอาจหมายถึงโมเดลที่ไม่ได้ถูกออกแบบมาสำหรับหลายภาษาโดยเฉพาะ หรือโมเดลรุ่นเก่ากว่า) ค่าที่สูงกว่าบ่งบอกถึงประสิทธิภาพหรือความสามารถที่ดีกว่าในมิตินั้นๆ
แผนภูมินี้เน้นให้เห็นว่า LaBSE มีความโดดเด่นอย่างมากในด้านการรองรับหลายภาษา ปริมาณข้อมูลที่ใช้ฝึกฝน และความแม่นยำในงานเฉพาะทางอย่าง bi-text retrieval แม้ว่าความซับซ้อนของสถาปัตยกรรมอาจสูง แต่ความพร้อมใช้งานผ่านไลบรารีต่าง ๆ เช่น Hugging Face Sentence Transformers ก็ช่วยให้การนำไปใช้ง่ายขึ้นมาก
ประโยชน์และการประยุกต์ใช้ LaBSE ในโลกแห่งความเป็นจริง
จุดเด่นที่สำคัญของ LaBSE
- การทำงานหลายภาษาในโมเดลเดียว: ไม่จำเป็นต้องมีโมเดลแยกสำหรับแต่ละภาษา ช่วยลดความซับซ้อนในการพัฒนาและบำรุงรักษาระบบ
- ประสิทธิภาพสูงในงานข้ามภาษา: LaBSE แสดงให้เห็นถึงประสิทธิภาพที่ล้ำสมัย (State-of-the-Art - SOTA) ในหลาย ๆ งาน โดยเฉพาะอย่างยิ่ง bi-text retrieval ซึ่งมีการรายงานความแม่นยำเฉลี่ยสูงถึง 83.7% ในการทดสอบกับ 112 ภาษา
- รองรับภาษาทรัพยากรน้อย (Low-resource languages): เนื่องจากได้รับการฝึกฝนบนข้อมูลจำนวนมากและหลากหลายภาษา LaBSE จึงสามารถทำงานได้ดีพอสมควรแม้กับภาษาที่มีข้อมูลฝึกฝนจำกัด
- ความยืดหยุ่นในการใช้งาน: สามารถนำไปใช้ได้ทันที (zero-shot) สำหรับงานเปรียบเทียบความหมาย หรือนำไป fine-tune เพิ่มเติมสำหรับงานเฉพาะทางเพื่อให้ได้ประสิทธิภาพที่ดียิ่งขึ้นในโดเมนนั้น ๆ
- ความพร้อมใช้งาน: สามารถเข้าถึงและใช้งาน LaBSE ได้ง่ายผ่านแพลตฟอร์มยอดนิยมอย่าง TensorFlow Hub และ Hugging Face ทำให้ง่ายต่อการนำไปรวมเข้ากับโปรเจกต์ต่าง ๆ
แผนภาพเปรียบเทียบประสิทธิภาพของ LaBSE (เส้นสีน้ำเงิน) กับโมเดลอื่น ๆ ในงาน Bi-text Retrieval ในภาษาต่าง ๆ จากบล็อกของ Google Research
ตัวอย่างการนำไปใช้งาน
LaBSE ถูกนำไปประยุกต์ใช้อย่างกว้างขวางในหลากหลายสถานการณ์:
- การค้นหาข้อมูลหลายภาษา (Multilingual Information Retrieval): ช่วยให้ผู้ใช้สามารถค้นหาข้อมูลในภาษาหนึ่งและได้รับผลลัพธ์ที่เกี่ยวข้องในภาษาอื่น ๆ
- การทำเหมืองข้อความสองภาษา (Bi-text Mining): สกัดคู่ประโยคแปลจากเอกสารขนาดใหญ่ที่ไม่ได้รับการจัดเรียง (non-parallel corpora)
- การปรับปรุงระบบแปลภาษา: ใช้เป็นส่วนหนึ่งในการประเมินคุณภาพการแปล หรือช่วยในการเลือกประโยคตัวอย่างที่ดีที่สุดสำหรับการฝึกโมเดลแปลภาษา
- การวิเคราะห์ความคิดเห็นข้ามภาษา (Cross-lingual Sentiment Analysis): วิเคราะห์ความคิดเห็นหรือความรู้สึกที่แสดงออกในข้อความจากภาษาต่าง ๆ โดยใช้โมเดลพื้นฐานร่วมกัน
- การสร้าง Chatbot หลายภาษา: พัฒนา Chatbot ที่สามารถโต้ตอบกับผู้ใช้ได้ในหลายภาษาอย่างมีประสิทธิภาพ
คำถามที่พบบ่อย (FAQ)
LaBSE แตกต่างจาก BERT ทั่วไปอย่างไร? ▼
BERT ทั่วไปมักถูกฝึกฝนสำหรับภาษาเดียว (monolingual) หรือสำหรับงานที่เน้นความเข้าใจภายในภาษาเดียว ในขณะที่ LaBSE ถูกออกแบบและฝึกฝนมาโดยเฉพาะเพื่อสร้าง sentence embeddings ที่เป็นกลางทางภาษา (language-agnostic) และทำงานได้ดีในงานที่ต้องการเปรียบเทียบความหมายข้ามหลายภาษา (109 ภาษา) โดยใช้เทคนิคการฝึกฝนเพิ่มเติมเช่น Translation Language Modeling (TLM) และ Translation Ranking Task บนข้อมูลคู่ภาษาจำนวนมหาศาล
LaBSE สามารถนำไปใช้งานด้านใดได้บ้าง? ▼
LaBSE มีประโยชน์อย่างมากในงานที่ต้องจัดการกับข้อมูลหลายภาษา เช่น การค้นหาข้อความคู่ขนาน (bi-text retrieval) ซึ่งเป็นการค้นหาประโยคที่มีความหมายเดียวกันในภาษาต่าง ๆ, การค้นหาความหมายของประโยค (semantic search) ข้ามภาษา, การจัดกลุ่มข้อความ (text clustering) จากแหล่งข้อมูลหลายภาษา, และเป็นพื้นฐานสำหรับการพัฒนาระบบแปลภาษา หรือการวิเคราะห์ข้อมูลภาษาโดยรวม นอกจากนี้ยังสามารถนำไป fine-tune สำหรับงานจำแนกประเภทข้อความข้ามภาษาได้อีกด้วย
การ fine-tune LaBSE จำเป็นหรือไม่? ▼
LaBSE สามารถนำไปใช้งานได้ทันที (zero-shot) สำหรับงานทั่วไปที่เกี่ยวข้องกับการเปรียบเทียบความคล้ายคลึงของความหมายประโยคข้ามภาษา และให้ผลลัพธ์ที่ดีในระดับหนึ่ง อย่างไรก็ตาม หากต้องการประสิทธิภาพสูงสุดสำหรับงานเฉพาะทาง (เช่น การจำแนกความรู้สึกในโดเมนเฉพาะ หรือการค้นหาข้อมูลในหัวข้อที่เฉพาะเจาะจงมาก ๆ) การ fine-tune โมเดล LaBSE ด้วยชุดข้อมูลที่เกี่ยวข้องกับงานนั้น ๆ มักจะช่วยเพิ่มประสิทธิภาพได้อย่างมีนัยสำคัญ
LaBSE รองรับภาษาไทยได้ดีแค่ไหน? ▼
LaBSE รองรับภาษาไทยเป็นหนึ่งใน 109 ภาษา เนื่องจากภาษาไทยรวมอยู่ในชุดข้อมูลขนาดใหญ่ที่ใช้ในการฝึกฝน ทำให้ LaBSE สามารถสร้าง sentence embeddings สำหรับภาษาไทยและเปรียบเทียบกับภาษาอื่น ๆ ได้ อย่างไรก็ตาม ประสิทธิภาพสำหรับภาษาไทยอาจขึ้นอยู่กับปริมาณและคุณภาพของข้อมูลภาษาไทยที่ใช้ในการฝึกฝนเริ่มต้น และความซับซ้อนของงานที่นำไปใช้ สำหรับงานที่ต้องการความแม่นยำสูงมากในภาษาไทย การ fine-tune ด้วยข้อมูลภาษาไทยเฉพาะทางอาจช่วยปรับปรุงผลลัพธ์ได้ดียิ่งขึ้น
คำแนะนำสำหรับการค้นคว้าเพิ่มเติม
- การเปรียบเทียบประสิทธิภาพระหว่าง LaBSE กับโมเดล multilingual embedding อื่นๆ เช่น LASER หรือ mUSE เป็นอย่างไร?
- ขั้นตอนการ fine-tune โมเดล LaBSE สำหรับงาน sentiment analysis ภาษาไทยมีอะไรบ้าง?
- ความท้าทายและข้อจำกัดของ LaBSE ในการประมวลผลภาษาที่มีโครงสร้างซับซ้อน หรือภาษาถิ่นคืออะไร?
- กรณีศึกษาการนำ LaBSE ไปประยุกต์ใช้ในภาคธุรกิจหรืออุตสาหกรรมมีอะไรบ้างที่น่าสนใจ?
แหล่งอ้างอิง
Last updated May 14, 2025