
ไขปริศนา LaBSE: โมเดลฝังประโยคหลายภาษาอัจฉริยะและการรองรับภาษาไทย
เจาะลึก LaBSE ตั้งแต่สถาปัตยกรรม วิธีการฝึกฝน จนถึงการประยุกต์ใช้กับชุดข้อมูลภาษาไทย
LaBSE (Language-agnostic BERT Sentence Embedding) คือโมเดลการเรียนรู้ของเครื่องที่ปฏิวัติวงการประมวลผลภาษาธรรมชาติ (NLP) โดยเฉพาะอย่างยิ่งในด้านการจัดการกับหลายภาษา โมเดลนี้พัฒนาโดยทีมวิจัยของ Google AI มีความสามารถในการแปลงประโยคจากภาษาต่างๆ มากกว่า 109 ภาษา รวมถึงภาษาไทย ให้กลายเป็น "เวกเตอร์ฝัง" (sentence embeddings) ที่มีความหมายเชิงลึกและสามารถเปรียบเทียบกันได้ในปริภูมิเวกเตอร์ร่วม (shared vector space) สิ่งนี้หมายความว่าประโยคที่มีความหมายเหมือนหรือคล้ายกัน แม้จะอยู่คนละภาษา ก็จะมีเวกเตอร์ที่อยู่ใกล้กันในปริภูมินี้ ทำให้ LaBSE เป็นเครื่องมืออันทรงพลังสำหรับงาน NLP ที่ต้องการความเข้าใจเนื้อหาข้ามภาษา
ประเด็นสำคัญที่คุณควรรู้เกี่ยวกับ LaBSE
- ความเป็นกลางทางภาษา (Language-Agnostic): LaBSE สร้างการฝังประโยคที่ไม่ขึ้นกับภาษาใดภาษาหนึ่ง ทำให้สามารถเปรียบเทียบความหมายประโยคข้ามภาษาได้อย่างมีประสิทธิภาพ
- รองรับหลายภาษา รวมถึงภาษาไทย: โมเดลนี้ถูกฝึกฝนมาให้รองรับถึง 109 ภาษา ซึ่งรวมถึงภาษาไทย ทำให้เป็นประโยชน์อย่างยิ่งสำหรับนักพัฒนาและนักวิจัยที่ทำงานกับข้อมูลภาษาไทยและภาษาอื่นๆ
- เทคนิคการฝึกฝนขั้นสูง: LaBSE ใช้สถาปัตยกรรม BERT และเทคนิคการฝึกฝนที่ซับซ้อน เช่น Masked Language Modeling (MLM) และ Translation Language Modeling (TLM) เพื่อให้ได้ผลลัพธ์ที่มีความแม่นยำสูง
LaBSE คืออะไร? ทำความเข้าใจโมเดลสุดล้ำ
นิยามและความสามารถหลัก
LaBSE หรือ Language-agnostic BERT Sentence Embedding เป็นโมเดルการฝังประโยคที่ถูกออกแบบมาเพื่อสร้างเวกเตอร์แทนความหมายของประโยคโดยไม่ยึดติดกับภาษาใดภาษาหนึ่ง จุดเด่นคือการที่ประโยคจากภาษาต่าง ๆ (เช่น ไทย อังกฤษ จีน ญี่ปุ่น ฯลฯ) หากมีความหมายเดียวกันหรือใกล้เคียงกัน จะถูกแปลงให้อยู่ในรูปแบบเวกเตอร์ที่คล้ายคลึงกันในปริภูมิเวกเตอร์เดียวกัน ทำให้สามารถวัด "ความใกล้เคียงทางความหมาย" ระหว่างประโยคเหล่านั้นได้โดยตรง แม้ว่าประโยคเหล่านั้นจะมาจากคนละภาษาก็ตาม ความสามารถนี้เปิดประตูสู่การใช้งานที่หลากหลาย เช่น การค้นหาข้อมูลข้ามภาษา (cross-lingual information retrieval) การจับคู่ประโยคที่แปลกัน (translation pair matching) และการจัดกลุ่มเอกสารหลายภาษา
แผนภาพแสดงแนวคิดของ LaBSE ในการสร้าง Sentence Embeddings ที่เป็นกลางทางภาษา ทำให้ประโยคที่มีความหมายเดียวกันจากภาษาต่างๆ มีเวกเตอร์ที่ใกล้เคียงกัน
สถาปัตยกรรมพื้นฐาน
LaBSE มีพื้นฐานมาจากสถาปัตยกรรม Transformer แบบ BERT (Bidirectional Encoder Representations from Transformers) ซึ่งเป็นที่รู้จักกันดีในด้านประสิทธิภาพการเข้าใจบริบทของคำในประโยค โดย LaBSE ใช้สถาปัตยกรรม BERT-base ซึ่งประกอบด้วย Transformer encoder 12 ชั้น (12-layer Transformer) โมเดลนี้มีขนาดคลังคำศัพท์ (vocabulary) ที่ใหญ่มาก ประมาณ 500,000 โทเค็น (tokens) เพื่อให้สามารถครอบคลุมคำศัพท์จากภาษาจำนวนมากที่รองรับ (109 ภาษา) การมีเลเยอร์ที่ลึกและคลังศัพท์ที่กว้างขวางนี้ช่วยให้ LaBSE สามารถจับความแตกต่างทางความหมายที่ซับซ้อนทั้งภายในภาษาเดียวและระหว่างภาษาต่างๆ ได้อย่างมีประสิทธิภาพ
กระบวนการและวิธีการฝึกฝน LaBSE
การฝึกฝนโมเดล LaBSE เป็นกระบวนการที่ซับซ้อนและใช้ข้อมูลจำนวนมหาศาล เพื่อให้ได้โมเดลที่มีความสามารถในการเข้าใจและเปรียบเทียบประโยคข้ามภาษาได้อย่างแม่นยำ กระบวนการหลักๆ ประกอบด้วยการฝึกฝนเบื้องต้น (pre-training) และการปรับละเอียด (fine-tuning)
การฝึกฝนเบื้องต้น (Pre-training)
ในขั้นตอนนี้ โมเดลจะเรียนรู้คุณสมบัติพื้นฐานของภาษาและความสัมพันธ์ระหว่างภาษาต่างๆ ผ่านสองเทคนิคหลัก:
Masked Language Modeling (MLM)
เทคนิค MLM เป็นการฝึกให้โมเดลทำนายคำที่ถูก "ปิดบัง" (masked) ไว้ในประโยค ตัวอย่างเช่น หากมีประโยค "แมว [MASK] น่ารัก" โมเดลจะต้องเรียนรู้ที่จะทำนายว่าคำที่หายไปคือคำว่า "เป็น" หรือคำอื่นๆ ที่เหมาะสมตามบริบท การฝึกด้วยวิธีนี้ช่วยให้โมเดลเข้าใจโครงสร้างทางไวยากรณ์และความสัมพันธ์ของคำต่างๆ ภายในประโยคของแต่ละภาษา
Translation Language Modeling (TLM)
TLM เป็นส่วนสำคัญที่ทำให้ LaBSE มีความเป็นเลิศด้านการเข้าใจความหมายข้ามภาษา ในการฝึกแบบ TLM โมเดลจะได้รับคู่ประโยคที่แปลกัน เช่น ประโยคภาษาอังกฤษคู่กับประโยคภาษาไทยที่มีความหมายเดียวกัน จากนั้น บางคำในประโยคทั้งสองจะถูกปิดบัง และโมเดลต้องทำนายคำเหล่านั้นพร้อมกัน การฝึกฝนด้วยวิธีนี้บังคับให้โมเดลเรียนรู้ที่จะสร้างการแทนความหมาย (representation) ที่สอดคล้องกันสำหรับประโยคที่มีความหมายเหมือนกัน แม้จะอยู่คนละภาษาก็ตาม
การปรับละเอียด (Fine-tuning)
หลังจากผ่านการฝึกฝนเบื้องต้นแล้ว LaBSE จะถูกนำมาปรับละเอียดเพิ่มเติมด้วย "translation ranking task" หรือภารกิจการจัดอันดับการแปล ในขั้นตอนนี้ โมเดลจะถูกฝึกให้แยกแยะว่าคู่ประโยคใดเป็นคู่แปลที่ถูกต้องออกจากคู่ประโยคที่ไม่ถูกต้อง (negative samples) โดยใช้สถาปัตยกรรมแบบ "dual-encoder Siamese network" ซึ่งหมายความว่ามี encoder สองตัว (หนึ่งตัวสำหรับภาษาต้นทาง และอีกตัวสำหรับภาษาเป้าหมาย) ทำงานร่วมกันเพื่อสร้างเวกเตอร์ฝัง จากนั้นจะมีการคำนวณค่า loss function เพื่อผลักดันให้เวกเตอร์ของคู่ประโยคที่แปลกันอย่างถูกต้องเข้ามาอยู่ใกล้กันในปริภูมิเวกเตอร์ และผลักดันเวกเตอร์ของคู่ประโยคที่ไม่ถูกต้องให้ออกห่างกัน กระบวนการนี้ช่วยเสริมสร้างความสามารถของ LaBSE ในการจับคู่ความหมายข้ามภาษาให้แม่นยำยิ่งขึ้น
ชุดข้อมูลที่ใช้ในการฝึกฝนโดยรวม
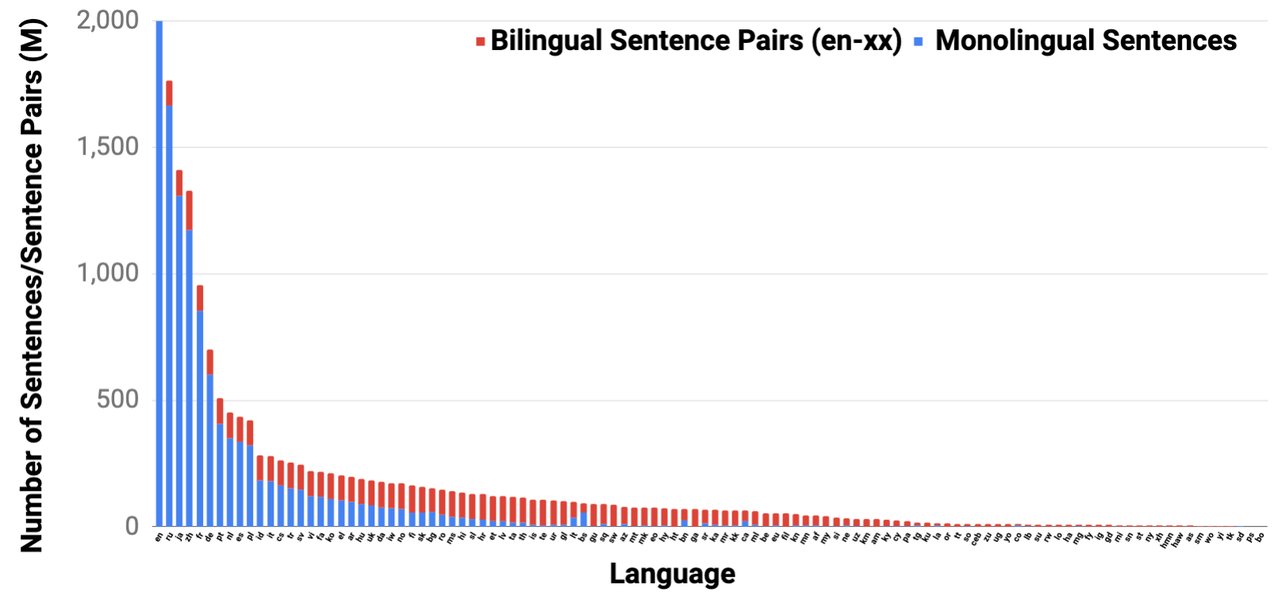
LaBSE ถูกฝึกฝนด้วยชุดข้อมูลขนาดใหญ่มาก ประกอบด้วยข้อมูลจากหลากหลายแหล่งที่มา เพื่อให้ครอบคลุมภาษาและรูปแบบการใช้ภาษาที่หลากหลาย โดยรวมแล้ว นักวิจัยใช้ประโยคภาษาเดียว (monolingual sentences) มากกว่า 17,000 ล้านประโยค และคู่ประโยคสองภาษา (bilingual sentence pairs) อีกกว่า 6,000 ล้านคู่ ชุดข้อมูลมหาศาลนี้ทำให้ LaBSE มีประสิทธิภาพสูงแม้ในภาษาที่มีทรัพยากรน้อย (low-resource languages) ซึ่งอาจจะไม่ได้มีข้อมูลจำนวนมากในระหว่างการฝึกฝนโดยตรง
แผนผังความคิด: องค์ประกอบสำคัญของ LaBSE
เพื่อให้เห็นภาพรวมของ LaBSE ได้ชัดเจนยิ่งขึ้น แผนผังความคิดด้านล่างนี้สรุปองค์ประกอบหลักของโมเดล ตั้งแต่แนวคิดพื้นฐาน สถาปัตยกรรม กระบวนการฝึกฝน การรองรับภาษา ไปจนถึงการนำไปประยุกต์ใช้งานจริง:
หลายภาษา (Multilingual
Sentence Embedding)"] id1_2["ความเป็นกลางทางภาษา
(Language-Agnostic)"] id1_3["พัฒนาโดย Google AI"] id2["สถาปัตยกรรม (Architecture)"] id2_1["พื้นฐานจาก BERT-base
(Based on BERT-base)"] id2_2["12-layer Transformer Encoder"] id2_3["คลังศัพท์ ~500k โทเค็น
(~500k Token Vocabulary)"] id2_4["Dual-Encoder (สำหรับการ Fine-tuning)"] id3["กระบวนการฝึกฝน (Training Process)"] id3_1["การฝึกฝนเบื้องต้น (Pre-training)"] id3_1_1["Masked Language Modeling (MLM)"] id3_1_2["Translation Language Modeling (TLM)"] id3_2["การปรับละเอียด (Fine-tuning)"] id3_2_1["Translation Ranking Task"] id3_3["ชุดข้อมูลขนาดใหญ่
(Massive Datasets)"] id3_3_1["17+ พันล้านประโยค Monolingual"] id3_3_2["6+ พันล้านคู่ประโยค Bilingual"] id4["การรองรับภาษา (Language Support)"] id4_1["109 ภาษา"] id4_2["รวมภาษาไทย (Includes Thai)"] id5["การประยุกต์ใช้งาน (Applications)"] id5_1["การค้นหาข้ามภาษา
(Cross-lingual Retrieval)"] id5_2["การเปรียบเทียบความคล้ายคลึง
ของประโยค (Sentence Similarity)"] id5_3["การจัดกลุ่มข้อความ
(Text Clustering)"] id5_4["การจำแนกประเภทข้อความ
(Text Classification)"]
แผนผังนี้แสดงให้เห็นถึงความซับซ้อนและความสามารถรอบด้านของ LaBSE ซึ่งเป็นผลมาจากการออกแบบสถาปัตยกรรมที่แข็งแกร่งและกระบวนการฝึกฝนที่ครอบคลุม
LaBSE กับภาษาไทย
การรองรับภาษาไทย
ข่าวดีสำหรับผู้ที่ทำงานกับภาษาไทยคือ LaBSE ได้รับการฝึกฝนให้รองรับภาษาไทยเป็นหนึ่งใน 109 ภาษาที่โมเดลนี้สามารถประมวลผลได้ ซึ่งหมายความว่านักพัฒนาและนักวิจัยสามารถนำ LaBSE ไปใช้กับงานที่เกี่ยวข้องกับข้อความภาษาไทยได้โดยตรง เช่น การสร้างระบบค้นหาที่เข้าใจภาษาไทยและภาษาอื่นๆ การเปรียบเทียบเอกสารภาษาไทยกับเอกสารภาษาต่างประเทศ หรือการพัฒนาระบบตอบคำถามที่รองรับหลายภาษา
แหล่งที่มาและขนาดของชุดข้อมูลภาษาไทย
แม้ว่าเอกสารเผยแพร่จาก Google AI ไม่ได้ระบุขนาดของชุดข้อมูลภาษาไทยที่ใช้ในการฝึกฝน LaBSE โดยเฉพาะเจาะจง แต่เป็นที่ทราบกันว่าการฝึกฝนโมเดลขนาดใหญ่อย่าง LaBSE นั้นต้องอาศัยชุดข้อมูลจำนวนมหาศาลจากหลากหลายแหล่ง ข้อมูลภาษาไทยที่ใช้ในการฝึกฝนน่าจะมาจากคลังข้อมูลขนาดใหญ่ เช่น:
- Common Crawl: เป็นคลังข้อมูลเว็บสาธารณะขนาดใหญ่ที่รวบรวมข้อมูลจากเว็บไซต์จำนวนมหาศาลทั่วโลก ซึ่งรวมถึงเนื้อหาภาษาไทยจำนวนมาก
- Wikipedia: สารานุกรมออนไลน์ Wikipedia ฉบับภาษาไทยก็เป็นแหล่งข้อมูลสำคัญอีกแห่งหนึ่ง
- Parallel Corpora (คลังข้อมูลคู่ขนาน): ชุดข้อมูลที่ประกอบด้วยคู่ประโยคที่แปลกันระหว่างภาษาไทยกับภาษาอื่นๆ (เช่น ไทย-อังกฤษ) มีบทบาทสำคัญในการฝึกฝนส่วน Translation Language Modeling (TLM) และ translation ranking task ตัวอย่างเช่น ชุดข้อมูล scb-mt-en-th-2020 ซึ่งมีคู่ประโยคแปลไทย-อังกฤษมากกว่า 1 ล้านคู่ ก็เป็นตัวอย่างของทรัพยากรประเภทนี้
นอกจากนี้ ชุดข้อมูลภาษาไทยขนาดใหญ่อื่นๆ เช่น CC100-Thai corpus (ซึ่งเป็นส่วนหนึ่งของ Common Crawl มีขนาดประมาณ 8.7 GB และประกอบด้วยข้อความภาษาไทยหลายสิบล้านประโยค) ก็เป็นตัวอย่างของแหล่งข้อมูลที่อาจถูกนำมาใช้หรือมีลักษณะคล้ายกับข้อมูลที่ใช้ฝึก LaBSE หรืออาจนำมาใช้ในการ fine-tune โมเดล LaBSE ให้มีความเชี่ยวชาญเฉพาะด้านสำหรับภาษาไทยมากยิ่งขึ้น
ตาราง: ตัวอย่างชุดข้อมูลภาษาไทยสำหรับงาน NLP
เพื่อให้เห็นภาพรวมของทรัพยากรข้อมูลภาษาไทยที่สามารถนำมาใช้ในงาน NLP รวมถึงการ fine-tune โมเดลอย่าง LaBSE ได้ดียิ่งขึ้น ตารางด้านล่างนี้แสดงตัวอย่างชุดข้อมูลภาษาไทยที่สำคัญบางส่วน:
| ชื่อชุดข้อมูล (Dataset Name) | ประเภทข้อมูล (Data Type) | ขนาด/รายละเอียดโดยประมาณ (Approximate Size/Details) | แหล่งที่มา/ผู้พัฒนา (Source/Developer) |
|---|---|---|---|
| CC100-Thai | Monolingual Text (ข้อความภาษาเดียว) | ประมาณ 8.7 GB (ประมวลผลจาก Common Crawl) | หลากหลาย (ประมวลผลจาก Common Crawl) |
| scb-mt-en-th-2020 | Parallel Corpus (ชุดข้อมูลคู่ขนาน ไทย-อังกฤษ) | มากกว่า 1 ล้านคู่ประโยค | ธนาคารไทยพาณิชย์ (SCB) และหน่วยงานวิจัย |
| Thai-NLP-Dataset Collection (GitHub) | หลากหลาย (ตัดคำ, NER, POS tagging ฯลฯ) | รวมมากกว่า 43 ชุดข้อมูลย่อย | ชุมชนนักพัฒนา (เช่น keyreply) |
| WangchanBERTa Corpus | Monolingual Text (ข้อความภาษาเดียว) | ข้อมูลขนาดใหญ่จากหลากหลายแหล่งในไทย | สถาบันวิจัยปัญญาประดิษฐ์ประเทศไทย (AIResearch) |
| Thai WordNet | Lexical Database (ฐานข้อมูลคำศัพท์เชิงความหมาย) | โครงข่ายคำศัพท์และความสัมพันธ์ | NECTEC |
*หมายเหตุ: ตารางนี้เป็นเพียงตัวอย่าง ชุดข้อมูลอาจมีการปรับปรุงหรือมีชุดข้อมูลใหม่ๆ เกิดขึ้นเสมอ
การประเมินจุดเด่นของ LaBSE ผ่าน Radar Chart
เพื่อให้เห็นภาพรวมจุดเด่นของ LaBSE ในมิติต่างๆ ได้ชัดเจนยิ่งขึ้น Radar Chart ด้านล่างนี้แสดงการประเมินเชิงคุณภาพในด้านต่างๆ ที่สำคัญของโมเดล (คะแนน 1-5 โดย 5 คือดีที่สุด) การประเมินนี้อ้างอิงจากคุณลักษณะทั่วไปของโมเดลและการเปรียบเทียบกับแนวทางอื่นๆ ในวงการ NLP:
จากแผนภูมิ จะเห็นว่า LaBSE มีจุดแข็งอย่างยิ่งในด้านความสามารถหลายภาษา การรองรับภาษาไทย และประสิทธิภาพในงานข้ามภาษา อย่างไรก็ตาม การ fine-tune โมเดลอาจยังต้องการทรัพยากรและข้อมูลเฉพาะทางพอสมควรเพื่อให้ได้ประสิทธิภาพสูงสุดในบางงาน
การนำ LaBSE ไปใช้งาน
LaBSE ไม่ได้เป็นเพียงโมเดลทางทฤษฎี แต่เป็นเครื่องมือที่พร้อมใช้งานจริงในหลากหลายแพลตฟอร์ม นักพัฒนาและนักวิจัยสามารถเข้าถึงโมเดล LaBSE ที่ผ่านการฝึกฝนมาแล้ว (pre-trained model) และนำไปประยุกต์ใช้กับงานของตนเองได้อย่างสะดวกผ่านช่องทางต่างๆ เช่น:
- Hugging Face Transformers: หนึ่งในแพลตฟอร์มยอดนิยมที่ให้บริการโมเดล NLP รวมถึง LaBSE (ภายใต้ชื่อ เช่น
setu4993/LaBSE) ทำให้ง่ายต่อการดาวน์โหลดและใช้งานในโค้ด Python เพียงไม่กี่บรรทัด - TensorFlow Hub: Google ก็ให้บริการโมเดル LaBSE ผ่าน TensorFlow Hub ซึ่งเป็นคลังโมเดลของ TensorFlow
ด้วยความสามารถอันโดดเด่น LaBSE จึงเหมาะสำหรับงาน NLP ที่หลากหลาย โดยเฉพาะงานที่เกี่ยวข้องกับหลายภาษา เช่น:
- Cross-lingual Information Retrieval: การค้นหาข้อมูลหรือเอกสารที่เกี่ยวข้องในภาษาต่างๆ เช่น ผู้ใช้ค้นหาด้วยคีย์เวิร์ดภาษาไทย แต่ระบบสามารถดึงผลลัพธ์ที่เป็นภาษาอังกฤษหรือภาษาอื่นๆ ที่มีความหมายสอดคล้องกันได้
- Sentence Similarity and Paraphrase Detection: การเปรียบเทียบความคล้ายคลึงทางความหมายระหว่างประโยค แม้ประโยคเหล่านั้นจะมาจากคนละภาษา หรือเป็นการถอดความ (paraphrase) กันก็ตาม
- Multilingual Text Classification: การจำแนกประเภทข้อความ (เช่น การวิเคราะห์ความรู้สึก, การแยกแยะหัวข้อ) ที่สามารถทำงานได้กับข้อความจากหลายภาษาโดยใช้โมเดลเดียว
- Text Clustering: การจัดกลุ่มเอกสารหรือข้อความที่มีเนื้อหาคล้ายกัน โดยไม่จำกัดว่าเป็นภาษาใด
- Bitext Mining and Translation Quality Assessment: การค้นหาคู่ประโยคที่แปลกันจากคลังข้อมูลขนาดใหญ่ และการประเมินคุณภาพการแปล
วิดีโอนี้จากช่อง Arxiv Insights อธิบายแนวคิดและรายละเอียดทางเทคนิคของ LaBSE โดยอ้างอิงจากเปเปอร์งานวิจัยต้นฉบับ ให้ความเข้าใจเชิงลึกเกี่ยวกับสถาปัตยกรรมและวิธีการฝึกฝนโมเดล
คำถามที่พบบ่อย (FAQ)
LaBSE แตกต่างจาก BERT อย่างไร?
BERT (Bidirectional Encoder Representations from Transformers) เป็นโมเดลพื้นฐานที่เน้นการสร้าง representation ของคำและประโยคภายในภาษาเดียว (ส่วนใหญ่เป็นภาษาอังกฤษในเวอร์ชันดั้งเดิม) แม้จะมีเวอร์ชัน multilingual BERT (mBERT) แต่ LaBSE ถูกออกแบบและฝึกฝนมาโดยเฉพาะเพื่อสร้าง "sentence embeddings" ที่เป็นกลางทางภาษา (language-agnostic) อย่างแท้จริง โดยเน้นที่การทำให้ประโยคที่มีความหมายเดียวกันจากภาษาต่างกันมี vector ที่ใกล้เคียงกันใน space เดียวกัน ซึ่งทำได้ดีกว่า mBERT ในงานที่ต้องการเปรียบเทียบความหมายประโยคข้ามภาษาโดยตรง LaBSE ใช้เทคนิคเพิ่มเติมอย่าง Translation Language Modeling (TLM) และ fine-tuning ด้วย translation ranking task เพื่อบรรลุเป้าหมายนี้
LaBSE รองรับกี่ภาษา และมีภาษาไทยรวมอยู่ด้วยหรือไม่?
LaBSE รองรับภาษามากถึง 109 ภาษา และหนึ่งในนั้นคือภาษาไทย ซึ่งหมายความว่าคุณสามารถใช้ LaBSE เพื่อประมวลผลและสร้าง sentence embeddings สำหรับข้อความภาษาไทย รวมถึงเปรียบเทียบกับภาษาอื่นๆ ที่โมเดลรองรับได้
จำเป็นต้อง fine-tune LaBSE เพิ่มเติมสำหรับภาษาไทยหรือไม่?
LaBSE ที่เป็น pre-trained model สามารถใช้งานกับภาษาไทยได้ดีในระดับหนึ่งสำหรับงานทั่วไปที่ต้องการความเข้าใจความหมายข้ามภาษา อย่างไรก็ตาม หากคุณมีงานเฉพาะทาง (domain-specific task) หรือต้องการประสิทธิภาพสูงสุดสำหรับภาษาไทยโดยเฉพาะ การ fine-tune โมเดล LaBSE ด้วยชุดข้อมูลภาษาไทยที่เกี่ยวข้องกับงานนั้นๆ (เช่น ชุดข้อมูลคำถาม-คำตอบเฉพาะทาง, ชุดข้อมูลรีวิวสินค้าภาษาไทย) สามารถช่วยเพิ่มประสิทธิภาพให้ดียิ่งขึ้นได้
LaBSE มีประโยชน์อย่างไรในงาน NLP?
ประโยชน์หลักของ LaBSE คือความสามารถในการสร้าง sentence embeddings ที่เป็นกลางทางภาษา ทำให้สามารถนำไปประยุกต์ใช้ในงาน NLP ที่เกี่ยวข้องกับหลายภาษาได้อย่างมีประสิทธิภาพ เช่น:
- การค้นหาข้อมูลข้ามภาษา (Cross-lingual Search): ค้นหาข้อมูลในภาษาหนึ่งด้วยคำค้นหาจากอีกภาษาหนึ่ง
- การจับคู่ประโยคแปล (Translation Pair Matching): ค้นหาประโยคที่แปลตรงกันจากชุดข้อมูลขนาดใหญ่
- การจำแนกประเภทข้อความหลายภาษา (Multilingual Text Classification): สร้างโมเดลจำแนกประเภทที่ทำงานได้กับหลายภาษา
- การจัดกลุ่มข้อความหลายภาษา (Multilingual Text Clustering): จัดกลุ่มเอกสารที่มีเนื้อหาคล้ายกันโดยไม่จำกัดภาษา
- การปรับปรุงระบบแปลภาษา: ใช้เป็นส่วนหนึ่งในการประเมินคุณภาพการแปล หรือสร้าง embedding สำหรับระบบแปลภาษา
หัวข้อที่แนะนำ (Recommended Topics)
- ค้นหาข้อมูลเพิ่มเติมเกี่ยวกับการเปรียบเทียบประสิทธิภาพระหว่าง LaBSE และ mBERT สำหรับงานภาษาไทย
- สำรวจเทคนิคการ fine-tune โมเดล LaBSE ด้วยชุดข้อมูลภาษาไทยเฉพาะทางเพื่อเพิ่มประสิทธิภาพ
- ดูตัวอย่างการนำ LaBSE ไปใช้ในระบบค้นหาข้อมูลข้ามภาษาแบบโอเพนซอร์ส
- เรียนรู้เกี่ยวกับความท้าทายและแนวทางการพัฒนาโมเดล Sentence Embedding สำหรับภาษาที่มีทรัพยากรน้อยเช่นภาษาไทย
แหล่งอ้างอิง (References)
Last updated May 14, 2025