
ไขความลับข้อมูลมหาศาล: เบื้องหลังการฝึกฝนโมเดล LaBSE เพื่อความเข้าใจภาษาสุดล้ำ
เจาะลึกถึงแหล่งข้อมูลและเทคนิคการฝึกฝนที่ทำให้ sentence-transformers/LaBSE สร้างการฝังประโยค (sentence embeddings) ที่ไม่ขึ้นกับภาษาได้อย่างแม่นยำ
โมเดล sentence-transformers/LaBSE (Language-agnostic BERT Sentence Encoder) คือหนึ่งในเครื่องมืออันทรงพลังในโลกของการประมวลผลภาษาธรรมชาติ (NLP) ที่ช่วยให้เราสามารถเข้าใจและเปรียบเทียบความหมายของประโยคจากภาษาต่างๆ ได้อย่างมีประสิทธิภาพ ความสามารถอันน่าทึ่งนี้ไม่ได้เกิดขึ้นโดยบังเอิญ แต่เป็นผลมาจากการฝึกฝนด้วยชุดข้อมูลขนาดมหึมาและเทคนิคที่ซับซ้อน เรามาดูกันว่าข้อมูลใดบ้างที่ถูกนำมาใช้ในการสร้างโมเดลนี้
ไฮไลท์สำคัญของข้อมูลฝึกฝน LaBSE
- ข้อมูลสองประเภทหลัก: LaBSE ถูกฝึกฝนด้วยข้อมูลประโยคภาษาเดียว (monolingual) จำนวนมหาศาลถึง 17 พันล้านประโยค และข้อมูลคู่ประโยคสองภาษา (bilingual parallel sentences) อีก 6 พันล้านคู่ประโยค
- ครอบคลุมกว่า 109 ภาษา: การฝึกฝนครอบคลุมภาษาจำนวนมาก ทำให้โมเดลมีความสามารถในการทำงานข้ามภาษาได้อย่างกว้างขวาง แม้แต่กับภาษาที่มีข้อมูลน้อย (low-resource languages)
- เทคนิคการฝึกฝนขั้นสูง: ใช้การผสมผสานระหว่าง Masked Language Modeling (MLM) และ Translation Language Modeling (TLM) ร่วมกับการปรับละเอียด (fine-tuning) ด้วย Translation Ranking Task เพื่อสร้าง sentence embeddings ที่มีความหมายสอดคล้องกันข้ามภาษา
LaBSE คืออะไร? ทำความเข้าใจพื้นฐาน
LaBSE เป็นโมเดลการฝังประโยคที่พัฒนาโดยทีมวิจัยของ Google โดยมีเป้าหมายเพื่อสร้างเวกเตอร์ (หรือ "embeddings") ที่แทนความหมายของประโยค โดยเวกเตอร์เหล่านี้จะมีความคล้ายคลึงกันหากประโยคนั้นๆ มีความหมายเหมือนหรือใกล้เคียงกัน แม้ว่าจะมาจากคนละภาษาก็ตาม สิ่งนี้ทำให้ LaBSE มีประโยชน์อย่างยิ่งสำหรับงานต่างๆ เช่น การค้นหาข้อมูลข้ามภาษา (cross-lingual retrieval), การจัดกลุ่มเอกสารหลายภาษา, หรือการเปรียบเทียบความหมายของข้อความ
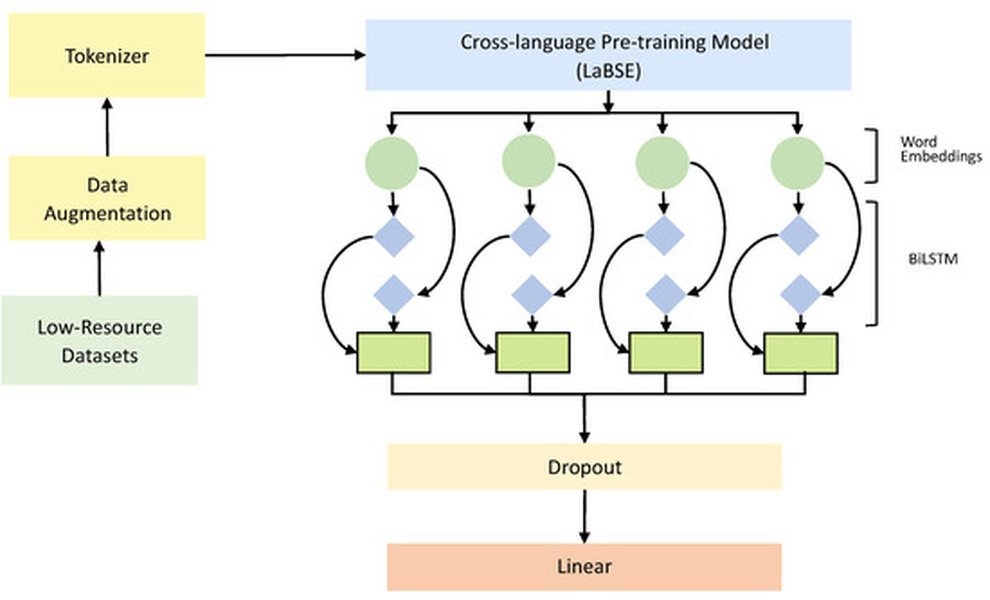
ภาพแสดงสถาปัตยกรรมของโมเดล LaBSE ซึ่งใช้โครงสร้างแบบ Dual Encoder
สถาปัตยกรรมและเป้าหมาย
LaBSE พัฒนาต่อยอดมาจากสถาปัตยกรรม BERT (Bidirectional Encoder Representations from Transformers) ซึ่งเป็นที่รู้จักกันดีในด้านความสามารถในการเข้าใจบริบทของคำในประโยคได้อย่างลึกซึ้ง LaBSE ใช้สถาปัตยกรรมแบบ "Dual Encoder" ซึ่งหมายความว่ามี Encoder สองตัว (หรือใช้ Encoder ตัวเดียวกันสองครั้ง) เพื่อประมวลผลประโยคสองประโยค (เช่น ประโยคต้นฉบับและประโยคแปล) แยกจากกัน จากนั้นจึงนำ embeddings ที่ได้มาเปรียบเทียบกัน เป้าหมายหลักคือการสร้าง "พื้นที่เวกเตอร์ร่วม" (shared vector space) ที่ประโยคที่มีความหมายเดียวกันจากภาษาต่างๆ จะถูกจับคู่ให้อยู่ใกล้กันในพื้นที่นั้น
ขุมข้อมูลมหาศาล: หัวใจสำคัญของการฝึกฝน LaBSE
ปริมาณและคุณภาพของข้อมูลที่ใช้ฝึกฝนเป็นปัจจัยสำคัญที่ส่งผลต่อประสิทธิภาพของโมเดล LaBSE สำหรับ LaBSE นั้น ใช้ข้อมูลจำนวนมหาศาลจากหลากหลายแหล่ง
ข้อมูลประโยคภาษาเดียว (Monolingual Data)
ส่วนนี้ประกอบด้วยประโยคที่มาจากภาษาเดียวจำนวนมหาศาลถึง 17 พันล้านประโยค ข้อมูลเหล่านี้ช่วยให้โมเดลเรียนรู้โครงสร้างทางไวยากรณ์ รูปแบบการใช้คำ และความหมายภายในแต่ละภาษาได้อย่างลึกซึ้ง แหล่งข้อมูลอาจมาจากคลังข้อมูลขนาดใหญ่บนเว็บ เช่น CommonCrawl หรือ Wikipedia การฝึกฝนด้วยข้อมูลประเภทนี้มีความสำคัญต่อเทคนิค Masked Language Modeling (MLM)
ข้อมูลคู่ประโยคสองภาษา (Bilingual Parallel Data)
อีกส่วนที่สำคัญอย่างยิ่งคือข้อมูลคู่ประโยคสองภาษา ซึ่งเป็นคู่ของประโยคที่มีความหมายเดียวกันแต่เขียนในคนละภาษา (เช่น ประโยคภาษาไทยและคำแปลภาษาอังกฤษ) LaBSE ใช้ข้อมูลส่วนนี้มากถึง 6 พันล้านคู่ประโยค ข้อมูลเหล่านี้มีความจำเป็นอย่างยิ่งสำหรับการสอนให้โมเดลเข้าใจความสัมพันธ์ระหว่างภาษาต่างๆ และสามารถสร้าง embeddings ที่สอดคล้องกันข้ามภาษาได้ ซึ่งเป็นหัวใจของเทคนิค Translation Language Modeling (TLM) และ Translation Ranking Task
ความครอบคลุมทางภาษา
LaBSE ได้รับการฝึกฝนบนข้อมูลที่ครอบคลุมถึง 109 ภาษา ซึ่งรวมถึงภาษาที่มีผู้ใช้จำนวนมาก เช่น อังกฤษ จีน สเปน และภาษาที่มีข้อมูลน้อยกว่า การมีความครอบคลุมทางภาษาที่กว้างขวางนี้ช่วยให้โมเดลสามารถถ่ายทอดความรู้ (transfer learning) ระหว่างภาษาได้ ทำให้มีประสิทธิภาพดีแม้ในภาษาที่อาจจะไม่ได้มีข้อมูลคู่ขนาน (parallel data) จำนวนมากในการฝึกฝนโดยตรง
ตารางสรุปประเภทและปริมาณข้อมูลฝึกฝน LaBSE
ตารางด้านล่างนี้สรุปองค์ประกอบหลักของข้อมูลที่ใช้ในการฝึกฝนโมเดล LaBSE เพื่อให้เห็นภาพรวมที่ชัดเจนยิ่งขึ้นเกี่ยวกับขนาดและความหลากหลายของชุดข้อมูล
| ประเภทข้อมูล (Data Type) | ปริมาณ (Quantity) | บทบาทหลักในการฝึกฝน (Primary Role in Training) |
|---|---|---|
| ข้อมูลประโยคภาษาเดียว (Monolingual Sentences) | 17 พันล้านประโยค (17 billion sentences) | เรียนรู้โครงสร้างและความหมายภายในแต่ละภาษา (MLM) |
| ข้อมูลคู่ประโยคสองภาษา (Bilingual Sentence Pairs) | 6 พันล้านคู่ประโยค (6 billion pairs) | เรียนรู้การจับคู่ความหมายข้ามภาษา (TLM, Translation Ranking) |
| จำนวนภาษาที่ครอบคลุม (Language Coverage) | 109 ภาษา (109 languages) | สร้างความสามารถในการทำงานข้ามภาษาที่กว้างขวาง |
เทคนิคการฝึกฝนที่ซับซ้อน
นอกเหนือจากข้อมูลจำนวนมหาศาลแล้ว LaBSE ยังใช้เทคนิคการฝึกฝนที่ชาญฉลาดหลายอย่างร่วมกันเพื่อให้ได้ embeddings ที่มีคุณภาพสูง
Masked Language Modeling (MLM)
เทคนิค MLM เป็นวิธีการฝึกฝนที่ใช้กันอย่างแพร่หลายในโมเดลตระกูล BERT โดยโมเดลจะได้รับประโยคที่มีบางคำถูก "ปิดบัง" (masked) ไว้ และหน้าที่ของโมเดลคือการทายว่าคำที่ถูกปิดบังนั้นคือคำอะไรจากบริบทของคำรอบข้าง วิธีนี้ช่วยให้โมเดลเรียนรู้ความสัมพันธ์ระหว่างคำต่างๆ และเข้าใจบริบทของประโยคในแต่ละภาษาได้เป็นอย่างดี
Translation Language Modeling (TLM)
TLM เป็นการขยายแนวคิดของ MLM ไปยังข้อมูลคู่ประโยคสองภาษา โดยโมเดลจะได้รับคู่ประโยค (เช่น ประโยคภาษา A และคำแปลในภาษา B) ที่ถูกเชื่อมต่อกัน จากนั้นบางคำในประโยคทั้งสองภาษาจะถูกปิดบัง โมเดลต้องทายคำที่ถูกปิดบังโดยอาศัยบริบทจากทั้งสองภาษาพร้อมกัน วิธีนี้ช่วยให้โมเดลเรียนรู้การจัดเรียงคำ (alignment) และความสัมพันธ์ทางความหมายระหว่างภาษาต่างๆ
การปรับละเอียดด้วย Translation Ranking Task
หลังจากการ pre-training ด้วย MLM และ TLM แล้ว LaBSE ยังได้รับการปรับละเอียด (fine-tuned) ด้วยงานที่เรียกว่า "Translation Ranking Task" ในขั้นตอนนี้ โมเดลจะได้รับประโยคต้นฉบับในภาษาหนึ่ง และชุดของประโยคเป้าหมาย (candidate sentences) ในอีกภาษาหนึ่ง ซึ่งหนึ่งในนั้นเป็นคำแปลที่ถูกต้อง ส่วนที่เหลือเป็นคำแปลที่ไม่ถูกต้อง (negative samples) โมเดลจะถูกฝึกให้สามารถจัดอันดับคำแปลที่ถูกต้องให้มีคะแนนความคล้ายคลึง (similarity score) สูงกว่าคำแปลที่ไม่ถูกต้อง เทคนิคนี้มักใช้ร่วมกับฟังก์ชันการสูญเสีย (loss function) เช่น Additive Margin Softmax Loss เพื่อเพิ่มประสิทธิภาพในการแยกแยะระหว่างคู่ประโยคที่ "ดี" (มีความหมายสอดคล้อง) และคู่ประโยคที่ "ไม่ดี"
สถาปัตยกรรม Dual Encoder
ดังที่กล่าวไปข้างต้น LaBSE ใช้สถาปัตยกรรมแบบ Dual Encoder ซึ่ง Encoder หนึ่งจะประมวลผลประโยคจากภาษาต้นทาง และอีก Encoder (หรือตัวเดียวกัน) จะประมวลผลประโยคจากภาษาเป้าหมาย จากนั้น embeddings ที่ได้จากแต่ละ Encoder จะถูกนำมาเปรียบเทียบกัน (มักใช้ cosine similarity) เพื่อวัดระดับความคล้ายคลึงทางความหมาย สถาปัตยกรรมนี้มีประสิทธิภาพสูงสำหรับงานที่ต้องการเปรียบเทียบความหมายระหว่างประโยคสองประโยค เช่น การค้นหา หรือการระบุคู่ประโยคแปล
การเปรียบเทียบปัจจัยการฝึกฝนของ LaBSE
เพื่อให้เห็นภาพรวมของความซับซ้อนและขนาดของปัจจัยต่างๆ ที่เกี่ยวข้องกับการฝึกฝนโมเดล LaBSE เมื่อเทียบกับโมเดลสมมติแบบอื่นๆ แผนภูมิเรดาร์ด้านล่างนี้แสดงการเปรียบเทียบในมิติต่างๆ เช่น ปริมาณข้อมูล ความครอบคลุมของภาษา และประสิทธิภาพของเทคนิคการฝึกฝน โดยค่าที่แสดงเป็นค่าเปรียบเทียบเชิงคุณภาพเพื่อให้เข้าใจได้ง่าย
แผนภูมิเรดาร์นี้แสดงให้เห็นว่า LaBSE มีความโดดเด่นในด้านปริมาณข้อมูลทั้งแบบ Monolingual และ Bilingual รวมถึงความครอบคลุมของภาษาที่กว้างขวาง ซึ่งส่งผลให้มีประสิทธิภาพสูงในการเรียนรู้ทั้งแบบ MLM และ TLM แม้ว่าความซับซ้อนในการฝึกฝนจะสูงตามไปด้วย
โครงสร้างองค์ประกอบการฝึกฝน LaBSE
แผนผังความคิด (Mindmap) ด้านล่างนี้สรุปองค์ประกอบหลักที่เกี่ยวข้องกับการฝึกฝนโมเดล LaBSE ตั้งแต่ประเภทของข้อมูลที่ใช้ เทคนิคการฝึกฝน ไปจนถึงผลลัพธ์ที่ได้คือการฝังประโยคที่ไม่ขึ้นกับภาษา
(การฝังประโยคที่ไม่ขึ้นกับภาษา)"] id4b["Cross-lingual Understanding
(ความเข้าใจข้ามภาษา)"] id4c["ประสิทธิภาพสูงในการดึงข้อความสองภาษา"]
แผนผังนี้ช่วยให้เห็นภาพรวมของกระบวนการทั้งหมด ตั้งแต่การรวบรวมข้อมูลจำนวนมหาศาล การใช้เทคนิคการเรียนรู้ที่ซับซ้อน และโครงสร้างสถาปัตยกรรมที่เหมาะสม เพื่อให้ได้ผลลัพธ์เป็นโมเดลที่สามารถเข้าใจความหมายของประโยคในหลากหลายภาษาได้อย่างแท้จริง
วิดีโออธิบาย Language-agnostic BERT Sentence Embedding
วิดีโอด้านล่างนี้จากช่อง "The AI Epiphany" บน YouTube อธิบายเกี่ยวกับแนวคิดของ Language-agnostic BERT Sentence Embedding ซึ่งเป็นพื้นฐานของ LaBSE วิดีโอนี้สรุปเนื้อหาจากเปเปอร์วิจัยต้นฉบับของ Google ทำให้เห็นภาพรวมของเทคนิคและเป้าหมายของโมเดลประเภทนี้ได้เป็นอย่างดี แม้ว่าวิดีโอจะเป็นภาษาอังกฤษ แต่ก็ให้ข้อมูลเชิงลึกที่เป็นประโยชน์เกี่ยวกับหลักการทำงานของโมเดลเหล่านี้
การทำความเข้าใจหลักการเหล่านี้ช่วยให้เราตระหนักถึงความซับซ้อนและความชาญฉลาดในการออกแบบโมเดล LaBSE เพื่อให้สามารถจัดการกับความท้าทายในการทำความเข้าใจภาษาที่หลากหลายได้อย่างมีประสิทธิภาพ
ข้อจำกัดของ LaBSE
แม้ว่า LaBSE จะมีประสิทธิภาพสูงและถูกฝึกฝนบนชุดข้อมูลขนาดใหญ่ แต่ก็ยังมีข้อจำกัดบางประการที่ควรทราบ:
- ความเข้าใจในบริบทเชิงลึก: โมเดลอาจมีข้อจำกัดในการทำความเข้าใจบริบทของประโยคบางประเภทที่ซับซ้อน เช่น สำนวนโวหาร คำประชดประชัน หรือการอ้างอิงทางวัฒนธรรมที่เฉพาะเจาะจงมากๆ
- ความลำเอียงในข้อมูล (Data Bias): ชุดข้อมูลที่ใช้ในการฝึกฝนอาจมีความลำเอียง (bias) หรือไม่สมดุล (imbalance) ในบางภาษา หรือสะท้อนอคติที่มีอยู่ในข้อมูลต้นทาง ซึ่งอาจส่งผลต่อประสิทธิภาพของโมเดลในภาษาที่มีข้อมูลน้อย หรือทำให้โมเดลแสดงพฤติกรรมที่ไม่พึงประสงค์
- ทรัพยากรในการฝึกฝนและใช้งาน: การฝึกฝนโมเดลขนาดใหญ่อย่าง LaBSE ต้องใช้ทรัพยากรคอมพิวเตอร์จำนวนมาก และการนำไปใช้งานจริงก็อาจต้องการฮาร์ดแวร์ที่มีประสิทธิภาพสูงเช่นกัน
คำถามที่พบบ่อย (FAQ)
คำค้นหาที่เกี่ยวข้องที่คุณอาจสนใจ
- เทคนิคการประเมินประสิทธิภาพของโมเดล sentence embeddings หลายภาษา
- การนำ LaBSE ไปประยุกต์ใช้ในงานค้นหาข้อมูลข้ามภาษาจริง
- เปรียบเทียบ LaBSE กับโมเดล sentence embedding อื่นๆ เช่น mUSE หรือ LASER
- วิธีการ fine-tune โมเดล LaBSE สำหรับงานเฉพาะทางในภาษาไทย
แหล่งอ้างอิง
Last updated May 15, 2025